ARTICLE · 1304638
Harness 思想:AI 工具的灵魂不是模型,是那层壳
上一篇搭好了 AI 数据分析工作台(VSCode + Claude Code + OpenCode /Codex + CC Switch),结尾留了一个词:Harness,这篇把它讲透。
一、先分清:什么是模型的,什么是壳的
一个能干活的 AI Agent,由两部分组成:
- 模型:感知、推理、决策的能力。这是训练出来的——在海量数据上反复学习,练出来的"聪明"。你改不了它,只能选它。
- Harness(直译"套件",我叫它"壳"):让模型能在你的环境里干活的一切——工具、知识、上下文管理、权限边界。这是工程出来的——可以配置、可以积累、可以越用越好
一个常用的比喻:模型是驾驶者,Harness 是载具。驾驶技术再好,没有车、没有仪表盘、没有刹车,哪也去不了。反过来,同一个驾驶者,开不同的车,体验完全不同——这就是为什么同一个模型换了个工具,效果立刻不一样。
有人会问:那"AI 会不会干活"到底取决于谁?
答案是:自主执行的潜质(Agency)来自模型训练;落地可用的 Agent 产品 = 模型 + Harness,缺一不可,模型决定它有多"聪明"、有没有自主规划的潜力;Harness 决定这份潜力能不能闭环落地、真正把活干出来。
对我们用工具的人来说,这个分工直接给出一条配置原则:模型用 CC Switch 随时切换,Harness 才是你的核心资产。上一篇说"工作台越用越顺手",顺手的那部分——项目约定、技能、权限习惯——全在壳里。
二、壳里有什么:拆开 Harness 的五个部件
Harness = 工作流编排 + 工具链 + 知识管理 + 安全护栏(含权限、系统强约束)+ 反馈循环
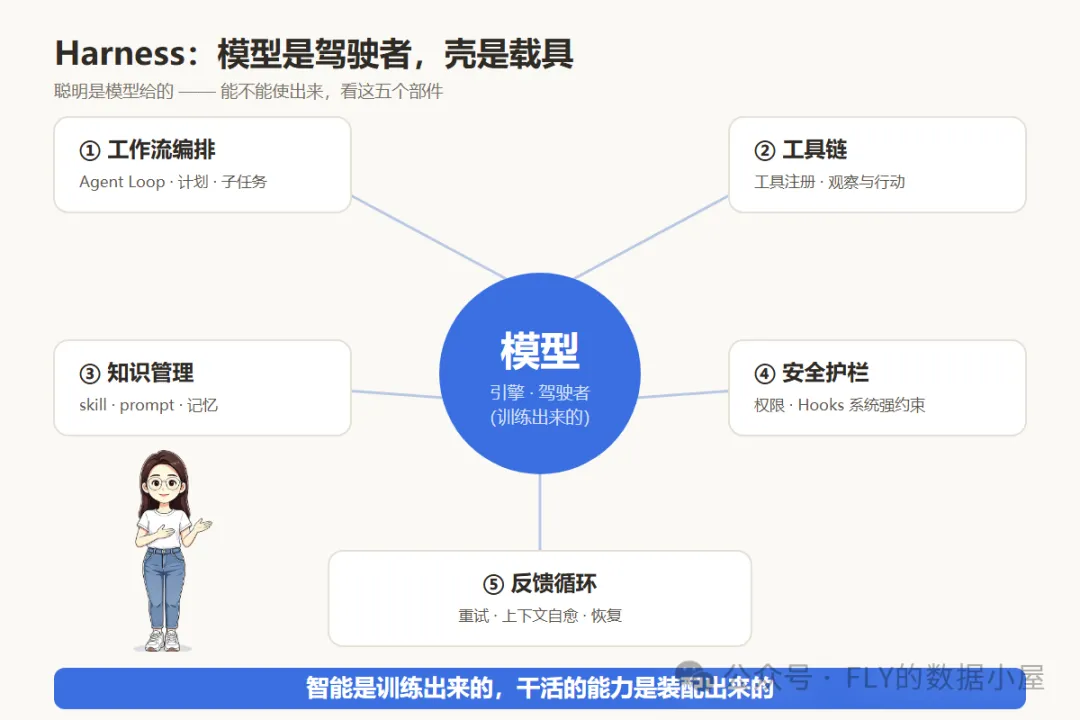
这几件事落到工程实现上,用数据分析师熟悉的场景拆开来看(括号里是对应的工程机制):
1. 工作流编排(Agent Loop + 任务清单 + 子任务拆分)
AI 工具的核心其实朴素得惊人:一个循环。收到任务 → 模型思考 → 调用工具 → 看结果 → 继续思考,直到完成。所谓"一个循环 + 一个命令行工具,就是一个 Agent"。
但只有循环还不够,长任务会跑偏,所以要编排:
- 先列计划再动手:复杂任务先写步骤清单,做到第 8 步忘了第 2 步?看一眼清单。没有计划的 Agent,做着做着就偏了
- 子任务隔离:追查一个数据问题要翻几十个文件、跑几十条命令,中间过程会把主任务淹没。好 Agent 会"开个新窗口"专门做追查,只把结论带回主任务——像你修 bug 时开个新终端查调用链,查完就关
2. 工具链(工具注册 + 观察与行动)
工具决定 Agent 能干什么:读写文件、跑 SQL、查数据、执行脚本。工程上加一个新工具只要"注册一个处理函数"——所以好的 Agent 天然可扩展。
工具的另一面是观察与行动:模型要能"看见"环境状态——文件内容、命令输出、报错信息,也要能"动手"——执行命令、改文件、调接口。观察和行动的丰富度,直接决定智能能发挥多少。Harness 没有让模型变聪明,它给了模型双手、双眼和一个工作空间。
3. 知识管理(skill 按需加载 + 提示词组装 + 记忆)
想让 AI 遵守你的口径规范、报告模板?常见错误是把所有文档一股脑塞进提示词——6000 行规范,改个颜色也要带着。
好 Harness 的做法是按需加载:告诉 AI"有哪些知识可用",用到哪个再拉哪个。提示词本身也是运行时组装的——按当前任务拼装能力说明,而不是写死一大段。这就是"skill / 插件"背后的思想:Everything is a Plugin,能装卸,不硬编码。
几个常被混用的概念:prompt 管「当下给模型说什么」,skill 管「一套任务该怎么做」(把提示词 + 步骤 + 参考资料打包成可复用模块,用到时才加载),MCP(Model Context Protocol)管「模型可以摸到哪些外部资源 / 工具」。至于 Plugin,大多是平台私有的封闭扩展,而 MCP 是跨平台的通用协议。它们都装在壳上——prompt 和 skill 对应知识管理,MCP 对应工具链。
知识管理还有一层记忆:上下文压缩是有损的,"用 tab 缩进"可能被压缩成"有代码风格偏好"。所以要有一层不参与压缩、跨会话保留的记忆:重要的约定落成文件,索引常驻,内容按需取用。
4. 安全护栏(权限 + 系统强约束)
给你"清理一下项目"的指令,AI 有可能误删文件。怎么办?安全不靠信任模型,靠代码。
- 权限闸门:每个操作执行前先判断——硬性禁止的直接拒绝(删库级命令),敏感的要人工确认,其余放行。边界画在代码里,不画在"希望模型自觉"上
- 系统强约束(Hooks):想在每次 AI 改完文件后自动记录、自动检查规范?把这些规则"挂"在循环的扩展点上,由系统保证执行——像插件一样装卸,而不是靠反复嘱咐
5. 反馈循环(容错重试 + 上下文自愈)
输出截断、上下文超限、接口报错,都是日常。差的 Agent 一报错就崩;好的 Agent 把错误当信号,走反馈循环自我修复——分类处理:重试、腾上下文、切换模型,然后继续干活。错误不是终点,是重试的起点。
"腾上下文"就是上下文压缩:历史记录总会撑满窗口,压缩策略的核心是"便宜的先跑,贵的后跑"——能用规则裁剪就别动用模型摘要。跑不动先自我调整再继续——这是循环能扛住长任务的关键。
三、拿着这个视角,重新看你的 AI 工具
理解 Harness 之后,有三件事会变得清晰:
2. 配置精力该往哪投。不是天天换模型,而是投在壳:项目口径写进 CLAUDE.md、常用流程存成 skill(知识管理);敏感操作设权限、重复动作交给 hooks(安全护栏);出错能自愈(反馈循环)。模型会贬值,壳会增值。
3. AI 跑偏了,先诊断是哪个部件。越做越乱?工作流编排缺位——没计划、没拆子任务。做到一半忘了要求?知识管理没兜住——记忆被挤掉了。没按你的规范来?安全护栏没装。跑一半就崩?反馈循环缺失。把"AI 不听话"翻译成"Harness 哪个部件缺位",就有了明确的修复动作——这比"换个更强的模型"有用得多。
收个尾
一句话总结 Harness 思想:
智能是训练出来的,干活的能力是装配出来的。模型选现成的,壳自己攒。
这也是这个系列的主线:AI 时代的数据分析,人的价值从"跑数的手艺"转向"装配工作系统的眼光"——知道该给 AI 什么工具、什么知识、什么边界,然后让它替你跑。
下一篇讲壳的运维:配置怎么管——多模型切换、配置成文、让几个月后的自己还能看懂现在的配置。
本文是「AI 时代的数据分析工作」系列第 2 篇。Harness 工程机制参考公开的 Agent Harness 教学项目与开源。