ARTICLE · 1315318
公司禁你用AI到底在怕什么
“禁的是账号,划的是责任线。
字节那条内部通知流出来那天,我所在的几个行业群里都在转同一句话:
“连字节都开始禁 AI 了。”
这话说得太省事。我把能查到的信息拼了一遍,真实情况跟“禁 AI”差得挺远。
先把事实摆准:从本月起,字节对全公司所有 L4 级别的代码仓库和飞书文档,实施外部 AI 访问封禁。员工自己花钱买的 Claude、Codex 账号,没法再访问这些内部资源。
注意,封的是“个人账号访问内部资源”这条通道,不是 AI 本身。用外部 AI 处理公开信息、处理个人生活,不受限制。
技术副总裁洪定坤在内网回了两句,我觉得第二句比第一句有价值。
第一句是解释:“L3 及以上内容一旦有泄露,后果是非常严重的。”
第二句是否认:“推广产品不需要用这种禁掉其他选择强迫使用的方式,因为这样效果很差。”
一个肯把“这样效果很差”写在内网的人,至少没打算糊弄员工。
📌 本文看点
01
效率算不出来
02
三道防线
03
三星的答案
EFFICIENCY
“怕你太效率”,数据上站不住
评论区最热的那个说法是:公司怕你用 AI 太快,显得别人太慢,或者把活干完了没活干。
这个说法爽,但它经不起查。
METR 去年做过一个挺狠的实验:找 16 名资深开发者,在他们自己维护了好几年、上百万行的开源项目上做 246 个真实任务,随机分成“能用 AI”和“不能用 AI”两组,全程录屏。
结果:用 AI 的那组,完成任务慢了 19%。
更扎心的是认知差。开工前他们预计 AI 能让自己快 24%,干完之后自评快了 20%。录屏一算,慢了 19%。感知和现实之间差了将近 40 个百分点。
原因不复杂:写上下文提示、等生成、然后花时间调试那些“看起来对、架构上微妙地错”的代码。
效率这件事,连当事人自己都测不准,公司怎么可能拿它当管理依据?
+20%
开发者自评提速
-19%
录屏实测
+11%
企业侧真实归因
再看两组企业侧的数据。客服场景里,AI 让新手每小时解决的问题数涨了 34%,对资深员工几乎为零。咨询顾问的对照实验里,在模型能力范围内,速度快 25%、质量高 40%;一旦出了能力边界,准确率掉 19 个百分点。
还有一份斯坦福做的企业审计:观察数据看,用 AI 的员工比不用的快 41%。控制住“谁是先上手的那批人”之后,真实的因果提速只有 11%。剩下 30 个百分点,是“本来手就快的人先用了 AI”。
把这几组放在一起,结论很清楚:AI 的效率提升高度依赖任务类型,而且极难归因。它不是一个可以写进 KPI 的稳定变量。
所以“怕你太效率”这个假设,大概率是想多了。公司连你今天到底快了没有都算不出来。
LEAK
真正怕的,是那三条没失效的防线
那怕什么?怕数据出去。
三星 2023 年那三起事故,到现在还是最好的教材。半导体部门引入 ChatGPT 不到 20 天,出了三件事:一名工程师把设备测量数据库的源代码整段贴进去求改错;一名员工把产量和不良品统计的代码贴进去求优化;还有一名把手机录的会议内容转成文字,喂进去生成纪要。
没有一个人想泄密。他们只是想把活干得快一点。
要命的地方在于,三星当时的三道防线全都是好的。文件加密正常——但员工不是传文件,是把内容“念”给 AI 听,复制粘贴在加密系统眼里跟粘到 Word 里没区别。外发管控正常——但浏览器往 https 网站输入框里打字,网络层看就是一个普通表单提交。权限管理也正常——员工本来就有权看这些数据。
「三道防线一道没坏,数据还是出去了。」
因为 AI 造了一条绕过所有传统防线的新通道,入口是工位上的键盘。
这才是“泄密”两个字的真实含义。它不是怕你知道什么,是怕你把自己知道的东西,顺手贴进一个不受控的地方。
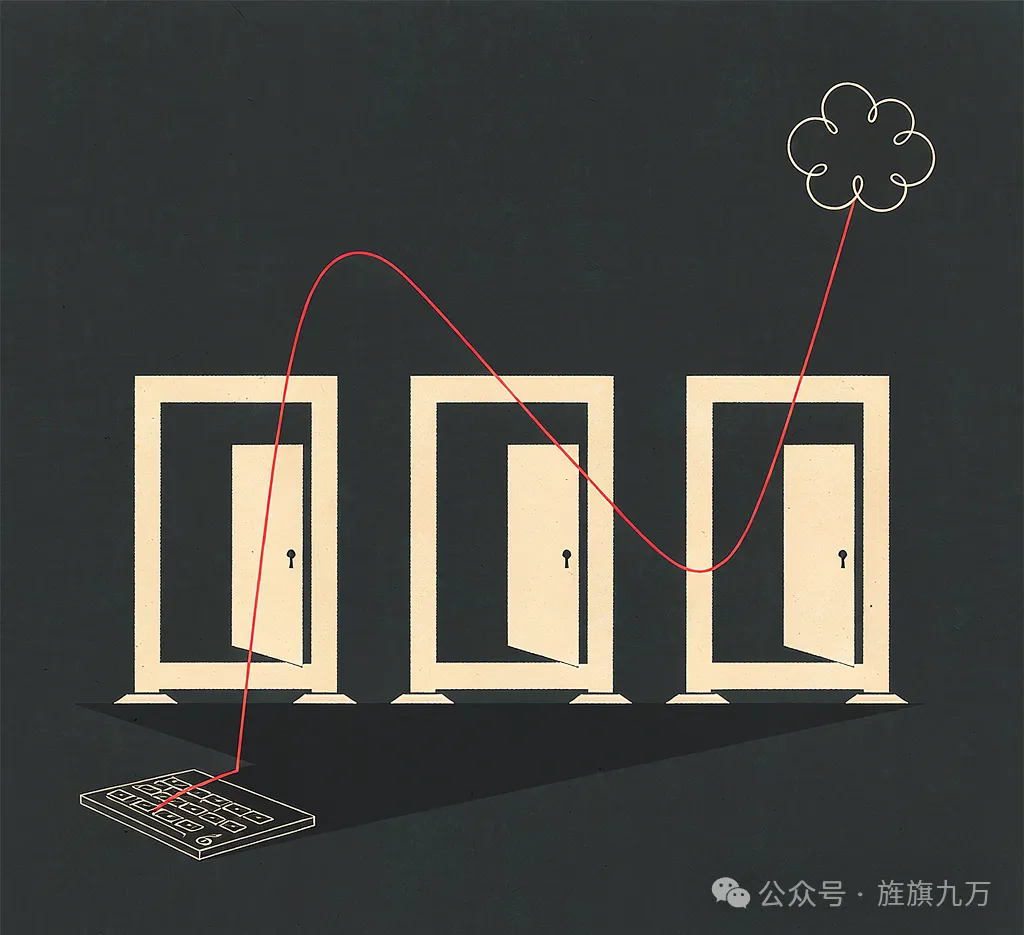
— 三道门都锁着,线从键盘上绕过去了
SIDE EFFECT
禁令的副作用:风险从可见变成不可见
我给企业做 AI 内训,被问过最多次的一个问题是:“有没有办法让员工别用个人号?”
我的回答一直是:有,但你不会喜欢。因为你能封的是工具,封不住的是“想把活干完”这件事。
禁用这个动作,有个绕不开的副作用。
Cyberhaven 去年的调查里,77% 的员工承认把公司数据输入过第三方 AI 工具;而在粘进 ChatGPT 的内容里,11% 属于机密。
77%
承认输过公司数据
11%
粘贴内容是机密
这说明一件事:需求不会因为禁令消失,只会转移。
公司能封住办公电脑上的浏览器,封不住员工口袋里的手机。能拦住公司网络,拦不住家里的宽带。禁令执行得越硬,行为就下沉得越深——从“在公司电脑上用”,变成“用手机拍屏幕、回家再贴”。
对安全团队来说,这是最坏的结局。原来至少还有日志可查,现在连“谁在用”都不知道。
禁止不会让行为消失,只会让行为失去观测。
THREE YEARS
三星三年后的答案,不是禁
有个细节很少有人提。
今年 11 月,三星宣布在全公司范围重新引入 ChatGPT、Gemini 和 Claude。距离它 2023 年那纸禁令,三年。
条件开得很具体:只走企业版,供应商承诺不用客户数据训练;必须完成内部安全培训才能开权限;敏感业务走自研的 Samsung Gauss。
同一家公司,同一类风险,三年后给的答案不是“禁”,是分级 + 企业版 + 培训。
这三样东西拆开看,其实是在回答三个问题:
什么数据可以出去——分级。
出去之后谁负责——企业版合同。
员工知不知道边界在哪——培训。
字节这次的动作,方向是一致的,只是步子更硬:直接掐断个人账号对 L4 资源的访问。管控的着力点,从“工具入口”挪到了“数据出口”。
上次是禁工具,这次是禁通道。这比禁工具聪明,因为它不拦你用什么,只拦你能碰到什么。
FOR YOU
打工人这边,三件事要清楚
骂完公司,还得回到自己的处境。三件事。
第一,分清“公开信息”和“内部信息”。
这次的口径其实给了空间:公开的工作信息、个人生活场景,不受限制。真正被拦的是内部代码库和文档。别把“公司不让我用 AI”当成一句笼统的委屈,它是分层的。
第二,判断标准可以很土。
这段内容如果发到一个陌生人邮箱里,你会不会心慌?会,就别往 AI 里贴。这比背十条合规条款好用。
第三,知道制度是有门槛的。
劳动合同法第 4 条要求,涉及劳动纪律的制度要经职工代表大会或全体职工讨论,还要公示告知。最高法的司法解释也写了,只有经过民主程序、内容合法、并且向劳动者公示的制度,才能作为处理依据。
现实里有公司拿“严重违纪”开人,最后败诉,理由是拿不出公示的证据。这不是鼓励你钻空子,是提醒你:规则要生效,得先成立。
— 线的两边,是两种责任
THE END
结语
回到那个二选一:怕泄密,还是怕你太效率?
我的答案是:都不是。
怕的是看不见。
看不见数据从哪条缝出去,看不见效率到底涨没涨,看不见员工在用什么工具干活。一个组织最怕的从来不是风险本身,是风险不在自己的视野里。
所以这道禁令的本质,不是技术管控,是重新划一条责任线:用公司的账号,责任在公司;用个人的账号,责任在你自己。
这条线划得对不对,可以吵。但它至少是一条能看见的线。
「比大家都在偷偷用、谁也不知道,要强。」
我是旌旗九万,热衷于分享 AI 观察与干货。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。