ARTICLE · 1332699
RAG -- 第 3 章 文档解析与切分
这一章决定了系统的天花板。检索不到的东西,后面所有环节都无能为力。
3.1 一个真实的翻车案例
某公司把 300 份 PDF 制度文件灌进知识库,上线后用户反馈"问住宿标准答不出来"。
排查发现:这些 PDF 是双栏排版的,解析工具按"从左到右、从上到下"逐行读取,把左栏的一行和右栏的一行拼成了同一行:
一线城市住宿上限 450 元 二、交通标准二线城市住宿上限 350 元 高铁二等座实报实销
结果每个 chunk 都是两栏交错的乱码。向量化之后,语义已经彻底错了,再怎么调 top-k、换重排模型都没用。
这个案例说明一件事:解析和切分是"数据加工",不是"工程配置"。它们出错时不会报异常,系统看起来一切正常,只是答得不准——而这种"安静的错误"最难排查。
3.2 各格式的解析要点
PDF:最麻烦的一种
PDF 里没有"段落"这个概念,只有"某个字符画在某个坐标"。所以解析质量取决于工具能否正确还原阅读顺序。
💡判断一个 PDF 有没有文本层:用 PyMuPDF 读第一页的 get_text(),如果返回空字符串或只有零星字符,就是扫描件,必须走 OCR。
Word / Markdown / HTML
这三种格式自带结构(标题层级、列表、表格),一定要保留结构信息,因为它是最好的切分依据。
Word:读 Heading 1/2/3样式,而不是读纯文本Markdown:按 #/##切分天然合理HTML:先去掉 nav/footer/script/style,再抽
<main>或 <article>
Excel / CSV
⚠️这是最容易被错误处理的格式。把表格直接拼成文本会变成:
产品,价格,库存A,100,20B,200,15
模型看不懂哪一行对应哪个表头。
正确做法有两种:
每行转成一句自然语言: 产品 A 的价格是 100 元,库存 20 件。—— 适合行数不多、需要语义检索的场景保留表头作为上下文,按行组切成块,并在每块前重复表头 —— 适合需要保留表格结构的场景
图片
图片本身不能被文本检索。两条路:① OCR 成文字;② 用多模态模型生成图片描述(caption),把描述向量化。后者能检索到"图里画了什么",但成本高。
3.3 清洗清单
解析完之后,别急着切分,先过一遍清洗。下面每一条都是踩过的坑:
^第?\s*\d+\s*页 | ||
\.{3,} 或大量数字结尾的行,整段删 | ||
-\n | ||
\n | ||
\ufffd□ | ||
💡 中文特有的坑:PDF 转文本时常在汉字之间插入空格("差 旅 报 销")。清洗时可以用正则把"单个汉字 + 空格 + 单个汉字"中的空格去掉,但要小心误伤英文。
3.4 切分:为什么不能随便切
核心矛盾
目标:一个 chunk 只讲一件事,且这件事是完整的。
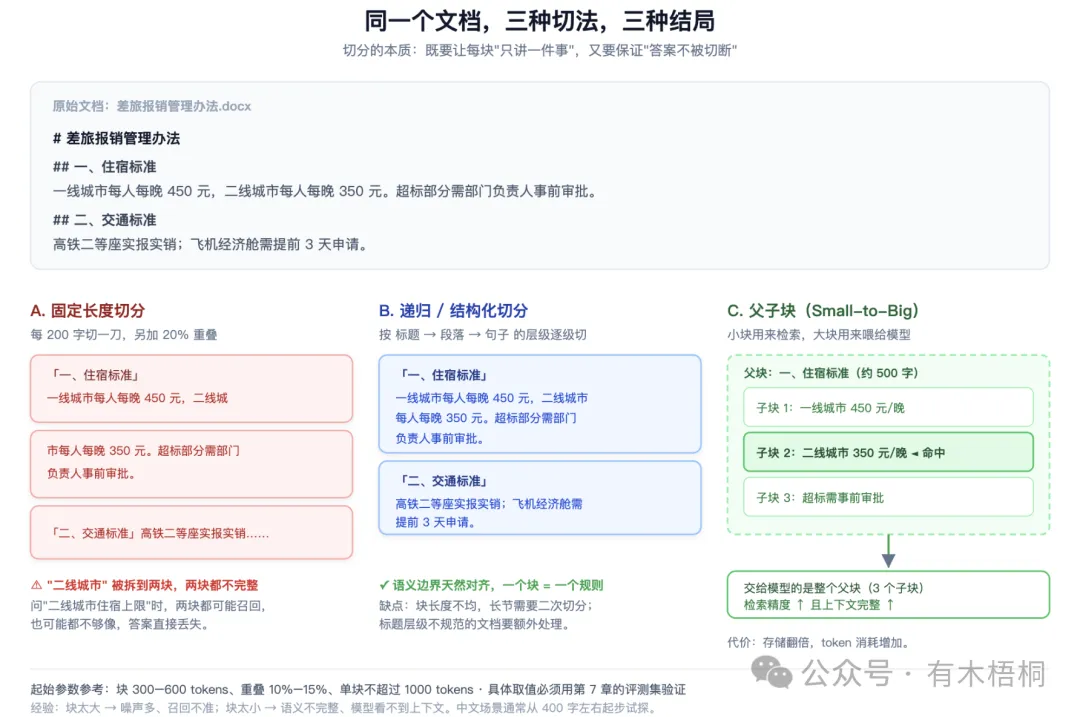
策略一:固定长度切分
按字符数或 token 数硬切,加一点重叠。
def fixed_split(text, size=500, overlap=50):chunks, start = [], 0while start < len(text):chunks.append(text[start:start + size])start += size - overlapreturn chunks
优点:实现最简单,块大小可控。缺点:会在句子中间切断,语义破损。适用:日志、代码、无结构的连续文本;或作为兜底方案。
策略二:递归 / 结构化切分(推荐默认)
按"段落 → 句子 → 逗号"的优先级递归切:先尝试用大分隔符切,块还是太大就用更细的分隔符,直到满足大小限制。
def recursive_split(text, max_size=500, separators=None):if separators is None:separators = [”\n\n”, ”\n”, ”。”, ”!”, ”?”, ”;”, ”,”, ””]sep = separators[0]parts = text.split(sep) if sep else list(text)chunks, buf = [], ””for p in parts:piece = p + sep if sep else pif len(buf) + len(piece) <= max_size:buf += pieceelse:if buf:chunks.append(buf)if len(piece) > max_size and len(separators) > 1:chunks.extend(recursive_split(piece, max_size, separators[1:]))buf = ””else:buf = pieceif buf:chunks.append(buf)return chunks
优点:尽量在语义边界断开,块大小又不失控。适用:绝大多数场景的默认选择。
策略三:结构感知切分(最适合制度/手册/文档类)
利用文档自带的标题层级切分:每个二级标题下的内容作为一个块;如果太长,再按段落二次切。
这样切出来的块,天然"一个块 = 一个小节 = 一个完整规则"。
策略四:语义切分
把文本按句子拆开,计算相邻句子的向量相似度,在相似度骤降的地方切一刀(说明换话题了)。
优点:切点最符合语义。缺点:要为每个句子算向量,成本高;且相似度阈值难调,容易切得过碎。
💡 实践经验:语义切分听起来最优雅,实际收益往往不如"结构感知 + 递归"。因为文档的作者已经用标题帮你划好了语义边界,没必要再猜一遍。
3.5 五个决定成败的细节
细节一:块大小怎么定
🔧 起始区间:300–600 tokens(中文约 300–500 字),单块不超过 1000 tokens。
调整方向:
检索结果"总是不相关" → 块太大,试着缩小 检索结果"相关但不完整,答一半" → 块太小,试着放大 问题需要跨段落推理("比较 A 和 B 两个方案")→ 用父子块或加大块
📌 不要指望一次调对。用第 7 章的评测集,把 300/500/800 三档都跑一遍,看 Recall@10 的变化。
细节二:overlap 要不要加
重叠的作用是防止"答案正好落在切口上"。
🔧 推荐10%–15%(块 500 字,重叠 50–75 字)。
⚠️ 重叠不是越多越好:重叠 50% 意味着索引体积翻倍、检索结果里一半是重复内容、还会挤占上下文预算。
细节三:给每个块加上下文(这是性价比最高的技巧之一)
一个孤立的块长这样:
一线城市每人每晚 450 元,二线城市每人每晚 350 元。问题是:它没说是"住宿费"、也没说是哪家公司。如果用户问"出差住宿能报多少",这个块可能因为缺少"住宿"二字而排在后面。
解决办法:在块前面拼接"标题路径"。
【差旅报销管理办法 > 一、住宿标准】一线城市每人每晚 450 元,二线城市每人每晚 350 元。
这样做的效果通常比换一个更强的 Embedding 模型更明显,而且几乎零成本。强烈建议默认开启。
更进阶的做法是给每个块生成一句"上下文摘要"(用 LLM 概括该块在全文中的位置),但这会增加索引成本。
细节四:表格和代码不要切
表格被切开就没有意义了(表头在一半,数据在另一半)。代码被切开就会语法错误。
处理原则:
表格:整表作为一块;太大时按行切,但每块都要重复表头 代码:按函数/类切分,而不是按行数
细节五:父子块(Small-to-Big)
用小块做检索(精准),命中后返回它所属的大块给模型(完整)。
父块:一、住宿标准(整节 500 字)├─ 子块1:一线城市 450 元 ← 检索用├─ 子块2:二线城市 350 元 ← 命中└─ 子块3:超标需审批
命中子块 2,但交给模型的是整个父块,模型能看到完整语境。
代价:存储翻倍,上下文 token 增加。收益:解决"检索准但答不全"的经典问题。
3.6 一个可以直接用的切分器
下面这段代码把上面的要点合在一起:结构感知 + 递归兜底 + 标题路径 + 元数据。
import refrom dataclasses import dataclass, field@dataclassclass Chunk:text: strdoc_id: strtitle_path: str = ””index: int = 0meta: dict = field(default_factory=dict)def split_markdown(doc_id: str, md: str, max_chars: int = 500,overlap: int = 60, min_chars: int = 80):”””按 Markdown 标题层级切分,超长小节再按段落递归切。”””chunks = []# 1. 按标题切段,记录标题路径sections = []# [(title_path, body)]path = []# 当前标题栈buf = []for line in md.splitlines():m = re.match(r”^(#{1,6})\s+(.*)$”, line)if m:if buf:sections.append((” > ”.join(path), ”\n”.join(buf).strip()))buf = []level, title = len(m.group(1)), m.group(2).strip()path = path[:level - 1] + [title]else:buf.append(line)if buf:sections.append((” > ”.join(path), ”\n”.join(buf).strip()))# 2. 每节内部按段落聚合到 max_charsidx = 0for title_path, body in sections:if not body:continueparas = [p.strip() for p in re.split(r”\n\s*\n”, body) if p.strip()]cur = ””for p in paras:if len(cur) + len(p) + 1 <= max_chars:cur = f”{cur}\n{p}” if cur else pelse:if cur:chunks.append(Chunk(f”【{title_path}】\n{cur}”, doc_id,title_path, idx)); idx += 1# 单段就超长 → 按句子硬切while len(p) > max_chars:cut = p.rfind(”。”, 0, max_chars)cut = cut + 1 if cut > max_chars // 3 else max_charschunks.append(Chunk(f”【{title_path}】\n{p[:cut]}”, doc_id,title_path, idx)); idx += 1p = p[max(0, cut - overlap):]cur = pif cur and len(cur) >= min_chars:chunks.append(Chunk(f”【{title_path}】\n{cur}”, doc_id, title_path, idx)); idx += 1return chunks
用一段测试文本跑一下:
md = ”””# 差旅报销管理办法## 一、住宿标准一线城市每人每晚 450 元,二线城市每人每晚 350 元。超标部分需部门负责人事前审批。## 二、交通标准高铁二等座实报实销;飞机经济舱需提前 3 天申请。”””for c in split_markdown(”doc-001”, md, max_chars=200):print(repr(c.text[:50]), ”|”, c.title_path)
输出:
'【差旅报销管理办法 > 一、住宿标准】\n一线城市每人每晚 450 元...' | 差旅报销管理办法 > 一、住宿标准'【差旅报销管理办法 > 二、交通标准】\n高铁二等座实报实销...' | 差旅报销管理办法 > 二、交通标准
注意 【标题路径】 这个前缀同时也进了向量——它既帮检索,也帮模型理解上下文。
3.7 怎么验证切分质量
不用等整个系统搭完,切分做完就能验:
随机抽 20 个 chunk 人工看:是不是每块都"讲一件事且完整"?有没有从中间断开的句子?有没有两栏交错的乱码? 反查测试:拿 10 个业务问题,人工在原文里找到答案,看答案所在的句子是否完整落在某一个 chunk 里。如果答案是"跨了两个 chunk 各一半",说明切分有问题。 统计分布:块长度分布是否集中在设定值附近?如果出现大量超长块或极短块(<50 字),说明分隔符没生效。
💡 第 2 条最关键。如果答案本身被切断了,检索做得再好也拼不回来。