文档文本内容
第3 讲 统计与成对数据的统计分析
1.(2025·全国Ⅱ卷,T1)样本数据2,8,14,16,20 的平均数为(  )
A.8
B.9
C.12
D.18
2.(2023·新课标Ⅱ卷,T3)某学校为了解学生参加体育运动的情况,用比例分配的分层随机抽样方法作抽样
调查,拟从初中部和高中部两层共抽取60 名学生,已知该校初中部和高中部分别有400 名和200 名学生,
则不同的抽样结果共有(  )
A.C400
45 ·C200
15 种
B.C400
20 ·C200
40 种
C.C400
30 ·C200
30 种
D.C400
40 ·C200
20 种
3.(2025·天津,T5)下列说法中错误的是(  )
A.若X~N(μ,σ2),则P(X≤μ-σ)=P(X≥μ+σ)
B.若X~N(1,22),Y~N(2,22),则P(X<1)<P(Y<2)
C.|r|越接近1,相关性越强
D.|r|越接近0,相关性越弱
4.(2025·全国Ⅰ卷,T15)为研究某疾病与超声波检查结果的关系,从做过超声波检查的人群中随机调查了1
000 人,得到如下列联表:
组别
超声波检查结果
合计
正常
不正常
患该疾病
20
180
200
未患该疾病
780
20
800
合计
800
200
1 000
(1)记超声波检查结果不正常者患该疾病的概率为p,求p 的估计值;
(2)根据小概率值α=0.001 的独立性检验,分析超声波检查结果是否与患该疾病有关.
附:χ2=
n(ad -bc)
2
(a+b)(c +d )(a+c)(b+d ),
α
0.05
0.010
0.001
xα
3.841
6.635
10.828
命题热度:
本讲是历年高考命题必考的内容,属于中低档题目,三种题型都有所考查,分值约为5~15 分.
考查方向:
一是统计知识,如样本数据数字特征计算与频率分布直方图等相结合进行考查;二是一元线性回归模型的
分析,以社会实际生产生活问题为情境的回归直线方程的求解与应用;三是独立性检验,实际生活背景下
的两类变量之间的相关性检验.
1.答案 C
解析 样本数据2,8,14,16,20 的平均数为2+8+14+16+20
5
=12.
2.答案 D
解析 根据比例分配的分层随机抽样的定义知,初中部共抽取60×400
600=40(人),高中部共抽取60×200
600
=20(人),根据组合公式和分步乘法计数原理知,不同的抽样结果共有C 400
40 ·C200
20 种.
3.答案 B
解析 根据正态分布的对称性可知,若X~N(μ,σ2),则P(X≤μ-σ)=P(X≥μ+σ),故A 正确;若X~N(1,
22),Y~N(2,22),则P(X<1)=P(Y<2)=0.5,故B 错误;样本相关系数r 的绝对值越接近0,相关性越弱,越
接近1,相关性越强,故C,D 正确.
4.解 (1)根据表格可知,超声波检查结果不正常的200 人中有180 人患该疾病,
所以p 的估计值为180
200= 9
10.
(2)零假设为H0:超声波检查结果与患该疾病无关,
根据表中数据可得,
χ2=1 000×(20×20-180×780)
2
200×800×800×200
=765.625>10.828=x0.001,
根据小概率值α=0.001 的独立性检验,我们推断H0不成立,即认为超声波检查结果与患该疾病有关,此推
断犯错误的概率不超过0.001.
考点一 统计图表、数字特征
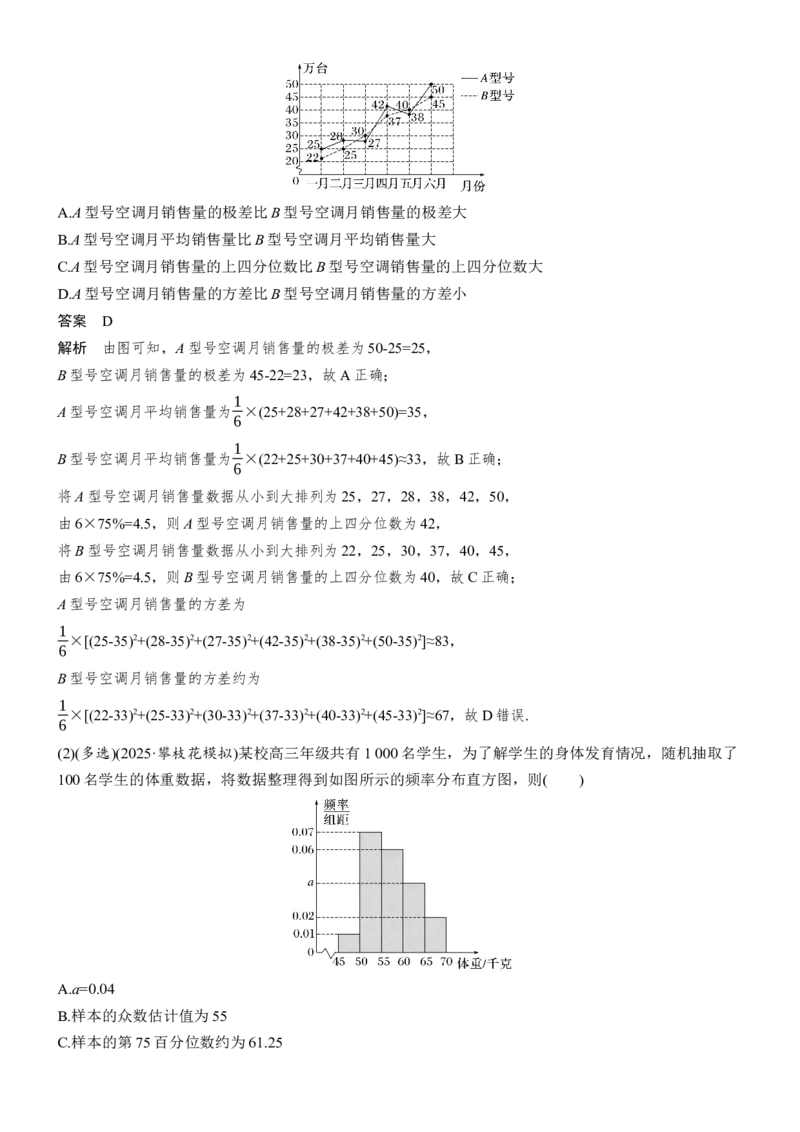
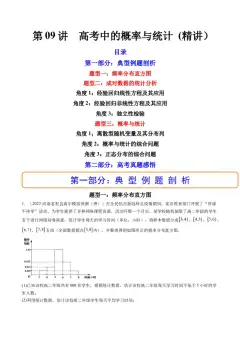
例1 (1)(2025·绵阳模拟)某家电公司生产了A,B 两种不同型号的空调,公司统计了某地区2024 年的前
6 个月这两种型号的空调的销售情况,得到销售量的折线图如图所示,分析这6 个月的销售数据,下列
说法不正确的是(  )
A.A 型号空调月销售量的极差比B 型号空调月销售量的极差大
B.A 型号空调月平均销售量比B 型号空调月平均销售量大
C.A 型号空调月销售量的上四分位数比B 型号空调销售量的上四分位数大
D.A 型号空调月销售量的方差比B 型号空调月销售量的方差小
答案 D
解析 由图可知,A 型号空调月销售量的极差为50-25=25,
B 型号空调月销售量的极差为45-22=23,故A 正确;
A 型号空调月平均销售量为1
6×(25+28+27+42+38+50)=35,
B 型号空调月平均销售量为1
6×(22+25+30+37+40+45)≈33,故B 正确;
将A 型号空调月销售量数据从小到大排列为25,27,28,38,42,50,
由6×75%=4.5,则A 型号空调月销售量的上四分位数为42,
将B 型号空调月销售量数据从小到大排列为22,25,30,37,40,45,
由6×75%=4.5,则B 型号空调月销售量的上四分位数为40,故C 正确;
A 型号空调月销售量的方差为
1
6×[(25-35)2+(28-35)2+(27-35)2+(42-35)2+(38-35)2+(50-35)2]≈83,
B 型号空调月销售量的方差约为
1
6×[(22-33)2+(25-33)2+(30-33)2+(37-33)2+(40-33)2+(45-33)2]≈67,故D 错误.
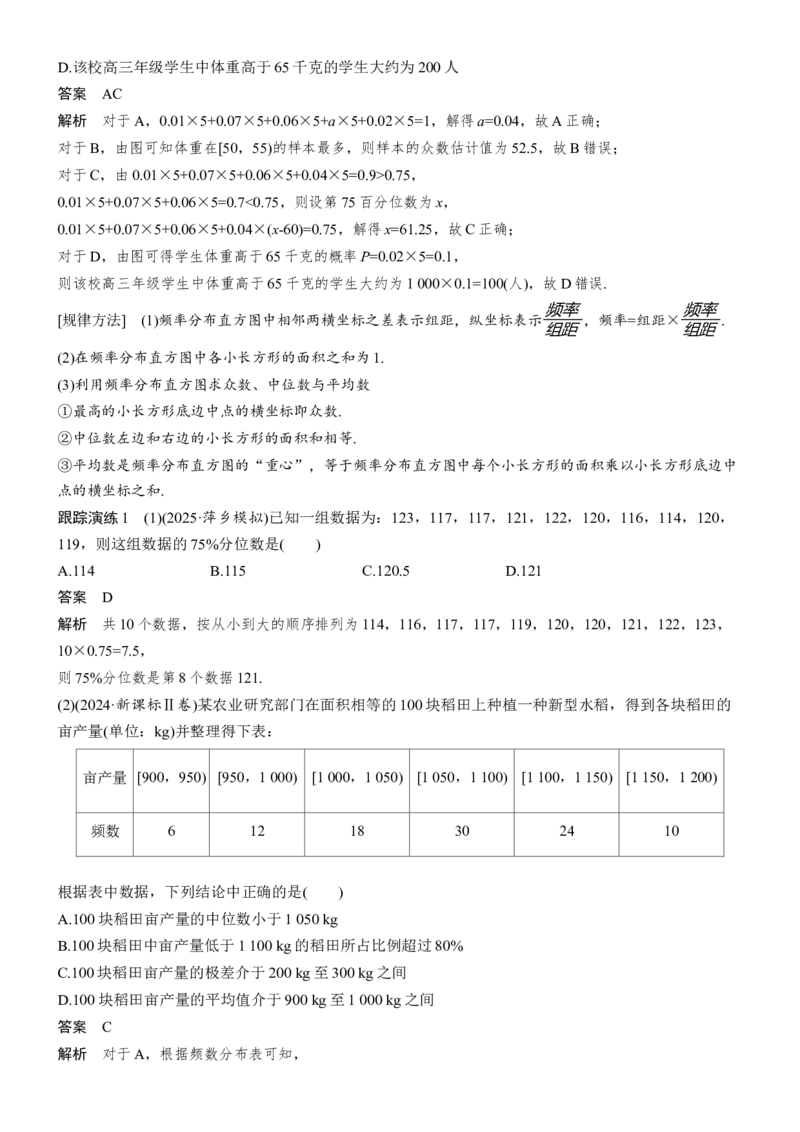
(2)(多选)(2025·攀枝花模拟)某校高三年级共有1 000 名学生,为了解学生的身体发育情况,随机抽取了
100 名学生的体重数据,将数据整理得到如图所示的频率分布直方图,则(  )
A.a=0.04
B.样本的众数估计值为55
C.样本的第75 百分位数约为61.25
D.该校高三年级学生中体重高于65 千克的学生大约为200 人
答案 AC
解析 对于A,0.01×5+0.07×5+0.06×5+a×5+0.02×5=1,解得a=0.04,故A 正确;
对于B,由图可知体重在[50,55)的样本最多,则样本的众数估计值为52.5,故B 错误;
对于C,由0.01×5+0.07×5+0.06×5+0.04×5=0.9>0.75,
0.01×5+0.07×5+0.06×5=0.7<0.75,则设第75 百分位数为x,
0.01×5+0.07×5+0.06×5+0.04×(x-60)=0.75,解得x=61.25,故C 正确;
对于D,由图可得学生体重高于65 千克的概率P=0.02×5=0.1,
则该校高三年级学生中体重高于65 千克的学生大约为1 000×0.1=100(人),故D 错误.
[规律方法] (1)频率分布直方图中相邻两横坐标之差表示组距,纵坐标表示频率
组距,频率=组距× 频率
组距.
(2)在频率分布直方图中各小长方形的面积之和为1.
(3)利用频率分布直方图求众数、中位数与平均数
①最高的小长方形底边中点的横坐标即众数.
②中位数左边和右边的小长方形的面积和相等.
③平均数是频率分布直方图的“重心”,等于频率分布直方图中每个小长方形的面积乘以小长方形底边中
点的横坐标之和.
跟踪演练1 (1)(2025·萍乡模拟)已知一组数据为:123,117,117,121,122,120,116,114,120,
119,则这组数据的75%分位数是(  )
A.114
B.115
C.120.5
D.121
答案 D
解析 共10 个数据,按从小到大的顺序排列为114,116,117,117,119,120,120,121,122,123,
10×0.75=7.5,
则75%分位数是第8 个数据121.
(2)(2024·新课标Ⅱ卷)某农业研究部门在面积相等的100 块稻田上种植一种新型水稻,得到各块稻田的
亩产量(单位:kg)并整理得下表:
亩产量[900,950) [950,1 000)
[1 000,1 050)
[1 050,1 100)
[1 100,1 150)
[1 150,1 200)
频数
6
12
18
30
24
10
根据表中数据,下列结论中正确的是(  )
A.100 块稻田亩产量的中位数小于1 050 kg
B.100 块稻田中亩产量低于1 100 kg 的稻田所占比例超过80%
C.100 块稻田亩产量的极差介于200 kg 至300 kg 之间
D.100 块稻田亩产量的平均值介于900 kg 至1 000 kg 之间
答案 C
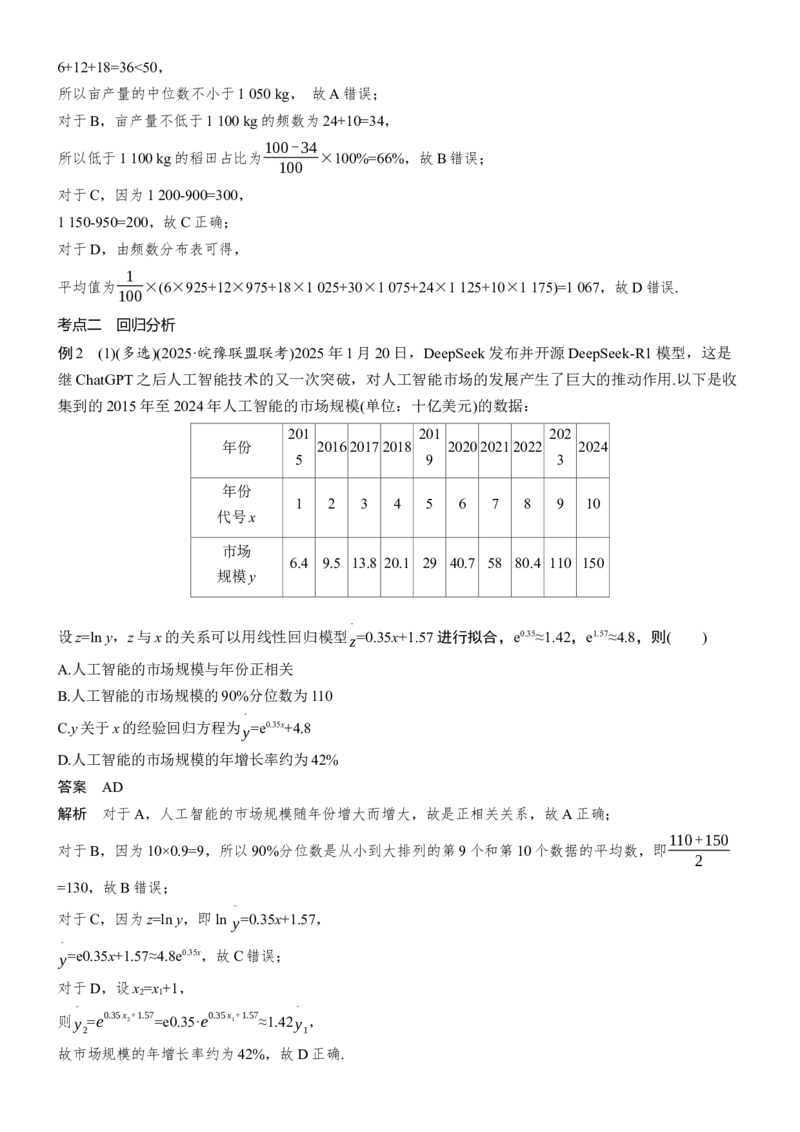
解析 对于A,根据频数分布表可知,
6+12+18=36<50,
所以亩产量的中位数不小于1 050 kg, 故A 错误;
对于B,亩产量不低于1 100 kg 的频数为24+10=34,
所以低于1 100 kg 的稻田占比为100-34
100
×100%=66%,故B 错误;
对于C,因为1 200-900=300,
1 150-950=200,故C 正确;
对于D,由频数分布表可得,
平均值为1
100×(6×925+12×975+18×1 025+30×1 075+24×1 125+10×1 175)=1 067,故D 错误.
考点二 回归分析
例2 (1)(多选)(2025·皖豫联盟联考)2025 年1 月20 日,DeepSeek 发布并开源DeepSeek-R1 模型,这是
继ChatGPT 之后人工智能技术的又一次突破,对人工智能市场的发展产生了巨大的推动作用.以下是收
集到的2015 年至2024 年人工智能的市场规模(单位:十亿美元)的数据:
年份
201
5
2016 2017 2018
201
9
2020 2021 2022
202
3
2024
年份
代号x
1
2
3
4
5
6
7
8
9
10
市场
规模y
6.4
9.5 13.8 20.1
29
40.7
58
80.4 110 150
设z=ln y,z 与x 的关系可以用线性回归模型z
^=0.35x+1.57 进行拟合,e0.35≈1.42,e1.57≈4.8,则(  )
A.人工智能的市场规模与年份正相关
B.人工智能的市场规模的90%分位数为110
C.y 关于x 的经验回归方程为y
^ =e0.35x+4.8
D.人工智能的市场规模的年增长率约为42%
答案 AD
解析 对于A,人工智能的市场规模随年份增大而增大,故是正相关关系,故A 正确;
对于B,因为10×0.9=9,所以90%分位数是从小到大排列的第9 个和第10 个数据的平均数,即110+150
2
=130,故B 错误;
对于C,因为z=ln y,即ln y
^ =0.35x+1.57,
y
^ =e0.35x+1.57≈4.8e0.35x,故C 错误;
对于D,设x2=x1+1,
则y
^
2=e
0.35 x2+1.57=e0.35·e
0.35 x1+1.57≈1.42y
^
1,
故市场规模的年增长率约为42%,故D 正确.
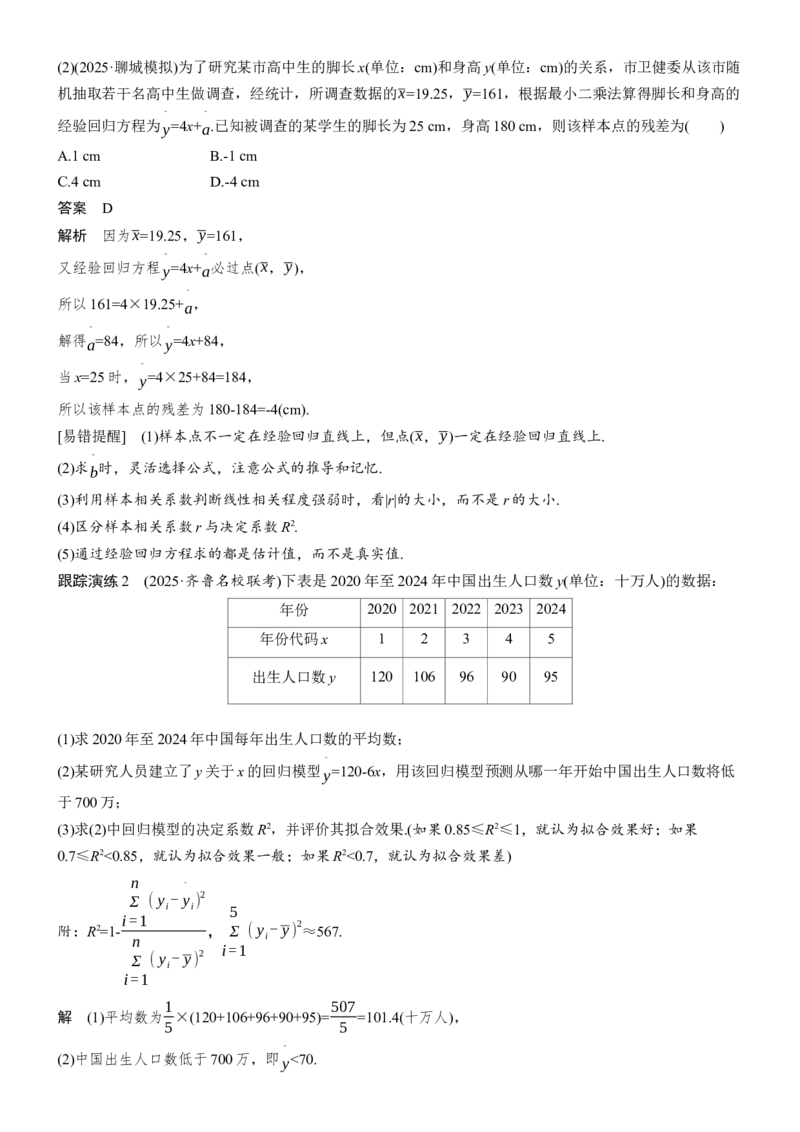
(2)(2025·聊城模拟)为了研究某市高中生的脚长x(单位:cm)和身高y(单位:cm)的关系,市卫健委从该市随
机抽取若干名高中生做调查,经统计,所调查数据的x=19.25,y=161,根据最小二乘法算得脚长和身高的
经验回归方程为y
^ =4x+a
^.已知被调查的某学生的脚长为25 cm,身高180 cm,则该样本点的残差为(  )
A.1 cm
B.-1 cm
C.4 cm
D.-4 cm
答案 D
解析 因为x=19.25,y=161,
又经验回归方程y
^ =4x+a
^必过点(x,y),
所以161=4×19.25+a
^,
解得a
^=84,所以y
^ =4x+84,
当x=25 时,y
^ =4×25+84=184,
所以该样本点的残差为180-184=-4(cm).
[易错提醒] (1)样本点不一定在经验回归直线上,但点(x,y)一定在经验回归直线上.
(2)求b
^时,灵活选择公式,注意公式的推导和记忆.
(3)利用样本相关系数判断线性相关程度强弱时,看|r|的大小,而不是r 的大小.
(4)区分样本相关系数r 与决定系数R2.
(5)通过经验回归方程求的都是估计值,而不是真实值.
跟踪演练2 (2025·齐鲁名校联考)下表是2020 年至2024 年中国出生人口数y(单位:十万人)的数据:
年份
2020
2021
2022
2023
2024
年份代码x
1
2
3
4
5
出生人口数y
120
106
96
90
95
(1)求2020 年至2024 年中国每年出生人口数的平均数;
(2)某研究人员建立了y 关于x 的回归模型y
^ =120-6x,用该回归模型预测从哪一年开始中国出生人口数将低
于700 万;
(3)求(2)中回归模型的决定系数R2,并评价其拟合效果.(如果0.85≤R2≤1,就认为拟合效果好;如果
0.7≤R2<0.85,就认为拟合效果一般;如果R2<0.7,就认为拟合效果差)
附:R2=1-
n
Σ
i=1
( yi- y
^
i)
2
n
Σ
i=1
( yi- y)
2
,
5
Σ
i=1
( yi- y)
2≈567.
解 (1)平均数为1
5×(120+106+96+90+95)=507
5 =101.4(十万人),
(2)中国出生人口数低于700 万,即y
^ <70.
y
^ =120-6x<70,解得x>25
3 ,x∈N*,
当x=8 时,y
^ =120-6×8=72>70,
当x=9 时,y
^ =120-6×9=66<70,
x=9 对应2028 年,即预测从2028 年开始中国出生人口数将低于700 万.
(3)当x=1 时,y
^ =120-6×1=114,(y1-y
^
1)2=(120-114)2=36,
当x=2 时,y
^ =120-6×2=108,(y2-y
^
2)2=(106-108)2=4,
当x=3 时,y
^ =120-6×3=102,(y3-y
^
3)2=(96-102)2=36,
当x=4 时,y
^ =120-6×4=96,(y4-y
^
4)2=(90-96)2=36,
当x=5 时,y
^ =120-6×5=90,(y5-y
^
5)2=(95-90)2=25,
所以R2=1-
5
Σ
i=1
( yi- y
^
i)
2
5
Σ
i=1
( yi- y)
2
≈1-36+ 4+36+36+25
567
=430
567 ≈0.76,
因为0.7≤R2<0.85,所以这个模型的拟合效果一般.
考点三 独立性检验
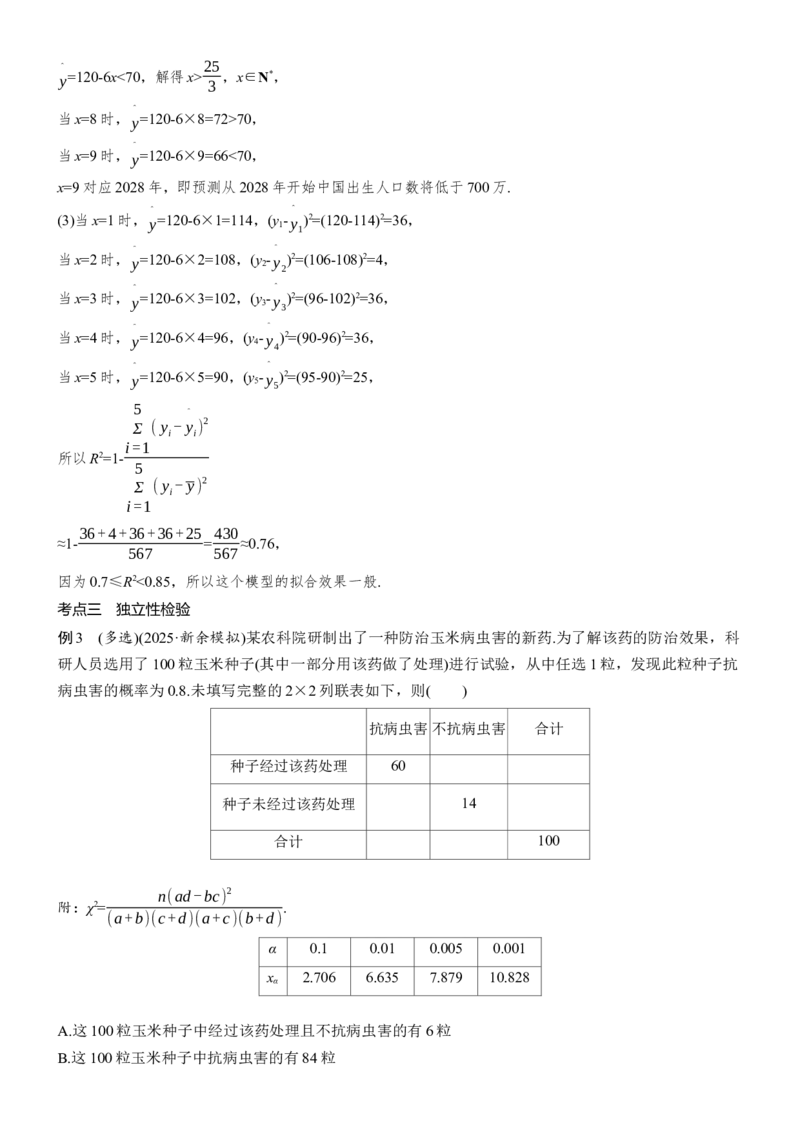
例3 (多选)(2025·新余模拟)某农科院研制出了一种防治玉米病虫害的新药.为了解该药的防治效果,科
研人员选用了100 粒玉米种子(其中一部分用该药做了处理)进行试验,从中任选1 粒,发现此粒种子抗
病虫害的概率为0.8.未填写完整的2×2 列联表如下,则(  )
抗病虫害不抗病虫害
合计
种子经过该药处理
60
种子未经过该药处理
14
合计
100
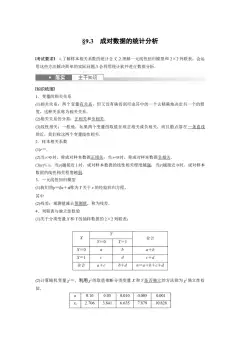
附:χ2=
n(ad -bc)
2
(a+b)(c +d )(a+c)(b+d ).
α
0.1
0.01
0.005
0.001
xα
2.706
6.635
7.879
10.828
A.这100 粒玉米种子中经过该药处理且不抗病虫害的有6 粒
B.这100 粒玉米种子中抗病虫害的有84 粒
C.χ2的观测值约为13.428
D.根据小概率值α=0.001 的独立性检验,可以认为该新药有效
答案 AD
解析 由题可将2×2 列联表补充完整如表.
抗病虫害不抗病虫害
合计
种子经过该药处理
60
6
66
种子未经过该药处
理
20
14
34
合计
80
20
100
由表可知A 正确,B 错误;
零假设为H0:种子抗病虫害与该新药无关,由表可知χ2=100×(60×14 -20×6)
2
66×34×80×20
≈14.439>10.828,因此根
据小概率值α=0.001 的独立性检验,推断H0不成立,即可以认为该新药有效,故C 错误,D 正确.
[易错提醒] (1)χ2越大,两分类变量无关的可能性越小,推断犯错误的概率越小,通过表格查得无关的可
能性.
(2)在犯错误的概率不大于0.01 的前提下认为两个变量有关,并不是指两个变量无关的可能性为0.01.
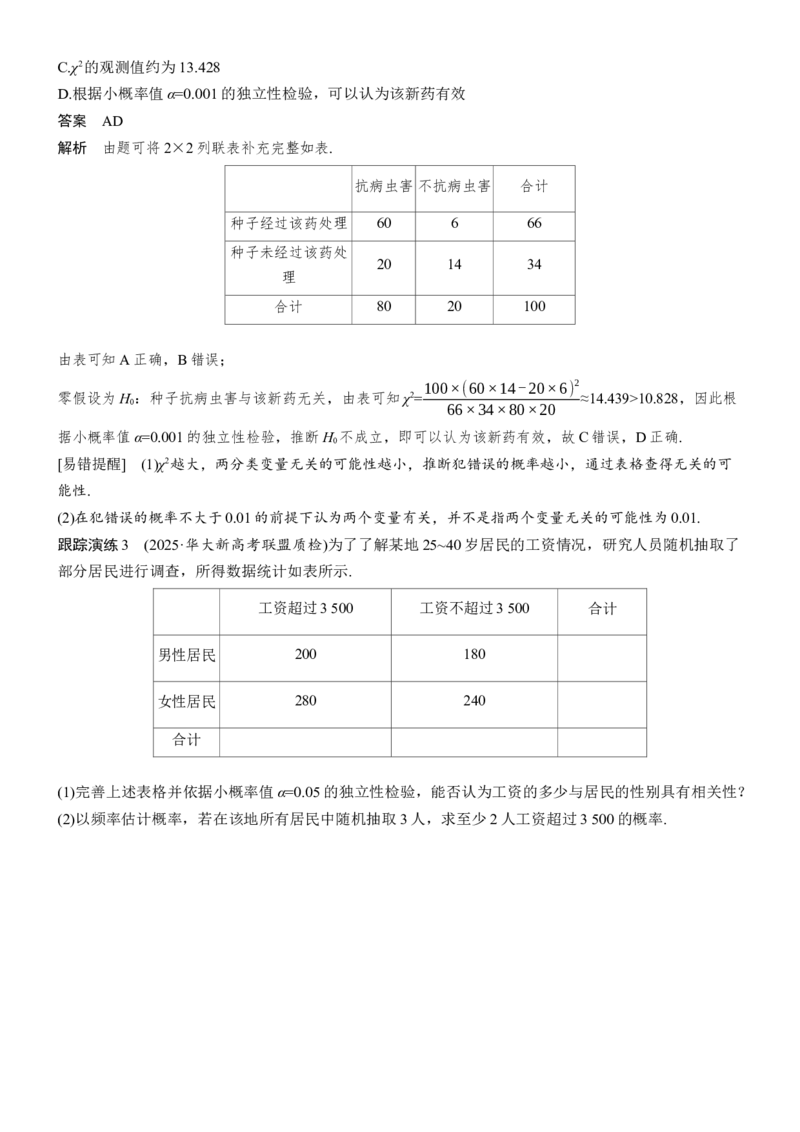
跟踪演练3 (2025·华大新高考联盟质检)为了了解某地25~40 岁居民的工资情况,研究人员随机抽取了
部分居民进行调查,所得数据统计如表所示.
工资超过3 500
工资不超过3 500
合计
男性居民
200
180
女性居民
280
240
合计
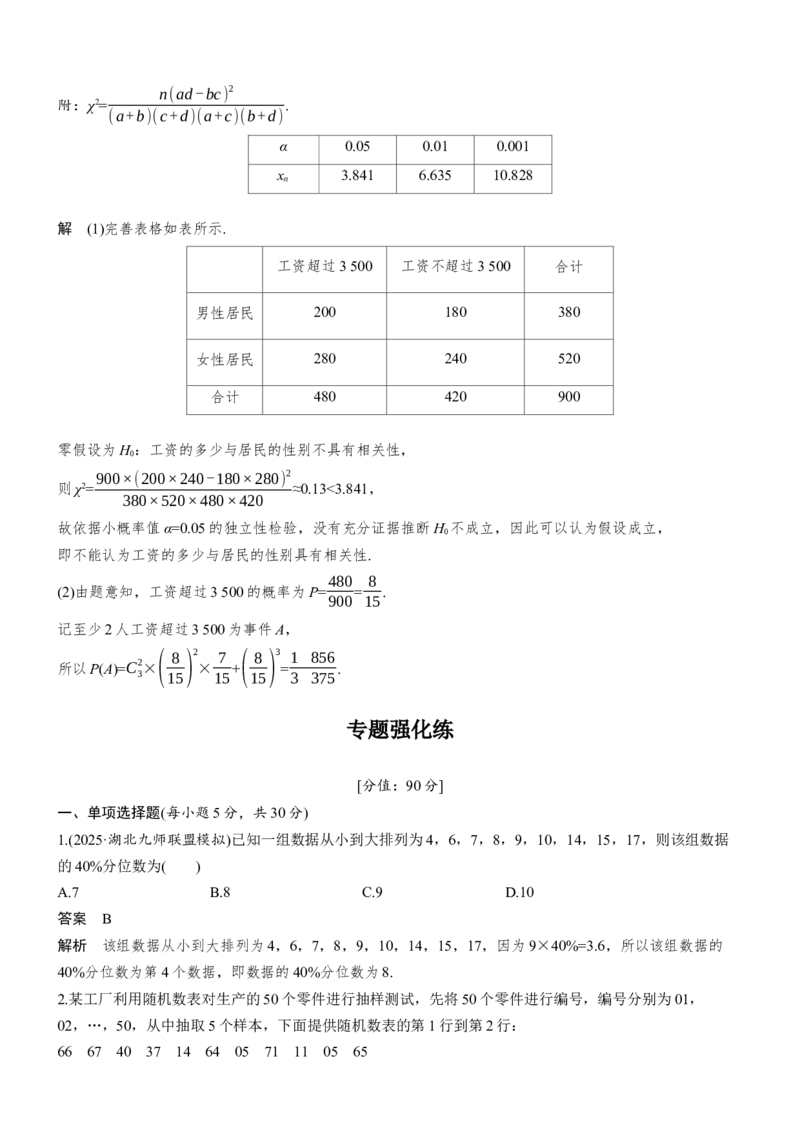
(1)完善上述表格并依据小概率值α=0.05 的独立性检验,能否认为工资的多少与居民的性别具有相关性?
(2)以频率估计概率,若在该地所有居民中随机抽取3 人,求至少2 人工资超过3 500 的概率.
附:χ2=
n(ad -bc)
2
(a+b)(c +d)(a+c)(b+d ).
α
0.05
0.01
0.001
xα
3.841
6.635
10.828
解 (1)完善表格如表所示.
工资超过3 500
工资不超过3 500
合计
男性居民
200
180
380
女性居民
280
240
520
合计
480
420
900
零假设为H0:工资的多少与居民的性别不具有相关性,
则χ2=900×(200×240-180×280)
2
380×520×480×420
≈0.13<3.841,
故依据小概率值α=0.05 的独立性检验,没有充分证据推断H0不成立,因此可以认为假设成立,
即不能认为工资的多少与居民的性别具有相关性.
(2)由题意知,工资超过3 500 的概率为P=480
900= 8
15.
记至少2 人工资超过3 500 为事件A,
所以P(A)=C3
2×(
8
15)
2
× 7
15+(
8
15)
3
=1 856
3 375.
专题强化练
[分值:90 分]
一、单项选择题(每小题5 分,共30 分)
1.(2025·湖北九师联盟模拟)已知一组数据从小到大排列为4,6,7,8,9,10,14,15,17,则该组数据
的40%分位数为(  )
A.7
B.8
C.9
D.10
答案 B
解析 该组数据从小到大排列为4,6,7,8,9,10,14,15,17,因为9×40%=3.6,所以该组数据的
40%分位数为第4 个数据,即数据的40%分位数为8.
2.某工厂利用随机数表对生产的50 个零件进行抽样测试,先将50 个零件进行编号,编号分别为01,
02,…,50,从中抽取5 个样本,下面提供随机数表的第1 行到第2 行:
66 67 40 37 14 64 05 71 11 05 65
09 95 86 68 76 83 20 37 90
57 16 03 11 63 14 90 84 45 21 75
73 88 05 90 52 23 59 43 10
若从表中第1 行第9 列开始向右依次读取数据,则得到的第4 个样本的编号是(  )
A.10
B.09
C.71
D.20
答案 B
解析 从随机数表第1 行的第9 列数字开始由左向右每次连续读取2 个数字,删除超出范围及重复的编号,
符合条件的编号有14,05,11,09,20,所以选出来的第4 个样本的编号为09.
3.(2025·东三省四市教研联合体模拟)为了了解学校质量监测成绩,现随机抽取该校200 名学生的成绩作为
样本进行分析,并绘制频率分布直方图,若该频率分布直方图的组距为10,且样本中成绩在区间[92.5,
102.5)这一组内的学生有40 人,则在频率分布直方图中该组数据对应的矩形高度为(  )
A.0.02
B.0.2
C.0.04
D.0.4
答案 A
解析 由题意成绩在区间[92.5,102.5)内学生的频率为40
200=0.2,频率
组距=0.02,即所求矩形高度为0.02.
4.(2025·安康联考)有一组样本数据x1,x2,…,xn,其平均数为x1,方差为s1
2,若样本数据-x1+1,-
x2+1,…,-xn+1 的平均数为x2,方差为s2
2,则(  )
A.x2=x1-1
B.x2=x1
C.s1
2=s2
2
D.s1
2>s2
2
答案 C
解析 根据样本数据平均数公式可知,x2=-x1+1,方差s2
2=(-1)2s1
2=s1
2.
5.某在线平台利用AI 技术为学生提供个性化学习路径,为了解学生对平台的满意程度,随机抽取使用该平
台的学生进行打分,将收集到的分数按照[30,40),[40,50),[50,60),[60,70),[70,80),[80,90),
[90,100]分组,画出频率分布直方图如图所示,则这些数据的中位数约为(  )
A.85
B.80
C.77.5
D.75
答案 C
解析 由于(0.005+0.005+0.010+0.015)×10=0.35,(0.005+0.005+0.010+0.015+0.020)×10=0.55,
因此中位数落在区间[70,80)内,设中位数为x,
由0.35+0.020×(x-70)=0.5,得x=77.5,因此,中位数约为77.5.
6.某校为了解本校高一男生身高和体重的相关关系,在该校高一年级随机抽取了7 名男生,测量了他们的
身高和体重得下表:
身高x(单位:cm)
167 173 175 177 178 180
181
体重y(单位:kg)
90
54
59
64
67
72
76
由表格制作成如图所示的散点图:
由最小二乘法计算得到经验回归直线l1的方程为y
^ =b
^
1x+a
^
1,其样本相关系数为r1;经过残差分析,点
(167,90)对应残差过大,把它去掉后,再用剩下的6 组数据计算得到经验回归直线l2的方程为y
^ =b
^
2x+a
^
2,
样本相关系数为r2.则下列选项正确的是(  )
A.b
^
1>b
^
2,a
^
1>a
^
2,r1<r2
B.b
^
1>b
^
2,a
^
1<a
^
2,r1>r2
C.b
^
1<b
^
2,a
^
1<a
^
2,r1>r2
D.b
^
1<b
^
2,a
^
1>a
^
2,r1<r2
答案 D
解析 这7 个身高的平均数
x=167+173+175+177+178+180+181
7
≈176,
因为点(167,90)的横坐标167 小于平均值176,纵坐标90 相对过大,所以去掉该点后经验回归直线的截距
变小,而斜率变大,所以a
^
1>a
^
2,b
^
1<b
^
2,
又r1>0,r2>0,且去掉点(167,90)后成对样本数据的线性相关程度更强,拟合效果会更好,所以r1<r2.
二、多项选择题(每小题6 分,共12 分)
7.(2025·济南模拟)为了验证牛的毛色(黑色、红色)和角(有角、无角)这两对相对性状是否相关,某学院进行
了一次数据统计,并根据形成的2×2 列联表,计算得到χ2≈2.727,根据小概率值为α 的独立性检验,则(
)
附:
α
0.100
0.050
0.010
xα
2.706
3.841
6.635
A.若α=0.100,则认为“毛色”和“角”无关
B.若α=0.100,则认为“毛色”和“角”有关,此推断犯错误的概率不超过0.100
C.若α=0.010,则认为“毛色”和“角”无关
D.若α=0.010,则认为“毛色”和“角”有关,此推断犯错误的概率不超过0.01
答案 BC
解析 对于A,B,若α=0.100,因为χ2≈2.727>2.706,则认为“毛色”和“角”有关,此推断犯错误的概
率不超过0.100,故A 错误,B 正确;
对于C,D,若α=0.010,因为χ2≈2.727<6.635,则认为“毛色”和“角”无关,故C 正确,D 错误.
8.(2025·浙江R6 联盟联考)下列结论中,正确的有(  )
A.若随机变量ξ~N(2,σ2),P(ξ≤5)=0.81,则P(ξ≤-1)=0.19
B.将一组样本中的每个数据都加上同一个非零常数后,均值与方差都变化
C.已知经验回归方程为y
^ =b
^x+2.8,且x=4,y=30,则b
^=6.8
D.在线性回归分析中,决定系数R2用来刻画拟合的效果,R2值越小,则模型的拟合效果越好
答案 AC
解析 对于A,因为随机变量ξ~N(2,σ2),P(ξ≤5)=0.81,
所以P(ξ≤-1)=1-P(ξ≤5)=1-0.81=0.19,故A 正确;
对于B,将一组样本中的每个数据都加上同一个非零常数后,均值发生变化而方差不变,故B 错误;
对于C,因为经验回归方程为y
^ =b
^x+2.8,且x=4,y=30,
则30=4b
^+2.8,即b
^=6.8,故C 正确;
对于D,在线性回归分析中,决定系数R2用来刻画拟合的效果,R2值越大,则模型的拟合效果越好,故D
错误.
三、填空题(每小题5 分,共10 分)
9.(2025·湖南名校联合体模拟)高三某班第一组学生的数学期末考试成绩分别为138,130,120,122,
120,130,110,130,则该组成绩的中位数与平均数之差的绝对值为     .
答案 1
解析 将成绩从小到大排列为110,120,120,122,130,130,130,138,
所以该组成绩的中位数为122+130
2
=126,
平均数为138+130×3+122+120×2+110
8
=125,
所以该组成绩的中位数与平均数之差的绝对值为|126-125|=1.
10.某校数学建模兴趣小组收集了一组恒温动物体重W(单位:克)与脉搏率f(单位:心跳次数/分钟)的对应数
据(Wi,fi)(i=1,2,…,8),根据生物学常识和散点图得出f 与W 近似满足f=cWk(c,k 为参数).令xi=ln Wi,
yi=ln fi,计算得x=8,y=5,
8
Σ
i=1
yi
2=214.由最小二乘法得经验回归方程为y
^ =b
^x+7.4,则k 的值为

;为判断拟合效果,通过经验回归方程求得预测值y
^ i(i=1,2,…,8),若残差平方和
8
Σ
i=1
( yi- y
^
i)
2
≈0.28,则决定系数R2≈      . (
参考公式:决定系数R
2=1-
n
Σ
i=1
( yi- y
^
i)
2
n
Σ
i=1
( yi- y)
2)
答案 -0.3 0.98
解析 因为f=cWk,两边取对数可得ln f=ln c+kln W,又xi=ln Wi,yi=ln fi,
依题意经验回归方程y
^ =b
^x+7.4 必过点(x,y),
所以5=8b
^+7.4,
解得b
^=-0.3,所以k=-0.3,
又R2=1-
8
Σ
i=1
( yi- y
^
i)
2
8
Σ
i=1
( yi- y)
2
=1-
8
Σ
i=1
( yi- y
^
i)
2
8
Σ
i=1
yi
2-8 y
2
≈1-
0.28
214 -8×5
2=0.98.
四、解答题(共27 分)
11.(13 分)(2025·湖南名校联考)为了研究学生的性别和是否喜欢跳绳的关联性,随机调查了某中学的100 名
学生,整理得到如下列联表.
男学生
女学生
合计
喜欢跳绳
35
35
70
不喜欢跳绳
10
20
30
合计
45
55
100
(1)依据小概率值α=0.1 的独立性检验,能否认为学生的性别和是否喜欢跳绳有关联?(5 分)
(2)已知该校学生每分钟的跳绳个数X~N(170,100),该校学生经过训练后,跳绳个数都有明显进步.假设经
过训练后每人每分钟的跳绳个数都增加10,该校有1 000 名学生,预估经过训练后该校每分钟的跳绳个数
在[170,200]内的学生人数.(结果精确到整数)(8 分)
附:χ2=
n(ad -bc)
2
(a+b)(c +d )(a+c)(b+d ),其中n=a+b+c+d.
α
0.1
0.05
0.01
xα
2.706
3.841
6.635
若X~N(μ,σ2),则P(μ-σ≤X≤μ+σ)≈0.682 7,P(μ-2σ≤X≤μ+2σ)≈0.954 5,P(μ-3σ≤X≤μ+3σ)≈0.997 3.
解 (1)零假设为H0:学生的性别和是否喜欢运动无关.
χ2=100×(35×20-35×10)
2
45×55×70×30
≈2.357<2.706,
所以根据小概率值α=0.1 的独立性检验,没有充分证据推断H0不成立,因此可以认为H0成立,即不能认为
学生的性别与是否喜欢跳绳有关.
(2)训练前该校学生每人每分钟的跳绳个数X~N(170,100),则μ=170,σ2=100,σ=10,
又训练前学生每分钟的跳绳个数在[160,190]内,160=μ-σ,190=μ+2σ,
所以P(160≤X≤190)=P(μ-σ≤X≤μ+2σ)= P( μ-σ ≤X ≤μ+σ )
2
+ P( μ-2σ ≤X ≤μ+2σ )
2
≈0.682 7
2
+0.954 5
2
=0.341 35+0.477 25=0.818 6,
由1 000×0.818 6=818.6≈819(人),
估计训练前该校每分钟的跳绳个数在[160,190]内的学生人数为819,
即预估经过训练后该校每分钟的跳绳个数在[170,200]内的学生人数为819.
12.(14 分)(2025·曲靖模拟)自“机器人扭秧歌”这一节目在2025 年春晚舞台大放异彩后,专注于四足机器
人研发的某中国科技公司在全球范围内倍受瞩目,旗下一款机器人在巡检与监控、安防与救援、科研与影
视等方面应用广泛.现统计出该款机器人在某地区2024 年1 月至5 月的销售量如表所示.
月份x
1
2
3
4
5
销售量y/台
26
37
50
64
93
(1)经计算样本相关系数r≈0.98,故变量x,y 线性相关性很强,求y 关于x 的经验回归方程;(5 分)
(2)用(1)中所求的经验回归方程来拟合这组成对数据,当样本数据的残差的绝对值大于5 时,称该对数据为
一对“次数据”,现从这5 对数据中任取3 对做残差分析,求取到的数据中“次数据”对数X 的分布列和
均值.(9 分)
附:经验回归直线y
^ =b
^x+a
^中斜率和截距的最小二乘估计公式分别为b
^=
n
Σ
i=1
( xi- x)( yi- y)
n
Σ
i=1
( xi- x)
2
,a
^=y-b
^
x.
解 (1)由表格可得x=1
5×(1+2+3+4+5)=3,
y=1
5×(26+37+50+64+93)=54,
5
Σ
i=1
( xi- x)
2=4+1+0+1+4=10,
5
Σ
i=1
(xi-x)(yi-y)=56+17+0+10+78=161,
所以b
^=
5
Σ
i=1
( xi- x)( yi- y)
5
Σ
i=1
( xi- x)
2
=161
10 =16.1,a
^=y-b
^
x=54-16.1×3=5.7,
故y 关于x 的经验回归方程是y
^ =16.1x+5.7.
(2)当x=1 时,y
^ =16.1×1+5.7=21.8,
残差的绝对值为|26-21.8|=4.2<5;
当x=2 时,y
^ =16.1×2+5.7=37.9,
残差的绝对值为|37 -37.9|=0.9<5;
当x=3 时,y
^ =16.1×3+5.7=54,
残差的绝对值为|50-54|=4<5;
当x=4 时,y
^ =16.1×4+5.7=70.1,
残差的绝对值为|64 -70.1|=6.1>5;
当x=5 时,y
^ =16.1×5+5.7=86.2,
残差的绝对值为|93-86.2|=6.8>5.
所以“次数据”为第四组和第五组,共两组.
故“次数据”对数X 的所有可能取值为0,1,2.
P(X=0)=C3
3
C5
3= 1
10,
P(X=1)=C3
2C2
1
C5
3 =3
5,
P(X=2)=C3
1C2
2
C5
3 = 3
10.
所以X 的分布列为
X
0
1
2
P
1
10
3
5
3
10
E(X)=0× 1
10+1×3
5+2× 3
10=6
5=1.2.
(13 题5 分,14 题6 分,共11 分)
13.哈希表(HashTable)是一种利用键值的映射关系,将数据存储在特定位置的数据结构.常用的方法之一是
“除留余数法”.例如,当除数为3 时,键值为13 的数据因13÷3 余1,应存放于位置1 中,从而可直接依
据键值快速定位数据位置,多个数据可映射到同一位置(如键值10 和13 均映射到同一位置).现有一个容量
为7 个位置(编号0~6)的哈希表,以除留余数法(除数为7)进行映射,需要存储22 个数据.设这7 个位置存放
的数据个数分别为a0,a1,a2,a3,a4,a5,a6,则下列说法中正确的是(  )
A.至少有1 个位置存放了不少于5 个数据
B.若这22 个数据的键值恰好是0~44 间的所有奇数,则a0~a6的中位数为2
C.若a0~a6的方差为s2,则s2的最小值为0,最大值为2 904
49
D.若a0~a6的极差为5,则最多有2 个位置没有存放数据
答案 D
解析 设ai为数据除以7 的余数为i(i=0,1,2,3,4,5,6)的数的个数,
对于A 选项,22=7×3+1,
不妨假设这7 个位置存放的数据个数分别为3,3,3,3,3,3,4,故A 错误;
对于B 选项,由题意可知,这些奇数分别为1,3,5,7,9,11,13,15,17,19,21,23,25,27,
29,31,33,35,37,39,41,43,
这些数据除7 的余数分别为1,3,5,0,2,4,6,1,3,5,0,2,4,6,1,3,5,0,2,4,6,1,
所以a0=3,a1=4,a2=3,a3=3,a4=3,a5=3,a6=3,
将a0~a6这7 个数由小到大排列依次为3,3,3,3,3,3,4,中位数为3,故B 错误;
对于C 选项,由题意可知,a0~a6这7 个数的平均数为x=22
7 ,
且3<22
7 <4,|3- 22
7 |<|4 - 22
7 |,
因为ai∈N(i=0,1,2,3,4,5,6),
s2=1
7
6
Σ
i=0(ai- 22
7 )
2
,
当a0~a6这7 个数中有6 个3,1 个4 时,s2取最小值,
即(s
2)min=1
7[6×(3- 22
7 )
2
+(4 - 22
7 )
2
]= 6
49,
当a0~a6这7 个数中有6 个0,1 个22 时,s2取最大值,
即(s
2)max=1
7[6×(0- 22
7 )
2
+(22- 22
7 )
2
]=2 904
49
,故C 错误;
对于D 选项,不妨取a0~a6这7 个数依次为1,6,3,3,3,3,3,
满足极差为5,此时,所有位置都有数据,
若存在一些位置没有数据,则a0~a6这7 个数据中的最大值为5,最小值为0,
因为22=5×4+2,此时,至少需要5 个位置存放数据,则至多有2 个位置没有存放数据,故D 正确.
14.(多选)已知一组样本数据:-2,a,b,4,其中a≤0,b≥0,将该组数据排列,下列关于该组数据结论
正确的是(  )
A.序列不可能既是等比数列又是等差数列
B.若成等比数列,则a 和b 有4 组可能取值
C.若成等差数列,则a 和b 有3 组可能取值
D.若该数据的平均数是1,这组数据的方差的最小值为9
2
答案 ABC
解析 若为等比数列,由-2,4 可知公比小于0,正负交替排列,
而此时若成等差数列,则具单调性,相互矛盾,
故不可能既是等比数列又是等差数列,A 项正确;
若排列后成等比数列,设公比的绝对值大于1,则
①公比为-2,数列为a,b,-2,4⇒a=-1
2,b=1,
公比为-2,数列为-2,4,a,b⇒a=-8,b=16,
公比为-2,数列为b,-2,4,a⇒a=-8,b=1,
②公比为
3√-2,数列为-2,b,a,4 ⇒b=2
3√2,a=-2
3√4,共4 组可能取值,
若公比的绝对值小于1,对应上述倒序排列,a 和b 有4 组可能取值,
所以若成等比数列,a 和b 有4 组可能取值,B 项正确;
由a≤0,b≥0,若-2,a,b,4 排序后成等差数列,设公差大于0 有:
①公差d=6,数列为a,-2,4,b⇒a=-8,b=10;
②公差d=3,数列为a,-2,b,4⇒a=-5,b=1;
③公差d=2,数列为-2,a,b,4⇒a=0,b=2;
公差小于0,对应上述倒序排列,故a,b 有3 组可能取值,
所以若成等差数列,a 和b 共有3 组可能取值,C 项正确;
由数据的平均数是1,x=-2+ 4+a+b
4
=1⇒a+b=2,a≤0,
方差D(X)=1
4 [(-2-1)2+(4-1)2+(a-1)2+(b-1)2]=18+2(a-1)
2
4
≥5,D 项错误.