ARTICLE · 1335192
zip 能把文档压掉一半,为什么压不动视频:压缩的边界
同一台电脑,同一个 zip:一份全是同一个字的 100MB 文本,压完只剩 100KB;7MB 的视频压完几乎一个字节都没省下来。不是 zip 偷懒——它一打开文件就看穿了,谁还有得挤,谁早就被挤干了。
引言:同一批文件,两种命运
本机实测。在 Windows 上用系统自带的压缩功能,把这七份文件各压了一遍,压缩比一眼分出了三个世界:
| 1.94x | |||
| 3.79x | |||
| 5.84x | |||
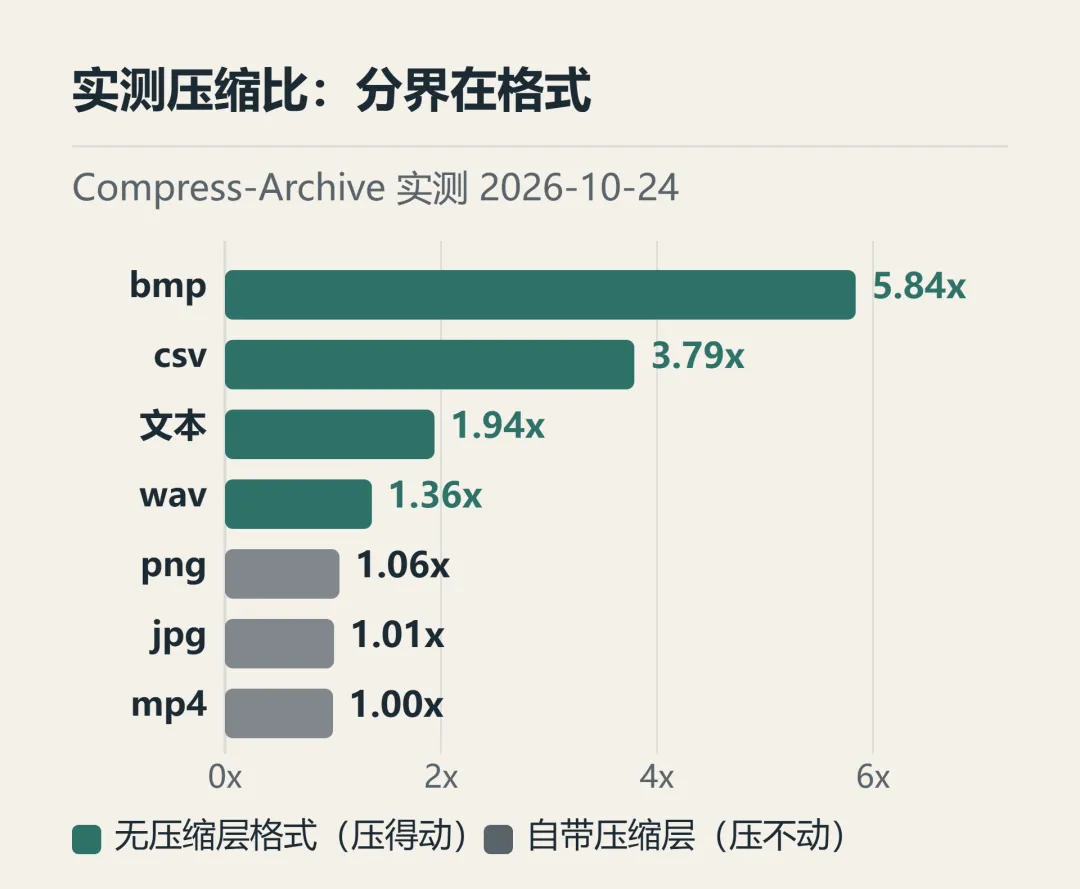
同一支压缩器,面对不同文件,压缩比从 5.84x 一路滑到 1.00x。三个世界:txt、csv、bmp 这些生格式压得动;jpg、png、mp4 出厂自带压缩层,基本压不动;wav 卡在中间——同样没带压缩层,但提示音里成段的重复有限,1.36x 已是它全部的家底。bmp 是 jpg 解开压缩后的形态——同一张壁纸,没压缩的版本 36.9MB,压过的 1.6MB,再拿 zip 压 jpg 只能抠出 1%。这篇讲清楚四件事:
zip 凭什么把文件压小:它找的到底是什么 熵是地板:什么样的文件神仙也压不动 zip 套 zip 为什么不但不赚还要倒贴 传文件之前,怎么一眼判断「还能不能压」
口径先说清:全部实验在本机 Windows 11 完成,压缩器为 PowerShell 5.1 的 Compress-Archive(.NET DeflateStream,即 DEFLATE),视频样本由 ffmpeg 9.0.1 生成,文本样本按固定随机种子合成。脚本、逐项数据与样本来源随库存档(.store/compress-exp/),可复跑。
一、压缩找的是重复:往前翻几页,照抄一段
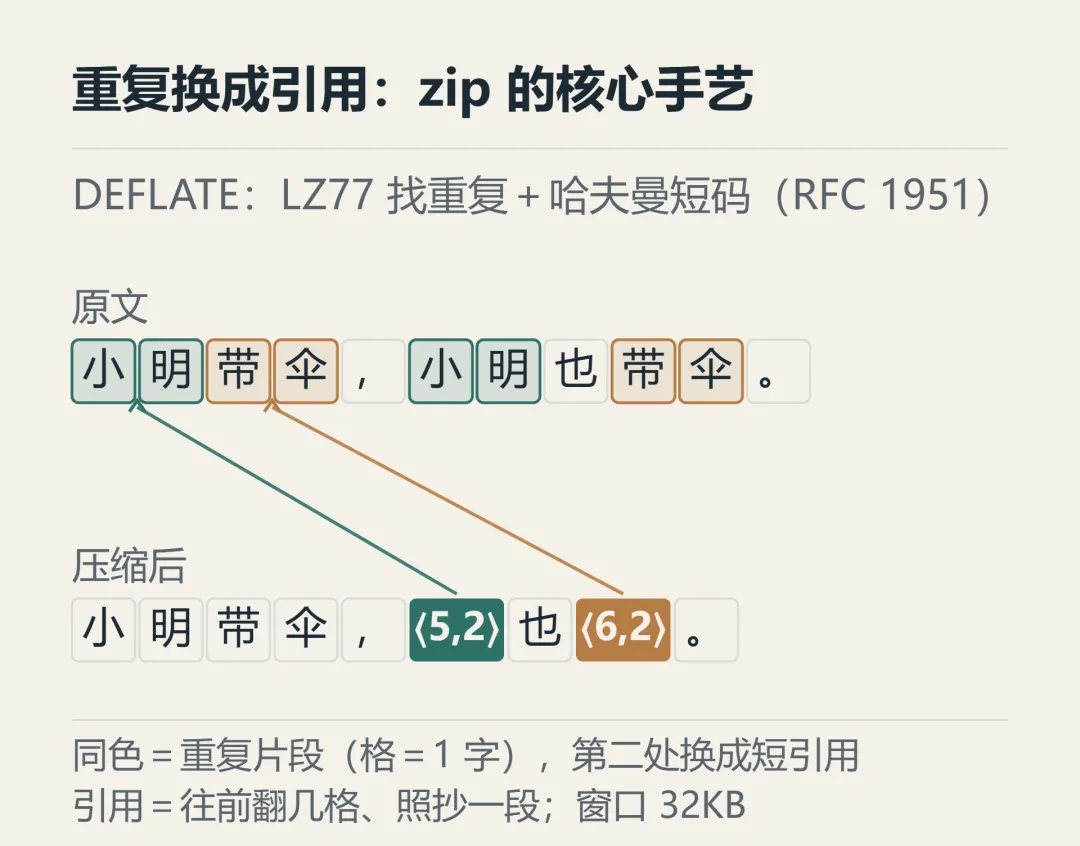
先看那两个「压得动」的赢家里最不起眼的一位:csv。一份 1MB 的数值表格压到 277KB——省下的 77 万字节从哪来?答案是重复。各列格式雷同:seq 编号逐行加一;日期只到天,一串串完全相同;城市名十选一;温度永远带一位小数。压缩器把反复出现的片段存一份底账,后面每撞见一次,只写一张「往前翻几页、照抄一段」的短引用,不再重抄全文。重复越密,引用越短,省得越多。
这就是压缩的核心手艺,术语叫 LZ77:维护一个往前翻的「滑动窗口」(DEFLATE 的窗口是 32KB),在窗口里找当前内容的重复,命中就换成一对数字——距离(往前多少字节)加长度(照抄多少字节)。它的发明人 Jacob Ziv 与 Abraham Lempel 在 1977 年发表的正是这套「把重复换成引用」的算法,zip 里的 DEFLATE 就是它和另一招的组合拳——RFC 1951 开篇交代的正是这套构造:「compresses data using a combination of the LZ77 algorithm and Huffman coding」(用 LZ77 算法与哈夫曼编码的组合压缩数据)。哈夫曼负责的第二步是给账本本身瘦身:出现越频繁的符号发越短的代号,高频的「引用」用一两个比特就打发走。zip、gzip、png 用的都是这套组合。
回头再看表格那份 3.79x:它压得过自然语言,因为结构化数据的重复比文章更规整——文章里的重复是「词语和句式」,表格里的重复是「整列同款格式」。而 bmp 的 5.84x 更直白:一张 3840×2400 的照片逐像素存就是 3600 多万个字节,相邻像素的颜色本来就相近,大片重复等着 LZ77 收割。格式里没有压缩层,不代表内容里没有重复——bmp 和 wav 这些「生格式」的口号是原样存储,把重复问题整个留给了 zip。
二、熵是地板:没有意外,就没有可挤的
那压不动的那几位呢?压缩这门手艺的全部粮食是重复,粮食吃完了,神仙也变不出字节。1948 年,贝尔实验室的克劳德·香农在《通信的数学理论》里给「不可预测程度」起了名字:信息熵。一段内容越出乎意料,熵越高;熵越高,可压缩的余地越小。压缩比的天花板不在压缩软件的参数里,在内容本身的意外程度里——这就是地板。
实测给这条地板拍了一张阶梯照。四份 1MB 上下的文本,冗余一路递减:
| 908.64x |
中间两行值得盯着看。十六进制串看起来「乱」,但每两个字符其实只描述一个字节(256 种可能),字符级别只有 16 种取值——DEFLATE 把这层伪装看穿了,照样砍掉四成多;真正压不动的是第三行:1MB 伪随机字节,每个字节都是满额意外,zip 压完 1,049,022 字节——不但一克没减,还多出 446 字节。拆开这 446 字节的账本费,是两笔:一笔是容器的固定开销,约 126 字节——每个文件前置 44 字节的 local file header、zip 收尾还有 60 字节中央目录记录加 22 字节结束记录(zip 规范明文规定);另一笔约 320 字节,藏在 DEFLATE 压缩流自己内部——数据满额意外时,流里的块标记这些结构照样要占地方。内容变小的时候这两笔可以忽略,在内容一克不减时就裸露出来了。而最后一行是另一个极端:1MB 的 'a' 是没有第二种可能的内容,DEFLATE 把它写成一串「距离 1、长度 258」的引用再套上短码,压到 1,154 字节——只剩原来的千分之一。
顺带把 100MB 的极端案例也跑了:同样全 'a' 的文本写到 104,857,600 字节,zip 完是 102,048 字节,压缩比 1,027.53x。重复是粮食,这句话的数学上限就在这——粮食无限的时候,zip 的输出几乎只有账本本身。
三、再压一遍:不但不赚,还要倒贴
现在可以回答标题的后半问了。jpg、png、mp4 压不动,不是 zip 的锅——这些格式出厂时就自带压缩层:png 内部就是 DEFLATE 流(PNG 规范明写压缩方法为「deflate/inflate 压缩,带 32K 滑动窗口」);jpg 对图像做 8×8 分块的离散余弦变换加量化再套熵编码;mp4 是个容器,里面装的视频轨道是 H.264 或 H.265 这类编码压过的数据。也就是说,这些文件在被 zip 碰到之前,已经被人用同一套手艺挤过一遍了。
那把已经压过的再压一遍呢?实测:把第一轮的七个 zip 各再压一次——
六件全部倒贴——zip 套 zip 买到的只有又一层压缩结构的开销(容器账本约一百二十字节,大头在 DEFLATE 流内——mp4 那件多出的 2,519 字节里,容器只占约 124 字节,其余全是流内开销),内容一个字节都挤不出来。例外是 bmp 那件,两层反而小了 134,894 字节,这个反例恰恰印证了地板理论:第一轮对 bmp 只压到 5.84x,DEFLATE 的输出里仍有它没榨干的重复结构,第二轮顺着自己人的账本又摸出 2.1%——第一层没压透的,第二层还能捡漏;第一层就是压缩格式的(jpg、mp4),第二层只剩纯亏。所以「压缩包不必再压」不是习惯,是算术:最好结果也就是不赚,而账本费每次都要照付。
视频就这样躺进了压不动的名单:它出厂时已经被 H.264 这类编码以「只存变化」的思路压得只剩骨架,zip 那套找重复的手艺面对一串近乎随机的码流无计可施。
拿走就能用
- 传文件前判断「还能不能压」,看扩展名就够了
:生格式可压——txt/csv/bmp/wav 这类没带压缩层的,压;熟格式别压——jpg/png/mp4/mp3 出厂即压缩,zip 一遍只能白付手续费;压缩包更别压——套娃必倒贴。 - 「看起来乱」不等于「压不动」
:哈希串、订单号这类字符集有限的伪随机文本,压一压还有余量——实测对象是十六进制随机串,砍掉了四成多;真压不动的是伪随机字节流。犹豫的最快验证法就是压一下看前后体积——增量几百字节就是答案。 - 视频传不动时别指望 zip 套娃
:换网盘直传或压缩画质,码流里没有留给 zip 的粮食。
结语
压缩从头到尾只做一件事:把重复记账,把意外照价买单。文本有重复,所以压得掉一半;随机字节全是意外,所以分文不少还要倒贴账本费;视频出厂前就把重复清算过了,zip 只能签字画押。100MB 压到 100KB 的奇迹与 7MB 几乎纹丝不动的「失效」,是同一本账的正反两面——压缩的边界从来不在软件里,在内容还剩多少意外里。
这套「找重复」的手艺也不只活在 zip 里:手机把它搬进内存,让离场的应用住进压缩仓,写在《离场的人,住进了压缩仓:深入理解 Linux 的 zram 内存压缩》;文件系统把它搬进磁盘,让照片压着存放,写在《不删一张照片,空间多出一半:F2FS 文件压缩》。而编码这条线还有更巧的玩法——二维码缺了一块照样能扫(见《二维码为什么缺一块也能扫出来》),那是另一场提前算好的账。
参考资料
RFC 1951(IETF):DEFLATE 格式规范原文 PKWARE APPNOTE:zip 容器规范,本地文件头与 method 0/8 定义 RFC 2083(IETF):PNG 规范,压缩方法条目 Wikipedia「JPEG」:JPEG 编码流程条目 Shannon(1948):《通信的数学理论》,熵概念原始出处 本号前作:《离场的人,住进了压缩仓:深入理解 Linux 的 zram 内存压缩》 本号前作:《不删一张照片,空间多出一半:F2FS 文件压缩》