ARTICLE · 1346218
我给自己做了个DSH插件「产出台」
一、起因:一句「已完成」和一座山
最早的问题特别具体。
我用 DSH 让 AI 做设计相关的活——生成效果图、改配色、出几版备选。它干活其实不慢,但每次收尾都是这么一句话:
「已完成。」
然后甩给我一堆文件。
我打开一看:方向偏了。沙发位置不对、色调太暖、构图太满。这时候再说一遍,它又得跑十分钟。而那十分钟它其实出过好几版草稿——我一版都没看见,等我想说「中间那个版本感觉对」的时候,它已经被后面覆盖了。
产出是有的,只是我看不见。
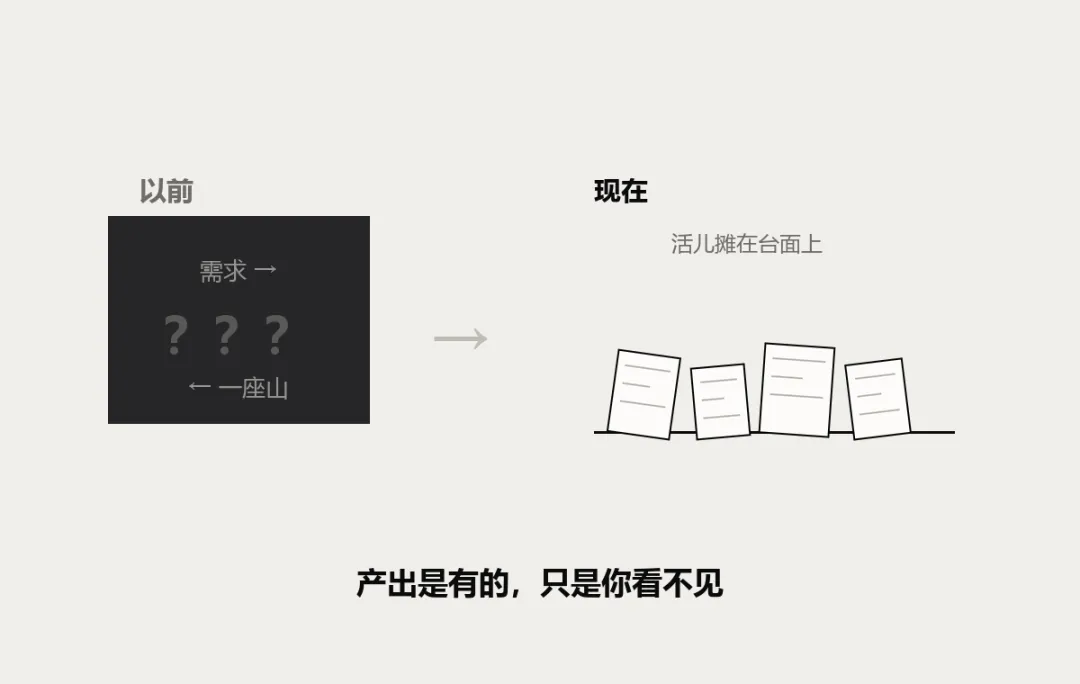
以前:递出去一句需求,收回来一座山。现在:活儿摊在台面上,一直看着
这不是 AI 不努力,是我和它之间的接口太窄:我递出去一句需求,收回来一座山,中间的过程对我完全不可见。
所以我动手做的第一件事,跟任何高级功能都无关——
我要能边看边等。
二、先让它「看得见」
面板亮起来的那一刻
第一版只做一件事:侧边栏多一个面板,AI 每出一个文件,这边立刻出现。
不用等它说完成。它还在跑,我已经能看见第一张图长什么样了。
这一版做完,最大的感受不是功能多强,而是心里的不确定消失了。以前是等一个不知道会不会来的结果,现在是我看着它一步步逼近。
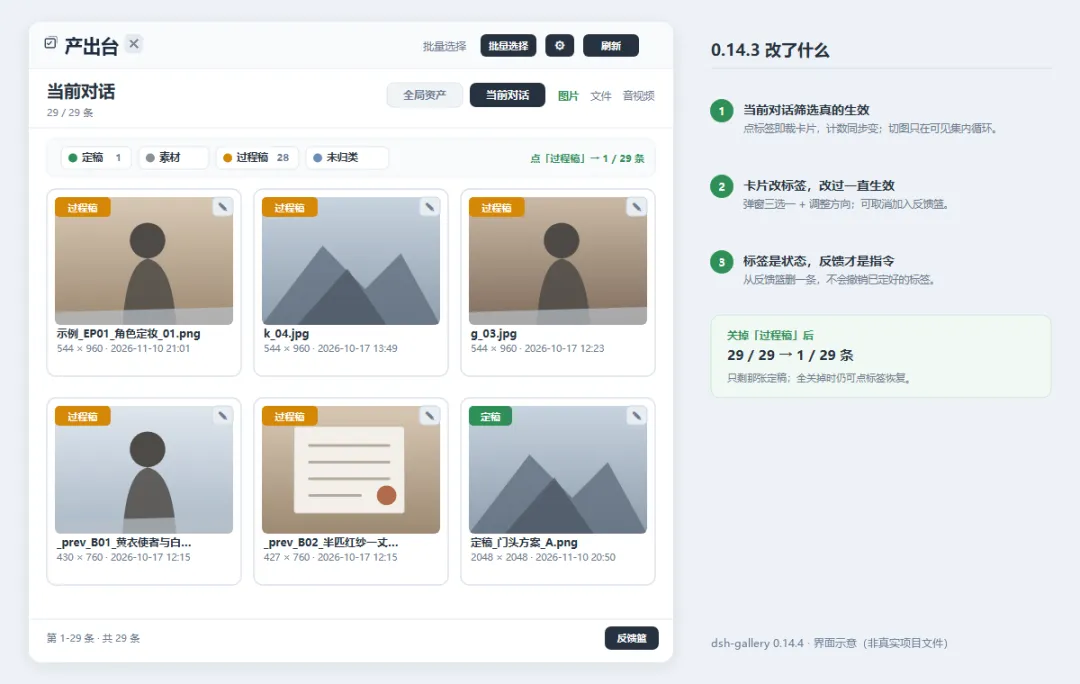
当前对话 · 29 条产出实时可见,每 5 秒自动刷新
但面板空得离谱
跑起来我就发现不对:明明 AI 生成了十几张图,面板里只显示出两三张。
查了半天才明白——它只认几种「写文件」的动作,而很多图是它用脚本批量生成的,走的是另一条路,没被记录。
解决思路:AI 生成完图,通常会自己打开看一眼,这是它检查自己工作效果的方式。这个「看一眼」的动作也被记录下来了。
把它也算作产出,那些「过程中生成的图」就都能看见了。
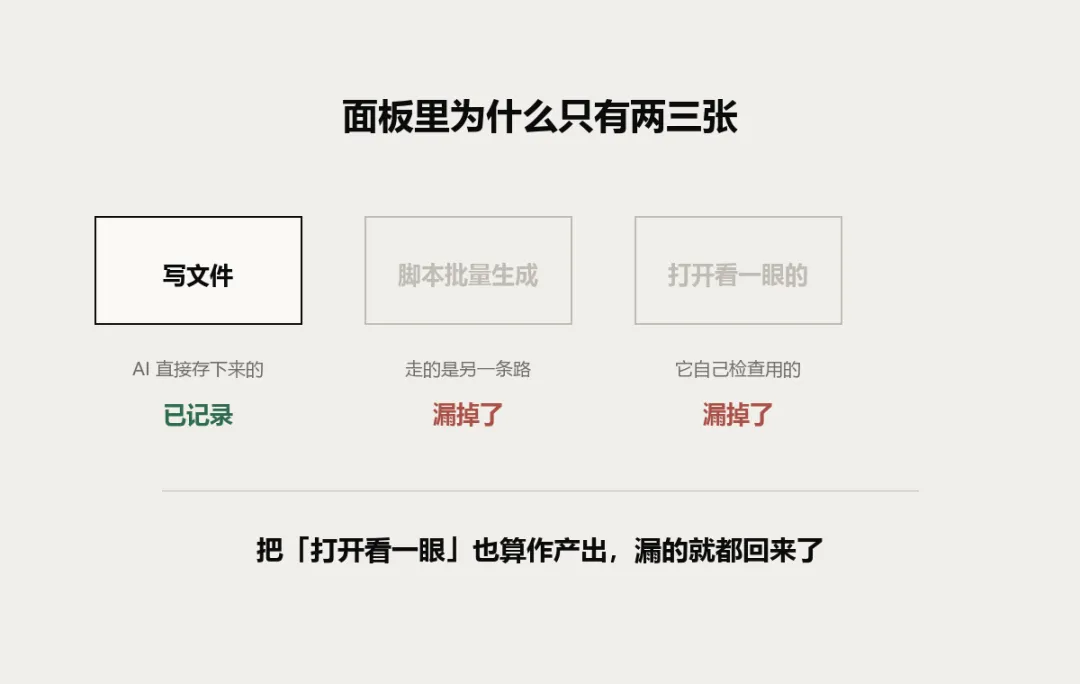
漏掉的两类:脚本批量生成的、它自己打开看过的
看见了,但看不清
缩略图能看个大概,可我要判断细节——沙发扶手的位置、材质对不对、字体有没有压到边。
所以加了查看器:点开大图、放大、拖动画布。
但很快又不够了:放大的缩略图糊。
这是常识问题——缩略图本来就是为了快,细节在压缩的时候就丢了。可我要判断的是「这张图能不能用」,糊的图没法判断。
解决思路:右键「查看原图」,加载文件本身。查看器里也有个按钮可以随时切。
这一步很琐碎,但没有它,前面所有「看得见」都是打折的。
三、它出的不只是图
视频和音频是空白的
做设计验证的时候,我会让 AI 出漫游动画、出配音样片。
但面板里根本没有这一类。
不是「忘了做」,是当时底层只分了两种东西。要加视频,得先把它当成和图片平级的类别,而不是图片的附属。
改完之后:视频有首帧缩略图,点开在面板里直接播。
卡了最久的坑:进度条拖不动
视频能播了,但我拖不动进度条。
拖到 30 秒,松手,它跳回 0。
查了很久才找到原因:DSH 的桌面外壳在转发视频文件时,会把「这个文件总共多大」这个信息去掉。播放器拿不到总长度,就不知道进度条该有多长,只能认为总时长是 0——所以怎么拖都没用。
试过几条路都不行,最后换了思路:不流式播了,把整段先拿到浏览器里再播。
整段在本地内存里,播放器知道确切大小,进度条就正常了。
代价是开始播之前要等一下(文件越大等越久)。实测 127MB 的视频大约半秒,可以接受。
如果文件大到不适合这样播,会引导你用系统播放器打开——不硬撑。
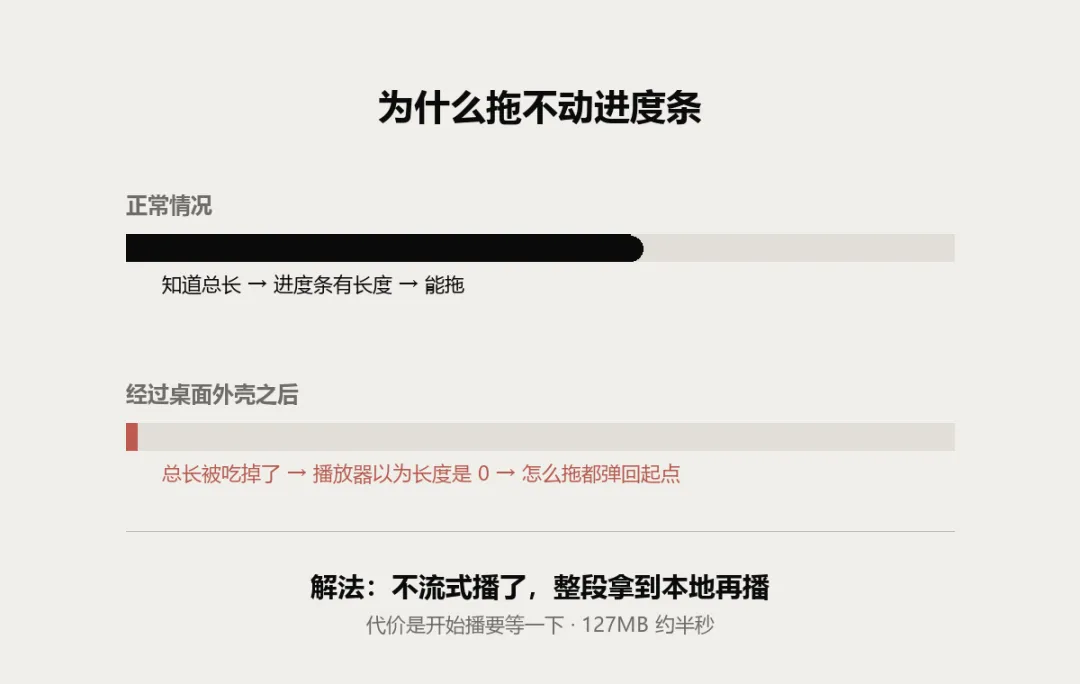
进度条拖不动的真正原因
四、东西太多,开始乱
能看的越来越多之后,新问题冒出来了,而且是我完全没预料到的:
找不到东西。
我做一篇公众号,封面在这个对话、正文配图在另一个对话、背景素材又是第三个对话生成的。找一张图要一个个对话翻回去,翻到后来自己都忘了哪张是哪个对话出的。
这跟最开始的问题其实是同一个——看得见,但组织不起来。
先把它们汇总
加了「全局资产」,把所有对话的产出汇到一处,按对话分组。
当前正在聊的对话默认展开,其他收起。每组头上标着:成稿几张、过程稿几张、素材几张。
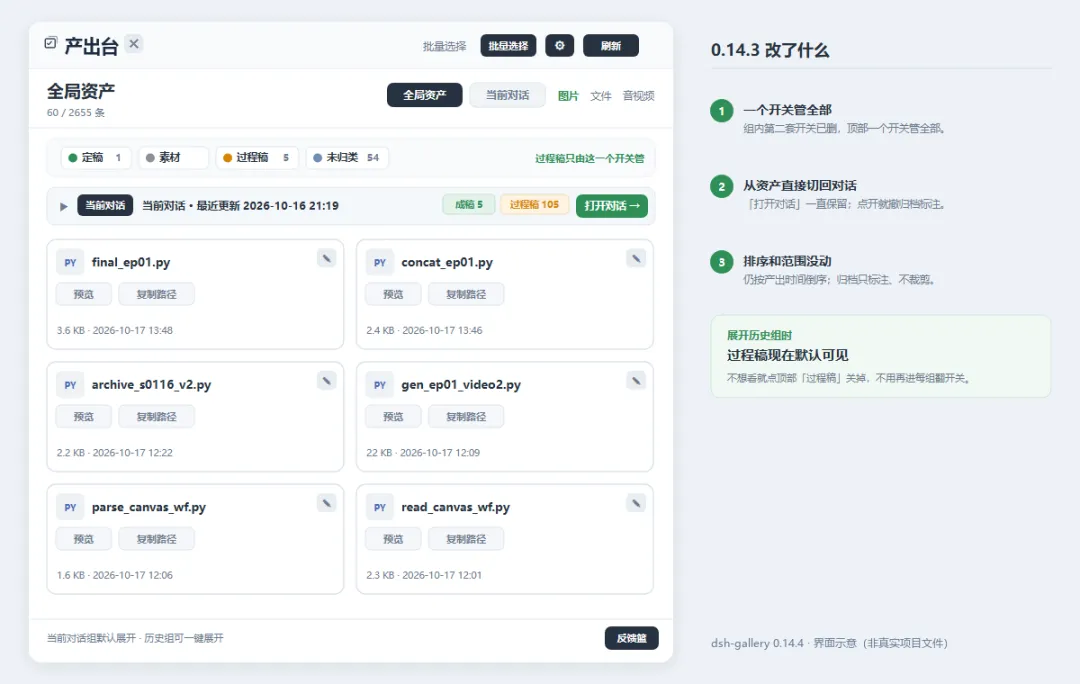
全局资产 · 跨对话的产出汇到一处
再让它自己分类
但汇总之后还是一屏几十张图。所以让它根据线索猜分类:
- 定稿
——你确认过要用的 - 过程稿
——AI 生成了一堆供你挑的候选 - 素材
——你提供给它的原图、参考图 - 未归类
——判断不出来的
这里踩了整个项目最本质的一个坑
分类猜得不准,这我预料到了——机器只能看文件什么时候产生、被谁用过,猜不准很正常。
所以加了手动改:点一下标签,自己标。
结果标完过一会儿,它自己变回去了。
查了几遍代码才想明白问题在哪:
分类是机器猜的,每 5 秒重扫一次就会重算;而我的标记,写在了那个「每次都会被重算」的地方。
机器猜的东西会变,人给的判断必须留得住。这两样东西,从一开始就不该放在同一个位置。
改法是把它们彻底分开:自动分类每次重扫重算,人的判断单独存一个文件,扫描永远不碰它。
改完之后,标签标上就真的锁住了——刷新、切对话、重启,甚至文件被重新生成过,标记都还在。
这件事让我改了一个更基础的认识:界面可以合并,数据必须分开。
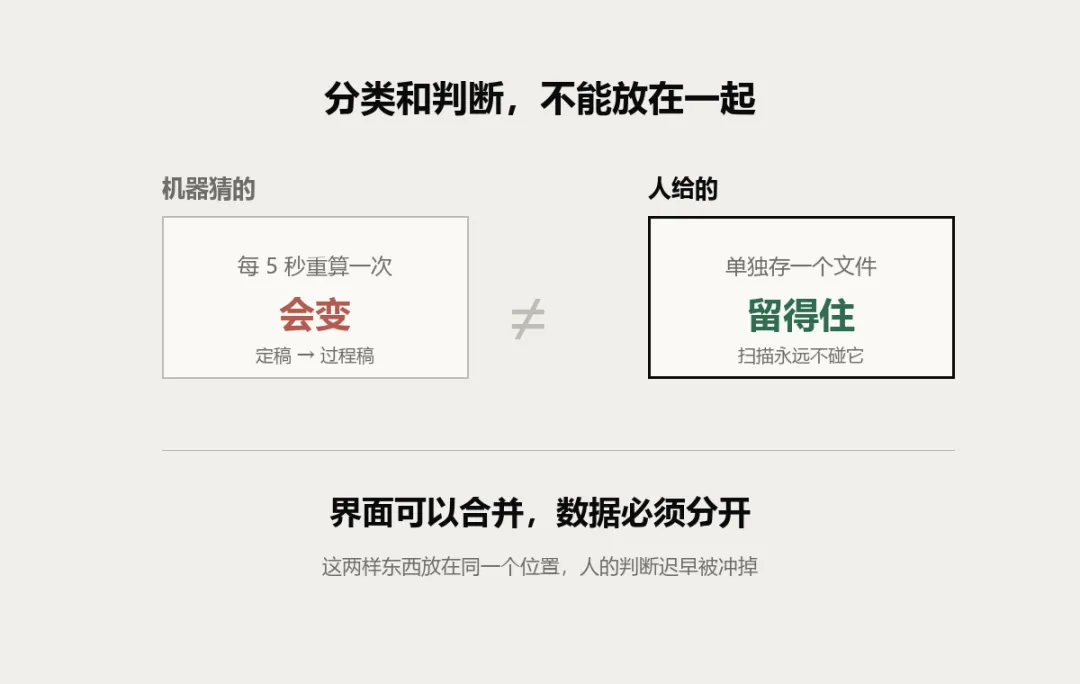
分类是机器猜的会变,判断是人给的必须留得住
五、看见了,然后呢
三类资产都能看了,也能分类整理了。但真正让我觉得还差一口气的是:
看见不对之后,我怎么告诉它?
以前是在聊天框里打字:
「第二张那个沙发位置偏了,往左挪一点,色调也太暖了要冷一点,其它的别动……」
打完一长串,还得祈祷它别把整张图重做一遍。
直接在图上圈
所以加了框选:在图上拖一个框,圈出哪块不对,旁边写一句。
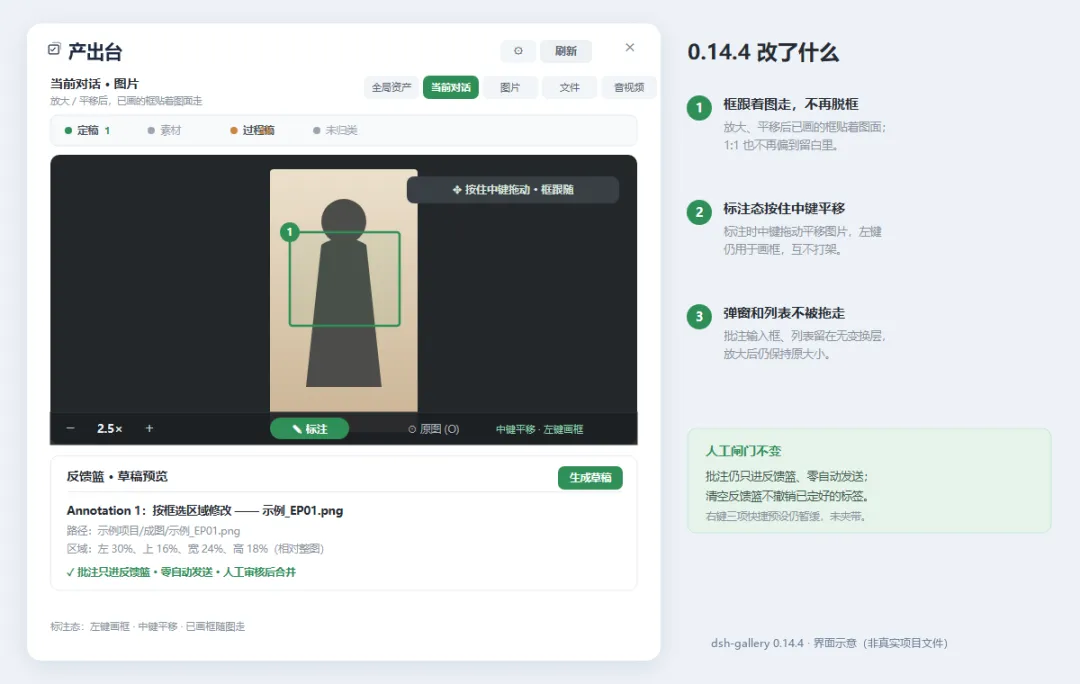
图上圈选 · 放大后框跟着图走,不脱框
这个功能做完,又连着踩了两个坑:
第一个坑:标注完放大图片,框飘走了。因为框记的是「屏幕上第 500 像素」,图片一放大,500 像素对应的位置就变了。
改成记「相对整张图的百分比」——左 30%、上 16%、宽 24%。这样不论窗口多大、放大几倍,都能还原到同一块地方。
第二个坑:标到画布边缘就动不了了。因为标注状态下左键被框选占用,没法平移。
改成按住鼠标中键平移,已经画的框跟着走,不会脱框。
攒成一张清单
圈一个不够,可以圈好几个。每条自动编号,最后整理成一张清单写进输入框。
清单长这样:
Annotation 1:按框选区域修改 —— 示例_EP01.png
区域:左 30%、上 16%、宽 24%、高 18%(相对整张图)
理由:人物手势再收一点,别压住衣纹

Annotation 2:……
但发送这一步,我没让它自动做
这是整个项目我态度最坚决的一点:
草稿写进输入框之后,插件就停手了。
它不帮你发。你可以改字、删掉某条、加几句自己的话,然后你自己按发送。
为什么不自动发?
AI 接到指令就开始干活。一旦发错了,它已经在错了。
而人看一眼再发,成本几乎等于零。
我宁可多这一步。
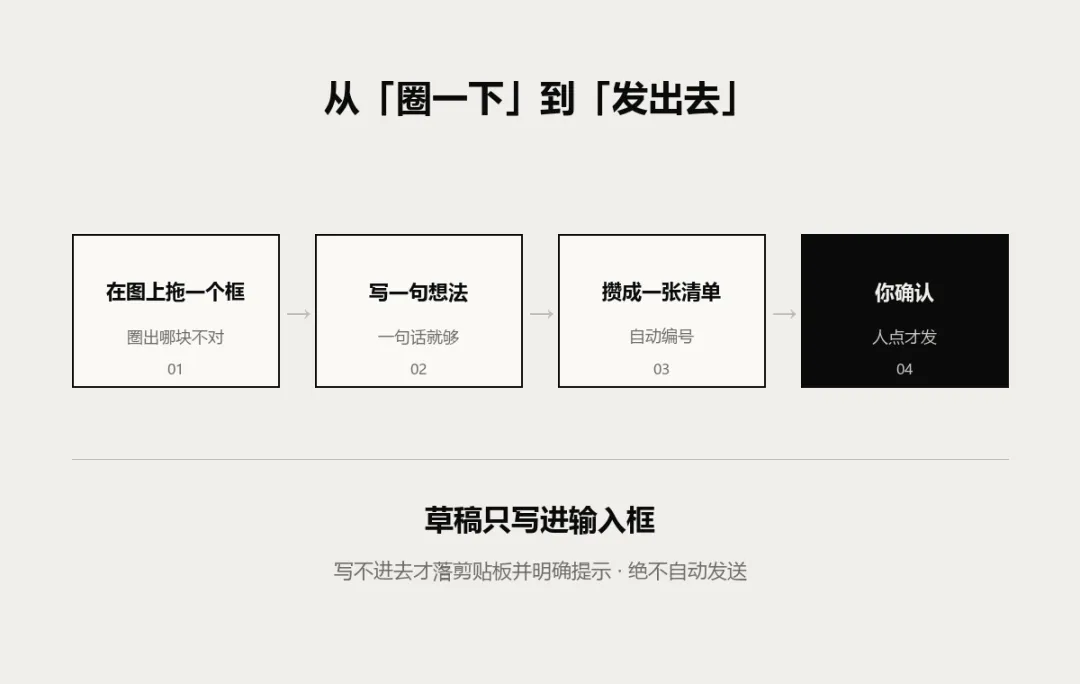
从圈一下到发出去,四步
顺带解决:视频里那一帧怎么指
做视频的时候,「第 12 秒那个镜头里人物表情不对」这种话 AI 很难理解。
所以加了截帧:播到你觉得不对的地方,按一下,当前这一帧立刻变成一张图,存进这次产出里。
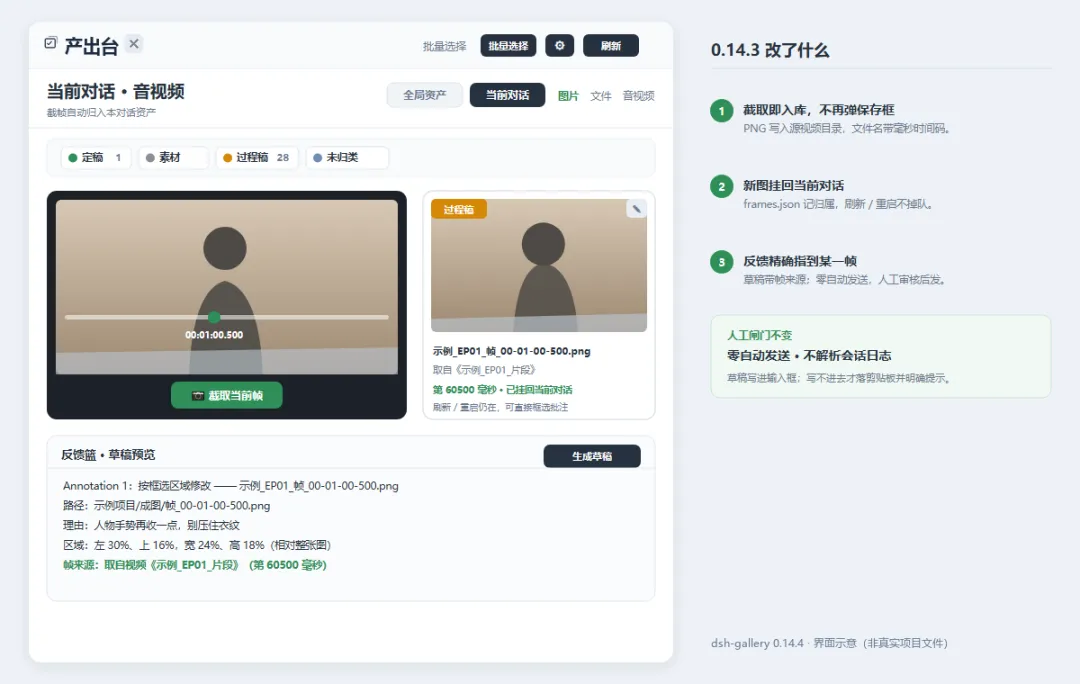
视频截帧 · 自动存进当前对话,反馈能精确指到某一帧
然后就能在这张帧图上圈框,草稿里会多一行「取自视频《xxx》第 60500 毫秒」——AI 就知道你说的是哪一帧。
六、回头看,每一步都是被上一步逼出来的
没有一条是提前规划出来的。 都是用的时候觉得别扭,然后去改。
七、现在它长成了什么样
就三件事:
产出随出随看 — 它还在跑,你已经能看见第一张图。图片能看原图,文件能直接预览,视频能拖进度条。
跨对话收得拢 — 所有对话的产出汇在一处,按对话分组,自动分类还能手动改,标签标上就锁住。
圈点意见送回任务 — 在图上圈一块写一句,攒成清单写进输入框。你确认了才发。
不变的底线是:所有判断都是你做的。插件只负责让你看见、让你说得清楚、让你确认。
它不自动发送、不自动改文件、不替你做决定。
八、几句实话
不联网。 所有数据在你本机。它只读对话记录来找出「这次产出了哪些文件」,不读你聊了什么。
跨平台但有个例外。 Windows、macOS、Linux 都能装。「打开所在文件夹」能精确选中文件这个只有 Windows,其他系统只能打开到目录。
批注不长期保存。 圈选的批注只在这一次有效——它是「这次要跟 AI 说的话」。真正长期存着的是你手动改的标签。
它不完美。 分类还是会猜错,大文件播放还是会引导你用系统播放器,标注还只支持矩形框。都是些能忍的地方。
写在最后
最开始我想要的其实只有一件事:让 AI 干活的时候,我能站在旁边看着。
后来发现,光看着不够。得能翻回去找、得分得清、还得说得清楚哪里不对。
「产出台」这个名字是这么来的——它是一张台面,不是一台机器。
机器是你按一下按钮,等它出结果。台面是你把活儿摊开,边做边看,随时伸手调整。
我更想要后面这个。
一张台面,不是一台机器
安装方式
方式一 · 在 DSH 里装(推荐)
打开 DSH → 插件页 → 搜 dsh-gallery → 点安装。
方式二 · 命令行装
npm i dsh-gallery方式三 · 从 GitHub 直接装
dsh plugin --profile web add dsh-gallery@latest装完必须完全退出 DSH 再重新打开。
不是刷新页面,是彻底关掉重开——它有一部分跑在后台,只在 DSH 启动时加载一次。只刷新页面的话,那部分不会更新,你会以为没装上。
开源地址
GitHub:https://github.com/Hope2023Dcr/dsh-gallery
npm:https://www.npmjs.com/package/dsh-gallery
MIT 协议,代码全开放。零依赖、不联网、不上传任何数据——你可以自己翻代码确认。
有问题、装不上、或者发现哪个功能不对劲,直接去 GitHub 开 issue,我会看。
想加点什么?来投票
这个插件到现在所有功能,都是我自己用着别扭、然后去改的。
所以下一个功能该做什么,我更想听听你们用的时候哪儿别扭。
下面几个是我一直在犹豫的,在评论区告诉我你更想要哪个(或者直接说你的场景,不用管这几条):
① 图片 A/B 对比
两张图并排看、同步缩放,专门用来挑「这两版哪个好」。
—— 现在的做法是来回切,切多了就记不清了。
② 按标记筛出「待处理」
现在能按定稿/过程稿筛,但不能只筛出「我标了要重做」的那些。
—— 想一次性把所有待返工的都调出来。
③ 标注支持更多形状
现在只能拉矩形框。想要箭头、圆圈、随便画。
—— 有些地方不是一个框能说清的。
④ 换个词、改个名
「过程稿」「定稿」这套叫法你觉得别扭吗?你更习惯怎么说?
⑤ 你的场景
你做的是什么活?哪一步最烦?现在这个插件帮你省了哪一步、还差哪一步?
说真的,第 ⑤ 条对我最有用。
我做这个插件的出发点就是「用着别扭就去改」,所以你们怎么用、卡在哪,比我拍脑袋想功能有用得多。
评论区见。
产出台 · Output Gallery
GitHub: github.com/Hope2023Dcr/dsh-gallery