ARTICLE · 1355244
dsh插件推荐 - 这个插件能告诉任务时间花在哪、模型在思考什么、钱花在哪,花了多少全部都展示出来
SEGMENT GAUGE
DSH-WATCHER
把 33 分钟拆成四段
一个只读插件,专治「Agent 说做完了」
首响应等待
可见推理
输出
重试
只读观察
分段计时
数据伦理
DSH 插件
约 4,200 字 · 阅读约 11 分钟
你有没有过这种时候。
让 Agent 干一个稍微复杂点的活。翻几个文件,改两处代码,跑一遍测试。你去泡了杯茶,回来一看,它跑完了。
结果是对的。但中间那二十分钟它到底干了什么,你一点都不知道。
走了多少步,调了多少次工具,哪一步磨了三分钟,有没有哪条命令重试了五遍才过——这些全都在,只是不在你眼前。
我后来想明白一件事:我们平时看 Agent,看到的是结论,不是过程。而结论这个东西,是最没有信息量的。它只告诉你成没成,不告诉你为什么慢、慢在哪、下次还该不该这么用。
我最近在翻 DSH 的插件目录,碰到一个叫 DSH-Watcher 的东西,它干的就这一件事。
01
先搞清楚它是什么
DSH-Watcher 不是一个独立的应用。它是 DeepSeek Harness 的一个插件。
DeepSeek Harness 下面简称 DSH,是 DeepSeek 官方开源的 Agent 运行框架,它本身就已经能读文件、能跑命令、能干活。DSH-Watcher 装进去之后,你的会话标题栏会多一个眼睛图标,点一下,整个 Session 就收成一张能折叠的工作路径。
关键在只读两个字。
它不往你的对话里塞消息,不改 DSH 的核心,也不写你的会话。你看到的对话还是那个对话,一个字都没动过。
而且它还专门说了一句:我不替代 DSH 自带的 Trajectory。
一句话分工
官方那个告诉你发生了什么,它告诉你这些事花了多久、算不算数。
02
一次会话,它给你折成五层
点开之后是个五级结构:对话轮次 → 阶段 → 步骤 → 模型阶段 / 每次执行。每一层都能单独折叠。
我第一次看到这个层级划分时愣了一下,因为它跟人回忆一件事的顺序是一样的。你不会一上来就想「第 137 个事件是什么」,你会先想「第二轮的活干得慢」,再往下想「是查文件那一步慢」,最后才是「那条 grep 跑了四十秒」。
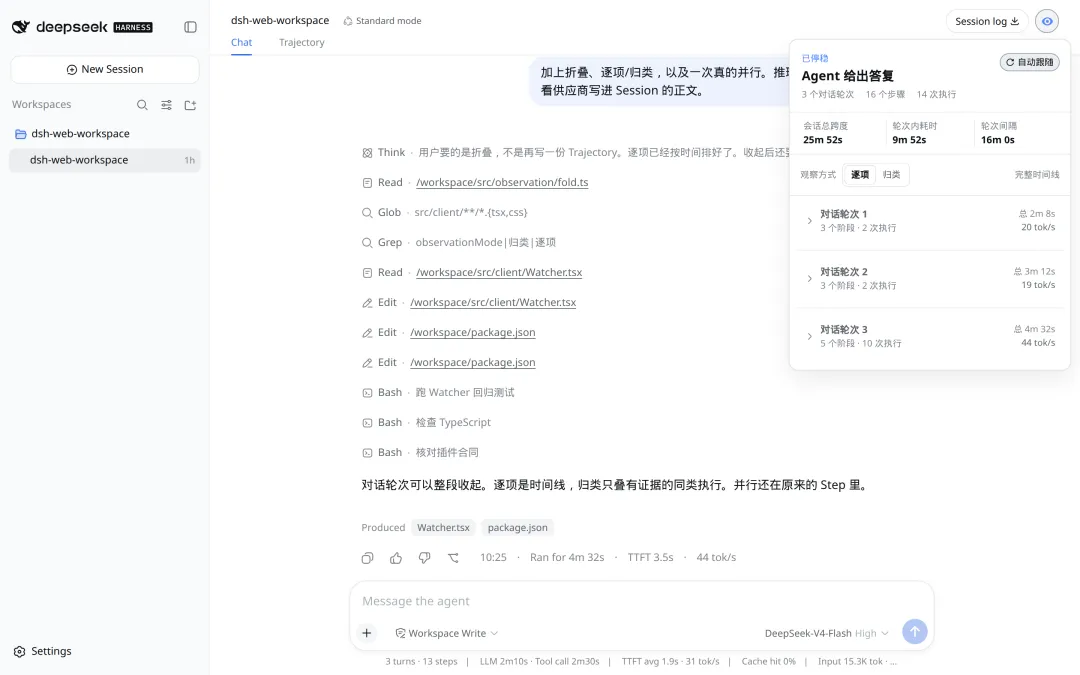
三个对话轮次全部收起,只留每一轮的总时长
它给了两个开关。一个叫逐项 / 归类。逐项是按时间把每一步摊开,这是默认视图,看因果用。归类是在同一个阶段里,把能证明是同一件事的调用叠起来,显示成 ×5,点开还能摊回原始的每一次。
这里有个细节我很喜欢:它只叠能证明相同的东西。两条不同的 bash 命令,哪怕长得再像,也绝不合并。
这听着保守,其实是克制。省事的做法是「看着像就合并」,那样数字好看了,但你被骗了。
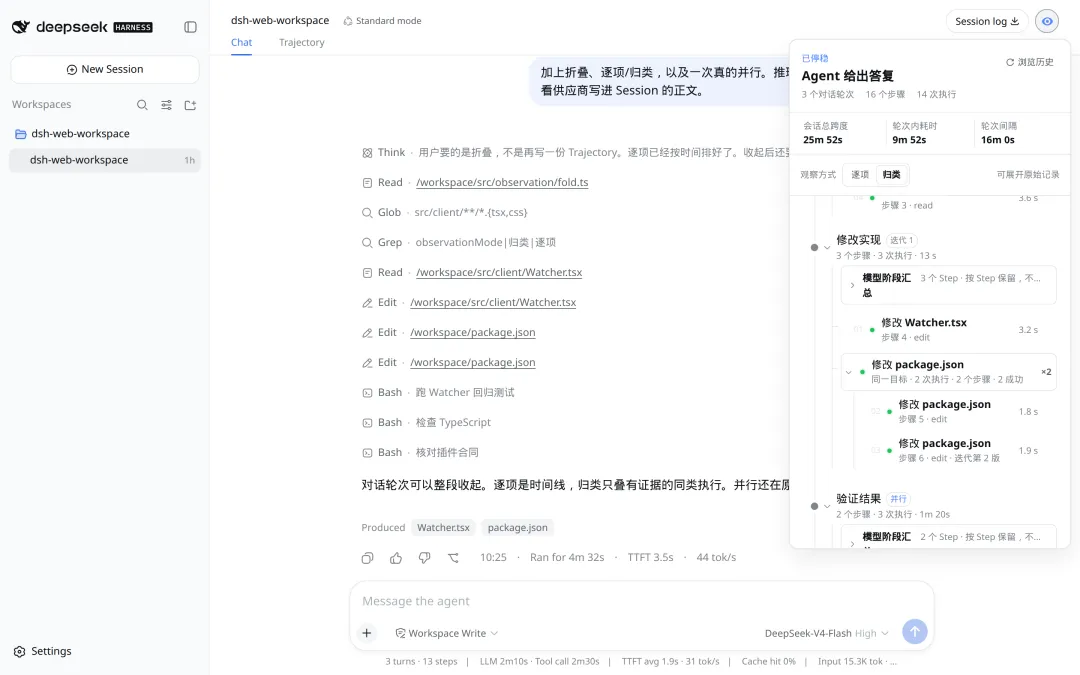
归类模式下同一目标被叠成 ×2
另一个开关叫概览 / 详情。概览停在阶段那一层,详情全展开。两个开关互不影响,你可以归类加详情,也可以逐项加概览。
还有个东西得单独说:并行调用。
Agent 经常一口气同时开三个工具。在普通日志里,这三条是前后脚出现的三条记录,你根本分不清谁是谁的。它的处理是把这三个留在同一个 Step 的括号里,各自一行,都能单独点开看。
其实吧,这个差别比想象中大。一个是「这三件事同时发生了」,一个是「这三件事先后发生了」。后者会让你对耗时做出完全错误的判断。
03
它拒绝把排队时间叫成思考时间
它真正狠的地方在计时。
一般的耗时统计给你一个总时长。它给你四个:首响应等待、可见推理、输出-工具意图、重试-未归因。
然后立了一条规矩,我看到的时候是真的有点被戳到——
不许把首响应等待叫成「思考时间」。
为什么?
因为从发出请求到第一个字蹦出来,这段时间里装的东西不止是模型在想。可能有排队,可能有网络往返,可能是上下文太长正在做 prefill,也可能是供应商那边在限流。你把这一整段都叫「思考」,等于让一个仪表盘替你编了个故事。
它的设计文档里,把「思考耗时」这个词直接列成了禁用词。不加限定地说「思考花了多久」,在这个项目里是违规的。
这条规矩不是拍脑袋定的。它有个反例。
设计文档里记着一次审计:一份真实的会话日志,3 个对话轮次,203 个 Step,230 次工具动作。其中有一个 Turn,从头到尾跑了 2,020,092 毫秒——33 分 40 秒。
33:40
一次 Turn 的总时长
203
这一轮的 Step 数
230
工具动作次数
而当时那个界面,只暴露了几十条短命令各自的耗时。
也就是说,你盯着屏幕看到的是「每条命令都挺快的」,实际发生的是「这一轮跑了半个多小时」。那半个多小时去哪了?没人知道,因为没有一个地方在算它。
整套计时体系,是被这个看不见的 33 分钟逼出来的。
顺带一个我觉得很聪明的处理:它把会话总跨度拆成两段,轮次内耗时,和轮次间隔。
前面那段是 Agent 在干活,后面那段是你在想事情、去开会、去吃饭。分开之后你才知道,这半小时里到底有几分钟该算在它头上。
04
它也不把拿到结果当成成功
第二条规矩,比第一条还反直觉。
拿到结果,不等于成功。
大部分日志的默认逻辑是:工具返回了,那就是成功了,打个绿勾。这条链条的问题在于,一条 curl 返回 404 也是返回了,一条 npm install 报错退出也是返回了。
所以它的中立态不叫成功,叫已返回。
已返回
工具给了回应,但没有任何证据说明它对
成功
必须拿出退出码是 0 这类权威证据
要变成成功,得拿出权威证据:退出码是 0,或者结果类型本身就是非错误的。拿不出来,就一直停在已返回。
更绝的是它对轮次的处理:一轮里面某个子步骤成功了,整轮不会因此变绿。反过来也一样,一个子步骤失败,不会让整轮直接判死。
这话听着像产品细节,其实是数据伦理。
因为一旦「拿到了东西」就等于「成功」,所有统计都会系统性偏乐观。报错率低、成功率好看,而你在真实使用里被坑的次数一分不少。
它还有一组定义也挺较真。N 次执行,是不同记录;重试 N 次,必须是同一工具同一参数在失败之后再次出现;迭代 N 版,是同一个目标输入变了。
最后一条:没有证据,不许写「循环」。
我看到这句时笑了一下。因为「它在循环」是我们最容易脱口而出的判断,而它偏偏要求你把证据摆出来才能这么说。
05
最打动我的,是它敢写「这个测不到」
说到这儿,得讲一件让我对它好感陡增的事。
它的设计文档里留着一行更正记录。
更正记录 · 2026.09.09
大意是:之前写过的几组性能拆分比例——队列和网络占 60/40、推理占 75/25、生成占 70/30,还有一个 bash 兜底占 85%——这些数字是编的,不是测量出来的。现在撤回。
60/40 75/25 70/30 85%
全部作废
我看到这行的时候是真愣住了。
一个开源项目的设计文档里,作者主动追认「我之前写的那几个百分比是我编的」。这种事在开源社区不常见,在成熟公司的产品文档里更不常见。
但你回头看它整套设计,会发现这行更正不是孤例,是同一个东西的两次显形。
它给缺数据留了两个专门的词。测到了但供应商没上报,写「未上报」;压根没记录,写「未记录」。两个词不混用,也绝不用 0 去填。
它的设计文档里还有一句话,我觉得可以印在所有监控面板上:
缺失的计时和用量,是 absence,不是 zero。
还有一条更硬的:不许还原,不许把推测写成事实,不许声称自己有权访问隐藏的思维链。能看到什么就展示什么——供应商已经写进会话里的可见推理,有就显示,没有就写「未记录」。
你想想看,这句话在今天的语境里有多不合时宜。
现在满地都是「我看到了模型的思考过程」的产品。而它站出来说:我只展示你有权看到的那部分,剩下的我不猜。
顺着这条线,还有个特别技术、但特别能说明问题的 bug。
它早期是按事件到达的顺序排列步骤的。结果有一次,几个延迟到达的审批事件,把 Step 110 到 113 插到了 Step 104、106、108 下面,整条时间线错位了。
修法是把排序权威从「到达顺序」换成「Turn → Step → 事件序号」,然后锁了一个回归测试。
这事儿小到不值得写进更新日志,但它说明一件事:这个项目对「什么才算证据」是有洁癖的。连事件先来后到这种事都要按权威来,那它给你的那些百分比,可信度自然不一样。
06
省钱这件事,它做成了一张榜
前面都在讲看得准,这段讲看得值。
它有一块 Insights 区,最显眼的是前缀缓存命中率排行榜——按命中率从高到低排你的模型,每个模型下面还挂着命中复用了多少 Token、实际付了多少输入 Token。
这块东西为什么会存在?
因为前缀缓存是今天 Agent 成本里最容易被忽略的一项。同一段系统提示词、同一批工具定义、同一份记忆,如果每次请求都能命中缓存,你的输入成本可能只有没命中的几分之一。
而绝大多数人根本不知道自己的命中率是多少。很多朋友可能不知道,这一项在账单上根本不单独列。
排行榜 · 每个模型两栏
按命中率从高到低
命中率 · 复用 · 实付
命中率 / 复用 Token / 实付 Token
同一套三栏,换一个模型
再换一个,一直排下去
条形长度只是示意,不是它的真实命中率 —— 那个数只有你自己的会话里才有
它把这个数字做成了一张能排名的表,还配了句解释:这个榜直接决定上下文成本,也决定了首字响应快不快。
同一块面板上还有别的切片。模型首字响应延迟对比、思考 Token 占比、工具与终端命令的耗时全景、报错与重试的可靠度排查。
然后是钱。
它内置了一张价格表,三百多行,覆盖 DeepSeek、MiniMax、OpenAI、Anthropic、Gemini、Grok、GLM、Qwen 这些。按输入、输出、缓存三个桶分开算,给你一个估算费用。
坦率的讲,这个功能里最值得学的不是算法,是措辞。它在文件头就写明了:费率会落后于厂商官网,这是估算,不是账单。
显示 0
你会以为这模型免费
显示 未知
你知道这里没算
而且它有个处理我挺佩服:模型不在表里的时候,显示「未知」,不显示 0。
这个区别很大。0 会让你以为这模型免费,未知会让你知道这里没算。
它也不联网取价。你改了价格,改动只存在本地。
还有一件事得说,因为它决定你能不能用得顺手。
它打开面板的时候会自动去补历史,走的是官方的分页接口,一直往前翻到你这次会话的开头。翻的过程中,它会老老实实标一句「部分证据」——意思是现在这段还没加载完,你先别拿它下判断。
这个「部分」两个字,很值钱。
因为你想想看,任何一个统计工具,在你数据只加载了一半的时候给你的那个数字,都是错的。绝大多数工具不会告诉你这件事,它就直接显示出来,你自己看着办。
加载完整之后,它还会告诉你「已加载多少、总共多少」。这两个数你都看得见,你才知道自己看的到底是全貌还是片段。
我这人有点强迫症,看到「部分证据」这四个字反而踏实。因为它不是假装完整。
07
怎么装,以及几条得提前知道的
装法不复杂。
前提是你的 DSH 得在 0.2.0 那一档——具体是 0.2.0-rc.2,或者已经发出来的 0.2.0 稳定版。它明确不接受 alpha 版,装之前先确认一下自己的版本。Node 要求 22.19 以上,或者 24 及以上。
Web 端走命令行:
terminal
$ dsh plugin --profile web add dsh-watcher
$ dsh web
桌面端走应用内:侧边栏进「插件」,点「添加插件」,搜 dsh-watcher,点安装。
坑 · 只对 Web 生效
有个坑得提一句:用命令行装,只对 Web 生效。官方 CLI 只写 web 这个 profile,改不了桌面 App。桌面端必须走应用内那条路。
装完第一次可能要刷新一次页面,之后客户端的热更新才会生效。
然后是几条得提前知道的。说句大实话,这几条都直接影响你要不要装。
1 它跟 DSH 的版本卡得很死。这是插件类项目的通病,但它属于比较严重的那种。它跟着 DSH 从 0.2 的 rc 一路迁过来,每次上游删掉一个图标导出——比如把带尺寸后缀的名字换成不带后缀的——它整块渲染就崩。所以 DSH 那边一升级,它大概率要跟一版。你要用它,就得接受这个节奏。
2 每日 token 统计有个跨时区的口径问题,还没修。它按本地日历日把用量入账,跨时区的时候会对不上。
3 估算费用是估算。价格表得靠人更新,它自己不联网。
4 只能在 Web 端用。窄屏会切成单栏,但没有原生移动端体验。
5 它不替你做决定。它能告诉你时间花在哪、钱花在哪、哪一步在重试,但要不要改、改成什么样,还是你的事。
把这些摆出来不是劝退。有一说一,是想让你装之前心里有个数——哪些是设计如此,哪些是还没做完。
· · ·
说点真的。
我们这一两年看 AI,看的基本都是它有多聪明。跑分一出来,谁分高谁就赢了。
但真把 Agent 用起来你会发现,卡住你的往往不是聪明程度,是看不见。
它跑了半小时你不知道它在干嘛。它说做完了你不知道是不是真做完了。它报了个错你不知道这个错重试过几次。这些都不是智力问题,是观测问题。
而观测这件事,最难的部分从来不是画图,是承认自己测不到什么。
你想想看,一个面板,把所有的格子填满,把每条曲线画得漂漂亮亮,那东西看起来最专业。但它可能有一半的数字是估的、猜的、或者拿 0 填的。你看着它做决策,错得理直气壮。
DSH-Watcher 反过来。它先给你划一条线,线这边是量出来的,线那边是不知道的。线画在哪儿,它写在文档里,还公开改过一次。
它给的那条线
← 量出来的
不知道的 →
两段等长只是排版,不代表比例。真实的比例它没测过,所以不给。
我觉得这才是仪表盘该有的样子。
最后给三个判断,你要是想试,照着挑就行。
用不上
只是偶尔跟 AI 聊几句 单次对话的耗时你肉眼就能感知。
值得装
在跑长任务、被「感觉有点慢」折磨过 先完整看一次工作路径,把「感觉慢」换成「哪一步慢」。
先看榜
在意上下文成本 先去看那个缓存命中率榜。看完你对自己手上那几个模型的用法会有新想法。
有一句话我想放在最后。
把排队时间叫成思考时间,是仪表盘最常见的撒谎方式。而一个愿意在文档里撤回自己编的数字的作者,他说「未上报」的时候,你才敢信。
回到开头那杯茶。你回来的时候,它还是跑完了。
只是这回,中间那二十分钟去哪了,有人告诉你。
THE END
以上,既然看到这里了
如果觉得不错,随手点个赞、在看、转发三连吧
👍 点赞
👀 在看
↗ 转发
如果想第一时间收到推送,也可以给我个星标 ⭐
谢谢你看我的文章,我们,下次再见。
/ 作者:Patrick
/ 这里分享好用的 AI 工具和 skill
/ 创作不易,三连支持一下吧 ~