ARTICLE · 1367165
大规模文档去重还在二选一?SemHash-LLM:多粒度级联过滤,1%神经计算量搞定语义级去重
字数 3322,阅读大约需 17 分钟
大规模文档去重还在二选一?SemHash-LLM:多粒度级联过滤,1%神经计算量搞定语义级去重
做语料清洗、大规模文档库治理的团队,应该都卡在这个两难上:要快,就用MinHash、SimHash这类指纹法,毫秒级处理,但改写、复述、模板包裹的近重复根本认不出来;要准,就用嵌入向量做语义匹配,准是准,但百亿千亿级文档量算下来,计算成本和阈值调优根本扛不住。
尤其是现在预训练语料越做越大,网页、论文、代码各种来源混在一起,有模板包裹的、有片段转载的、有父子包含的,各种重复形态都有。单一粒度的去重方法,要么漏判要么误判,要么成本爆炸。
独立研究者联合东北大学、雪城大学的这项研究,提出的SemHash-LLM框架,刚好针对这个痛点。它不是单一的哈希或者单一的嵌入,是一套多粒度级联的去重流水线:字符级、token级、语义级三层特征融合,从布隆过滤器到语义哈希到加权LSH层层过滤,最后只有不到1%的边界案例才调用LLM裁判。五类去重场景全覆盖,最终综合得分91.05,比之前最好的DedupLM高近10分,而神经验证成本不到总计算量的1%。
一、核心痛点:传统去重的结构性失衡
先把现状说透。传统的文档去重,本质上就是在速度和语义之间二选一,天然顾一头。
精确指纹类方法,比如MinHash、SimHash,基于n-gram字面匹配,快是快,复杂度线性,但只能认字面。同一个意思换个说法、改个句式、调整下语序,直接认不出来。网页里常见的模板包裹——正文一样,头尾加了导航、广告、cookie提示——也认不出来,因为头尾的n-gram不一样。
纯嵌入语义类方法刚好反过来,能识别同义改写,能判断语义近似,但计算量大,阈值难调,规模上去之后成本爆炸。而且固定阈值根本应对不了不同类型的文档:技术文档本身重复度高,正常引用多;普通内容重复一点就算抄袭。统一用0.8阈值,要么漏很多要么误很多。
更麻烦的是真实语料里的重复根本不是一种形态:有改几个字的字符级近重复,有套模板的token级重复,有改写的语义级重复,有大段包含的父子关系,还有病毒式传播的高频片段。每一种适合的粒度都不一样。单一方法,天然顾不过来。
SemHash的核心思路就是:不赌单一方法,做级联管道。粗筛先把明显不可能的去掉,越来越精细,最后最难的边界案例才上LLM。大部分流量都在前面的低成本阶段,又准又快。
二、核心架构:五大组件,三级粒度,四级过滤
整个框架不是一个单一算法,是一套完整的分层去重系统。从特征提取到过滤再到最终裁判,全链路针对大规模语料优化。
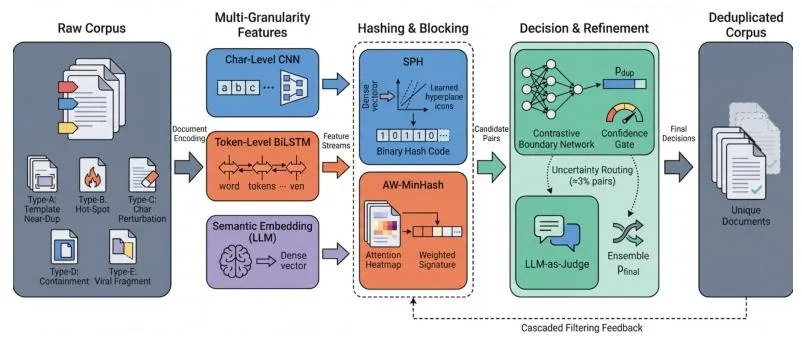
图1 SemHash-LLM整体框架
文档输入后,编码成字符、token、语义三级粒度特征,通过级联过滤管道逐步缩小候选集,边界案例交由LLM裁判。覆盖模板包裹、热点分布、短文本扰动、父子包含、高频片段五类去重场景。
1. 语义投影哈希:把语义塞进二进制哈希
这是最核心的组件,解决传统SimHash只能认字面的问题。不是直接对token做哈希,是先映射到LLM的语义嵌入空间,再学习一组超平面哈希函数,把连续的嵌入转成紧凑的二进制哈希码。
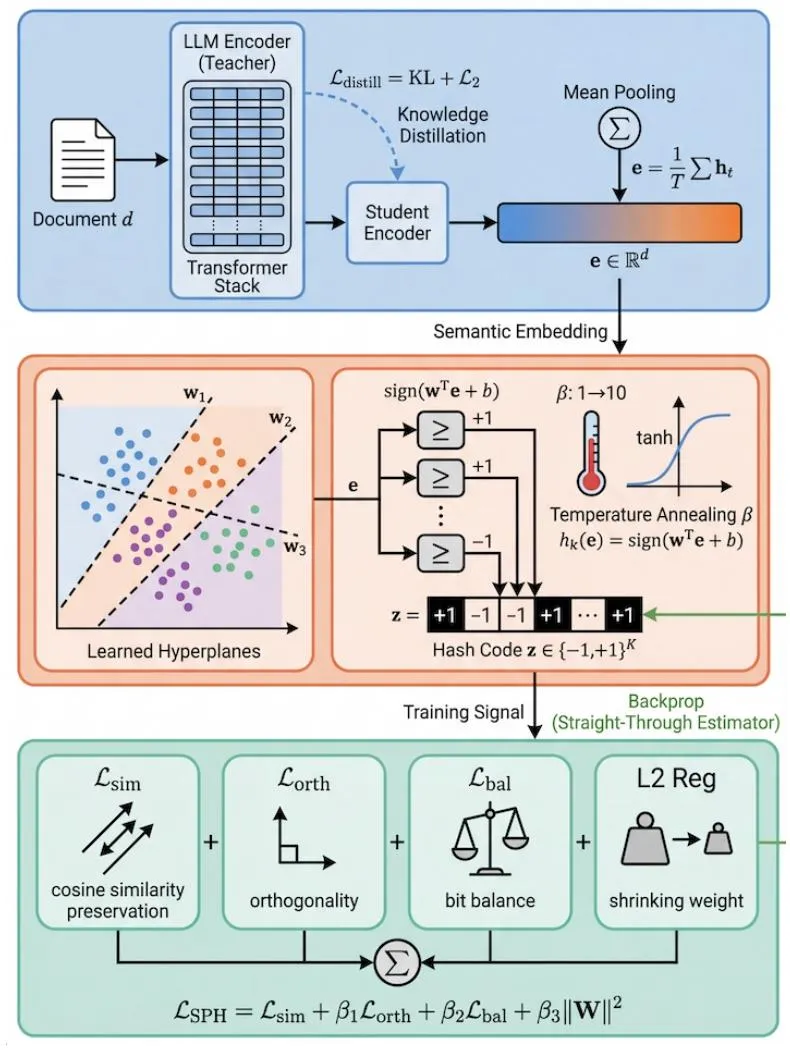
图2 语义投影哈希训练流程
用大模型教师蒸馏出轻量学生编码器,得到语义嵌入;通过学习的超平面分区映射成二进制哈希;训练目标同时优化相似性保持、正交性、位平衡。
几个关键设计:
• 蒸馏轻量编码器:不用每次都跑大模型,蒸馏个小的学生编码器,效果接近,成本低很多。训练用KL散度+L2距离,保证分布和点位都准确。 • 相似性保持哈希:不是随机超平面,是专门优化的——语义越相似的文档,哈希码越大概率一样。和SimHash的随机超平面完全不是一个思路,是冲着语义相似性优化的。 • 正交+位平衡正则:防止多个哈希函数趋同冗余,也防止某一位总0或总1浪费容量。
相当于把语义相似度,压缩进了二进制哈希码里。既有哈希的速度,又有语义的准确度。
2. 注意力加权MinHash:自动过滤模板噪音
语义哈希管整体意思,词法细节和模板污染怎么办?用注意力加权的MinHash。核心洞察:Transformer的注意力模式,天然就编码了token的重要性。很多其他token关注的token,就是核心内容;没人关注的停用词、模板、广告、cookie提示,就是噪音。
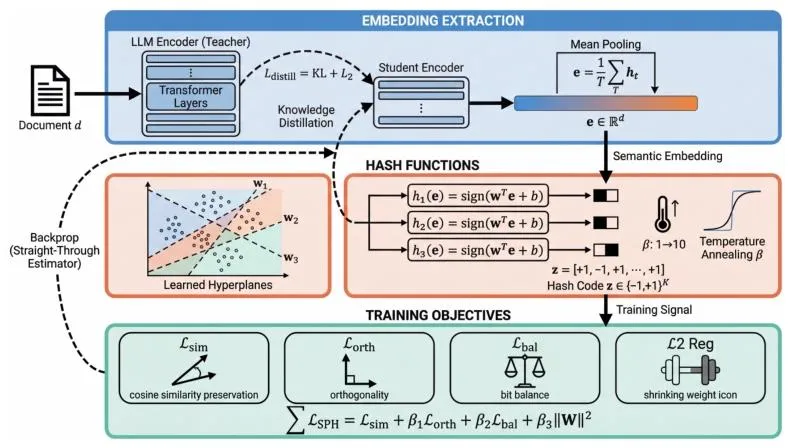
图3 注意力加权MinHash流程
聚合多层多头的注意力分数得到每个token的重要性,结合IDF得到每个n-gram的权重,加权采样生成MinHash签名,自适应LSH匹配。
做法很直接:
• 把所有层所有头的注意力聚合起来,得到每个token的重要性得分; • 每个5-gram的权重,等于覆盖token的平均注意力乘逆文档频率; • 加权MinHash采样,权重越高的n-gram越容易被选中。
相当于自动把模板、广告、导航栏这些 boilerplate 的权重压下去,把核心内容的权重提上来。不会因为两篇文章都带同样的cookie提示就被判成重复。还配了自适应LSH:注意力越集中的文档,分桶越粗;注意力越分散的,分桶越细。自动适配不同类型的文档。
3. 对比边界学习:不用固定阈值
传统去重最头疼的就是调阈值。0.8还是0.85?不同类型文档完全不一样。SemHash不用固定阈值,是用对比学习训练边界网络,还能量化不确定性。
• 对比投影学习,让重复对在投影空间里聚在一起,不同的分开; • 边界网络预测重复概率,还针对五类去重场景分别优化阈值; • 蒙特卡洛Dropout算不确定性,方差大的就是边界案例,自动送去给LLM裁判。
相当于自动学会不同场景的判断标准,不用人工一个个调。还能知道自己拿不准,自动甩给更高级的裁判。
4. LLM裁判:只判边界案,成本不到1%
拿不准的才给LLM,不是所有都判。实际只有大概3%的候选对会走到LLM这一步,最终神经验证的计算量不到总计算量的1%。LLM也不是随便判,是结构化prompt,带明确的去重标准和示例,输出重复、不同、包含三类结果,还有置信度。最后和自动预测做置信度加权融合:谁信得过听谁的,都不确定就折中。
5. 多粒度融合网络
前面三个粒度的特征,不是各干各的,是用门控融合网络自适应加权。
• 短文本:字符级特征权重高; • 长文档:语义级特征权重高; • 模板特征明显的:token级特征权重高。
自动适配不同场景,不用人工切模式。
四级级联过滤管道
最后整套系统做成四级过滤漏斗,层层收窄候选集:
1. 布隆过滤器预筛:O(1)查精确n-gram,干掉40%的候选; 2. 语义哈希分块:64位哈希,汉明半径8,再干掉95%; 3. 注意力加权LSH:再筛掉70%; 4. 神经验证:最后剩下的不到1%,给LLM判。
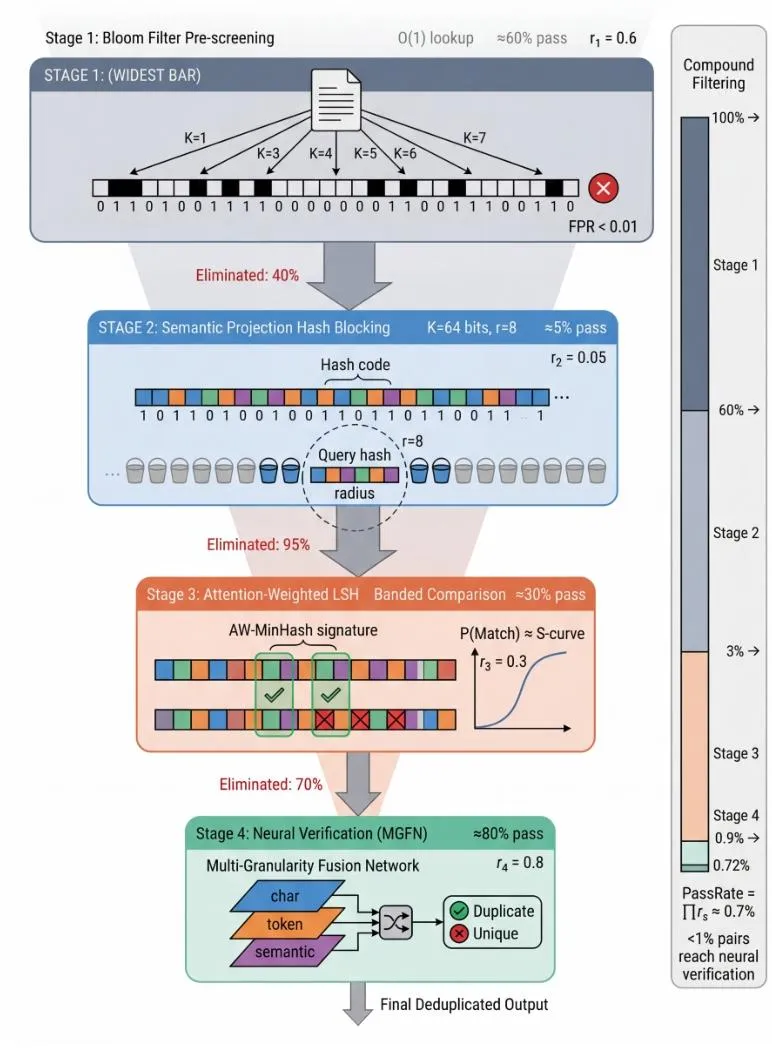
图5 级联过滤漏斗
四级过滤层层缩小候选集,从全部到60%到5%到3%到0.7%,最终只有不到1%的对需要神经验证。
整体通过率大概0.7%,也就是说绝大部分候选都在前面的低成本阶段处理完了,只有最难的边界案例才动用LLM。兼顾了精度和成本。
三、实验结果:全面领先,消融扎实
实验是在100GB的RedPajama网页语料上做的,覆盖五类去重场景:模板包裹(A)、热点分布(B)、短文本扰动(C)、父子包含(D)、高频片段(E)。
1. 主结果:全面领先基线
表1 性能对比与消融实验
每一类场景都领先,最终得分比之前最好的DedupLM高了近10分。尤其是E类高频片段和D类包含关系,提升非常明显,这两类刚好是传统方法的老大难。
2. 消融验证:每个组件都有明确价值
消融实验也很扎实,验证了每个组件的独立贡献:
• 去掉SPH语义哈希:总分掉到79.32,下降近12分,说明语义哈希是整个框架的核心; • 去掉AW-MinHash注意力加权:掉到85.18,也降了近6分,说明词法层面的加权过滤也很重要; • 去掉MGFN多粒度融合:掉到84.56,说明多粒度门控融合也有稳定贡献。
每个组件都有明确的价值,不是凑数的装饰。
3. 效率:贵的计算用在刀刃上
最有工程价值的是效率:四级过滤下来,只有不到1%的候选对需要神经验证。大部分计算都是哈希、布隆过滤器、轻量编码器这些低成本操作,LLM只处理最难的边界案例。这也是这套方案能撑得起万亿级语料的核心原因:把昂贵的计算用在刀刃上,而不是全量堆大模型。
四、工程启示与局限
对落地的几个启示
第一,大规模去重别死磕单一方法,级联管道性价比最高。不要要么全哈希要么全嵌入。前面用低成本方法粗筛,把99%的简单案例处理掉,最难的1%用重武器。整体成本降很多,精度还能保证。
第二,注意力是天然的内容重要性信号,别浪费了。做去重、匹配、检索,都可以用注意力权重来压模板、压噪音。不用额外训重要性模型,从编码器的注意力里直接提,免费的信号,效果还很好。
第三,阈值别手调,对比学习自动适配。不同类型文档、不同场景的最优阈值完全不一样。手调永远调不完,用对比学习自动学边界,还能量化不确定性自动分流,比人工准还省力。
第四,LLM做裁判别全量用,只处理边界。什么都让LLM判成本扛不住。把LLM当最后一道防线,只处理自动系统拿不准的边界案例,性价比最高。
局限
当然也有局限:
• 目前主要验证了英文语料,多语言的适配性还需要验证; • 学生编码器是领域相关的,跨领域迁移需要重新蒸馏; • 五类去重场景,更复杂的深度改写、意译类近重复还需要进一步验证。
结语
SemHash-LLM最有价值的地方,是它没有走“用大模型做去重”的蛮力路线,而是走了“多粒度级联+边界智能裁判”的工程路线。把便宜的、快的方法用在前面处理绝大多数案例,把昂贵的、强的模型用在最关键的边界上。既有语义级的准确度,又有哈希级的效率,还能撑大规模。
对于做语料清洗、大规模文档治理、预训练数据处理的团队来说,这套思路非常值得借鉴。不用在速度和精度之间二选一,搭个级联管道,大部分场景用低成本方案,边界上大模型兜底,就可以又快又准。如果你的团队还在为大规模文档去重的效率和精度头疼,这套多粒度级联去重的思路,非常值得参考。
https://arxiv.org/pdf/2607.01601