ARTICLE · 1378742
想把一本扫描版PDF电子书整理成可阅读的EPUB电子书?小工具来了,欢迎试用
想把一本扫描版PDF电子书整理成可阅读的EPUB电子书?小工具来了,欢迎试用
手头不少旧书与资料,只有扫描件:能看,却无法选中文字,翻到哪一页都得从头找目录,想做笔记和摘录尤其不便。 若你常与这类 PDF 打交道,下面这个工具或许能省下不少工夫。 这是一款在浏览器中运行的 PDF 转 EPUB 工具,面向没有文字层的扫描版 PDF。它做的不仅是格式转换,而是依据 OCR 识别结果重建目录与章节,输出结构清晰的 EPUB 3 电子书。 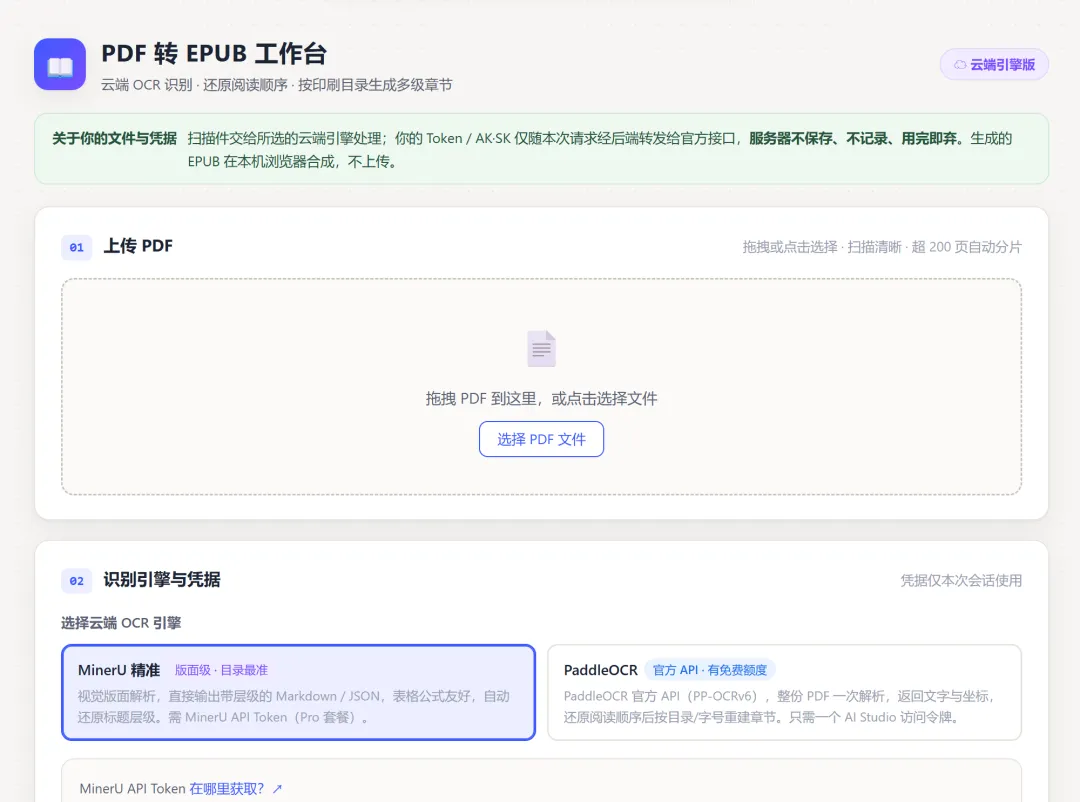
两种识别引擎可选。 MinerU 精准解析适合复杂版式与长文档,超过 200 页自动分片处理;PaddleOCR(PP-OCRv6)逐页识别文字与坐标,按阅读顺序还原正文。两者均由使用者自行填入访问令牌,请求经同源后端转发,令牌不落盘、不入日志。 目录与结构可校正。 提供「按识别字号生成」与「以印刷目录为准」两种策略。后者严格依据书前印刷目录的条目与页码切分章节;识别不准时,可人工标注目录页协助定位。生成后可在预览中调整标题层级、增删章节、编辑正文。 元数据与注释。可填写书名、作者等元数据,并从豆瓣链接自动抓取书籍信息;支持圈号、数字、符号及跨页注释,统一归并于章末,正文与注释之间双向跳转。 上传不限文件大小,长文档分块传输,输出符合 EPUB 3 标准。 使用入口: PDF 转 EPUB 工作台 · 云端 OCR + 印刷目录(请扫下方二维码码) 
捕梦网携手WorkBuddy联合出品,欢迎试用。请多多提出问题和意见,私我或者直接发在评论区都行。好用的话可以转发给身边需要的朋友~