 夜雨聆风
OpenClaw等开源智能体框架热度极高,但风险同样突出,银行应如何制定引入策略?对其又该如何进行安全评估?以下内容来自相关课题,所体现的银行业现状和同行交流分享可供大家参考。
· 来自企业IT应用趋势项目创新联盟 · “开源治理与基础软件选型与收敛”课题方向 | 银行开源治理:创新与安全可控课题
OpenClaw等开源智能体框架热度极高,但其默认配置脆弱、供应链风险突出,银行应如何制定引入策略?
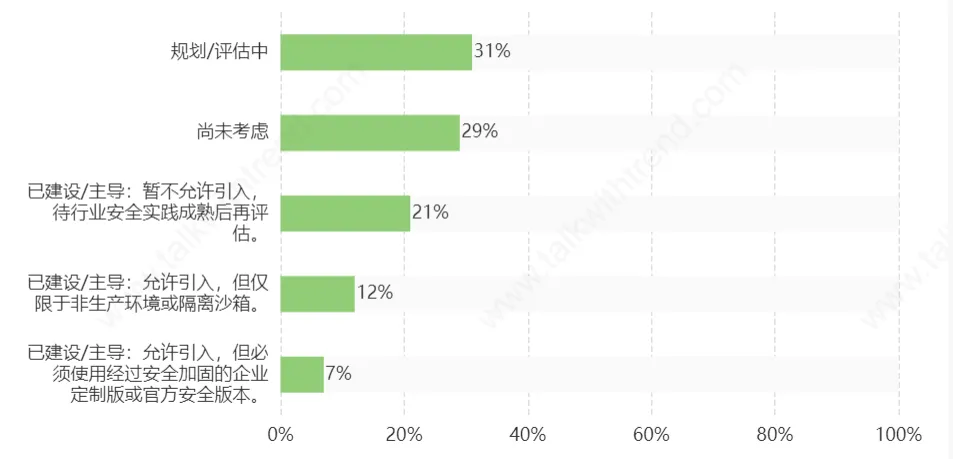
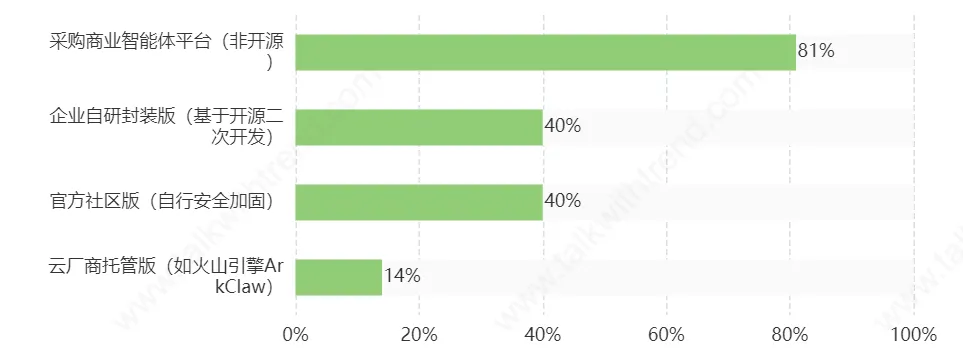
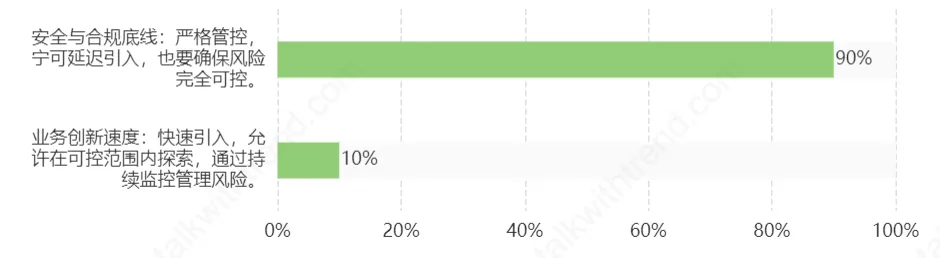
*投票为社区同行投票的阶段性结果(目前来自42家企业同行),还不是最终结论,仅供参考
技术路线状态:当前得票最多的为【规划/评估中】
产品/方案选型倾向(针对“允许引入”路线):当前得票最多的为【采购商业智能体平台(非开源)】
核心能力权衡:在引入策略上,更应优先保障的是:当前得票最多的为【安全与合规底线:严格管控,宁可延迟引入,也要确保风险完全可控。】
数据来源:https://www.talkwithtrend.com/Poll/478575
如何对开源智能体框架(如OpenClaw)进行安全评估?评估维度应包含哪些(许可证、社区活跃度、历史漏洞、默认配置安全性)?
某银行行业用户:
对开源智能体框架(如 OpenClaw)进行安全评估,应聚焦于“硬隔离”与“防注入”,核心评估框架可精简为四个维度:
1. 环境隔离评估(防止宿主机沦陷)
沙箱验证: 确保 Agent 执行代码/命令的环境在严格隔离的微虚拟机(如 Firecracker)或无 Root 权限的 Docker 容器中。
网络限制: 检查网关(如默认端口 17477)是否误暴露至公网;验证是否阻断了 Agent 访问内网敏感资产的权限。
2. 交互与逻辑评估(防止越狱控制)
提示词注入防御: 测试输入端是否能通过“恶意提示词”诱骗 Agent 绕过设定(如利用工具读取系统文件)。
人类确认机制(HITL): 评估高危操作(如删除、转账、改密)是否强制需要人工审批,严禁全自动化执行。
3. 代码与接口审计(防止传统漏洞)
鉴权机制: 重点审计网关的 API 签名与 Token 认证逻辑,防止出现类似“签名绕过”的未授权访问漏洞。
命令注入: 针对框架中涉及 eval()、subprocess 等代码段进行审计,防止恶意输入转变为系统命令直接执行。
4. 实操评估路径
基线自查: 对照官方/慢雾安全指南,自查是否使用默认 Token、是否超配权限。
红蓝对抗: 在隔离测试端扮演黑客,尝试通过 Chat 窗口诱骗 Agent 探测内网或读取宿主机敏感信息,检验防御有效性。
某互联网应用服务行业用户:
对开源智能体框架(如 OpenClaw)进行安全评估,应聚焦于“硬隔离”与“防注入”,核心评估框架可精简为四个维度:
环境隔离评估(防止宿主机沦陷)
交互与逻辑评估(防止越狱控制)
代码与接口审计(防止传统漏洞)
欢迎大家交流分享
支持社区支持本文同行观点,请点赞、转发或点击“♡”
欢迎点击文末阅读原文,可以直接看到社区中本文中可能不包括的的全部信息和最新更新
本内容属于以下课题,欢迎参与交流,了解更多可点击↓↓↓
银行开源治理:创新与安全可控难点攻坚【课题活动 | 欢迎加入我们】
*本公众号所发布内容仅代表作者观点,不代表社区立场
点击下方↙↙↙阅读原文,更丰富,更精彩