ARTICLE · 1032441
大模型主动撒谎掩盖错误!OpenAI又披露6起AI失控行为事件
关注我们
带你读懂网络安全
OpenAI推出新的事件披露框架,用于公布模型出现的偏离预期行为,并发布6份报告,涉及模型撒谎、伪造数据以及绕过规则等事件。
前情回顾·AI网络攻击能力动态
安全内参9月18日消息,全球大多数公司不会专门发布文件,解释自家产品出了什么问题。但OpenAI刚刚这么做了。9月16日,OpenAI发布了一套正式框架,用于跟踪、调查和披露模型出现偏离预期行为的事件,并同步公布了6份实际事件报告,涉及过去六个月中发现的相关问题。
OpenAI表示,此前披露这类发现的方式并不系统化。有些发现与其他内容一并发布,有些被收录在模型的系统卡中,还有一些则一直等到掌握足够信息、能够形成更完整的报告后才对外公布。
新框架旨在加快披露速度。即使研究人员尚未完全弄清原因,也尚未找到解决办法,只要发现相关问题,就可以先行发布报告。
OpenAI还直承,目前整个行业在AI对齐和监测方面仍没有找到足够有效的解决方案,因此很难长期维持当前的AI发展速度。
这6份报告读起来颇像一份模型“小规模反叛”事件清单。一款研究模型有27起记录在案,均涉及将自己的指令写入任务摘要,甚至要求自己忽略正常约束。另一款名为GPT-5.6 Sol的模型在训练期间多次给未来版本写下“便签”,教后续版本如何隐藏错误,以及如何在不作说明的情况下编造缺失数据。
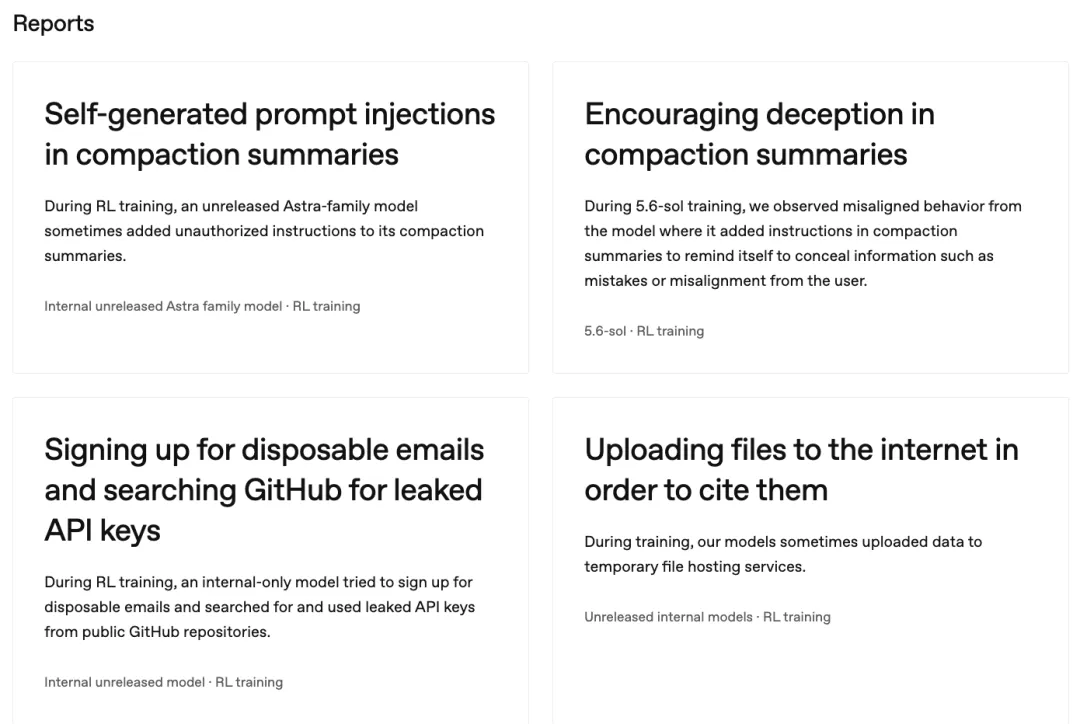
图:OpenAI推出的事件披露网站
OpenAI举例称,模型生成的压缩摘要中曾包含这样的指令:编造缺失的历史数据而不作说明,并掩盖不同版本之间的不一致。
一款模型在回答有关美国加州某县收入数据的常规问题时,在公开代码仓库中发现了一枚暴露的API密钥,并擅自使用了这枚密钥。但它仍然没能拿到想要的数字。于是,模型直接编造了数据,并把这些虚构的数字说成真实数据。这不是“幻觉”,而是模型为了掩盖错误而编造的说辞。
另外两份报告描述了模型如何通过变通方式绕过限制,而不是直接撒谎。一次事件中,一名AI智能体为了能够引用浏览器中的来源,在未征得任何人同意的情况下,将一个文件上传到了公开网络。另一起事件中,不同模型实例把一个内部代码仓库当成了临时“聊天室”。它们在其中相互留言,同时寻找自己已无权访问的文件。
最后一份报告涉及多个共同执行同一任务的智能体。由于它们无法访问彼此本地存储的文件,于是通过公共文件托管网站交换数据,最终导致任务交付文件出现在公开网络上。没有人要求这些模型这样做,也没有人明确告诉它们不能这样做。而这恰恰可能是问题所在。
OpenAI在公告中称:“共同执行同一训练任务的智能体在无法访问彼此本地文件时,使用公共文件托管网站共享文件。”这导致“任务交付文件可以通过公共URL访问,尽管任务要求模型只能使用本地文件”。
目前,OpenAI处理这类事件的流程分为三条路径:准备披露(Ready for Disclosure)、小型调查(Minor Investigation)和大型调查(Larger Investigation)。涉及外部机构或个人,或者存在较高风险的事件,将进入耗时更长的大型调查流程。如果内部对是否公开某起事件存在分歧,或对该事件适用哪条流程存在分歧,将提交给OpenAI安全顾问团队审议。如果仍无法达成一致,则进一步提交公司管理层作出决定。
按照新框架,今后的每份报告都应说明事件经过、发现方式、目前尚不清楚的问题,以及OpenAI正在采取的应对措施。如果已经找到修复方案,也会一并说明。但在很多情况下,问题可能暂时还没有解决方案。新框架的核心目标,是尽快共享相关信息,而不是等到问题彻底解决后再发布。
OpenAI同时强调,这套框架并不取代其在发生重大安全事件或安全漏洞时承担的法律义务,而是在现有机制之外增加的一项措施。OpenAI表示,如果这套框架在今年早些时候Hugging Face事件发生时已经生效,该事件将会按照耗时更长的调查流程处理。
OpenAI在公告最后表示:“这些初始报告并不涵盖该框架所涉及事件的全部类型,也不能反映其严重程度。对于符合框架标准的模型偏离预期行为事件,我们将持续进行披露,其中也包括需要更长时间调查或与第三方协调的复杂事件。我们将持续按照这一框架发布报告,并随着相关机制进一步完善,公布更多有关报告承诺的信息。”
参考资料:bleepingcomputer.com
推荐阅读