ARTICLE · 1043713
IBM AI4K团队做了个工具,把PDF变成AI能直接啃的数据
IBM AI4K团队做了个工具,把PDF变成AI能直接啃的数据
电脑里躺着几百篇PDF资料,想用AI帮忙读,结果发现它经常答非所问。
问题不在模型,在文件本身。PDF是给人看的排版格式,不是给机器读的数据格式。
IBM苏黎世研究院做了个工具叫Docling,专门解决这件事。
Docling的功能
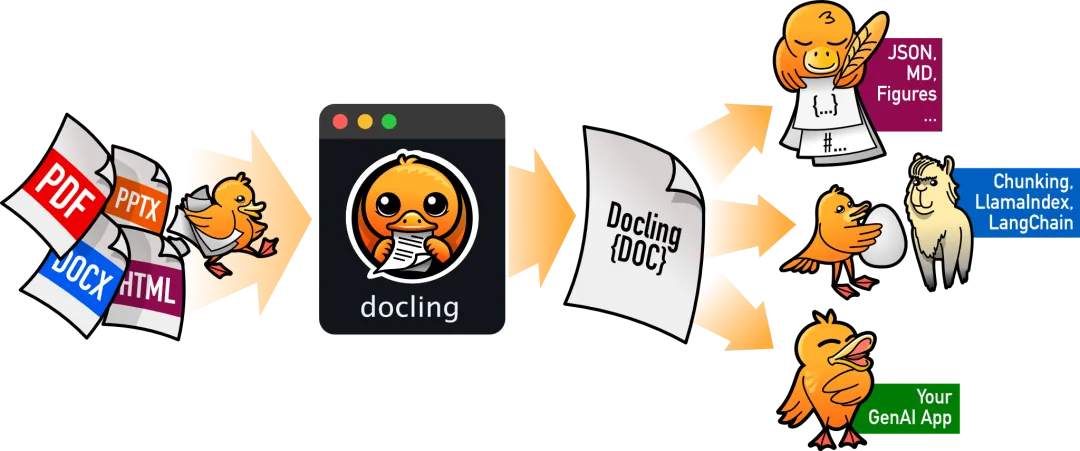
把各种文档,转成AI能直接用的结构化数据。
支持的文件类型很多:PDF、DOCX、PPTX、XLSX、HTML、EPUB、Apple Pages、WAV、MP3、WebVTT、Box Notes、EML、MSG、PNG、TIFF、JPEG、LaTeX、纯文本,还有ODF、XBRL、Markdown变体。
但真正的重点不是「支持多少格式」,是PDF解析做得细。
普通工具读PDF,就是抽文字。Docling会分析页面布局、阅读顺序、表格结构、代码块、公式、图片分类。两栏论文,它知道先读左栏再读右栏。表格,它知道哪是表头哪是数据。
它统一转成一种叫DoclingDocument的表示格式,再导出。可以导出Markdown、HTML、WebVTT、DocLang、DocTags,以及无损JSON。无损JSON这点对科研重要,意味着后续还能还原结构信息。
三个实用场景
本地运行,敏感数据、内网环境都能跑,不用把文件传到别人服务器。对处理未发表数据的人来说,这条是硬需求。 OCR支持,扫描版PDF、图片里的文字,它能识别。 和AI框架打通,LangChain、LlamaIndex、Crew AI、Haystack都能直接接,还有MCP server,能连各种智能体。
快速使用
pip安装:
pip install docling命令行转一个文档:
docling https://arxiv.org/pdf/2206.01062当前目录会生成一个md文件,里面是结构化的文档内容。Python里用:
from docling.document_converter import DocumentConvertersource = "https://arxiv.org/pdf/2408.09869"converter = DocumentConverter()result = converter.convert(source)print(result.document.export_to_markdown())Docling是MIT协议开源,托管在LF AI & Data基金会下,最初由IBM Research Zurich的AI for knowledge团队发起。项目还在活跃更新,最近加了视频解析、图表理解这些功能。
开源地址:https://github.com/docling-project/docling往期精彩