ARTICLE · 1073494
Xvisor 源码分析:中断虚拟化 — 从 HCR 注入到 VGIC 硬件辅助
中断虚拟化要回答两个方向的问题:Host 如何把一个中断交付给 Guest,以及 Guest 访问中断控制器时哪些操作需要陷出。
问题的根源在于归属冲突。整块 SoC 只有一个物理 GIC,但每个 Guest 都期望看到一个完整的、独占的中断控制器:有自己的分发器、自己的 CPU 接口、自己的中断号空间。若把物理 GIC 直接交给 Guest,两个 Guest 写同一个寄存器就会互相破坏。xvisor 的解法是把 GIC 拆成三份:软件模拟的部分、直通的部分、硬件辅助排队的部分,并用一层通用的 vcpu 中断机制在上面做粘合。这一层机制同时承担异常注入的职责,Guest 的一条未定义指令、一次数据访问失败,最终也走同一条断言路径送回 Guest。
本文代码取自 xvisor master 分支,涉及 core/vmm_vcpu_irq.c、arch/arm/cpu/arm64/cpu_vcpu_irq.c、arch/arm/cpu/common/vgic.c 与 vgic_v2.c、arch/arm/cpu/common/generic_timer.c,以及 emulators 目录下的 PL011 模拟器。全部函数名与行号均以真实源码为准。
1. 要解决的两个方向
先看 Host 到 Guest 的方向。中断送达 Guest 的最后一米是 CPU 的中断输入线:正常世界里,GIC 的 CPU 接口把物理中断信号送到核心的 IRQ 输入;虚拟化之后,EL1 不能直接接收物理中断,硬件提供了替代品,HCR_EL2 的 VI 与 VF 位可以在软件控制下向 Guest 注入一个虚拟 IRQ 或 FIQ,GIC 的虚拟化扩展则提供了功能完整的虚拟 CPU 接口。前者实现简单但只有一根线,后者需要 GIC 硬件支持。xvisor 两种都实现了,运行时按硬件能力选择。
再看 Guest 到 Host 的方向。Guest 的中断处理需要一组动作:读 IAR 拿到中断号、配置分发器的使能与优先级、写 EOIR 表示处理完毕。若中断控制器全部软件模拟,这些访问都是 Stage 2 缺页陷出,一次一次进入 xvisor;若使用 GIC 虚拟化扩展,IAR 与 EOIR 的读写由虚拟 CPU 接口硬件直接完成,不产生任何陷出,只有分发器配置这类低频操作才陷出。两种方案的性能差距因此集中在高频路径上:前者每个中断至少两次陷出,后者可以做到零陷出。
这两个方向的组合,构成了 xvisor 中断虚拟化的三条注入路径:其一,HCR.VI 软件注入,面向没有 VGIC 的平台;其二,emulators/pic/gic.c 的纯软件 GIC 模拟器,中断控制器整体陷出模拟;其三,arch/arm/cpu/common/vgic.c 的硬件辅助 VGIC,分发器软件模拟、CPU 接口直通、列表寄存器排队。前两条是保底方案,第三条是 ARM GICv2/v3 虚拟化扩展的标准用法,也是本文的主线。
2. 三层抽象:vmm_vcpu_irq、arch 层与 vgic
xvisor 把中断虚拟化切成三层。最上面的通用层 core/vmm_vcpu_irq.c 与体系结构无关,它维护每个 vcpu 的中断断言状态与 WFI 状态;中间的 arch 层 arch/arm/cpu/arm64/cpu_vcpu_irq.c 定义 ARM 平台的异常类中断与注入手段;最下面的 vgic 层 arch/arm/cpu/common/vgic.c 实现 GIC 的硬件辅助模拟。三层之间的接口是固定的函数指针,vgic 通过注册回调把自己挂进 arch 层的私有数据里。
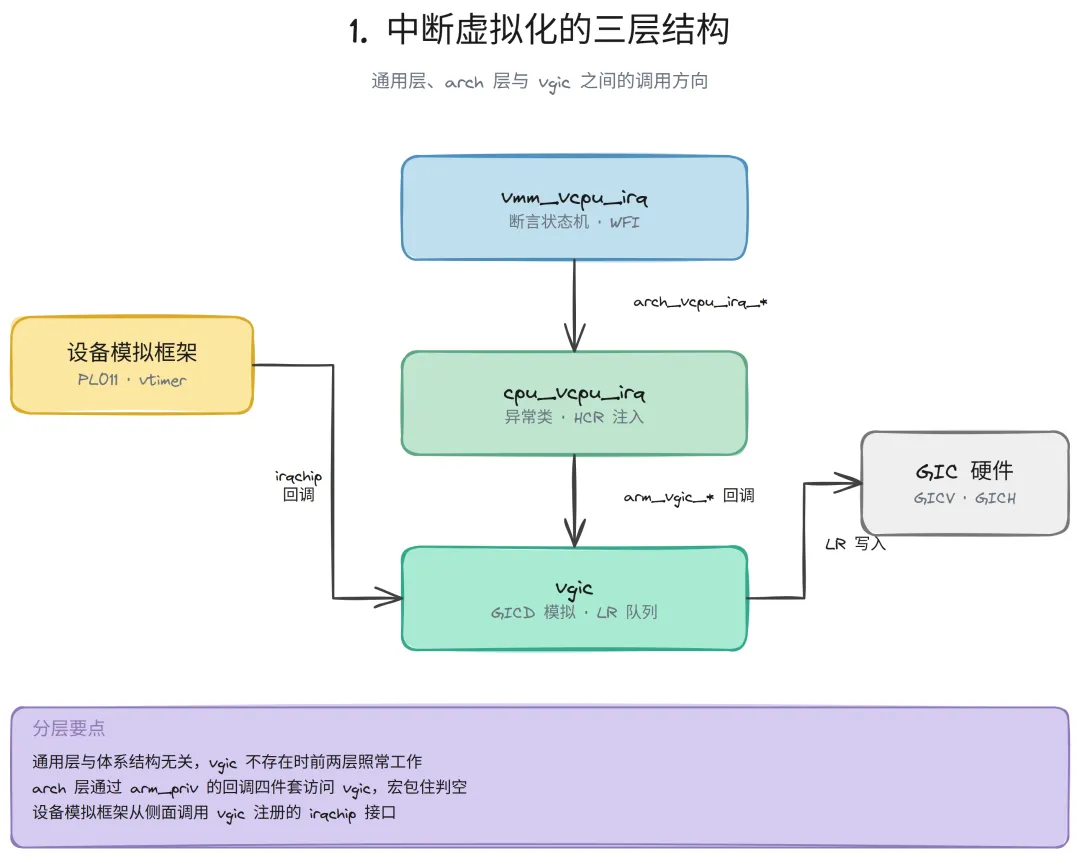
通用层调用 arch 层的 arch_vcpu_irq_ 前缀接口,arch 层通过 arm_priv 里的回调四件套访问 vgic,设备模拟框架从侧面调用 vgic 注册的 irqchip 接口。三个方向都不反向依赖,vgic 即使整体不存在,前两层照常工作。
先看 arch 层定义的中断号空间。ARM 平台的一个“vcpu 中断”不是 GIC 意义上的中断号,而是异常注入的类别编号:
u32 arch_vcpu_irq_priority(struct vmm_vcpu *vcpu, u32 irq_no){ u32 ret = 3; switch (irq_no) { case CPU_RESET_IRQ: ret = 0; // 复位:最高优先 break; case CPU_UNDEF_INST_IRQ: ret = 1; // 未定义指令 break; case CPU_SOFT_IRQ: case CPU_PREFETCH_ABORT_IRQ: case CPU_DATA_ABORT_IRQ: case CPU_HYP_TRAP_IRQ: case CPU_EXTERNAL_IRQ: case CPU_EXTERNAL_FIQ: ret = 2; // 其余异常类并列 break; }; return ret;}复位类优先级为 0,未定义指令为 1,软中断、取指与数据访问失败、HYP 陷出、外部 IRQ 与 FIQ 并列为 2。这个优先级只在“多个 vcpu 中断同时断言”时决定先执行哪个,与 GIC 的中断优先级是两套体系。值得注意的是 CPU_EXTERNAL_IRQ:它代表“有外部中断等待交付 Guest”,是 vgic 与通用层之间的挂钩。当 vgic 排队了一个待交付中断时,它向通用层断言的就是这个编号。
arch 层访问 vgic 的通道藏在 arm_priv 里。VGIC 模块初始化每个 Guest 时,把四个回调连同私有数据写进 vcpu 的体系结构私有结构,此后 arch 层只认这四个函数指针:
/* arch/arm/cpu/arm64/include/arch_regs.h */struct arm_priv { ... bool vgic_avail; void (*vgic_save)(void *vcpu_ptr); void (*vgic_restore)(void *vcpu_ptr); bool (*vgic_irq_pending)(void *vcpu_ptr); void *vgic_priv;};#define arm_vgic_setup(vcpu, __save_func, __restore_func, \ __irq_pending_func, __priv) \ do { \ arm_priv(vcpu)->vgic_avail = TRUE; \ arm_priv(vcpu)->vgic_save = __save_func; \ arm_priv(vcpu)->vgic_restore = __restore_func; \ arm_priv(vcpu)->vgic_irq_pending = __irq_pending_func; \ arm_priv(vcpu)->vgic_priv = __priv; \ } while (0)vgic_avail 同时充当能力开关:cpu_vcpu_irq.c 在执行外部中断前先查它,为假就走 HCR 注入路径。切换钩子 arm_vgic_save 与 arm_vgic_restore 也是一对宏,包住可用性判断后供 cpu_vcpu_helper.c 在上下文切换时调用。这种“宏包装的弱回调”是 xvisor 在 C 语言里模拟可选依赖的惯用手法,代价是所有调用点都必须经过宏,绕过宏直接调用函数指针会缺失判空。
3. 通用层:断言状态机与优先级执行
通用层的核心是每个 vcpu 一个的 irqs 数组。数组的每一项是一个原子状态机,取值只有三个:DEASSERTED、ASSERTED、PENDING。断言方调用 vmm_vcpu_irq_assert,执行方在 vcpu 自己的上下文里调用 vmm_vcpu_irq_process,两者可能运行在不同的物理 CPU 上,因此全部状态迁移都用原子操作完成:
static bool vcpu_irq_process_one(struct vmm_vcpu *vcpu, arch_regs_t *regs){ /* 仅当存在待执行的断言时进入 */ if (arch_atomic_dec_if_positive(&vcpu->irqs.execute_pending) >= 0) { int irq_no = -1; u32 i, tmp_prio, irq_count = vcpu->irqs.irq_count; u32 irq_prio = 0; /* 按优先级选出要执行的断言 */ for (i = 0; i < irq_count; i++) { if (arch_atomic_read(&vcpu->irqs.irq[i].assert) == ASSERTED) { tmp_prio = arch_vcpu_irq_priority(vcpu, i); if (tmp_prio > irq_prio) { irq_no = i; irq_prio = tmp_prio; } } } /* 状态迁移 ASSERTED -> PENDING,交 arch 层执行 */ if (arch_atomic_cmpxchg(&vcpu->irqs.irq[irq_no].assert, ASSERTED, PENDING) == ASSERTED) { if (arch_vcpu_irq_execute(vcpu, regs, irq_no, vcpu->irqs.irq[irq_no].reason) == VMM_OK) { arch_atomic_write(&vcpu->irqs. irq[irq_no].assert, DEASSERTED); } else { /* 执行失败,回退状态并补回执行计数 */ arch_atomic_inc(&vcpu->irqs.execute_pending); arch_atomic_write(&vcpu->irqs. irq[irq_no].assert, ASSERTED); } } return TRUE; } return FALSE;}execute_pending 是一个计数器而非布尔值,这是设计的关键:断言方每次断言使计数加一,执行方用 dec_if_positive 抢占式地取走一个执行名额,多个物理 CPU 同时断言时不会丢事件。执行失败时名额补回、状态退回 ASSERTED,下次调度重试。执行入口由调度器调用:vmm_scheduler 在每次中断退出路径上调用 vmm_vcpu_irq_process,此时 vcpu 正处于自己的上下文,arch_vcpu_irq_execute 拿到的寄存器现场是真实可注入的。
断言侧的 vmm_vcpu_irq_assert 还做两件事:检查 vcpu 是否处于可中断状态,以及断言成功后唤醒沉睡的 vcpu。前者意味着正在执行复位或已被暂停的 vcpu 不会接收中断;后者通过 hcpu_func 把 vcpu_irq_wfi_resume 投递到 vcpu 所在的物理 CPU,与第 9 节的 WFI 机制衔接。
4. 没有 VGIC 的世界:HCR 注入与软件模拟
arch 层执行一个 vcpu 中断时,先判断类别。未定义指令、取指失败、数据访问失败三类通过 cpu_vcpu_inject_ 系列函数改写 Guest 的 PSTATE 与 ELR,把异常直接写入 Guest 的执行流,这部分属于 CPU 虚拟化的范畴。外部 IRQ 与 FIQ 的处理则取决于 vgic 是否可用:
int arch_vcpu_irq_execute(struct vmm_vcpu *vcpu, arch_regs_t *regs, u32 irq_no, u64 reason){ /* VGIC 可用时,外部中断由 VGIC 硬件交付 */ if (arm_vgic_avail(vcpu) && ((irq_no == CPU_EXTERNAL_IRQ) || (irq_no == CPU_EXTERNAL_FIQ))) { arm_vgic_irq_pending(vcpu); return VMM_OK; } /* 异常类注入:改写 Guest 现场 */ switch(irq_no) { case CPU_UNDEF_INST_IRQ: rc = cpu_vcpu_inject_undef(vcpu, regs); break; case CPU_PREFETCH_ABORT_IRQ: rc = cpu_vcpu_inject_pabt(vcpu, regs); break; case CPU_DATA_ABORT_IRQ: rc = cpu_vcpu_inject_dabt(vcpu, regs, (virtual_addr_t)reason); break; }; return rc;}没有 VGIC 时,arch_vcpu_irq_assert 对外部 IRQ 置位 HCR_EL2 的 VI 位,对 FIQ 置位 VF 位。Guest 下次运行时硬件看到 VI 为 1,便向 EL1 呈现一个 IRQ 异常,Guest 进入中断处理后读中断控制器的 IAR 寄存器。这个中断控制器是谁,取决于 Guest 配置:xvisor 在 emulators/pic/gic.c 里提供了一个完整的软件 GIC 模拟器,IAR 的读、EOIR 的写、分发器的全部配置都是 Stage 2 陷出后的软件模拟。软件模拟器内部自己维护 pending 与 active 状态,读到 IAR 时返回最高优先级的 pending 中断并迁移到 active,行为与真实 GIC 一致,代价是每步都陷出。
xvisor 的测试脚本目录里保留着 one_novgic_guest 系列用例,专门验证无 VGIC 配置下两个 Guest 共存的场景。保底路径与主线路径共用同一套通用层,这正是三层切分的收益:换注入手段不需要动 vmm_vcpu_irq 一行代码。
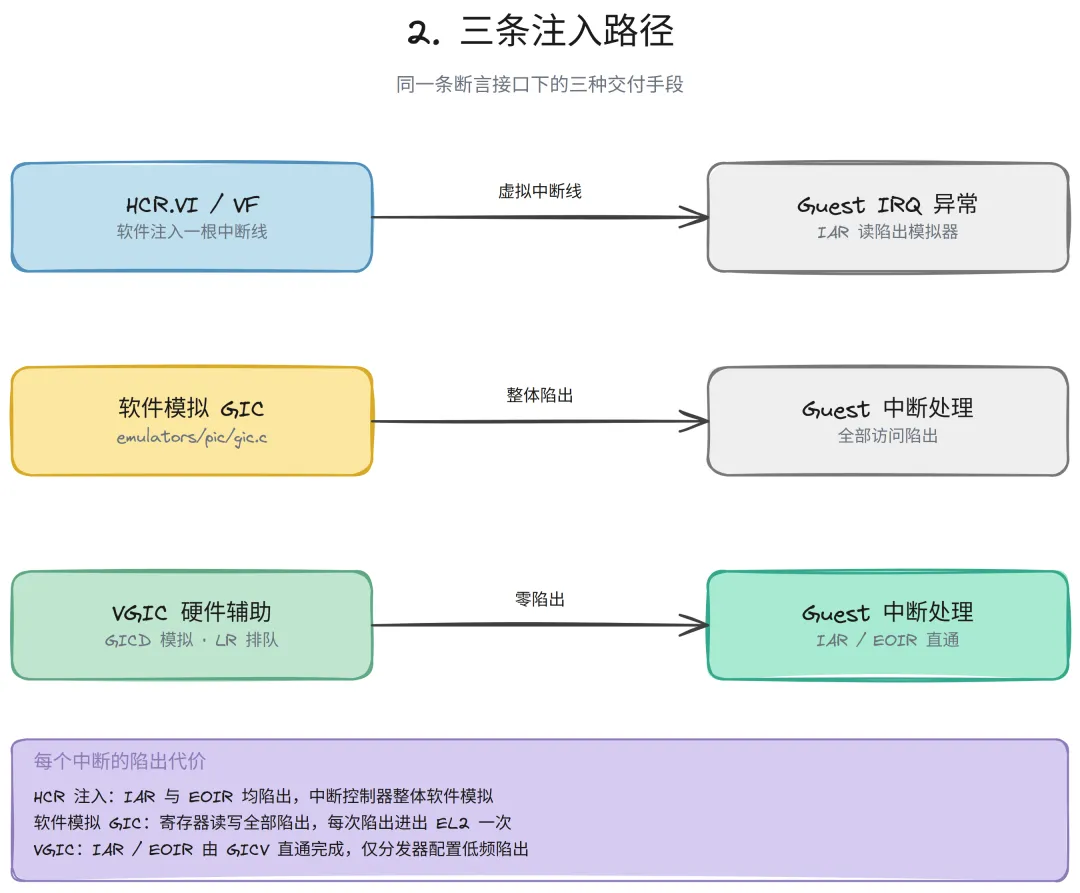
这张图把三条路径放在同一视野:HCR 注入只有一根虚拟中断线,Guest 读 IAR 时陷出到软件模拟器;软件模拟 GIC 在 xvisor 内完整模拟整个中断控制器,全部访问陷出;VGIC 把 IAR 与 EOIR 交给硬件直通,只有分发器配置陷出。三者对外的接口都是 vmm_vcpu_irq_assert,差别全在内部实现。
5. GIC 虚拟化扩展:GICD 模拟、GICV 直通与 GICH 排队
ARM GIC 的虚拟化扩展把中断控制器划成了三个区域。GICD 分发器保持软件模拟:使能、优先级、目标 CPU 这类配置低频且需要 xvisor 全局管控,陷出代价可以接受。GICC 的虚拟化版本 GICV 直通映射给 Guest:IAR 读与 EOIR 写这两个最高频的操作由硬件完成,零陷出。GICH 是只属于 Hypervisor 的控制区:xvisor 通过它维护一组列表寄存器 LR,GIC 硬件按 LR 的内容决定向 GICV 呈现哪些虚拟中断。vgic_v2_probe 从 Host 设备树把三个地址取出来:
int vgic_v2_probe(struct vgic_ops *ops, struct vgic_params *params){ node = vmm_devtree_find_matching(NULL, vgic_host_match); /* reg[2] 为 GICH 物理地址,Host 自行映射 */ rc = vmm_devtree_request_regmap(node, &vgicp.hctrl_va, 2, "GIC HCTRL"); /* reg[3] 为 GICV 物理地址,Guest 直通用 */ rc = vmm_devtree_regaddr(node, &vgicp.vcpu_pa, 3); /* 维护中断号,从设备树中断映射解析 */ vgicp.maint_irq = vmm_devtree_irq_parse_map(node, 0); /* LR 数量由硬件报告:GICH_VTR 的低 6 位 */ vgicp.lr_cnt = vmm_readl_relaxed( (void *)vgicp.hctrl_va + GICH_VTR); vgicp.lr_cnt = (vgicp.lr_cnt & GICH_VTR_LRCNT_MASK) + 1; ...}LR 数量不是编译期常量,而是上电时从 GICH_VTR 寄存器读出:GICv2 的虚拟化扩展最多 64 个,具体实现往往更少。xvisor 用宏 VGIC_V2_MAX_LRS 预留上限,运行时以 probe 得到的实际值为准。直通映射发生在 Guest 创建时,vgic_cpu_emulator_probe 检查到 Guest 设备树里 compatible 为 arm,vgic,cpu 的节点后,把该节点声明的 Guest 物理地址区间直接改写到真实的 GICV 地址上:
static int vgic_cpu_emulator_probe(struct vmm_guest *guest, struct vmm_emudev *edev, ...){ if (!vgich.avail) { return VMM_ENODEV; } if (!(edev->reg->flags & VMM_REGION_REAL)) { return VMM_ENODEV; } /* 把 Guest 视角的 GICC 区间直通到物理 GICV */ return vmm_guest_overwrite_real_device_mapping(guest, edev->reg, VMM_REGION_GPHYS_START(edev->reg), vgich.params.vcpu_pa);}Guest 里运行的系统看到的“GICC 基址”是自己设备树里写的地址,Stage 2 页表把这个地址指到物理 GICV,读写直达硬件。分发器节点 arm,vgic,dist 则走普通的模拟器注册流程,读写陷入 vgic_dist_emulator_read32 与 write32。一个 GIC 被拆成两个节点、两种映射方式,这是使用 GIC 虚拟扩展的标准配置手法。
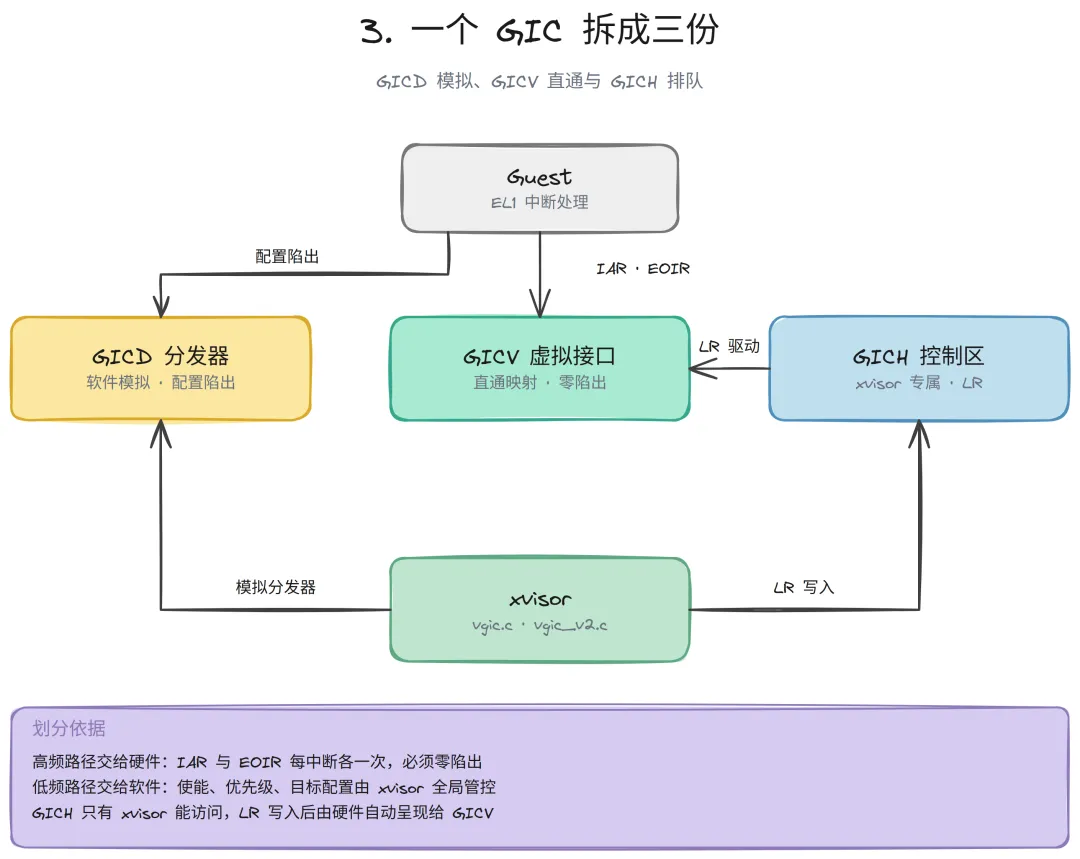
这张图的重点:GICD 由 xvisor 模拟,每次访问一次陷出;GICV 直通,Guest 独占访问零陷出;GICH 只有 xvisor 能碰,LR 写入后硬件自动把虚拟中断送到 GICV。
6. 注入模型:List Register 队列
vgic 的软件状态分两级。vgic_guest_state 是整个 Guest 一份的“分发器”:256 个中断的使能位图、pending 位图、优先级、目标 CPU 掩码,以及每个中断是否映射了 Host 物理中断号的 host_irq 字段。vgic_vcpu_state 是每个 vcpu 一份的“CPU 接口影子”:LR 使用位图、中断到 LR 的反向映射 irq_lr,以及上下文切换时保存的 HCR、VMCR、APR 与全部 LR 值。队列一个中断,就是把分发器里的 pending 状态翻译成一条 LR:
static bool __vgic_queue_irq(struct vgic_guest_state *s, struct vgic_vcpu_state *vs, u32 irq){struct vgic_lr lrv = { ... }; /* 已有同中断号的 LR,直接补 pending 位 */ lr = VGIC_GET_LR_MAP(vs, irq); if ((lr < vgich.params.lr_cnt) && VGIC_TEST_LR_USED(vs, lr)) { vgich.ops.get_lr(lr, &lrv, VGIC_MODEL_V2); if (lrv.virtid == irq) { lrv.flags |= VGIC_LR_STATE_PENDING; vgich.ops.set_lr(lr, &lrv, VGIC_MODEL_V2); return TRUE; } } /* 否则找空闲 LR */ for (lr = 0; lr < vgich.params.lr_cnt; lr++) { if (!VGIC_TEST_LR_USED(vs, lr)) break; } if (lr >= vgich.params.lr_cnt) { return FALSE; /* LR 耗尽 */ } lrv.virtid = irq; lrv.flags = VGIC_LR_STATE_PENDING; hirq = VGIC_GET_HOST_IRQ(s, irq); if (hirq != UINT_MAX) { lrv.flags |= VGIC_LR_HW; /* 直通中断 */ lrv.physid = hirq; } vgich.ops.set_lr(lr, &lrv, VGIC_MODEL_V2); return TRUE;}代码里有两处值得思考:中断号已经占用 LR 时不另找新 LR,而是在原 LR 上补 pending 位,电平触发的中断在 active 期间再次到来时只改一个状态位。其二,VGIC_LR_HW 分支:当该 Guest 中断号通过 map_host2guest 绑定了 Host 物理中断号时,LR 记下 physid 并置 HW 位,此后 Guest 对这个虚拟中断写 EOIR,硬件会连带把物理中断也 deactivate,Host 侧无需介入。这正是直通设备的中断路径:设备中断直接由 GIC 硬件路由进 Guest,xvisor 只在绑定阶段出现一次。
LR 耗尽时函数返回 FALSE,调用方 __vgic_flush_vcpu_hwstate 随即置位 GICH_HCR 的 UIE 位开启下溢中断:待 LR 有空位释放时硬件产生维护中断,xvisor 在中断里继续排队。这保证 pending 位图里积压的中断不会因为 LR 暂时占满而丢失。
软件生成中断 SGI 走的是分发器写入路径,也是 Guest 之间主动通信的唯一硬件手段。Guest 写 GICD_SGIR 触发 Stage 2 陷出,vgic_dist_write 解出目标掩码并登记来源:
static int vgic_dist_write(struct vgic_guest_state *s, int cpu, u32 offset, u32 src_mask, u32 src){ if (offset == 0xF00) { /* GICD_SGIR:软件生成中断 */ irq = src & 0x3FF; switch ((src >> 24) & 3) { case 0: /* 指定目标列表 */ sgi_mask = (src >> 16) & VGIC_ALL_CPU_MASK(s); break; case 1: /* 除自己外的全部 */ sgi_mask = VGIC_ALL_CPU_MASK(s) ^ (1 << cpu); break; case 2: /* 仅自己 */ sgi_mask = 1 << cpu; break; }; VGIC_SET_PENDING(s, irq, sgi_mask); /* 记录来源 vcpu,供目标读取 GICC_IAR 时报告 */ for (i = 0; (irq < 16) && (i < VGIC_NUM_CPU(s)); i++) { if (sgi_mask & (1 << i)) s->sgi_source[i][irq] |= (1 << cpu); } } ...}sgi_source 二维位图按目标 vcpu 与中断号记录来源,这是 GIC 规范的要求:Guest 读 IAR 时返回值里带有 SGI 的来源 CPU 编号,多核 Guest 的核间通知(如 reschedule IPI)依赖这个编号决定后续动作。登记完成后与设备中断汇入同一条 pending 到 LR 的排队路径,目标 vcpu 运行到下一次 flush 时一并送出。SGI 之外,分发器写入路径还处理使能、优先级、目标与触发方式配置,其中使能位的每次变化都会通过 vmm_devemu_notify_irq_enabled 通知下游模拟器,让电平敏感的设备在使能瞬间补一次 pending 判定。
7. 运行:一次虚拟定时器中断的完整链路
把各层串起来,最好的样本是虚拟定时器。Guest 设定了 CNTV_CVAL,vcpu 被切换出时 xvisor 读出剩余时间并挂了一个 Host 侧的定时器事件;事件到期,generic_virt_timer_handler 在 Host 中断上下文里执行:
static void generic_virt_irq_inject(struct vmm_vcpu *vcpu, struct generic_timer_context *cntx){ virq = cntx->virt_timer_irq; /* 向 Guest 的 PPI 断言 0 -> 1 电平变化 */ rc = vmm_devemu_emulate_percpu_irq2(vcpu->guest, virq, vcpu->subid, 0, 1);}static vmm_irq_return_t generic_virt_timer_handler(int irq, void *dev){ ctl = generic_timer_reg_read(GENERIC_TIMER_REG_VIRT_CTRL); if (!(ctl & GENERIC_TIMER_CTRL_IT_STAT)) return VMM_IRQ_NONE; /* 虚假中断 */ /* 屏蔽 Host 侧的定时器中断 */ ctl |= GENERIC_TIMER_CTRL_IT_MASK; generic_timer_reg_write(GENERIC_TIMER_REG_VIRT_CTRL, ctl); vcpu = vmm_scheduler_current_vcpu(); generic_virt_irq_inject(vcpu, cntx); return VMM_IRQ_HANDLED;}注意 current_vcpu 的判空逻辑:Host 中断可能落在任意物理 CPU 上,若该 CPU 当前没有运行普通 vcpu,或运行的不是持有这把定时器的 vcpu,中断被丢弃并打印诊断,因为定时器事件的 priv 已经保证回调发生在正确的 vcpu 上下文。emulate_percpu_irq2 走到设备模拟框架的分发,最终调用 vgic 注册的 handle2 回调,也就是 __vgic_irq_handle:
static void __vgic_irq_handle(struct vgic_guest_state *s, u32 irq, int cpu, bool two_levels, ...){ /* 电平变化:0 -> 1 置 pending */ if (level) { VGIC_SET_LEVEL(s, irq, cm); VGIC_SET_PENDING(s, irq, target); } else { VGIC_CLEAR_LEVEL(s, irq, cm); } irq_pending = __vgic_vcpu_irq_pending(s, vs); /* 目标 vcpu 正在本 CPU 运行,立即刷新 LR */ if (vmm_scheduler_current_vcpu() == vs->vcpu) { __vgic_sync_and_flush_vcpu(s, vs); } /* 断言 CPU_EXTERNAL_IRQ,走通用层 */ vgic_vcpu_irq_update(vs->vcpu, irq_pending);}链路的后半段全部是前面各节的机制:vgic_vcpu_irq_update 调用 vmm_vcpu_irq_assert 断言 CPU_EXTERNAL_IRQ,execute_pending 加一,沉睡的 vcpu 被 wfi_resume 唤醒进入 READY;调度器随后把它切换上 CPU,cpu_vcpu_helper.c 的切换代码调用 arm_vgic_restore,恢复 HCR、VMCR、APR 与 LR,并把 pending 位图中新到的事件继续填进剩余的空 LR;vcpu 开始运行,GICV 硬件看到 LR 的 pending 位,向 EL1 呈现虚拟 IRQ;Guest 进入中断处理,读 GICC_IAR,这一读直达 GICV 不陷出,LR 状态由硬件迁移为 active。
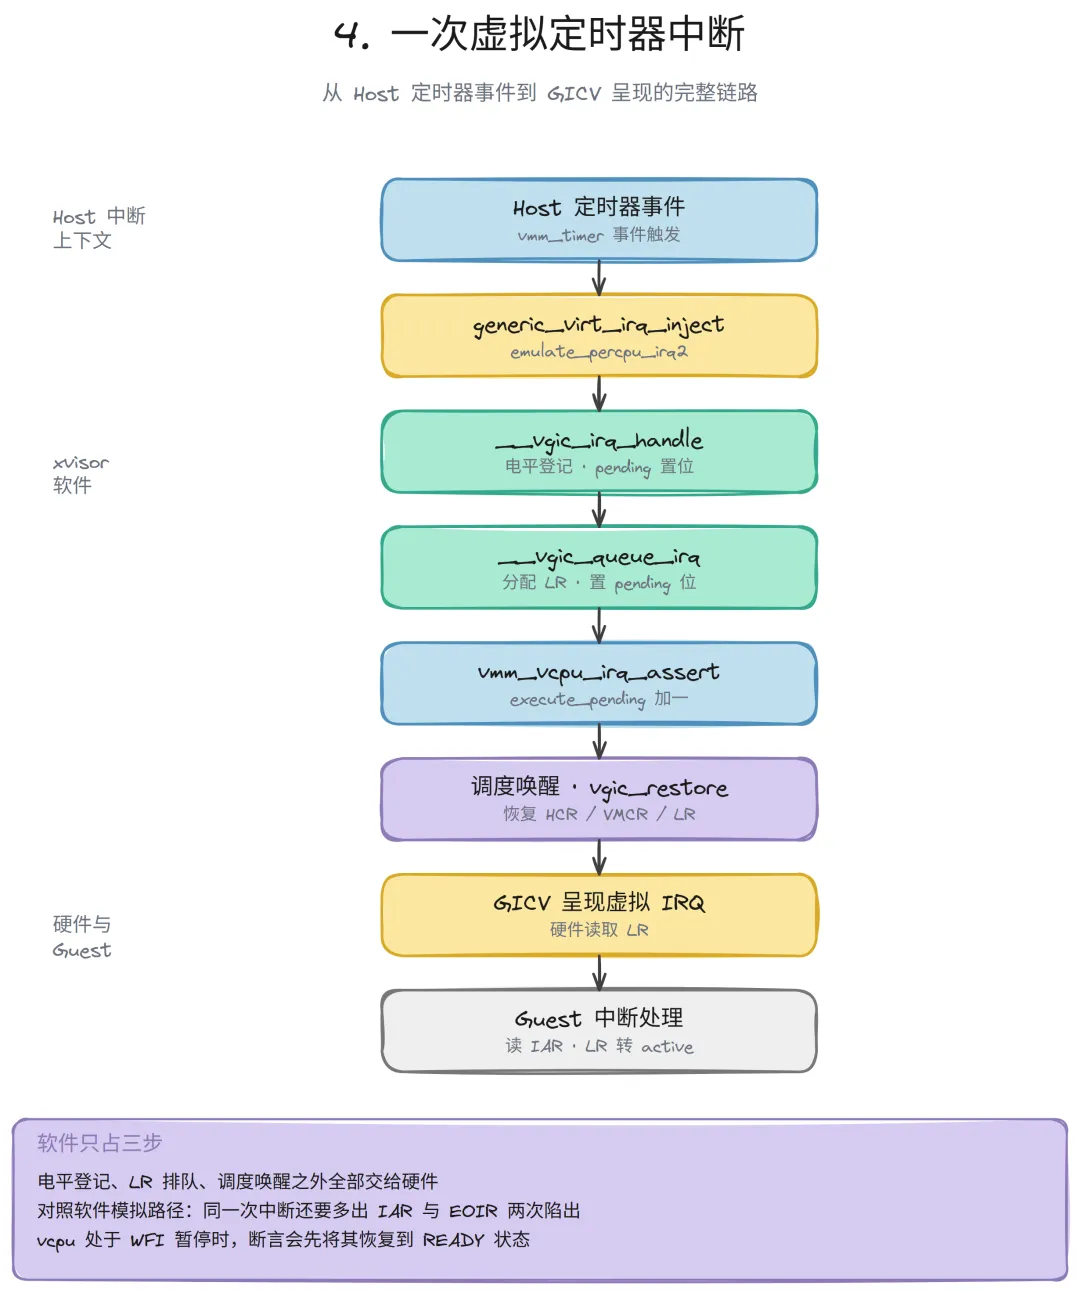
这张图把链路压成一条主干:Host 定时器事件到 GICV 呈现中断之间,软件的部分只有电平登记、LR 排队与调度唤醒三步,其余交给硬件。对照第 4 节的软件模拟路径,同一次中断要多出 IAR 与 EOIR 两次陷出,外加分发器内部状态的全部软件维护。
模拟设备走的是同一条链路的另一个入口。PL011 模拟器收到 Host 转发的串口输入后调用 vmm_devemu_emulate_irq 断言 RX 中断,电平登记与排队代码与定时器完全共用,差别只在中断号是 SPI 而非 PPI。对 vgic 而言,中断来自哪个模拟器、是软件生成还是硬件直通,全部被 host_irq 字段与 LR 的 HW 位屏蔽掉。
8. EOI 与维护中断:LR 的回收
Guest 处理完中断,写 GICC_EOIR。这一写直达 GICV,硬件把对应 LR 清空,并在 EISR 寄存器里记下哪个 LR 完成了 EOI,随后向 Host 产生一次维护中断。vgic 在初始化时把维护中断注册到了 Host 的中断框架上:
static vmm_irq_return_t vgic_maint_irq(int irq_no, void *dev){struct vmm_vcpu *vcpu = vmm_scheduler_current_vcpu(); /* 关闭下溢中断,避免重复触发 */ if (vgich.ops.check_underflow()) { vgich.ops.disable_underflow(); } /* 维护中断只在运行 vcpu 的 CPU 上有意义 */ BUG_ON(!vcpu); BUG_ON(!vcpu->is_normal); BUG_ON(!arm_vgic_avail(vcpu)); s = arm_vgic_priv(vcpu); vs = &s->vstate[vcpu->subid]; /* 回收空 LR,重新排队 pending */ __vgic_sync_and_flush_vcpu(s, vs); irq_pending = __vgic_vcpu_irq_pending(s, vs); vgic_vcpu_irq_update(vs->vcpu, irq_pending); return VMM_IRQ_HANDLED;}回收逻辑在 __vgic_sync_vcpu_hwstate 里:读 EISR 与 ELRSR,两者按位或后与软件的 LR 使用位图相交,得到“确实空出来”的 LR 集合;逐个读出 LR 里残留的 virtid,清掉硬件 LR,解除软件映射。这里有一处电平触发的细节:若中断是电平型且设备侧电平仍为高,回收后立即重新置 pending,等下一轮排队再送一次;若设备侧电平已经撤回,pending 一并清掉。边沿触发型则没有这一步,一次 EOI 即彻底结束。
维护中断与下溢中断共用一个中断号,进入时先查 GICH_MISR 的 U 位判断是否下溢。下溢意味着 LR 曾全部占满:回收完成后 flush 会继续把 pending 位图里积压的事件填进空出来的 LR,队列由此流动起来。从 Guest 的视角,这套机制的效果是中断处理永远不用等待 Host 调度:EOIR 写完的瞬间,下一个虚拟中断可能已经排进了刚空出的 LR。
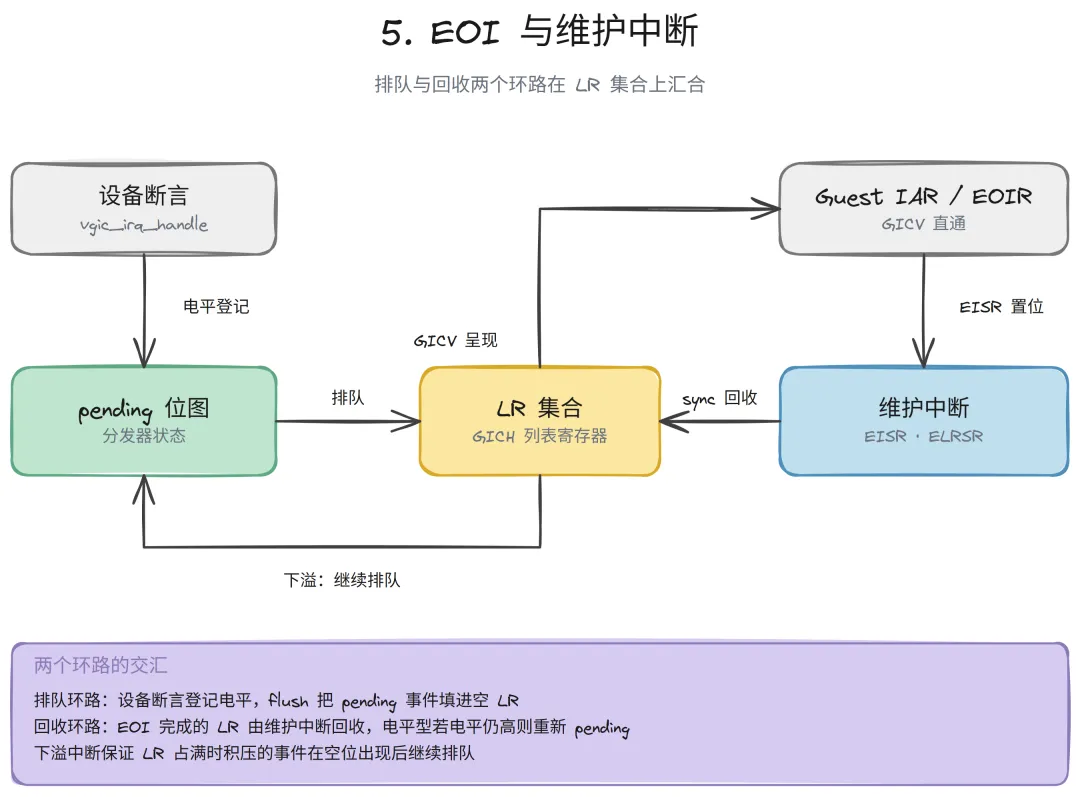
这张图的重点是两个环路的交汇:左边是中断送入的排队环路,右边是 EOI 驱动的回收环路,两者在 LR 集合上汇合。Guest 的 IAR 与 EOIR 两次访问都在直通区完成,Host 只在回收环路出现。
9. 上下文切换与 WFI
vcpu 切换时,vgic 的硬件上下文必须跟着走。cpu_vcpu_helper.c 在切换出旧 vcpu 时调用 arm_vgic_save,切入新 vcpu 时调用 arm_vgic_restore,两者都指向 vgic_state_alloc 注册的回调。保存与恢复不是对称的镜像:保存先做一次 sync,把 EOI 完成的 LR 回收到软件状态、刷新电平触发中断的 pending 位,再把 HCR、VMCR、APR 与全部 LR 读进 vgic_vcpu_state 的 hw 字段;恢复则反过来,先写回这些寄存器,再做一次 flush,把 vcpu 睡眠期间新到的 pending 事件填进 LR。方向差异的原因是 LR 属于物理 CPU 而非 vcpu,切出时硬件里可能残留着Guest 运行期间的变化,切入时硬件里则是上一个 vcpu 的残留。
WFI 的处理与中断虚拟化直接相关。Guest 执行 WFI 时 xvisor 不能让物理 CPU 停在这里,vmm_vcpu_irq_wait_timeout 的策略分三段:先查有无待执行断言,有则立即返回;没有则调用调度器的 yield 让出几次,代码里用 WFI_YIELD_THRESHOLD 计数,上限 100 次;仍无事件才把 vcpu 置为暂停状态并挂一个超时定时器事件。此后任何一次 vmm_vcpu_irq_assert 都会通过 wfi_resume 将 vcpu 恢复到 READY 状态。100 次 yield 的缓冲是为了过滤频繁的虚假 WFI:中断可能在 yield 之后立刻到达,此时 vcpu 仍在 READY 状态,不需要付出暂停再唤醒的代价。
超时定时器由 CONFIG_WFI_TIMEOUT_MSECS 配置,到期后强制唤醒 vcpu 一次。这是对 Guest 里过于乐观的 WFI 用法兜底:若硬件或模拟器遗漏了一次本应到达的中断,vcpu 至少会周期性地醒来重查状态,而不是永久沉睡。
10. 回到注入这条主线
中断虚拟化的机制围绕一个目标展开:让 Guest 以接近原生的代价使用中断。这个目标拆成三份:通用层把“断言一个事件给 vcpu”抽象成与体系结构无关的状态机;arch 层区分异常注入与外部中断两条子路径;vgic 层用 GIC 虚拟化扩展把高频的 IAR 与 EOIR 交给硬件,软件只维护分发器状态与 LR 队列。三层之间用固定接口与回调四件套解耦,没有 VGIC 的平台可以退回 HCR 注入与软件模拟,通用层代码一行不改。