ARTICLE · 1074562
新手必看:jquick-pdf基础语法详解(pdf/body全局模板结构)
新手必看:jquick-pdf基础语法详解(pdf/body全局模板结构)
引入
很多后端开发者第一次接触 PDF,会把“页面结构”理解成一组 Java 对象:先创建文档,再创建段落,再设置字体,最后计算位置。代码能够运行,却很难看出最终页面的层级;改一个标题间距,可能要在多个方法中寻找坐标和状态。jquick-pdf 把文档树直接写进模板,先掌握 <pdf><body>,就能建立从根节点到正文元素的清晰心智模型。
核心讲解
根元素与正文容器的分工
当前基线是 io.github.paohaijiao:jquick-pdfx:4.0.0、JDK 8+,JQuickPdfFactory 负责绑定和执行。模板根元素可以用 <pdf>,也可以用 <html>,二者都表示“这是一份文档”;<body> 则是正文容器,承载标题、段落、块和表格等可见内容。根元素声明文档身份与整篇布局的前提,<body> 声明正文从哪里开始;根元素通常只出现一次,正文内容全部写在 body 内部,写在 body 之外的内容不会被当作正文渲染。
解析与渲染链路
模板进入工厂后先被解析成节点结构,元素访问器再按照标签类型创建标题、段落、块或表格的渲染任务。布局引擎维护当前页、光标位置、边距和分页状态,渲染器消费样式模型完成绘制。正因为有这层结构,模板中的顺序就是文档中的阅读顺序,Java 代码可以只保留数据准备和输出逻辑。
基础语法范围
基础语法只依赖 jquick-pdfx。标题使用 <h1> 到 <h6>,文本常用 <p>、<span>、<br>、<tab>,容器使用 <div>,表格使用 <table>、<tr>、<th>、<td>。列表 <list>/<li>、图片 <image>、<svg> 和分页标签属于后续扩展,不必在第一个 Demo 中一次学完。
最小调用链
最小调用链是:创建工厂、绑定变量、选择模板来源、执行并接收字节。JQuickPdfFactory.create() 与 new JQuickPdfFactory() 都能创建无输出流工厂;bind(String,Object) 返回当前工厂,适合连续绑定;executeContent 返回字节数组,调用者决定保存、上传还是写入 HTTP 响应。资源模板可改用 executeResource,磁盘模板可改用 executeFile。如果需要调整页面,可通过 JPdfConfig 配置页面尺寸与页边距。
关键细节
标签嵌套规则
<div> 可以包含 <p>、<span>、<table> 等块级内容,是组织分区的主要元素;<p> 表示一个段落,<span> 用于段落内部的行内片段,<br> 与 <tab> 只做换行和制表,不承载内容;表格必须按 <table> → <tr> → <th>/<td> 的层级书写,表头用 <th>,数据用 <td>。标签必须成对闭合且不能交叉嵌套,缩进只服务于人类阅读,真正影响结果的是闭合关系、属性分隔和文本边界。
文本引号与变量替换
固定文本必须使用单引号,例如 '项目交付说明',因为解析器需要明确的边界来区分“要输出的字面量”和“模板语法”;未加引号的内容会被当成语法处理,轻则丢失、重则解析异常。变量使用 {...} 是否有对应 bind,每个 &{...} 是否真的注册过资源。固定中文放在单引号中、动态值单独放占位符中,便于后续替换与检索;不要用连续空格模拟列对齐,多列数据一律交给表格。
实战说明
先在 Maven 中引入核心依赖:
<dependency><!-- 核心模板解析与 PDF 渲染模块 --><groupId>io.github.paohaijiao</groupId><artifactId>jquick-pdfx</artifactId><version>4.0.0</version></dependency>
JDK 8+ 下运行一个 main 方法即可验证;模板较长时建议放进 src/main/resources,本篇先用字符串突出结构:
import com.github.paohaijiao.executor.JQuickPdfFactory;import java.nio.file.Files;import java.nio.file.Paths;public class BasicSyntaxDemo {public static void main(String[] args) throws Exception {String template = ""+ "<pdf>"+ "<body>"+ "<h1 style=\"fontSize:24;textAlignment:center\">'项目交付说明'</h1>"+ "<div style=\"backgroundColor:#eeeeee;padding:10px\">"+ "<p>'负责人:'{status}</p>"+ "</div>"+ "<h2>'交付清单'</h2>"+ "<table style=\"width:100%\">"+ "<tr><th>'项目'</th><th>'结果'</th></tr>"+ "<tr><td>'模板校验'</td><td>'已完成'</td></tr>"+ "<tr><td>'PDF 输出'</td><td>${status}</td></tr>"+ "</table>"+ "</body>"+ "</pdf>";// 绑定占位符并渲染模板byte[] pdf = JQuickPdfFactory.create().bind("user", "王五").bind("status", "已完成").executeContent(template);// 保存生成结果Files.write(Paths.get("syntax.pdf"), pdf);}}
效果: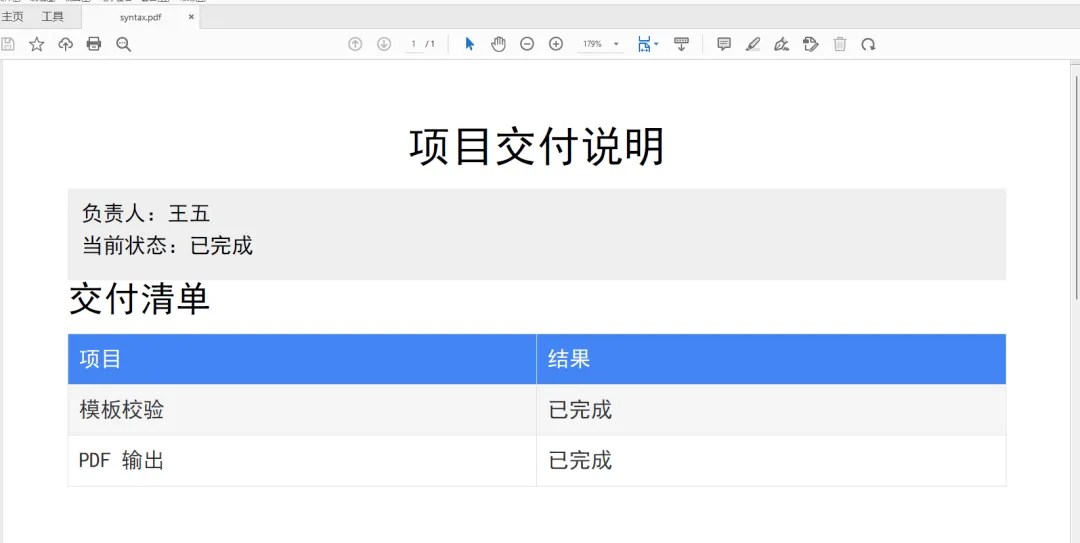
接入已有 Spring 服务时,可以把模板放到 src/main/resources/templates,业务方法读取数据库对象后先转换为简单的展示模型,再调用工厂。展示模型比直接把领域对象暴露给模板更稳:金额统一保留两位小数,日期统一时区,状态提前转换为中文。模板只消费已经准备好的字符串。
调试时不要一上来就放入完整报告,可按下述顺序逐步收敛:先保留一个标题、一个固定段落和一个变量,确认 PDF 能打开;再增加 <div>、表格和样式,逐块确认版式与间距;最后加入长文本、空值和分页,观察跨页与换行表现。遇到解析异常时用二分法定位问题区间:删掉模板后半段看是否仍然报错,重复几次就能锁定出错的标签或属性,每一步都保留可运行版本。
生产中最常见的问题是标签漏闭合、引号缺失、变量拼写不一致以及把 HTML 属性写到模板外。字符串模板中 Java 双引号需要转义,团队协作时更推荐资源文件。空值、超长名称和极端金额应在测试数据中覆盖。模板内容来自配置中心时,要限制可用模板集合并审计变更,避免把不受控内容当成代码执行。固定模板优先使用资源文件,数据绑定前完成格式化,批量生成时控制线程数并按文件大小和耗时设置监控;简单文档不必引入图表模块。基础结构稳定后,再按需加入 <list>、<image>、<svg> 或 <htmlPageBreak>,每扩展一种元素都先找到对应最小样例,验证解析和视觉结果后再接入业务数据。公告、回执、费用单、项目交付单、审批结果和内部报告都属于 <pdf><body> 的典型适用范围。
总结
<pdf>(或 <html>)解决“文档是谁”,<body> 解决“正文在哪里”,元素和样式解决“内容怎样呈现”。先把这棵树写正确,再谈复杂排版,学习和排错都会轻很多。需要避免的误区是把这套语法当浏览器 HTML 使用:它只覆盖库定义的类 HTML / CSS 子集,手写 iText 或 PdfBox 的团队在对象级控制上仍有优势,浏览器 HTML 的兼容面也更广,但需要额外运行时。若要继续深入,可关注样式优先级、资源模板、表格跨页、SVG 占位符和强制分页,并把模板解析测试与视觉回归分开。版本基线:jquick-pdfx 4.0.0、JDK 8+,升级前请核对 README_zh.md 的版本对照表;更多示例见 GitHub 仓库。