ARTICLE · 1077688
文档处理自动化——AI 批量处理网络配置、巡检报告
学习目标
今天你要掌握一个在运维和开发里最能"偷懒"、也最容易被低估的能力——文档处理自动化。具体来说:
理解为什么运维场景里"批量处理文档"是高频刚需:配置备份、巡检报告、Excel 台账、PDF 手册每天都在产生,手动整理既慢又容易出错。
掌握用 AI(正则脚本 + 大模型)把一个文件夹里的多份网络配置文件,批量抽取成结构化数据(JSON / CSV / Excel)。
学会用 AI 生成标准化的巡检周报、配置差异对比表、设备资产台账,并把结果导出成 Excel 给人看。
能写出一条"读文档 → 抽取字段 → 校验 → 生成报告"的自动化流水线,以后每周巡检只点一下。
今天结束时,你会有一个能跑的 Python 脚本:丢进去一堆交换机配置和巡检文本,吐出来一份带表头、带告警标红的 Excel 资产与周报清单。
核心内容
第一部分:概念理解(用AI解释)
先别急着写代码。打开 ChatGPT 或 Claude,把下面这段话发给它,感受 AI 怎么理解"文档自动化"这件事:
我是一名网络运维工程师,每天要处理几十份交换机/路由器的配置文件、每周要汇总全公司的设备巡检报告(Excel),还要把 PDF 手册里的参数整理成台账。这些工作又多又重复。请告诉我:1. "文档处理自动化"到底能帮我做什么?2. 把一份非结构化的配置文件,变成结构化数据,是什么意思?3. 我没有编程基础,能不能用 AI 完成这些事?4. 给我一个最朴素的工作流描述(不要代码)。
观察 AI 的回答,你会得到几个关键认知,我帮你提炼成要点:
第一,非结构化 vs 结构化。 你手里的switch01.conf写的是给人看的文本:"hostname SW-Core-01 / interface GigabitEthernet0/1 / description to-FW"。这叫非结构化或半结构化文本。而数据库、Excel 要的是"字段:值"——{"hostname": "SW-Core-01", "model": "C2960X", "ports": 48}。自动化干的事,本质就是把前者翻译成后者。
第二,批量是关键放大器。 处理一份配置不难,难的是处理 200 份;人处理 200 份要一天,脚本处理 200 份只要几秒。AI 的价值在"批量"上被放大——单份你找个网站也能做,但"一个命令处理一个目录"才是工程价值。
第三,抽取 + 生成两步法。 所有文档自动化都可以拆成两步:抽取(Extract)——从原始文档里抠出你关心的字段;生成(Generate)——把结构化数据套进模板,产出报告、台账、对比表。记住这个两步法,你就不会被花哨的工具迷住眼。
再让 AI 帮你厘清一个最容易混淆的点:
"用正则提取字段" 和 "让大模型直接读文档抽字段" 有什么区别?各自适合什么场景?给我一个对比表,并各举一个运维里的例子。
AI 会告诉你:正则适合格式极其固定的文本(比如同一型号设备、同模板导出的配置),写一条规则能跑一万次;大模型适合格式不固定、有自然语义的文档(比如不同厂家、不同人写的巡检报告),它能"理解"而非"匹配"。今天的实战,我们会两种都用到,并讲清什么时候用哪个。
一个额外认知:为什么 90% 的文档自动化项目半途而废? 让 AI 解释,答案通常是:① 一上来就想 100% 自动,遇到脏数据就崩;② 没给人留复核环节,错了没人发现;③ 格式假设太理想,真实文档千奇百怪。今天我们的设计原则就是——自动减重复,人工做复核,抽不到就留空+记日志。
第二部分:动手实验
实验1:让 AI 把一份配置抽成结构化 JSON
找一份你手头的真实设备配置(没有就用下面这段模拟的 Cisco 配置)。把它原样贴给 Cursor 或 Claude,输入:
下面是一份交换机配置,请帮我把关键信息抽取成 JSON,字段包括:hostname、model、management_ip、vlan_list(列表)、ios_version、port_count、interfaces(端口与描述列表)。只输出 JSON,不要解释。[把配置粘在这里]
模拟配置示例:
hostname SW-Core-01!model WS-C2960X-48TS-L!interface Vlan1ip address 10.10.1.1 255.255.255.0!interface GigabitEthernet0/1description to-Firewall!interface GigabitEthernet0/2description to-Core-02!spanning-tree mode rapid-pvst!version 15.2(7)E3
你会得到类似这样的 JSON:
json{"hostname": "SW-Core-01","model": "WS-C2960X-48TS-L","management_ip": "10.10.1.1","vlan_list": [1],"ios_version": "15.2(7)E3","port_count": 48,"interfaces": [{"port": "GigabitEthernet0/1", "desc": "to-Firewall"},{"port": "GigabitEthernet0/2", "desc": "to-Core-02"}]}
观察要点:AI 不只机械匹配,它"猜"出了 model 是型号、把接口描述归类成了列表。这就是大模型抽取比正则聪明的地方——它能理解语义、做合理归纳。
实验2:用脚本批量处理一个文件夹(正则版)
单份还不够,我们要批量。打开 Cursor,输入这个需求让 AI 生成脚本,或者直接用我下面这版可跑代码:
写一个 Python 脚本 batch_parse.py:1. 读取 ./configs/ 目录下所有 .conf 文件2. 对每个文件,用正则抽出 hostname、model、管理 IP、IOS 版本3. 汇总成一个列表,用 openpyxl 写成 Excel:configs_report.xlsx4. 如果某个文件抽不到某字段,单元格留空并记日志
pythonimport re, os, globfrom openpyxl import WorkbookCONFIG_DIR = "./configs"rows = []pattern_host = re.compile(r"^hostname\s+(\S+)", re.M)pattern_model = re.compile(r"^model\s+(\S+)", re.M)pattern_ip = re.compile(r"ip address\s+([\d.]+)")pattern_ios = re.compile(r"^version\s+([\d().]+E]+)", re.M)for path in glob.glob(os.path.join(CONFIG_DIR, "*.conf")):text = open(path, encoding="utf-8", errors="ignore").read()host = pattern_host.search(text)model = pattern_model.search(text)ip = pattern_ip.search(text)ios = pattern_ios.search(text)rows.append({"file": os.path.basename(path),"hostname": host.group(1) if host else "","model": model.group(1) if model else "","mgmt_ip": ip.group(1) if ip else "","ios": ios.group(1) if ios else "",})print(f"已解析 {path}")wb = Workbook()ws = wb.activews.append(["文件名", "hostname", "型号", "管理IP", "IOS版本"])for r in rows:ws.append([r["file"], r["hostname"], r["model"], r["mgmt_ip"], r["ios"]])wb.save("configs_report.xlsx")print(f"完成,共 {len(rows)} 台设备,已保存 configs_report.xlsx")
运行前先pip install openpyxl,建一个configs/文件夹放几份.conf。跑起来你会看到一份 Excel 资产清单——这就是文档自动化的第一个果实。
小技巧:不会写正则?让 AI 写。 你只要把一段配置贴给 AI:"帮我写一条 Python 正则,从这段文本里抽出管理 IP(ip address 后面第一个 IP)",AI 会给你要的代码。你不用背正则,只要会描述"我要哪个字段"。
实验3:用大模型做"智能抽取"(格式不固定时)
如果配置来自不同厂家(华为、H3C、Cisco),正则就不够用了——华为是sysname、Cisco 是hostname、H3C 又是另一套。这时用 Ollama 本地模型(Day 8 装过)批量抽:
pythonimport os, glob, jsonfrom ollama import chatPROMPT = """你是网络配置解析器。只输出 JSON,字段:hostname, vendor, model, mgmt_ip, ios_version。不要任何解释。配置如下:%s"""results = []for path in glob.glob("./configs/*.conf"):cfg = open(path, encoding="utf-8", errors="ignore").read()resp = chat(model="deepseek-r1:7b",messages=[{"role": "user", "content": PROMPT % cfg}])results.append(json.loads(resp["message"]["content"]))print(json.dumps(results, ensure_ascii=False, indent=2))
理解:这种方式"慢但稳",适合异构文档。正则快但脆,大模型慢但鲁棒——这就是今天要记住的核心权衡。
实验4:处理 PDF 巡检报告
巡检报告常是 PDF。用pdfplumber先把 PDF 抽成文本,再走上面的抽取逻辑:
pythonimport pdfplumberdef pdf_to_text(path):with pdfplumber.open(path) as pdf:return "\n".join(page.extract_text() or "" for page in pdf.pages)text = pdf_to_text("./inspection/sw01.pdf")print(text[:500]) # 看看抽出来的文本,再决定怎么抽字段
抽成文本后,无论是正则还是大模型,套路都和前面一致。PDF 的坑在于表格常被抽成一团,必要时用page.extract_tables()直接拿表格。
第三部分:深入原理
让 AI 用一段文字画出文档处理的端到端流水线:
请用文字描述"文档处理自动化"的端到端流程,每一步标注:输入、处理动作、输出、常见失败点。
你会得到类似这样的流水线:
原始文档(配置/PDF/Excel)↓ ① 加载与清洗(去噪、统一编码 UTF-8、拆页/分段)↓ ② 定位(找到含目标字段的段落,过滤无关内容)↓ ③ 抽取(正则 or 大模型 or 专用解析库)↓ ④ 结构化校验(字段类型、必填项、范围、格式)↓ ⑤ 合并与去重↓ ⑥ 生成报告(Excel / HTML / 对比表)↓ ⑦ 人工复核 & 归档
三种抽取方式深度对比(让 AI 帮你列,我整理成表):
| 方式 | 原理 | 速度 | 鲁棒性 | 适用场景 |
|---|---|---|---|---|
| 正则/模板 | 字符串模式匹配 | 极快 | 低(格式一变就废) | 同模板批量导出、固定格式日志 |
| 专用解析库 | 按协议/格式结构化解析(netmiko、ciso、pdfplumber) | 快 | 中 | 已知厂家/格式 |
| 大模型抽取 | 语义理解 + JSON 约束 | 慢 | 高 | 异构、半结构化、自然语言文档 |
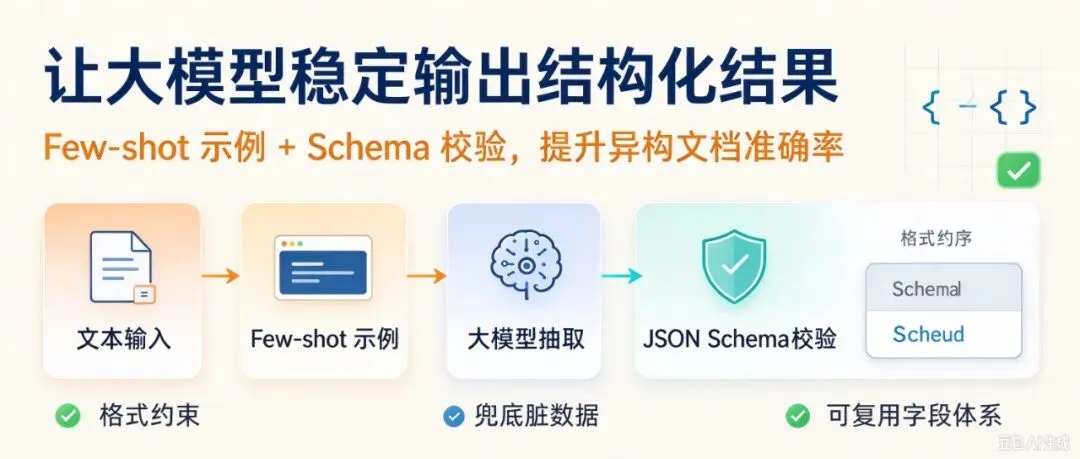
关键原理1:用 JSON Schema 约束大模型输出。 大模型容易"自由发挥",解决办法是明确告诉它输出格式,并做后校验:
pythonimport jsonschemaschema = {"type": "object","properties": {"hostname": {"type": "string"},"mgmt_ip": {"type": "string", "pattern": r"^\d{1,3}(\.\d{1,3}){3}$"}},"required": ["hostname"]}# 抽完用 jsonschema.validate 校验,失败就重试一次或标记人工复核
关键原理2:Few-shot 提升抽取准确率。 给大模型 1~2 个"输入→标准输出"的示例,它能大幅减少格式漂移。比如:"示例1:配置X → JSON Y;现在请按同样格式处理配置Z"。这在异构文档上尤其明显。
关键原理3:成本与速度权衡。 本地 7B 模型(Ollama)免费但慢(约 100 tokens/s),适合内部离线批处理;API(GPT-4o)贵但快且准,适合少量高质量需求。工程上常"先用本地模型跑全量,异常样本再丢 API 复核"。
失败点与兜底:真实文档里常有乱码、半截配置、字段缺失。工程上要"抽不到就留空 + 记日志 + 最后人工复核",而不是让脚本崩溃。一句话:自动化的目标是减少重复劳动,不是消灭人工——把人放在"复核"环节,比追求 100% 自动更现实、更可靠。
第四部分:实战应用
给你一个真实场景:你是某公司网络负责人,每周从 50 台设备收巡检报告(文本),要汇总成一份给老板看的 Excel,含:设备名、CPU 利用率、内存利用率、告警数、连通性。手动做要半天。我们用 AI 自动化:
实战A:巡检周报批量汇总
pythonimport glob, osfrom openpyxl import Workbookfrom openpyxl.styles import Font, PatternFillREPORT_DIR = "./inspection/"rows = []pat_dev = re.compile(r"设备[::]\s*(\S+)")pat_cpu = re.compile(r"CPU[利用率使用率]*[::]?\s*(\d+)%")pat_mem = re.compile(r"内存[利用率使用率]*[::]?\s*(\d+)%")pat_alarm = re.compile(r"告警[数条]*[::]?\s*(\d+)")pat_ping = re.compile(r"连通性[::]\s*(正常|异常|通|不通)")for path in glob.glob(os.path.join(REPORT_DIR, "*.txt")):t = open(path, encoding="utf-8", errors="ignore").read()dev = pat_dev.search(t)cpu = pat_cpu.search(t)mem = pat_mem.search(t)al = pat_alarm.search(t)pk = pat_ping.search(t)rows.append([dev.group(1) if dev else os.path.basename(path),cpu.group(1) + "%" if cpu else "N/A",mem.group(1) + "%" if mem else "N/A",al.group(1) if al else "0",pk.group(1) if pk else "未知",])wb = Workbook()ws = wb.activews.append(["设备名", "CPU利用率", "内存利用率", "告警数", "连通性"])for c in ws[1]:c.font = Font(bold=True, color="FFFFFF")c.fill = PatternFill("solid", fgColor="667EEA")for r in rows:ws.append(r)red = PatternFill("solid", fgColor="FFE0E0")for row in ws.iter_rows(min_row=2):v = str(row[3].value)if v.isdigit() and int(v) > 0:for c in row:c.fill = redwb.save("weekly_inspection.xlsx")print("周报已生成:weekly_inspection.xlsx,共", len(rows), "台")
实战B:配置差异对比表(变更审计)
网络设备改配置前后,老板常问"到底改了啥"。用difflib自动生成变更对比:
pythonimport difflibdef config_diff(old, new):a = open(old, encoding="utf-8", errors="ignore").readlines()b = open(new, encoding="utf-8", errors="ignore").readlines()return list(difflib.unified_diff(a, b,fromfile="变更前", tofile="变更后", lineterm=""))changes = config_diff("./backup/sw01_before.conf", "./backup/sw01_after.conf")with open("sw01_diff.txt", "w", encoding="utf-8") as f:f.writelines(changes)print("变更对比已生成,共", len([c for c in changes if c.startswith(('+','-')) and not c.startswith(('+++','---'))]), "处改动")
把 diff 结果再丢给大模型,它能写出一段人话:"本次变更新增了 3 个 VLAN、修改了管理 IP、关闭了未用的端口"——这就是"抽取 + 生成"在变更审计上的落地。
改造实验:让 AI 帮你把周报升级——加"环比上周"列(读上周的 xlsx 对比)、生成 HTML 版周报(结合 Day 9 的 RAG 思路做异常自动归因)。你只要对 AI 说:"在现有脚本上加一列'告警环比',从上次生成的 xlsx 读取旧值做差并标色",AI 就会补上。
进阶:大模型做异常归因。 抽出数据后,把"告警数 > 0 的设备"列表发给大模型:"这些设备本周有告警,结合它们的 CPU/内存,推测可能原因并给排查建议",AI 会生成一段能直接发出的分析文字——这比你手写强得多,也把今天的抽取成果和明天的问答机器人连了起来。
今日产出
一个能跑的
batch_parse.py:批量解析./configs/下的配置文件,输出 Excel 资产清单。一份用大模型(Ollama 本地)做的异构配置智能抽取脚本,验证了"正则快但脆、大模型慢但稳"的权衡。
一份
weekly_inspection.xlsx周报生成脚本:自动汇总巡检文本、表头美化、告警标红。一份
config_diff变更对比工具,能把两份配置的差异变成人话变更说明。对"抽取 vs 生成""正则 vs 大模型""自动减重复、人工做复核"三种核心权衡有了肌肉记忆。
关键学习
| 概念 | 理解 |
|---|---|
| 非结构化→结构化 | 文档自动化的本质,把人读的文本翻译成字段值 |
| 抽取 + 生成两步法 | 所有文档自动化都可拆成 Extract 和 Generate |
| 正则 vs 大模型 | 同模板用正则(快脆),异构文档用大模型(慢稳) |
| JSON Schema 校验 | 约束大模型输出格式、兜底脏数据 |
| Few-shot | 给示例显著提升异构文档抽取准确率 |
| 人工复核闭环 | 自动化减重复,不消灭人工;人放复核环节 |
感谢阅读!对您有帮助的话,点亮👍🏻❤️,关注公众号,转发给需要的朋友~ 原创转载请联系授权。