ARTICLE · 1077953
AI 回答越顺,我们为什么反而更需要一张核验清单?
AI 的流畅表达容易掩盖不确定性;核验应按错误代价分层,而不是一概相信或一概重做。
你问 AI 一个不熟悉的问题,它给出五点建议,结构清楚、措辞笃定,还顺手列出几条“研究表明”。这样的回答最容易让人继续下一步:发给同事、写进方案、照着执行。
真正危险的未必是明显胡说。明显错的内容会触发怀疑;一段把事实、解释和建议混在一起的顺畅回答,反而可能让核查显得多余。但这里先划一条线:目前没有证据可以证明“所有人一遇到流畅 AI 回答就会放弃验证”。我们能说的是,既有心理研究与人机协作研究提示了这种风险,具体是否发生取决于任务、个人经验、界面和错误代价。
01 顺,是阅读体验;真,是证据关系
心理学家 Reber 与 Schwarz 在 1999 年做过处理流畅性实验:改变陈述句的呈现清晰度,会影响参与者对句子真伪的判断。这个实验研究的是视觉呈现,不是今天的大模型,所以不能直接拿来宣称“AI 语言越顺,人一定越相信”。它提供一个更有限、也更有用的提醒:人对“容易处理”的感受,可能混入对“可信”的判断。
AI 正好可以把语句加工得非常容易处理:有结论,有层级,有过渡,甚至会补一段似乎很合理的原因。可是事实关系并没有因此变强。一句话如果没有原始出处,无论写得多自然,都还只是一个待核实主张;一个引用如果只支持相关背景,并不支持具体数字,也不能算作验证。
微软研究团队在 2025 年发表的调查访问了 319 名使用生成式 AI 的知识工作者,收集了 936 个工作使用实例。他们发现,对 AI 更有信心与较少自报的批判性思考相关;对自己完成任务更有信心,则与更多批判性思考相关。研究还指出,批判性思考并未简单消失,而是向信息核验、结果整合和任务管理转移。
这是一项自报调查,不是随机实验。它不能证明“使用 AI 导致思考能力下降”。但它给团队一个很实际的警报:如果大家把“我觉得模型很可靠”当成省略核查的理由,责任就会落在一个并没有被测量过的信心上。
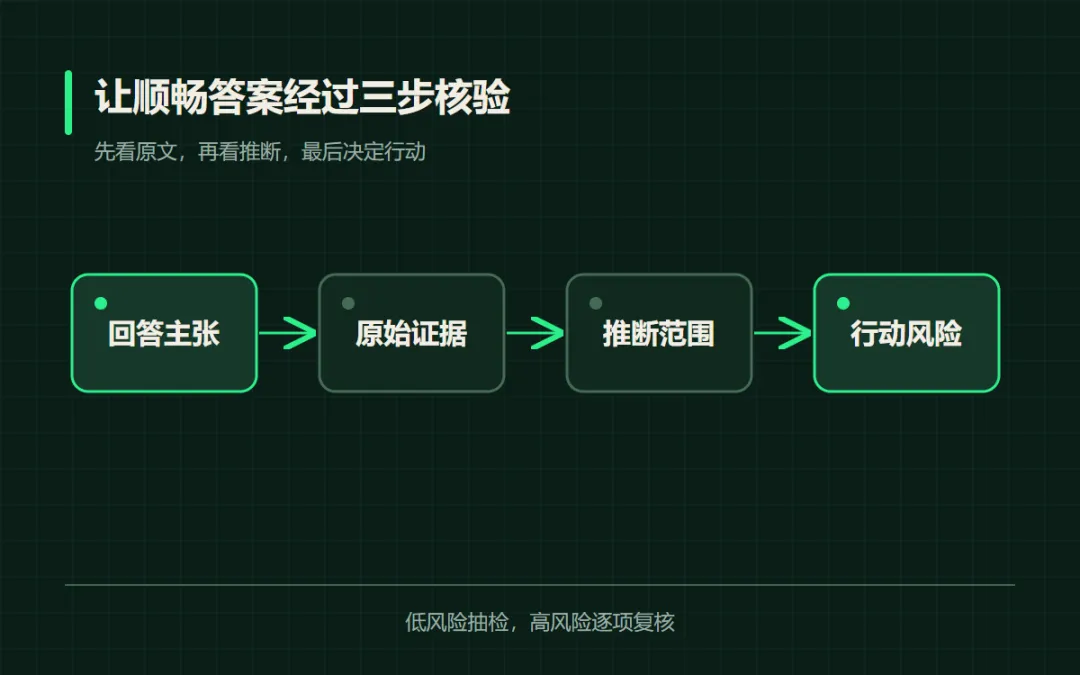 把事实与推断分开,才能决定一条 AI 回答值不值得采取行动。
02 “有解释”也不等于“已经核过”
人在现实工作中不是只看答案,还会看解释。问题是,解释本身也可能成为一种包装。2024 年一项关于自动化决策的实验发现,更多透明信息在某些条件下改善了使用准确性,但也可能增加对建议的同意倾向;单给系统置信度信息,并未产生同样的准确性改善。医疗影像场景中的另一个原始实验也观察到,某类局部解释会让医生更快跟随 AI 建议,不论该建议正确与否。
医疗实验不能直接外推到日常写报告,任务专业性和风险都不同。它说明的是:人类看见“解释”之后,并不自动完成了独立验证。AI 说出为什么,看起来更透明;如果解释的前提本身错了,它只是把错误讲得更连贯。
因此,把 AI 回答带进会议或文档时,可以强制分成三层:原文是什么;AI 或我从原文推断出什么;据此准备采取什么行动。第一层要有可打开的出处和准确的时间、对象;第二层要说明从事实跳到结论的条件;第三层要匹配错误代价与审批责任。三层若被写成一段漂亮的话,读者很难知道哪一句可以直接相信。
03 团队里,谁提交,谁说明核过什么
站在员工角度,AI 可以节省搜集和成稿时间,但也可能把核查工作悄悄推回给提交人。站在管理者角度,需要的是能追责的交付,不是“由 AI 生成”这个免责标签。站在客户或同事角度,看到的是一份组织交付,通常不会区分哪一句来自机器、哪一句来自人。
一个可执行的做法是:提交 AI 辅助材料时,附三行短说明——关键事实核了哪几个原始来源;哪些段落是判断或估计;最重要的未核点是什么。它不必变成冗长的合规表,但足以让审核者把精力放到真正薄弱的位置。
核查也要分级。给朋友想周末活动、给会议起几个标题,错误代价低,可以抽查或直接挑选。要给客户报价、引用政策条款、决定技术架构、提供健康或财务相关信息,则应逐项核对关键事实,并由有责任的人确认。高风险任务不能只因为 AI 的语气比人更确定,就获得更低的审查标准。
普通读者读一段 AI 答案,可以先抓“会改变行动”的一句:数字、日期、适用对象、限制条件。不要平均地检查每个字。若这句找不到原始支持,就把结论暂时放在“待确认”,不要让它自动进入下一步。
反过来也要防止另一种极端:所有 AI 输出都不信、所有低风险内容都重新查一遍,会让工具失去意义。经验丰富的人、可靠的组织数据、可运行的测试和清楚的来源链,都能降低核查成本。重点是让信任与证据、任务风险相匹配,而不是按回答是否悦耳分配信任。
AI 把句子说顺了,仍需要人把事实、推断和行动的连接讲清楚。
你上一次把 AI 回答用于工作时,最先核对的是哪一句?