ARTICLE · 1115828
MySQL 8.0.46 故障场景与源码
📌 本文导航
MySQL8.0.46 源码核心优化与特性 故障一 · 高并发频繁死锁 故障二 · 连接数虚高 Too many connections 故障三 · 大事务卡顿 / IO 飙升 故障四 · 索引失效慢查 故障五 · 主从复制延迟 故障六 · 临时表/文件排序 CPU 飙升 MySQL8.0.46 专属调优与版本红线
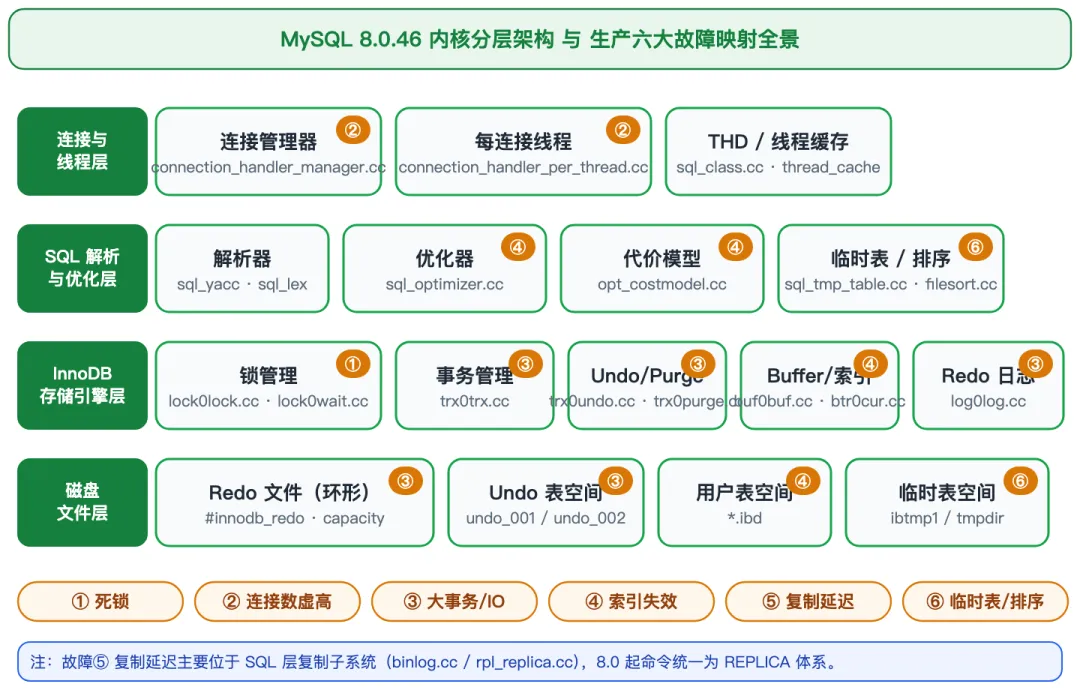
图1 · MySQL 8.0.46 内核四层架构与六大生产故障映射全景
整体分四层(自底向上):连接层 → SQL 层 → InnoDB 层 → 磁盘层。 每个故障都标注了归属的内核模块(图中绿框),与下文章节一一对应。 排查思路:先定位「哪一层、哪个模块」,再对应源码文件与故障章节,避免出错。
18.0.46 版本源码核心优化与特性(故障底层铺垫)
在 MySQL 8.0 系列迭代中,8.0.46 是此系列的最后一个版本。
1. 事务与锁模块源码优化
行锁等待队列调度逻辑被优化,缓解了旧版本高并发下锁队列拥堵、无效自旋等待的问题;同时修复了只读事务误触发锁占用等 BUG,显著降低高并发查询场景的锁竞争概率。注意:InnoDB 始终没有锁升级/降级,行锁的基础抢占逻辑并未改变。
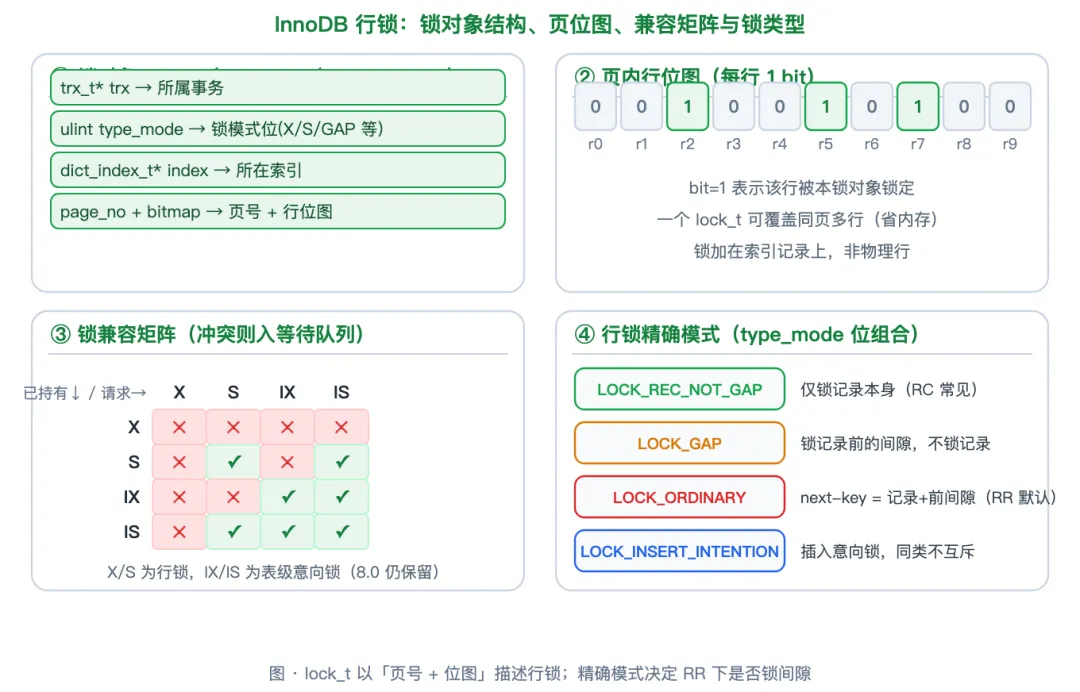
图2 · InnoDB 行锁:lock_t 页位图结构、锁兼容矩阵与四种精确模式
- lock_t
记录「谁(trx_id)持有了哪个索引、哪一页、行位图上的哪一把锁」。 右侧 4×4 锁兼容矩阵:同一行上 X 与 S 互斥,IX / IS 仅与表级意向锁兼容。 下方四种精确模式(REC_NOT_GAP / GAP / ORDINARY / INSERT_INTENTION)决定锁覆盖的是记录、间隙、二者还是插入意图。 这是死锁与间隙锁冲突的判定依据。
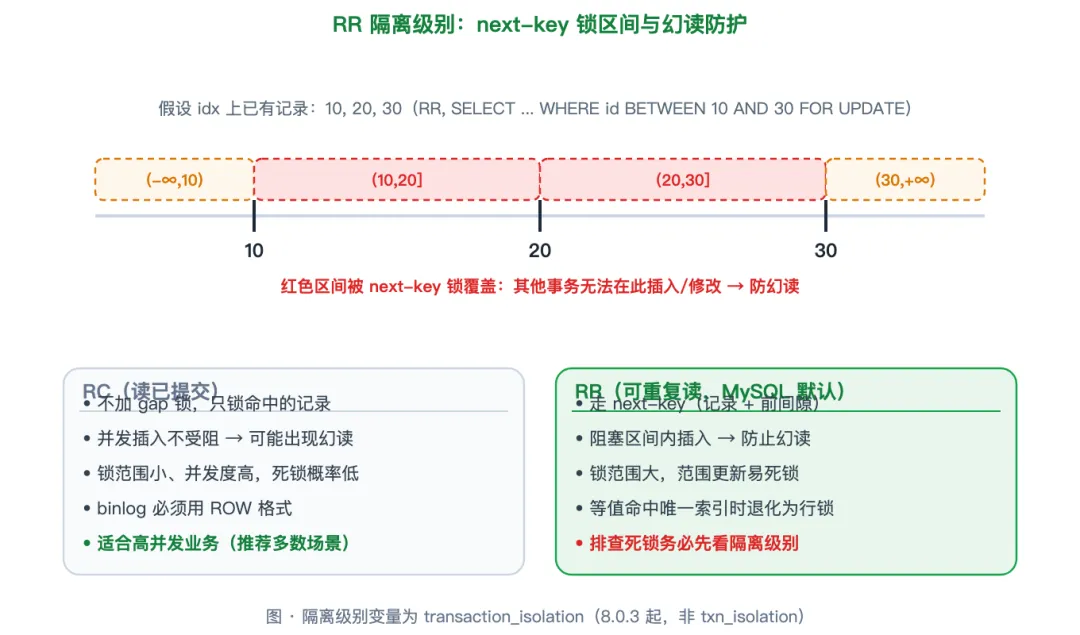
图3 · RR 下 next-key 锁区间防幻读,与 RC 的锁范围对比
- RR
隔离级别下加的是 next-key 锁(记录 + 前间隙),图中红色区间禁止插入——这是「范围 UPDATE / DELETE 踩死锁、并发插入被堵」的根源。 - RC
下退化成只锁记录本身,间隙不锁。 线上多数读多写少业务可用 RC 规避大量间隙冲突。遇到唯一索引也会有间隙锁。 RC ,遇到唯一键冲突时,也会有S Next-Key Lock 此为gap锁, 会阻塞插入意向锁 insert intention lock。
RC,Insert 更新遇到唯一索引时,会产生S gap ,gap锁为范围锁,扩大了锁定范围,会增加死锁概率。
RC,唯一键如果插入相同数据,语句会被阻塞,语句锁超退出之后,会获得[前数据,插入数据]和[插入数据,后数据]2个范围的S Gap,阻塞Gap之间的插入操作。
为了唯一键插入的原子性(防止其他事务插入相同数据),unique check 的时候会给所有的相同的record 和下一个record 加上next-key lock. 导致后续insert record 虽然没有冲突, 但是还是会被Block 住, 进而有可能造成死锁的问题.[对于insert操作来说,若发生唯一约束冲突,则需要对冲突的唯一索引加next-key共享读锁。而且还需要对该唯一索引的下一条记录也加next-key共享读锁。]
插入意向锁的属性:不会阻塞其他任何锁,只会被
gap lock阻塞。对于唯一键不要插入相同数据,因为会放大锁的范围。
锁名称解释:
Record lock/lock_mode X locks rec but not gap 都是行锁
lock mode S/lock mode X 都是gap锁
Next-Key Lock (Record lock+gap lock)行锁+gap锁
2. Redo / Undo 日志机制升级
针对生产高频的日志写入卡顿、崩溃恢复异常,优化了 redo 日志刷盘策略以平衡性能与数据安全;同时优化 undo 日志回收(purge)机制,缓解大事务后 undo 链表残留、磁盘占用过高的顽疾。8.0.30+ 起 redo 容量由 innodb_redo_log_capacity 统一管理(详见第三节)。
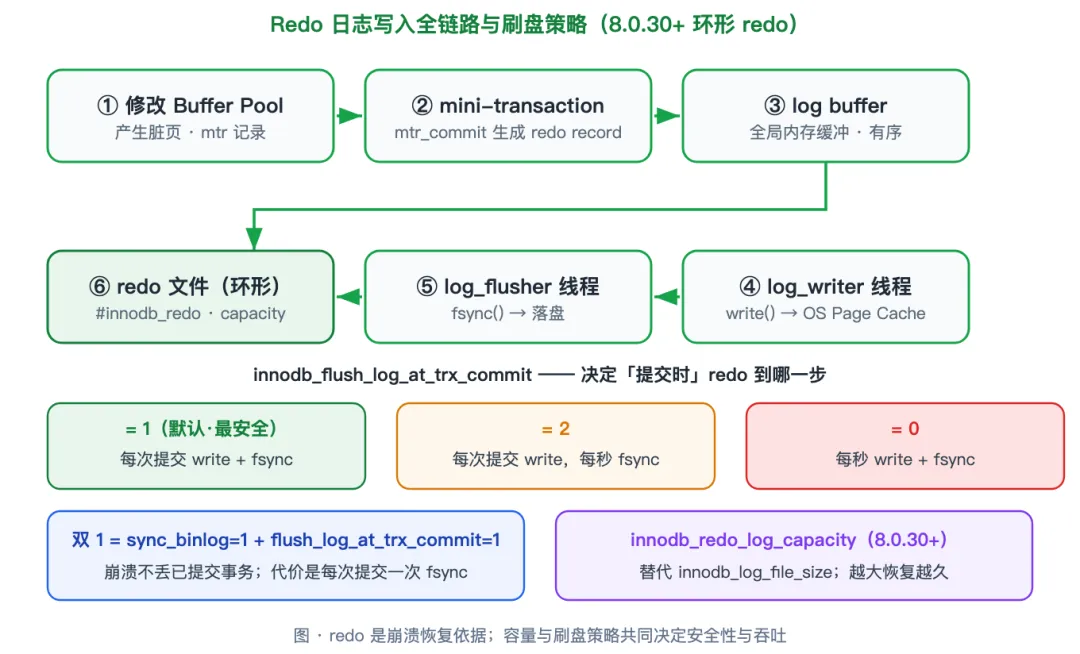
图4 · Redo 写入全链路(mtr → log buffer → writer → flusher)与刷盘策略
事务改动先写入 log buffer(内存缓冲区),此时尚未落盘。 - log_writer
线程把 log buffer 刷到环形 redo 日志文件。 事务提交时,log_flusher 按 innodb_flush_log_at_trx_commit 决定落盘时机。 - =1
每次提交都 fsync 到磁盘(最安全、最慢);=2 只写 OS 缓存;=0 每秒刷一次。 - 双 1 配置
(redo=1 + sync_binlog=1)保证崩溃不丢数据,但写吞吐下降,需配合足够大的 redo 容量。
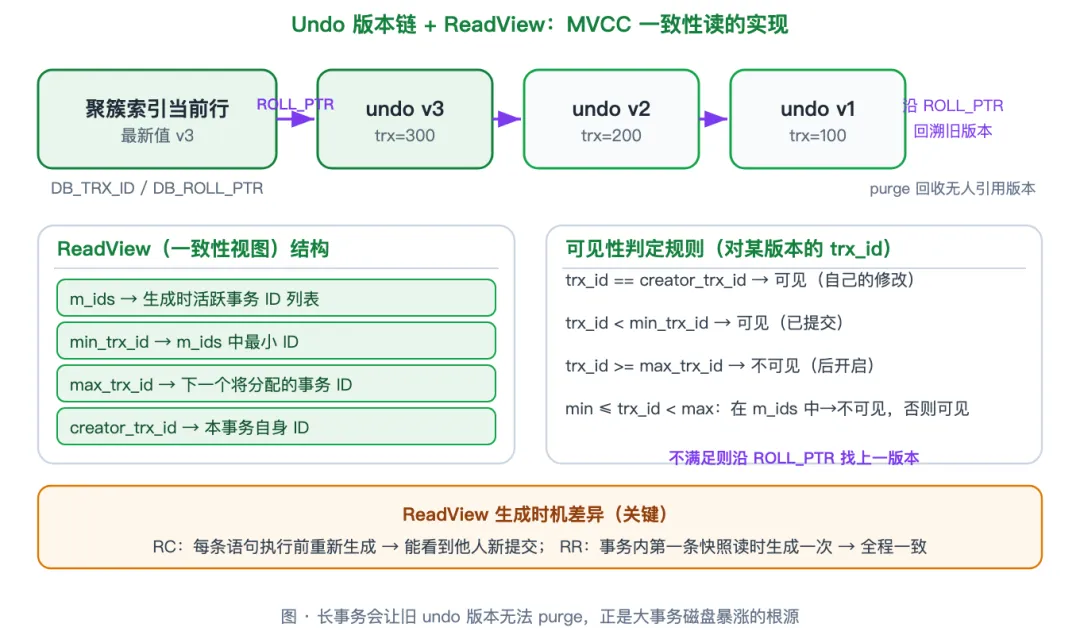
图5 · Undo 版本链 + ReadView 结构与 MVCC 可见性判定规则
每行改动在 undo 里挂一条版本记录,靠 ROLL_PTR 串成版本链。 - ReadView
携带创建者、活跃事务上限等字段,决定当前事务能看到哪条版本。 - RR
在事务开始时建一次视图(可重复读),RC每条语句重建(读已提交)。 - 未提交事务
的 undo 不能被 purge 回收,是大事务 IO 飙升的根源(见故障三)。
3. 连接与线程处理优化
优化了客户端连接超时判定与异常连接回收逻辑,缓解了长连接僵死不释放、连接数虚高的异常。但「半开连接」(客户端异常断开而服务端未感知)仍依赖 wait_timeout 到点被动回收,需要配合参数与连接池治理(见故障二)。
4. 索引与查询执行器优化
优化了联合索引代价计算逻辑,修正了部分场景下优化器选错索引、导致 SQL 慢查的问题;同时提升子查询、关联查询执行效率,减少低效临时表、文件排序的触发概率。但优化器「基于代价选计划」的本质未变,统计信息过期仍会误判(见故障四)。
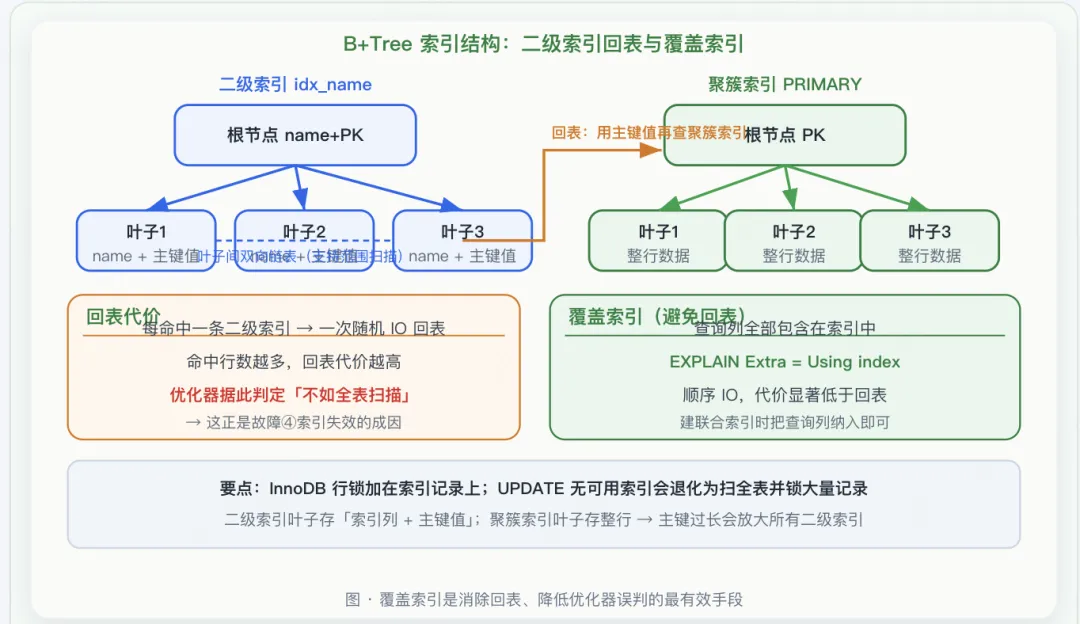

图6 · B+Tree 二级索引回表代价与覆盖索引
- 二级索引
叶子只存「索引列 + 主键值」,查询非索引列要回表到聚簇索引(图中虚线为随机 IO)。 当优化器估算回表代价大于全表扫描时,就会放弃索引(故障四根源)。 - 覆盖索引
(索引含所有查询列)能消除回表,是最直接的优化手段。
5. 复制与数据一致性
8.0 已全面重构复制术语与并行回放框架。binlog 事务写入与从库回放(applier)的协同,决定了主从延迟与一致性,是故障五的底层来源。
2生产高频故障:源码溯源 + 实战排查 + 解决方案
以下 TOP6 故障均来自真实生产场景,每个都按「现象复现 → 8.0.46 源码根源 → 实战排查步骤 → 落地根治方案」闭环展开。
故障1:高并发下频繁死锁(Deadlock found)
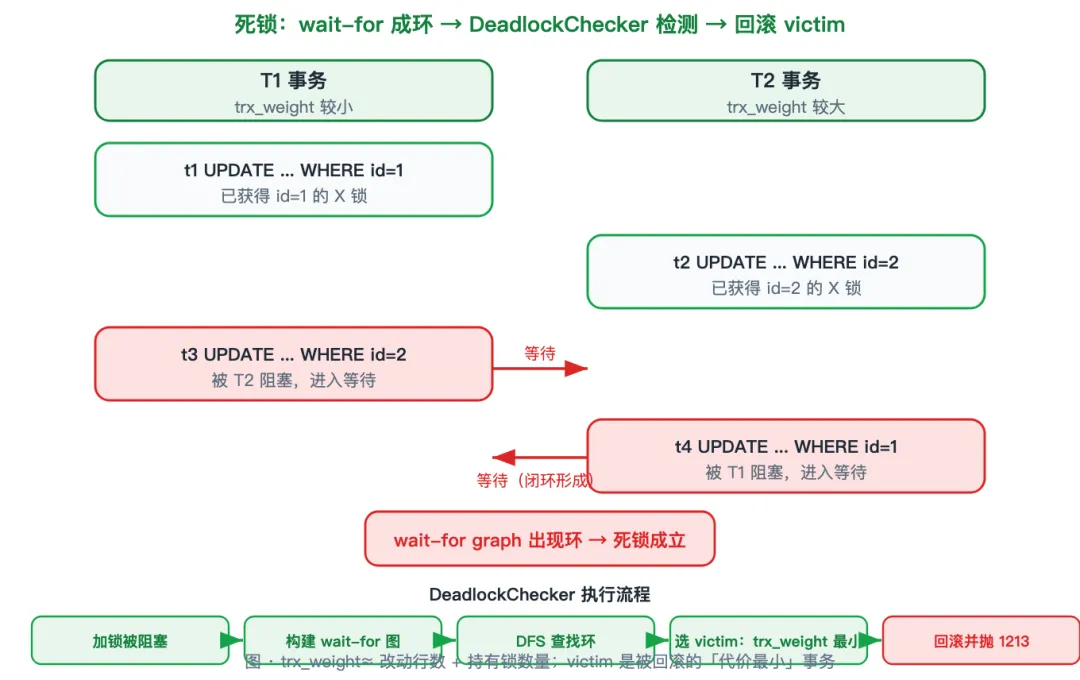
图7 · 死锁:wait-for 成环 → DeadlockChecker 选 victim 回滚并抛 1213
两条事务各自持有一行,并请求对方持有的行,锁等待箭头首尾相接成环。 - DeadlockChecker
沿图做 DFS 找到环后,选举 trx_weight(改动行数 + undo 量)最小的事务回滚,并抛出 1213。 - 权重大
的事务被保留——所以「越晚提交、改动越多越安全」是误区,恰恰是改动少的被牺牲。
- 1
开启全局死锁日志,确保每次死锁都落入错误日志(对性能几乎无影响) - 2
通过 SHOW ENGINE INNODB STATUS 定位冲突的两条 SQL、锁资源、事务执行顺序 - 3
用 performance_schema 实时抓取当前锁等待,确认是否为行锁顺序交叉 / 间隙锁冲突 - 4
结合业务代码核对多行、多表更新的执行顺序
-- 1) 开启全局死锁日志 SET GLOBAL innodb_print_all_deadlocks = ON; -- 2) 查看最近一次死锁(关注 LATEST DETECTED DEADLOCK) SHOW ENGINE INNODB STATUS\G -- 3) 实时锁等待(MySQL 8.0 推荐 performance_schema) SELECT * FROM performance_schema.data_lock_waits\G SELECT * FROM performance_schema.data_locks\G -- 4) 定位未提交/长事务 SELECT trx_id, trx_state, trx_started, trx_weight, trx_query FROM information_schema.innodb_trx ORDER BY trx_started ASC\G统一更新顺序:所有涉及多表/多行更新的事务,固定主键 ID 升序、固定表操作顺序,从根源打破锁循环依赖 缩短事务:避免单次事务批量更新大量数据,控制锁持有时间 规避间隙锁:用等值条件更新,减少范围 UPDATE/DELETE 触发的 gap/next-key 锁竞争 应用层加重试:捕获 1213 错误后指数退避重试,死锁本就可被安全重试
-- 1) 在线调大合理等待阈值(仅减少正常长事务被误杀,不解决死锁) SET GLOBAL innodb_lock_wait_timeout = 60; -- 2) 开启全量死锁日志(定位冲突 SQL 顺序,性能影响可忽略) SET PERSIST innodb_print_all_deadlocks = ON; -- 3) 应用层伪代码:捕获 1213 后指数退避重试 -- try { execute(tx); } catch (DeadlockException e) { -- if (retryCount < 3) sleep((1<<retryCount)*50ms); retry(); -- } -- 4) 业务约定:所有「订单+库存」写操作统一为 先订单(id ASC) → 后库存(id ASC)故障2:数据库连接数虚高,频繁 Too many connections
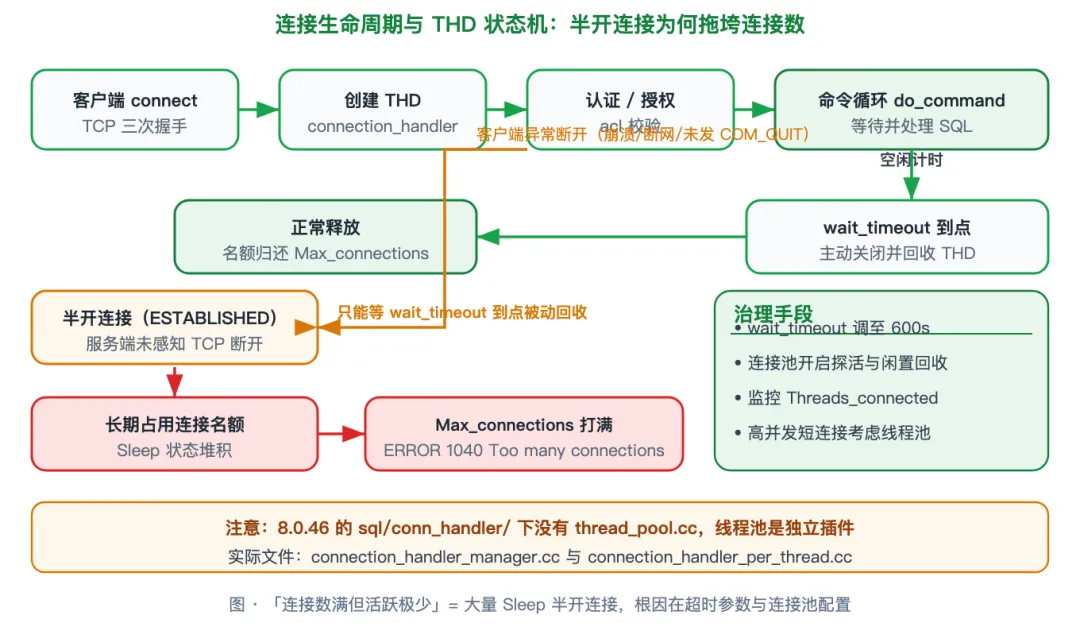
图8 · 连接生命周期与 THD 状态机:半开连接如何拖垮连接数
客户端异常断开(网络闪断、进程崩溃未发 COM_QUIT)后,服务端 THD 仍挂在 processlist 的 Sleep 状态。 这种半开连接只有等 wait_timeout 到点才会被回收。 默认 28800s(8 小时)意味着一条僵死连接要占满名额近半天——这就是「连接数满、活跃却极少」的真相。
- 1
执行 SHOW PROCESSLIST 统计 Sleep 连接数量、来源 IP - 2
查看 wait_timeout / interactive_timeout,默认值过长(8 小时) - 3
核对业务连接池配置,确认是否开启探活与闲置回收 - 4
紧急回收超长 Sleep 连接前,先确认来源 IP 避免误杀
-- 1) 连接状态分布 SHOW PROCESSLIST; SELECT COMMAND, COUNT(*) FROM information_schema.processlist GROUP BY COMMAND; -- 2) 超时参数(默认 28800s = 8h,过长) SHOW VARIABLES LIKE 'wait_timeout'; SHOW VARIABLES LIKE 'interactive_timeout'; -- 3) 连接水位 SHOW STATUS LIKE 'Threads_connected'; SHOW STATUS LIKE 'Max_used_connections'; -- 4) 紧急回收超长 Sleep(确认来源后再 KILL) SELECT CONCAT('KILL ', id, ';') AS kill_sql FROM information_schema.processlist WHERE COMMAND='Sleep' AND TIME > 1800;调小超时:全局设置并写入 my.cnf(见第三节命令),快速回收闲置僵死连接 连接池治理:开启探活(testOnBorrow/testWhileIdle)、配置 maxIdle/minIdle 与闲置销毁,避免「建而不放」 max_connections 按业务峰值 + 冗余设置,配合 thread_handling;高并发短连接可考虑线程池插件 监控 Threads_connected / Threads_running 并设置告警,连接打满前预警
-- 1) 缩短闲置超时,快速回收半开/僵死连接(在线 + 写入 my.cnf) SET PERSIST wait_timeout = 600; SET PERSIST interactive_timeout = 600; -- 2) 提高连接水位冗余(按峰值*1.3 估算,写入 my.cnf) -- max_connections = 800 -- 3) 业务连接池(以 HikariCP 为例,application.yml / properties)-- maximumPoolSize: 50 -- minimumIdle: 5 -- idleTimeout: 300000 # 5min 无活动回收 -- maxLifetime: 1800000 # 30min 强制换新,避免服务端已超时 -- connectionTestQuery: SELECT 1 -- keepaliveTime: 120000 # 探活故障3:大事务导致数据库卡顿、磁盘 IO 飙升
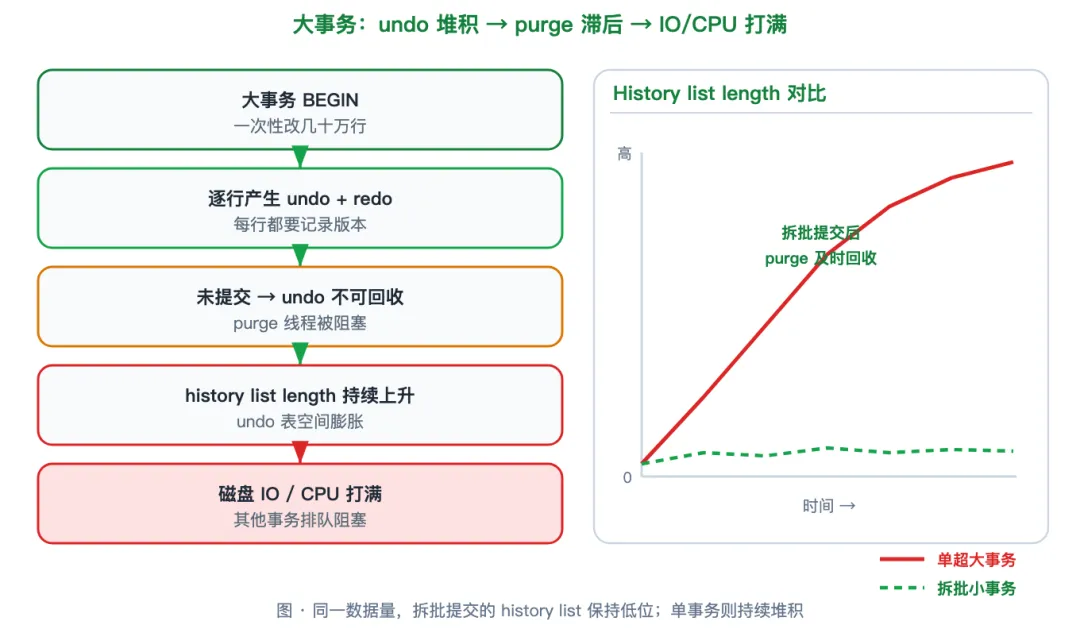
图9 · 大事务 undo 堆积与 purge 滞后:单事务 vs 拆批提交对比
单条超大事务(红色曲线)在提交前持续堆积 undo,history list length 陡升且 purge 线程追不上,undo 占用与 IO 同步打满。 拆成小批(绿色曲线)后,每批提交即释放 undo,曲线保持平稳。 两条线对比即「大事务 vs 拆批」的核心差异。
- 1
通过 information_schema.innodb_trx 定位执行超时的大事务 - 2
观察 undo history list 是否持续增长(purge 跟不上) - 3
查看锁等待实时视图,确认是否被大事务阻塞 - 4
监控磁盘 IO 与 redo 写入速率,确认瓶颈点
-- 1) 定位执行中的长事务(按开始时间排序) SELECT trx_id, trx_state, trx_started, trx_weight, trx_rows_modified, trx_query FROM information_schema.innodb_trx ORDER BY trx_started ASC\G -- 2) 观察 undo 堆积(关注 History list length) SHOW ENGINE INNODB STATUS\G -- 3) 锁等待实时视图 SELECT * FROM performance_schema.data_lock_waits\G SELECT waiting_trx_id, blocking_trx_id, wait_age FROM sys.innodb_lock_waits\G大事务拆分:批量操作按主键切片,单批 ≤ 1000~5000 行,每批提交 低峰执行:大批量数据操作迁移至业务低峰期 提升 purge:调大 innodb_purge_threads、设置 innodb_max_purge_lag 阈值限流,监控 history list length 大表删除优先用分区裁剪 / gh-ost、pt-osc 在线改表,避免单事务锁全表
-- 1) 提升 purge 并发与限流(写入 my.cnf) -- innodb_purge_threads = 8 -- innodb_purge_batch_size = 1000 -- innodb_max_purge_lag = 100000 # 超过则限流写入,防止 history list 失控 -- 2) 在线开启自动统计更新,避免大批量后统计失真 SET GLOBAL innodb_stats_auto_recalc = ON; -- 3) 大批量操作的推荐分批模板(应用层循环执行) -- WHILE 有数据: -- UPDATE ... WHERE id BETWEEN ? AND ? LIMIT 2000; -- 按主键切片 -- COMMIT; -- 每批独立提交,立即释放 undo 与锁 -- SLEEP(0.2); -- 错峰,给 purge 喘息故障4:索引正常但 SQL 慢查,优化器索引失效

图10 · 优化器代价模型:为何「有索引却走全表扫描」
优化器分别估算全表扫描代价与索引扫描代价(含回表随机 IO),取较小者。 左栏误判诱因(统计过期、数据倾斜、回表过多)会抬高或压低某一边,导致放弃索引。 右栏排查链路:EXPLAIN 看 key / type → optimizer_trace 看代价比较,逐层定位为何放弃索引。
- 1
执行 EXPLAIN 确认 key 为 NULL、type 为 ALL - 2
查看表统计信息,判断数据分布是否倾斜、Cardinality 是否过低 - 3
打开 optimizer_trace 看代价比较过程 - 4
刷新统计信息后复测,对比执行计划变化
-- 1) 执行计划(关注 key / type) EXPLAIN SELECT ... ; -- 2) 索引基数(Cardinality 偏低=选择性差) SHOW INDEX FROM `table_name`; -- 3) 优化器追踪代价比较 SET optimizer_trace='enabled=on'; SELECT ... ; SELECT * FROM information_schema.optimizer_trace\G SET optimizer_trace='enabled=off'; -- 4) 刷新统计信息后复测 ANALYZE TABLE `table_name`;刷新统计:ANALYZE TABLE 或开启 innodb_stats_auto_recalc,更新精准数据分布 索引重构:低选择性列后置到联合索引末尾,用覆盖索引减少回表;避免对选择性差字段建单列索引 临时救急:核心慢查用 FORCE INDEX(idx),但长期要重构索引结构 参数:eq_range_index_dive_limit(默认 200)影响 IN() 代价估算;统计采样 innodb_stats_persistent_sample_pages 适当调大
-- 1) 刷新统计信息(运维手动触发,或开启自动) ANALYZE TABLE order_item; SET GLOBAL innodb_stats_auto_recalc = ON; -- 2) 加大持久化统计采样页,让 Cardinality 更准(写入 my.cnf) -- innodb_stats_persistent_sample_pages = 200 -- 3) 临时止血:核心慢查强制走正确索引(长期仍需重构索引) -- SELECT ... FROM order_item FORCE INDEX(idx_cover) WHERE ... -- 4) 调整 IN() 代价估算精度(默认 200,超过改 equality dive 估算) -- eq_range_index_dive_limit = 200 -- 5) 推荐重建为覆盖索引,消除回表随机 IO -- ALTER TABLE order_item ADD INDEX idx_cover (status, create_time, order_id, amount);故障5:主从复制延迟(Seconds_Behind_Source 持续增大)
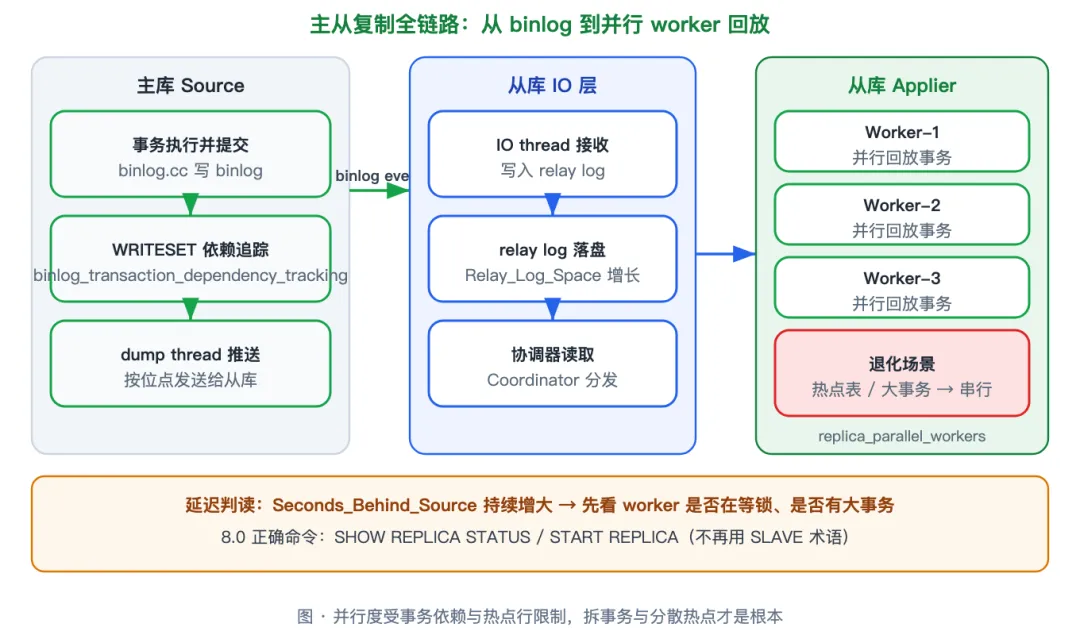
图11 · 主从复制全链路:binlog → relay log → coordinator → 并行 worker
三栏泳道中,主库 Source 写 binlog 并打 WRITESET 依赖标记;从库 IO 线程拉取后,Applier 按依赖关系派发给多个 worker 并行回放。 - 退化
发生在单张大事务(无并行空间)、热点表(所有事务改同一行必须串行)等场景。 若从库长查询持锁阻塞 worker,并行度塌缩,延迟持续增大。
- 1
用 SHOW REPLICA STATUS 查看延迟与回放线程状态(不要用 5.7 的 SHOW SLAVE STATUS) - 2
观察主库 binlog 生成速率与从库回放位点差距 - 3
检查是否存在大事务 / 长事务 / 热点表 - 4
查看从库 worker 是否处于等待锁状态
-- 1) 8.0 复制状态(REPLICA 体系,非 SLAVE) SHOW REPLICA STATUS\G -- 关注:Seconds_Behind_Source、Replica_SQL_Running_State、 -- Relay_Log_Space、Last_SQL_Error -- 2) 主库 binlog 位点 SHOW BINARY LOG STATUS; SHOW MASTER STATUS; -- 兼容写法 -- 3) 从库 worker 回放状态 SELECT * FROM performance_schema.replication_applier_status_by_worker\G开启 WRITESET 并行复制(见第三节命令),提升从库回放并发度 拆大事务、减少单事务改大量行,降低回放串行化 从库设为只读(super_read_only=ON),避免从库长查询阻塞 applier 监控 Seconds_Behind_Source 告警,定位热点表并做读写分离/分库分表
-- 1) 主库:开启 WRITESET 依赖追踪(写入 my.cnf,需重启生效) -- binlog_transaction_dependency_tracking = WRITESET -- transaction_write_set_extraction = XXHASH64 -- 2) 从库:LOGICAL_CLOCK 并行 + worker 数(在线设置) STOP REPLICA SQL_THREAD; SET GLOBAL replica_parallel_type = LOGICAL_CLOCK; SET GLOBAL replica_parallel_workers = 8; START REPLICA SQL_THREAD; -- 3) 从库只读,避免长查询阻塞 applier(写入 my.cnf) -- super_read_only = ON -- 4) 监控延迟告警 -- 关注 Seconds_Behind_Source,>30s 即告警故障6:临时表 / 文件排序导致 CPU 飙升
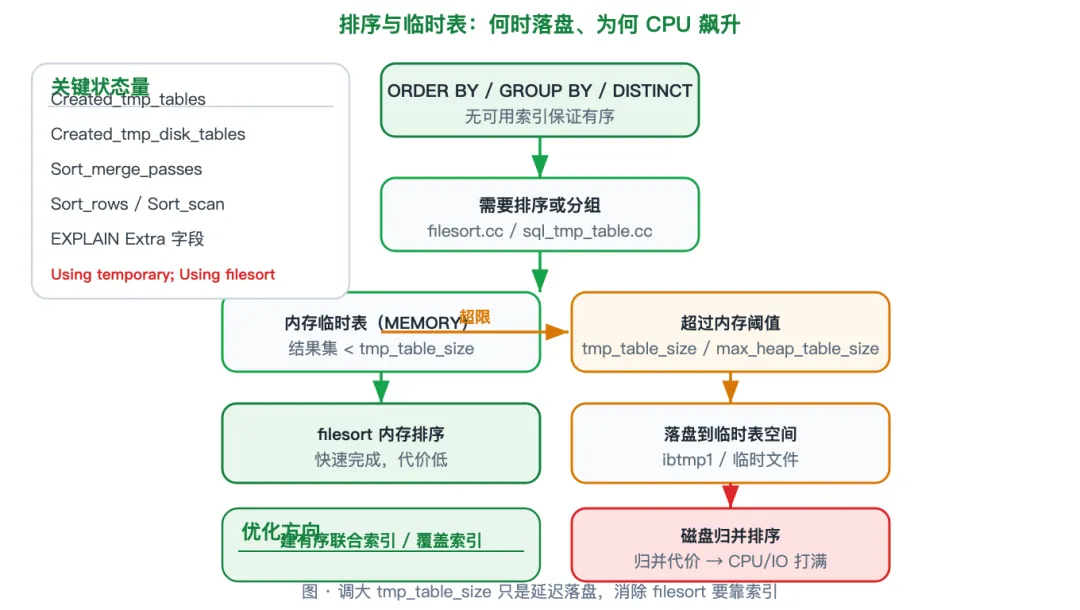
图12 · 排序与临时表:内存阈值、落盘流程与 filesort 归并代价
无索引的 ORDER BY / GROUP BY / DISTINCT 需要 filesort,中间结果先放内存临时表。 超过 tmp_table_size 与 max_heap_table_size两者较小值则落盘(转 InnoDB 临时表空间)。 - 双重排序
(二次回表取排序列)触发磁盘归并,Sort_merge_passes 升高,CPU / IO 同时打满。 给排序列建索引即可让执行器直接按序读取,跳过排序。
- 1
EXPLAIN 看 Extra 是否出现 Using temporary; Using filesort - 2
查看全局临时表落盘次数(Created_tmp_disk_tables) - 3
用 digest 视图找出最耗排序/临时表的 SQL - 4
检查 innodb 临时表空间磁盘占用
-- 1) 执行计划(关注 Extra) EXPLAIN SELECT ... ; -- 2) 临时表落盘次数 SHOW STATUS LIKE 'Created_tmp_disk_tables'; SHOW STATUS LIKE 'Created_tmp_tables'; SHOW STATUS LIKE 'Sort_merge_passes'; -- 3) 用 digest 找出最耗临时表/排序的 SQL SELECT DIGEST_TEXT, COUNT_STAR, SUM_CREATED_TMP_DISK_TABLES, SUM_SORT_MERGE_PASSES FROM performance_schema.events_statements_summary_by_digest ORDER BY SUM_CREATED_TMP_DISK_TABLES DESC LIMIT 10;加索引消除 filesort/temporary:为 ORDER BY / GROUP BY / DISTINCT 建联合索引,利用索引有序性 调大内存临时表上限(仅缓解):tmp_table_size、max_heap_table_size(如 64M→256M),但超过仍落盘 避免 SELECT * 大字段排序:只取需要的列,减小排序行宽 优化 LIMIT + ORDER BY:先查主键再 JOIN 回表(延迟关联),降低排序数据量
-- 1) 调大内存临时表上限(两者取小值生效,写入 my.cnf) -- tmp_table_size = 256M -- max_heap_table_size = 256M -- 2) 内部临时表优先用内存引擎(8.0 默认 TempTable,必要时调大其内存池) -- internal_tmp_mem_storage_engine = TempTable -- temptable_max_ram = 1G -- 3) 推荐:为 ORDER BY / GROUP BY 建联合索引,消除 filesort -- ALTER TABLE ticket ADD INDEX idx_owner_upd (owner, update_time); -- 4) 延迟关联:先取主键再回表,缩小排序行宽 -- SELECT t.* FROM ticket t JOIN ( SELECT id FROM ticket WHERE owner=123 ORDER BY update_time DESC LIMIT 20 ) x USING(id);38.0.46 版本专属优化建议
基于本版本源码优化特性,结合生产实战,整理以下专属调优方案,适配 8.0.46 内核,规避版本固有短板。
① 锁机制调优
依托新版本锁队列优化,可对「合理等待」场景适当调大 innodb_lock_wait_timeout(默认 50s,可到 50~120s),减少正常长事务被误杀。 ⚠️ 误区:调大该参数不能解决死锁——死锁由 DeadlockChecker 检测到即回滚,不受此参数影响;死锁只能靠统一更新顺序 + 应用重试根治。
② 日志调优(Redo)
8.0.30+ 用 innodb_redo_log_capacity(默认 100MB,替代旧 innodb_log_file_size / innodb_log_files_in_group)。8.0.46 应配置该参数(如 1~2GB),平衡写入性能与崩溃恢复时间(redo 越大,崩溃恢复重放越久)。 - innodb_flush_log_at_trx_commit
:1=每次提交刷盘(最安全);2=写 OS 缓存;0=每秒。双 1(sync_binlog=1 + 该参数=1)最强一致。 - sync_binlog=1
(8.0 默认)保证 binlog 不丢。
③ 连接与线程调优
缩短 wait_timeout / interactive_timeout(如 600s),加速回收闲置连接。 - thread_handling
:高并发短连接默认 one-thread-per-connection 即可;连接极多且短可考虑线程池插件(thread_pool_size)。 - max_connections
留冗余,配合 Threads_running 监控避免打满。
④ 查询与统计信息调优
定期 ANALYZE TABLE 或开启 innodb_stats_auto_recalc,适配优化器代价模型。 开启慢查询(slow_query_log=ON, long_query_time=1),结合 events_statements_summary_by_digest 定位问题 SQL。 按需调整 eq_range_index_dive_limit、optimizer_switch(如关闭不合适的 index_merge)。
+附:生产可直接落地的配置片段
-- 1) 连接超时(写入 my.cnf [mysqld] 段永久生效) SET GLOBAL wait_timeout = 600; SET GLOBAL interactive_timeout = 600; -- 2) 开启 WRITESET 并行复制(8.0.26+ 为 replica_* 前缀) SET GLOBAL binlog_transaction_dependency_tracking = WRITESET; SET GLOBAL replica_parallel_type = LOGICAL_CLOCK; SET GLOBAL replica_parallel_workers = 8; -- 3) 提升 purge 效率(my.cnf 写入) -- innodb_purge_threads = 8 -- innodb_max_purge_lag = 100000 -- 4) 8.0.30+ redo 容量(my.cnf 写入,替代 innodb_log_file_size) -- innodb_redo_log_capacity = 2G -- 5) 双 1 最强一致(8.0 默认即为 1) -- innodb_flush_log_at_trx_commit = 1 -- sync_binlog = 1🔗 精选推荐
简历生成器
MySQL 内存去哪了 [3步曲]
3.Ptmalloc vs Jemalloc 的内存和性能测试
AI的世界
3.开始AI聊天
5.Ragflow 0.24.0 + 本地 Ollama 部署