ARTICLE · 1116469
AI4MBDSE|雷达日报2026-10-02 | Agent 验收:从任务成功率到三层可核对证据
实测龙虾ppt弱于Codex弱于gpt网页版…
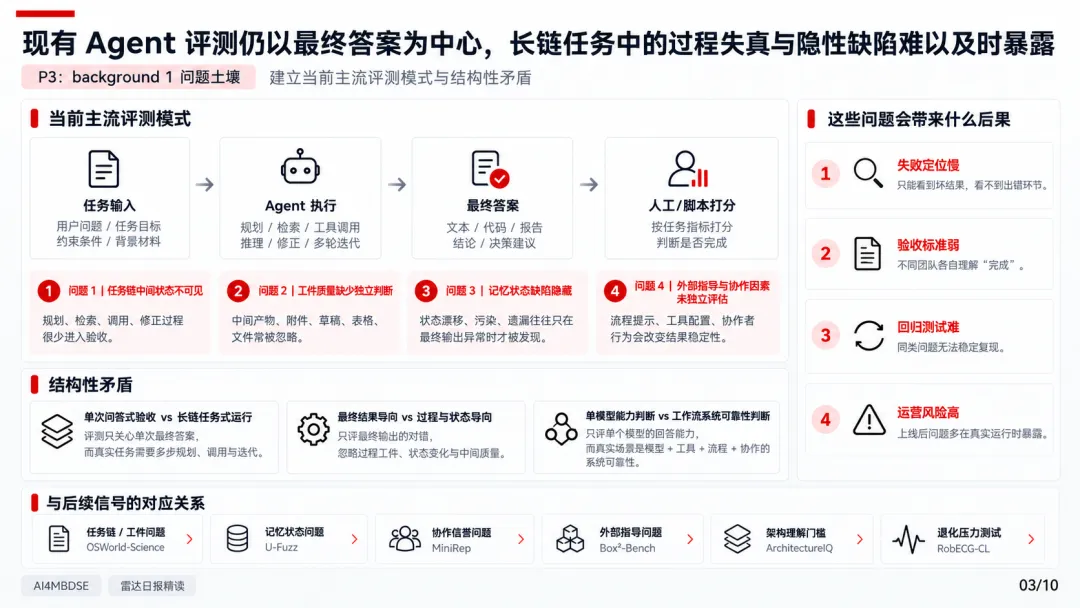
设想一次 Agent 验收:一个操作建模工具的 Agent 跑完了一条任务链,状态栏显示「完成」,可测试工程师翻遍输出,找不到任何能复核的中间验证证据——界面操作没留痕,工程对象的状态没人核对,最终工件也无法复现。任务成功了,但验收做不下去。今天的主信号恰好对准这个缺口:验收 Agent,到底该验什么。
01 今日重点信号
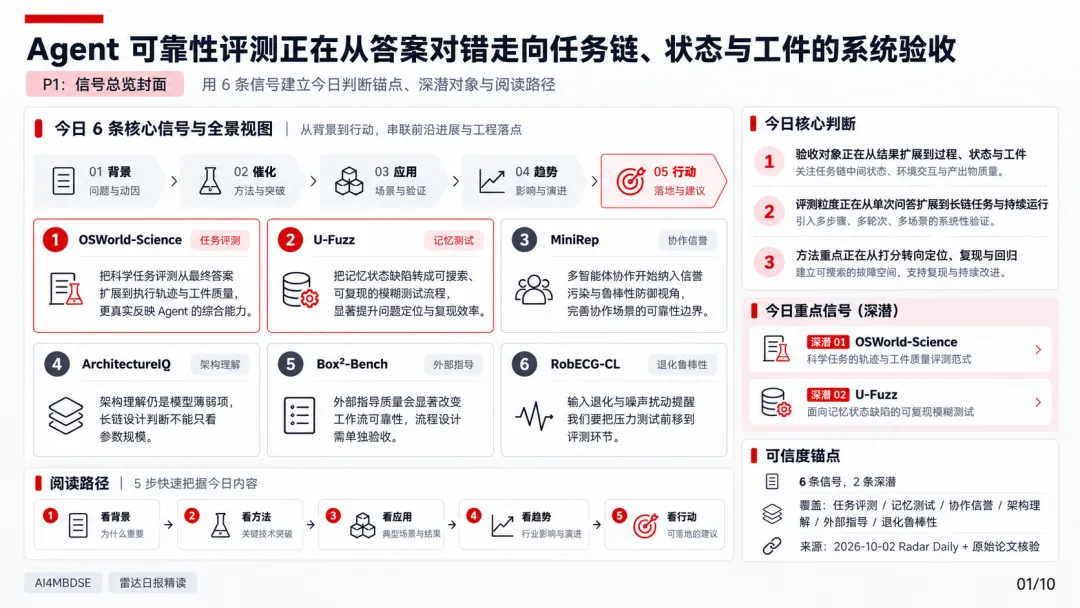
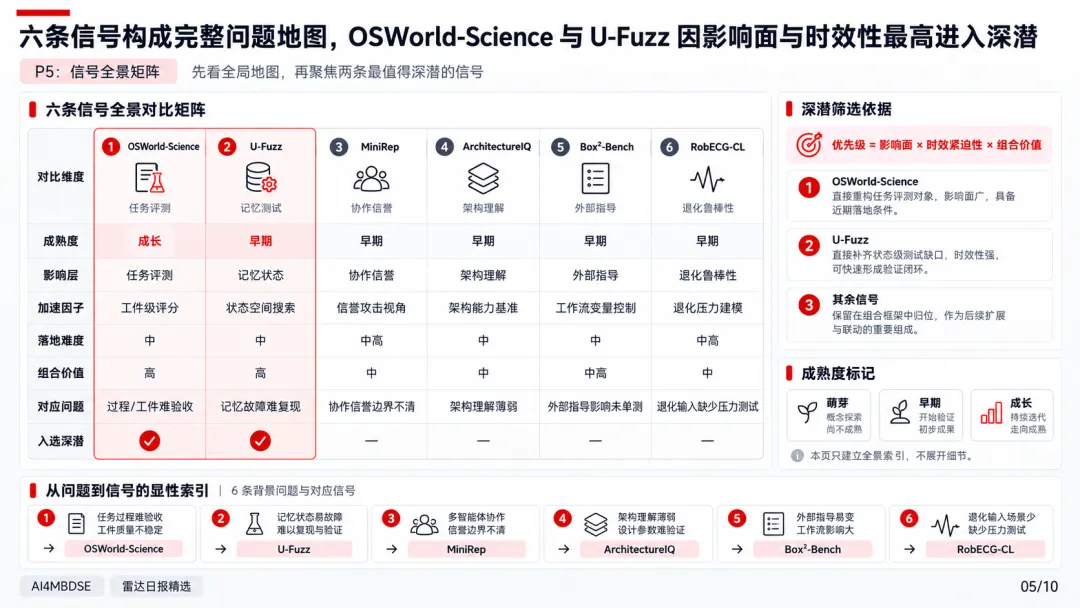
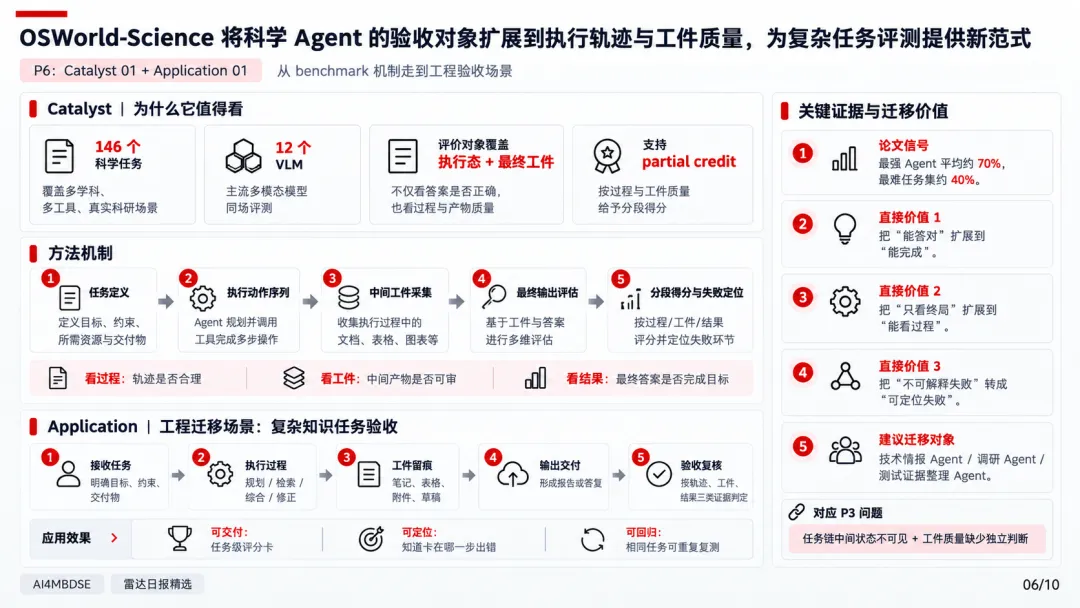
信号 01|OSWorld-Science:科学软件 Agent 全流程评测
英文标题:OSWorld-Science: A Benchmark of Computer Use Agents for Learning and Using Scientific Software
分类:AI 基础与智能系统|当日新增信号 / AI Early Signal / Agent / Workflow / Knowledge
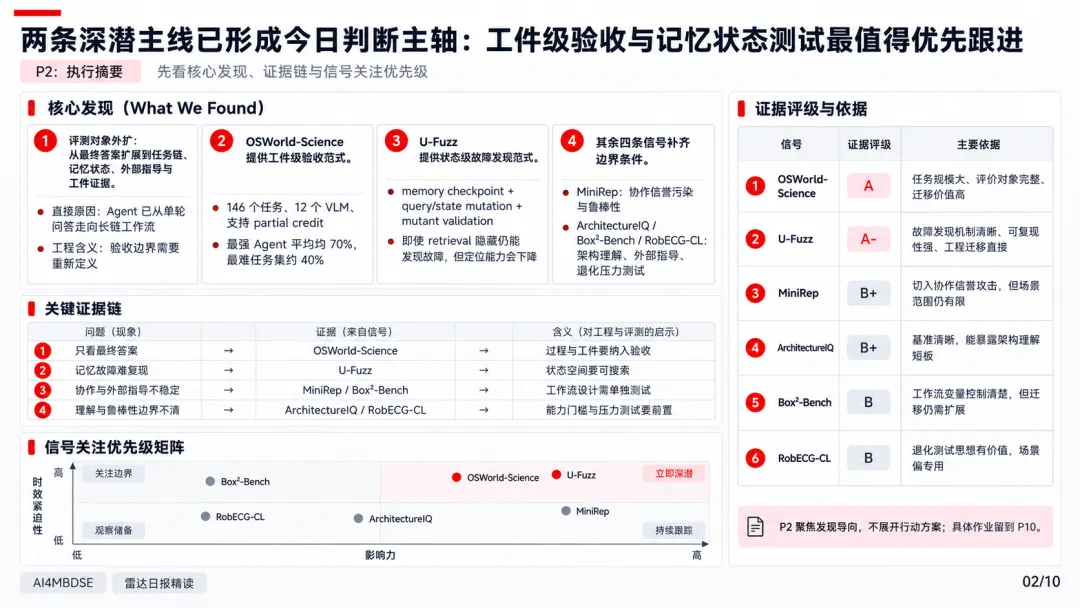
为什么选它:回到开头那个对不上的时刻:任务显示完成,但没有东西可以验收。OSWorld-Science 是一个面向计算机操作 Agent(computer-use agent)的评测基准:它把这个缺口拆成三个可检查面——模型是否理解专业界面、是否正确操作了科学对象、最终工件是否可验证,再用统一的 Agent harness 把整条工作流跑完,而不是只读最后那段文本答案。它把专业软件操作、科学任务语义和工件级结果放进同一个评测环境,直接补足通用桌面基准对工程任务链覆盖不足的问题。开头的问题因此有了一个新判断:Agent 验收不该问「它做完了吗」,而该问「每一层有没有留下可核对的验证证据」。对 AI4MBDSE,这个三层结构可以原样搬到需求分析、建模工具操作和验证产物的分层验收上。仍没解决的是成绩:公开摘要未给出全部模型的分项结果,它现在是一个框架,还不是一张可引用的成绩单。
能用吗:框架可观察,成绩不可用。公开摘要缺少分项结果,论文环境也不等于工程现场,先按「先观察」处理;可做的是借用它的三层划分,不是引用它的排名。
怎么用:选一条现有的 Agent 测试任务,拆成「界面操作—工程对象—最终工件」三层,每层写下一个可观察证据。完成标准:三层各有一个可核对产物,并标出哪一层目前是空白——那一层就是开头那种「完成但无法验收」的来源。
链接 URL:https://arxiv.org/abs/2609.39903v1
信号 02|Box²-Bench:外部指导的选择性依赖
英文标题:Thinking Outside the Box: Can Language Models Rely on External Guidance Selectively?
分类:AI 基础与智能系统|当日新增信号 / Agent / Workflow / Knowledge
为什么选它:它补的是三层框架里「外部指导」这一层的证据缺口。Box²-Bench 固定模型与任务,只改变工作流指导的可靠性:前沿模型能从可靠指导中受益,但指导误导或中途失效时仍容易被约束。这提示,固定模板、工具链规则和历史经验都要测「何时遵循、何时升级人工判断」,不能只测遵循。
能用吗:可迁移性目前只在同伴纠错和受污染记忆上观察到,不能直接等同于真实工程治理能力。论文环境结果,先观察。
怎么用:选一条现有工作流规则,构造可靠、误导、中途失效三个版本各跑一次,记录 Agent 是否机械服从。完成标准:三个版本各有观察记录,并写明哪一版应触发人工升级。
链接 URL:https://arxiv.org/abs/2609.39578v1
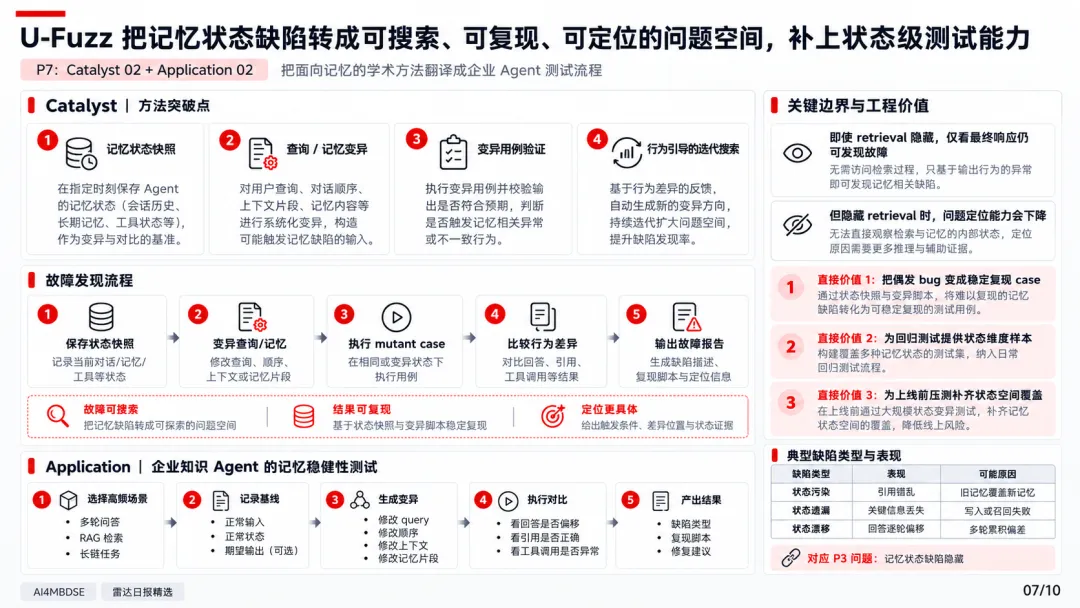
信号 03|U-Fuzz:智能体记忆使用模糊测试
英文标题:When Correct Memory Goes Wrong: Fuzzing Persistent Memory Use in LLM Agents
分类:AI+测试|当日新增信号 / AI + 测试
为什么选它:它补的是「记忆状态」这一层:记忆内容正确,但查询变化或状态演化会让它被错误使用——这是此前容易漏测的故障面。U-Fuzz 从记忆检查点出发,在明确变异义务下修改查询或记忆状态,先验证变异体再引导搜索,论文报告它比多种模糊测试基线发现更多已确认的记忆使用失败。
能用吗:结果来自论文实验环境,落地前提是被测系统支持冻结记忆检查点。只观察最终输出的 API 模型也在覆盖范围内,这点对黑盒 Agent 测试有利。
怎么用:用一个两轮对话样例做最小验证:冻结记忆检查点,分别写一条查询变异和一条记忆状态变异,用外部判据核对是否误用旧记忆。完成标准:两条变异各有明确的误用判据。
链接 URL:https://arxiv.org/abs/2609.38275v1
信号 04|MiniRep:恶意代理下的多智能体聚合
英文标题:MiniRep: Robust Reputation-Based Aggregation for Multi-Agent Debate
分类:AI+测试|当日新增信号 / AI Early Signal / AI + 测试
为什么选它:观察项,与主线隔一层。MiniRep 针对多智能体辩论:高信誉代理可能在新任务中策略性变坏,并用相似回答支配聚合结果。系统在异构十代理的 MATH 设置中、28 种攻击条件下优于对比方法。对评审协作 Agent,它提醒的是信誉、当前行为和群体相关性要分开留证,但它不直接回答开头的验收问题。
能用吗:结论受数学任务和模拟攻击范围限制。攻击分类可迁移为风险注入清单,防御效果在工程评审中的真实性待验证。
怎么用:把论文攻击分类里的串谋、相似回答支配、信誉投机各写成一条注入条件和期望拦截行为,凑成一页风险清单。完成标准:每条有触发条件和可观察判据。
链接 URL:https://arxiv.org/abs/2609.39297v1
信号 05|ArchitectureIQ:训练直觉评测
英文标题:ArchitectureIQ: On the Measure of Training Intuition
分类:AI 基础与智能系统|当日新增信号 / AI Early Signal / AI 基础研究 / 范式突破
为什么选它:观察项。ArchitectureIQ 把「模型懂训练」量化成配方选择任务:前沿模型总体约 76% 准确率,但仅比较架构时,最佳人类 65%、GPT-6 Astra 只有 38%,思维链计算也没有带来提升。它提示的是:AI 给出的建模、仿真或测试策略建议,值得用同样的小评测去审,而不是默认采纳。
能用吗:基于合成数据集,对数据属性的敏感性不足;总分掩盖分项短板,引用时应看分项。
怎么用:把一条测试设计经验改写成「给定条件、三种配方、唯一判据」的小题,做 3 题。完成标准:每题只有一个可核对的正确选项。
链接 URL:https://arxiv.org/abs/2609.39714v1
信号 06|RobECG-CL:退化感知的纸面心电识别
英文标题:Robust Transfer Learning for Paper ECG Recognition
分类:AI 基础与智能系统|当日新增信号 / AI 基础研究 / 范式突破
为什么选它:观察项,方法可借、领域不同。RobECG-CL 不随机加噪,而是构造有等级的退化视图,检查表征是否同时保持对象一致性和退化顺序;在 1% 标注下超过 ECG-FM。对工程图纸、扫描件或仪表图像的测试,可借的是退化阶梯这个实验结构,不是心电数字。
能用吗:结果来自医疗图像领域,跨领域复用前需重建本领域退化模型;数字不可迁移。
怎么用:选一张工程截图,定义版式、遮挡、噪声三种逐级退化和每级可接受指标。完成标准:三级退化可复现且各有通过线。
链接 URL:https://arxiv.org/abs/2609.39581v1
02 今日沉淀
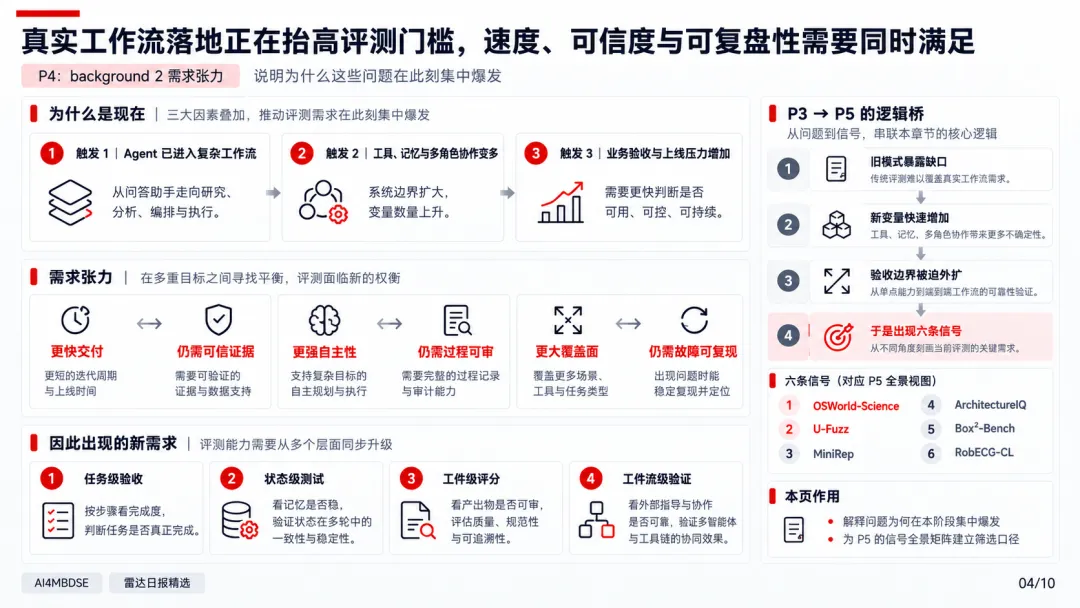
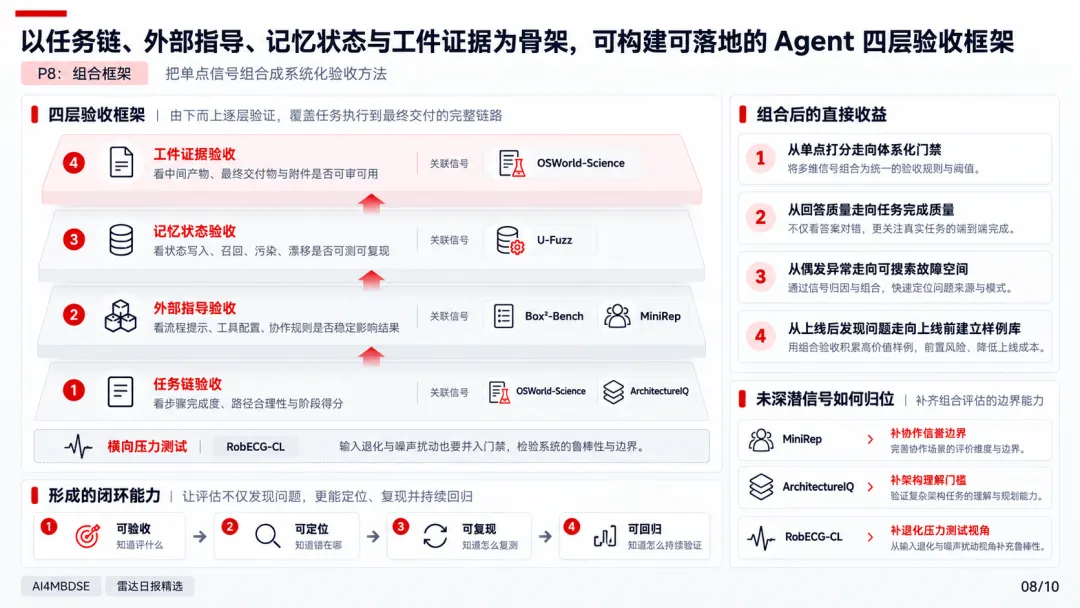
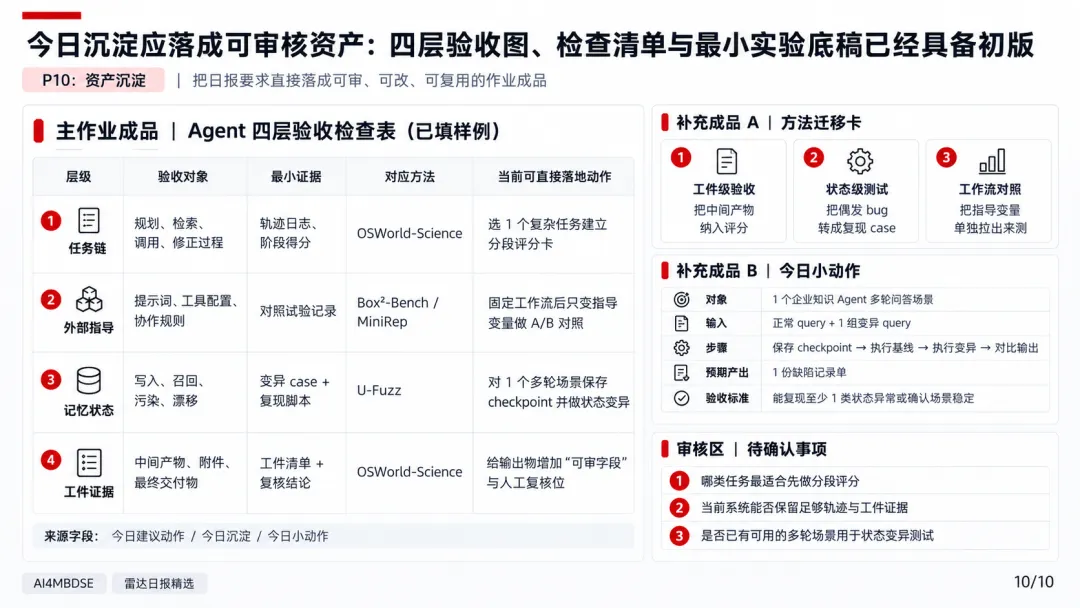
今天只沉淀一条方法:分层验收。把「任务链—外部指导—记忆状态—工件证据」拆成各自可检查的层,每层配一个可观察证据,而不是用一个任务成功率代表全部可靠性。协作信誉和输入退化今天只有论文环境证据,先记为同一方法的待补层。
03 今日小动作
• 承接开头的验收缺口:画一张「任务链—外部指导—记忆状态—工件证据」四层验收图,对照现有测试流程,标出一个目前完全没有检查的层。完成标准:四层各有一句检查对象说明,缺口处标记明确,并能说清补上它需要哪类证据。
04 日报精读PPT
复杂系统建模平台:一个开放的MBSE工程学习环境,面向系统工程师、MBSE 实践者和 SysML v2 学习者的建模平台。课程书架、学习系统工程方法、练习 SysML v2、理解工程应用和探索 AI 建模辅助的入口。请点击左下角「阅读原文」。
关于 AI4MBDSE AI+MBSE+测试 - 三个领域交叉的个人技术雷达。 从跨领域信号中找到真正值得关注的变化, 用「雷达扫描 → 精读拆解 → 方法沉淀」的多Agent协作流, 把技术洞察转化为可复用的工程方法和知识资产。 |
AI4MBDSE 不追热点,只沉淀 AI 如何成为系统工程生产力。