ARTICLE · 1126867
【LevelDB 源码阅读】04 写请求为什么排队:Writer 队列与写合并
04 写请求为什么排队
Writer 队列与写合并
上一篇结尾留下了一个问题:数据库已经打开、恢复到位,可短链服务真实的运行状态是这样的——几十个 HTTP worker 线程同时接到创建短链的请求,每个线程都调 Put,往同一个库里写。LevelDB 的头文件里倒是有一句承诺(include/leveldb/db.h:44-45):
A DB is safe for concurrent access from multiple threads without any external synchronization.
不需要调用方加任何锁。那多线程写进去的请求,在库内部是怎么不打架的?
这篇就沿着写路径往下读:DBImpl::Write 里的那条排队逻辑。读完会发现一个有点反直觉的事实:LevelDB 没有为写入设置专门的后台线程,排队、合并、落盘,全是写请求自己的线程在干;而且“排队”不但没有拖慢写入,在 sync=true 时反而是影响吞吐的来源。
多个线程同时 Put,LevelDB 内部怎么排队?为什么排队反而能更快——一条 fsync 的钱,一队人摊?
01
从 Put 到真正的入口:Write
首先从入口看起。DB::Put 本身的代码很少(db_impl.cc:1469-1473):
Status DB::Put(const WriteOptions& opt, const Slice& key, const Slice& value) {WriteBatch batch;batch.Put(key, value);return Write(opt, &batch);}
三行代码:把一对 key/value 包进一个 WriteBatch,然后转手交给 Write。Delete 也是同样的透传(db_impl.cc:1475-1479)。
Status DB::Delete(const WriteOptions& opt, const Slice& key) {WriteBatch batch;batch.Delete(key);return Write(opt, &batch);}
所以不管外面调的是 Put 还是 Delete,最终都会进入同一个门:DBImpl::Write(const WriteOptions& options, WriteBatch* updates)(db_impl.cc:1200)。
这个函数不长,七十来行,却是整个写路径的中枢。它要回答的问题和 02 篇单线程视角下不一样了:单线程时顺序天然成立,现在多个线程同时进来,谁先谁后?谁的日志先写?序列号怎么分?这些都指向同一个数据结构——writers_ 队列。
02
排队的第一步:把自己挂到 writers_ 上
Write 开头构造的是一个局部变量(db_impl.cc:1201-1204):
Writer w(&mutex_);w.batch = updates;w.sync = options.sync;w.done = false;
Writer 的定义就在同文件开头(db_impl.cc:43-52):一个 status、一个 batch 指针、一个 sync 标志、一个 done 标志,外加一个条件变量 cv。
struct DBImpl::Writer {explicit Writer(port::Mutex* mu): batch(nullptr), sync(false), done(false), cv(mu) {}Status status;WriteBatch* batch;bool sync;bool done;port::CondVar cv;};
整个结构在调用者的栈上构造,而不是堆。每个排队的写请求就是这样一个栈上对象,开销十分低廉。同时呼应一个事实:LevelDB 的写路径是零后台线程设计,为每个请求分配资源的开销都会直接算在写线程头上。
接着加锁、入队(db_impl.cc:1206-1207):
MutexLock l(&mutex_);writers_.push_back(&w);
writers_ 是 std::deque<Writer*>(db_impl.h:186),由 mutex_ 保护。注意队列里存的是指针——指向各线程栈上那个 Writer。也就是说,队列本身是共享的,队列元素却散落在各个线程的栈帧里,靠“入队的线程此时一定活着”这一点维持有效。
然后是这段(db_impl.cc:1208-1210):
while (!w.done && &w != writers_.front()) {w.cv.Wait();}
这短短的两行代码中包含了 3 个信息:
我不是队首,就没轮到我,持续等待。队首就是这一轮的 leader,负责真正干活。
如果我被上一轮 leader 捎带完成了(写合并就发生在这里),done 会被置为 true,我根本不用当 leader,直接拿结果走人。
条件变量存在虚假唤醒,而且被唤醒后条件也可能已经变化——比如被前一轮 leader 合并掉了。醒来必须重新检查,所以用 while 而不是 if。
每个 Writer 有自己的 CondVar(构造时绑定 mutex_,port/port_stdcxx.h:65 对 std::condition_variable 的封装),所以唤醒可以做得很精准:leader 完成后挨个通知该醒的对象,而不是唤醒整条队列再让所有人抢锁。
// Thinly wraps std::condition_variable.class CondVar {public:explicit CondVar(Mutex* mu) : mu_(mu) { assert(mu != nullptr); }~CondVar() = default;CondVar(const CondVar&) = delete;CondVar& operator=(const CondVar&) = delete;void Wait() {std::unique_lock<std::mutex> lock(mu_->mu_, std::adopt_lock);cv_.wait(lock);lock.release();}void Signal() { cv_.notify_one(); }void SignalAll() { cv_.notify_all(); }private:std::condition_variable cv_;Mutex* const mu_;};
把这个机制画成时间线,三个线程的交错大概是这样:
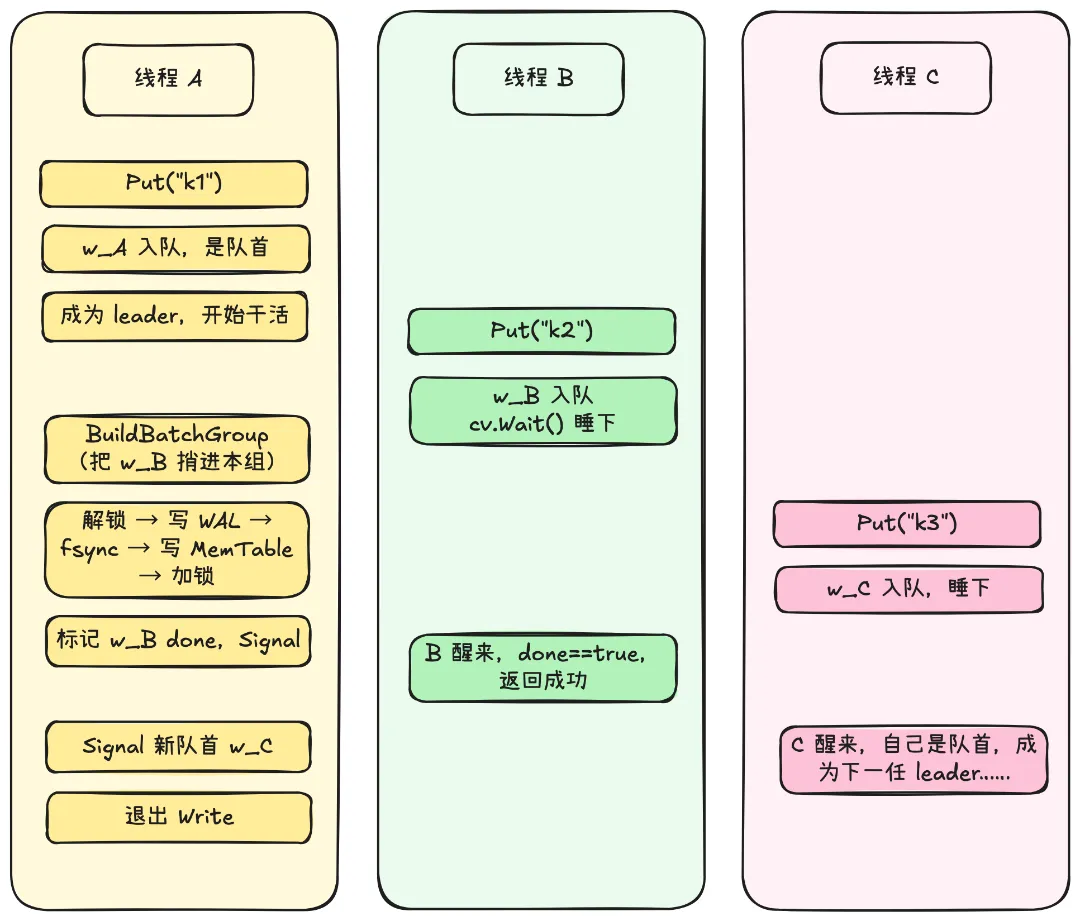
看完这张图,还有几个问题我们没理清楚:B 从入队到被标记 done,中间 leader A 干了什么?“捎进本组”又是怎么捎的?这就是 leader 的三件事。
03
队首的三件事:合并、落盘、写 MemTable
熬过了 while 等待、done 仍为 false 的那个线程,就是现任 leader。它接下来做三件事。
第一件事,确认有地方可写(db_impl.cc:1216):MakeRoomForWrite(updates == nullptr)。这个函数会判断的是 MemTable 满没满、L0 文件多不多、要不要切换 MemTable,后面单独讲——只要知道它可能让 leader 在这里又睡上一阵,给后台 Compaction 让路。
第二件事,合并(db_impl.cc:1220-1222):
WriteBatch* write_batch = BuildBatchGroup(&last_writer);WriteBatchInternal::SetSequence(write_batch, last_sequence + 1);last_sequence += WriteBatchInternal::Count(write_batch);
BuildBatchGroup 从队首(自己)开始向后扫,把后续 writer 的 batch 合并成一个大 batch,同时记下本组最后一个 writer 是谁。然后给这个大 batch 分配序列号:起始号是 last_sequence + 1,一口气推进 Count 个。八个线程各写一条被合并成一批,这批就占八个连续的序列号——每个成员具体分到哪个号,是后面讲解 WriteBatch 格式的核心内容,这里先按下不表。
第三件事,把合并得到的批真正落下去,这是整个函数最核心的一段(db_impl.cc:1229-1247):
mutex_.Unlock();status = log_->AddRecord(WriteBatchInternal::Contents(write_batch));bool sync_error = false;if (status.ok() && options.sync) {status = logfile_->Sync();if (!status.ok()) {sync_error = true;}}if (status.ok()) {status = WriteBatchInternal::InsertInto(write_batch, mem_);}mutex_.Lock();if (sync_error) {// The state of the log file is indeterminate: the log record we// just added may or may not show up when the DB is re-opened.// So we force the DB into a mode where all future writes fail.RecordBackgroundError(status);}
写 WAL、按需 fsync、写 MemTable——最耗时的操作全部发生在解锁状态。解锁不会乱套吗?源码注释(db_impl.cc:1224-1227)直接回答了:此时队列里其他 writer 都在 cv.Wait() 里睡着,能碰 log_ 和 mem_ 的只有 leader 一个,不需要锁保护;锁真正的职责是保护 writers_ 队列本身。持锁范围缩到最小,IO 期间别的线程还能继续入队。
还有一个容易看漏的细节:options.sync 用的是 leader 自己的选项。也就是说,一个组是否 fsync,由队首说了算。追随者(被捎带的)如果本来没要求 sync,被 leader 带着刷了盘,等于免费享受了一次更安全的写入,不亏;反过来,要求 sync 的追随者会不会被一个不 sync 的 leader 捎带,落得一个“没刷盘”的下场?不会——BuildBatchGroup 里有条专门的规则挡住这种情况,下一节说。
Sync() 失败的善后也值得一读:代码没有立刻把错误扔回去,而是用 sync_error 标志把失败带过 Lock(),在持锁状态下调 RecordBackgroundError(db_impl.cc:1246),把错误存进 bg_error_(db_impl.cc:654),此后所有后续写请求直接被拒。源码注释解释了为什么要下这么重的手:fsync 失败后,这条日志记录重开库时在不在,谁也说不准——与其带着不确定的因素继续跑,不如关掉写通道等人工介入。
void DBImpl::RecordBackgroundError(const Status& s) {mutex_.AssertHeld();if (bg_error_.ok()) {bg_error_ = s;background_work_finished_signal_.SignalAll();}}
最后收尾两行(db_impl.cc:1249-1251):
if (write_batch == tmp_batch_) tmp_batch_->Clear();versions_->SetLastSequence(last_sequence);
如果本组发生过合并,write_batch 指向的是复用的 tmp_batch_,用完 Clear() 掉留给下一轮;然后 SetLastSequence 把全局序列号发布出去。
合并逻辑单看是一个函数(db_impl.cc:1275-1321),读下来发现它其实是在回答“一组该多大”这个问题,而答案由三条边界共同给出。
第一条边界是尺寸。函数里有两行关键代码(db_impl.cc:1287-1290):
size_t max_size = 1 << 20;if (size <= (128 << 10)) {max_size = size + (128 << 10);}
翻译过来:如果当前攒的批还不大(不超过 128KB),那就允许再吞 128KB 的增量;一旦超过 128KB,上限就封死在 1MB。这是一个两档设计——小批限增量,大批封顶。为什么不让它无限制地吞?组越大,单次 IO 摊给越多请求,吞吐越高,但组内每个成员从入队到完成的时间也被拉长了:排在第 100 个的 writer,要等前面 99 个人的数据一起写完。上限是对吞吐和组内等待时延的折中。
第二条边界是 sync 单向规则(db_impl.cc:1297-1299):
if (w->sync && !first->sync) {// Do not include a sync write into a batch handled by a non-sync write.break;}
要求 fsync 的 writer,不能被一个不 fsync 的 leader 捎带。反方向则是允许的:不 sync 的追随者跟着 sync 的 leader,免费享受 fsync。规则不对称的道理在语义上:追随者要求 sync,意味着调用方认为“这条数据掉电也不能丢”,被不 sync 的 leader 带着跳过 fsync 就违背了用户的显式要求;反过来,用户没要求 sync,多刷一次盘只是比承诺的更安全,无妨。合并能合,前提是语义不缩水。
第三条边界最隐蔽:合并的载体。函数开头 WriteBatch* result = first->batch——如果扫完队列发现根本没人可合并(自己是唯一一个 writer),直接返回自己的 batch,一个字节都不用拷贝。只有真的要合并时,才切换到 tmp_batch_(db_impl.h:187,构造于 db_impl.cc:146),把队首和追随者的 batch 逐个 Append 进去(db_impl.cc:1310-1315)。tmp_batch_ 是 DBImpl 的成员,复用免去了每组一次的分配。Append 的实现(write_batch.cc:144-148)是 count 相加、rep_ 去掉头部计数后拼接,纯字节操作,不解析内容。
void WriteBatchInternal::Append(WriteBatch* dst, const WriteBatch* src) {SetCount(dst, Count(dst) + Count(src));assert(src->rep_.size() >= kHeader);dst->rep_.append(src->rep_.data() + kHeader, src->rep_.size() - kHeader);}
还有一个特例需要关注:队列里可能混进 batch == nullptr 的 writer(db_impl.cc:1302 的判断就是为它准备的)。
if (w->batch != nullptr) {size += WriteBatchInternal::ByteSize(w->batch);if (size > max_size) {// Do not make batch too bigbreak;}// Append to *resultif (result == first->batch) {// Switch to temporary batch instead of disturbing caller's batchresult = tmp_batch_;assert(WriteBatchInternal::Count(result) == 0);WriteBatchInternal::Append(result, first->batch);}WriteBatchInternal::Append(result, w->batch);}*last_writer = w;
Write 允许传入空指针,这种请求不写任何数据,却照样排队、照样当 leader——它的用途是当屏障。CompactRange 手动触发 Compaction 时会经由 TEST_CompactMemTable 插一个这样的屏障(db_impl.cc:640,Write(WriteOptions(), nullptr)),逼着前面的写全部落地、开一个新的 log 文件,后面的写落在切换后的新文件上。屏障 writer 不给合并批增加一个字节,但会作为 last_writer 被记下(db_impl.cc:1318)(可以看到 last_writer 的赋值没有考虑前面的 if 判断语句)。
leader 做完三件事,回到持锁状态,进入收尾循环(db_impl.cc:1254-1268):
while (true) {Writer* ready = writers_.front();writers_.pop_front();if (ready != &w) {ready->status = status;ready->done = true;ready->cv.Signal();}if (ready == last_writer) break;}// Notify new head of write queueif (!writers_.empty()) {writers_.front()->cv.Signal();}
从队首开始逐个出队,直到本组的 last_writer 为止:追随者标记 done、传回状态、逐个唤醒——它们醒来后在 while 循环里发现 done == true,直接返回,全程没干任何活。leader 自己(ready == &w)不走 Signal,因为本来就在跑。
循环外的两行是接力的关键:如果队列里还有人(本组之后新来的),把新队首唤醒。新队首醒来,while 条件不满足,自己成为 leader,开始它的三件事。于是整条队列就这样一波接一波地向前推进——没有调度器,没有后台写线程,干活的线程就是来干活的用户线程本身。用一句话概括这套机制:消费者就是排队的人。这也是开头说“零后台线程”的含义:LevelDB 的写路径上,唯一的执行者是从 Put 一路进来的调用方线程。
回头看 leader 的第一件事。MakeRoomForWrite(db_impl.cc:1325-1385)在合并之前运行,它决定“这一批能不能写、写到哪”。函数体是一个 while (true) 加一串分支,顺着读像过一串关卡:
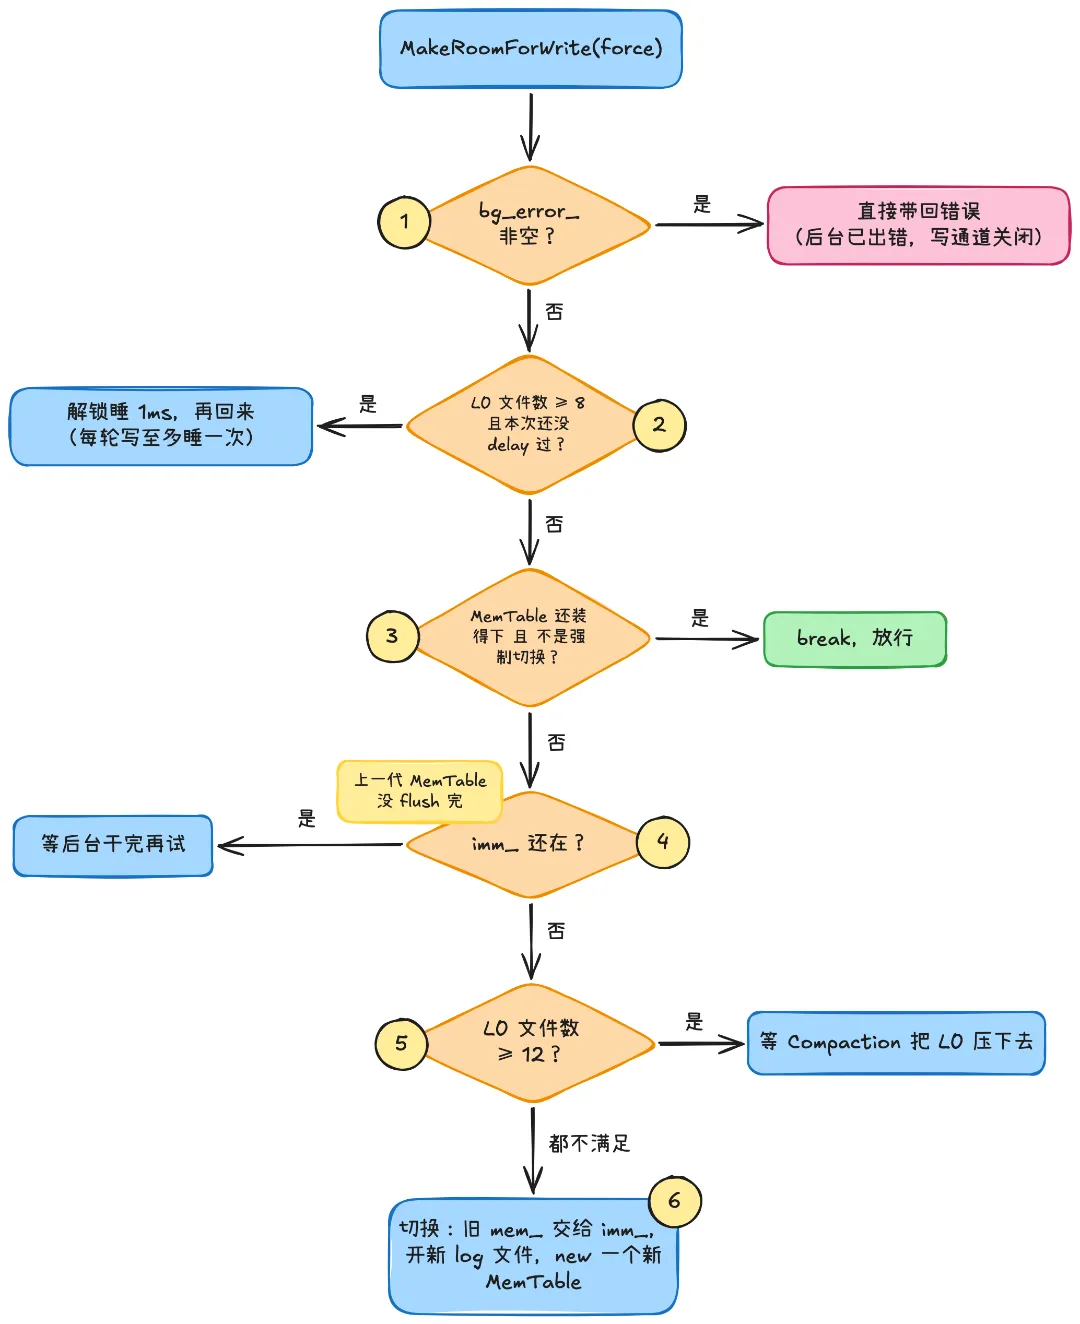
有两个配置数字需要标注一下:
kL0_SlowdownWritesTrigger(dbformat.h:31)的值是 8;
kL0_StopWritesTrigger(dbformat.h:34)的值是 12。
两个值都指的是 L0 层的 SSTable 文件数。可以把它们理解成减速带和红灯——当 L0 层堆到 8 个文件后,写入开始每轮小睡 1ms;堆到 12 个后,写入彻底停下来等 Compaction。
图中分支 ② 的实现(db_impl.cc:1335-1346)值得留意。
else if (allow_delay && versions_->NumLevelFiles(0) >=config::kL0_SlowdownWritesTrigger) {// We are getting close to hitting a hard limit on the number of// L0 files. Rather than delaying a single write by several// seconds when we hit the hard limit, start delaying each// individual write by 1ms to reduce latency variance. Also,// this delay hands over some CPU to the compaction thread in// case it is sharing the same core as the writer.mutex_.Unlock();env_->SleepForMicroseconds(1000);allow_delay = false; // Do not delay a single write more than oncemutex_.Lock();}
注释把动机说得很明白:
Rather than delaying a single write by several seconds when we hit the hard limit, start delaying each individual write by 1ms to reduce latency variance.
与其等到 12 个文件时彻底卡死,不如从 8 个起就把未来的长停顿摊成每次写 1ms 的小延迟。用户感受到的不是“快的时候飞快、慢的时候卡两秒”,而是“整体稍慢但平稳”。allow_delay 标志保证一次 MakeRoomForWrite 至多睡一次,不会睡完 1ms 醒来再睡。
分支 ④、⑤ 是两代 MemTable 的容量天花板。切换之后,旧 MemTable 变成 imm_(immutable),等着后台线程 flush 成 SSTable;在 flush 完成前,imm_ 一直占位,新的切换不能发生——所以分支 ④ 要等。而 flush 出来的 SSTable 直接落在 L0,又会推高 L0 文件数、撞上分支 ⑤,于是又要等 Compaction。写、flush、Compaction 三者的速度差,最终都会转化成写路径上的等待,这就是写请求直接感受到背压的地方。
分支 ⑥ 是切换本身(db_impl.cc:1360-1382):申请新文件号、开一个新的 log 文件(开失败就把文件号退回去,ReuseFileNumber)、imm_ = mem_、mem_ 指向新造的 MemTable,然后 MaybeScheduleCompaction 催一下后台。
// Attempt to switch to a new memtable and trigger compaction of oldassert(versions_->PrevLogNumber() == 0);uint64_t new_log_number = versions_->NewFileNumber();WritableFile* lfile = nullptr;s = env_->NewWritableFile(LogFileName(dbname_, new_log_number), &lfile);if (!s.ok()) {// Avoid chewing through file number space in a tight loop.versions_->ReuseFileNumber(new_log_number);break;}delete log_;delete logfile_;logfile_ = lfile;logfile_number_ = new_log_number;log_ = new log::Writer(lfile);imm_ = mem_;has_imm_.store(true, std::memory_order_release);mem_ = new MemTable(internal_comparator_);mem_->Ref();force = false; // Do not force another compaction if have roomMaybeScheduleCompaction();
这里能再次看到 02 篇说过的“WAL 与 MemTable 同生共死”:切 MemTable 的同时必然切 log 文件,两者是一个整体的两半。还有一个细节:has_imm_ 是 std::atomic<bool>(db_impl.h:179),imm_ 指针本身受 mutex_ 保护,但后台线程想快速判断“有没有 imm 等着我”时,读这个原子变量就够了,不用抢锁——主流程的锁竞争已经够热闹了,能给后台开个小孔就开个小孔。
MemTable 满了之后完整的故事——flush 怎么触发、imm 怎么变成 SSTable——属于后台线程的戏份,我们后面再说。这篇文章中,我们只需要了解:写入排队之前还有一道关,它决定了“这一批写进哪个 MemTable、哪个 log 文件”。
机制了解完了,动手实践一下。我们考虑一个具体一点的问题:
写合并对什么样的写有帮助?
实验代码是 write_bench(完整代码见文末附录):固定总写入量,开 N 个线程并发 Put 短码(key 形如 c:B000123,value 是对应的 URL),均分工作量,统计总吞吐。跑在本机(macOS,APFS 文件系统),先使用默认配置 sync=false,总写入 20000 条:
并发上去,吞吐反而掉下来了。是合并没起作用吗?
想一下 sync=false 时一次写到底在做什么:AddRecord 是往页缓存写几十个字节,InsertInto 是往内存里的跳表插一个节点,全程微秒级,没有任何真正的 IO 等待。这种情况下,排队本身的开销——抢锁、队列操作、合并时的 Append 拷贝——反而成了新增的成本项。合并能摊薄的只有那些“贵”的步骤,当这些开销大的步骤不存在时,合并就是纯开销。这一下也解释了为什么 8 线程比 4 线程又好了一点:并发越高,队伍越长,单次合并批越大,单位开销被摊得越薄,部分找回了损失。
再把 sync=true 打开,总写入降到 2000 条(fsync 很慢):
单线程 108 ops/s,一次写约 9.2ms——这基本就是本机一次 fsync 的价格。并发开到 8,吞吐 7.41 倍,接近线性。反推一下:800 ops/s ÷ 108 ops/s ≈ 7.4,也就是说 8 线程排队时,每次 fsync 平均捎带了大约 7.4 个写请求——8 个线程在排队,队伍里平均就这么多人,和合并机制的预测基本对得上。
两组实验合起来,结论收敛成一句话:写合并的收益等于被摊薄的那个昂贵步骤。fsync 在写路径上时(sync=true),并发越高收益越大,一条日志的钱全组摊;昂贵步骤不在路径上时(sync=false),合并只剩成本。数字本身和机器强相关——macOS 的 fsync 出了名的慢,Linux 加 SSD 上单线程可能就上万 ops/s——但“贵步骤决定合并收益”这个相对关系是通用的。
macOS 的 fsync(或由于为了保证数据安全而必须使用的 F_FULLFSYNC)之所以出了名的慢,并不是因为 Apple 的底层硬件不行,而是因为它的语义定义极度严格,且 Apple 定制的 NVMe 固件在执行真正的“硬件级落盘”时有着极高的延迟罚则。
fsync() 通常会同时刷新操作系统缓存和硬件驱动器的写入缓存。但在 macOS 上,情况完全不同:
在 macOS 中,标准的 fsync() 属于轻量级刷新。它只负责把数据从操作系统的页缓存(Page Cache)推送到硬盘自带的硬件缓冲区(Drive Cache),然后就立即返回。
这就导致 macOS 在常规的跑分测试(如 fio 不加特殊参数)中看起来快得惊人。但如果此时电脑突然断电,由于数据还在硬盘的电容/缓存里,数据依然会丢失或损坏。
为了追求绝对的数据完整性,像 SQLite、PostgreSQL、Go 语言(部分版本) 或 Rust 标准库 在 macOS 上必须放弃 fsync(),改用 Apple 独有的底层命令:
fcntl(fd, F_FULLFSYNC);这个命令会强制要求固件清空硬件缓存,将数据真正写入闪存介质中。而一旦开启 F_FULLFSYNC,吞吐量和 IOPS 会呈现断崖式下跌(有时甚至跌到十几或几十 IOPS,直接退回机械硬盘时代)。
LevelDB 也不例外,可以在 env_posix.cc::370-378)中看到对应的配置:
#if HAVE_FULLFSYNC// On macOS and iOS, fsync() doesn't guarantee durability past power// failures. fcntl(F_FULLFSYNC) is required for that purpose. Some// filesystems don't support fcntl(F_FULLFSYNC), and require a fallback to// fsync().if (::fcntl(fd, F_FULLFSYNC) == 0) {return Status::OK();}#endif // HAVE_FULLFSYNC
“攒一批、刷一次”这个思路在数据库圈有个通用名字:group commit。对照几个熟悉的实现,能看清 LevelDB 的取舍在哪。
MySQL 的提交路径上要顺序刷两份日志:redo log 和 binlog,每份都有 fsync,代价不小。InnoDB 的做法是把提交做成 flush、sync、commit 三个阶段,每个阶段各自排队:先到的事务当 leader,把追随者的日志一起刷盘,追随者在后一个阶段门口等着接力。
和 LevelDB 比,流程差不多的——leader 干活、追随者搭车、干完唤醒——差别则体现在约束上:LevelDB 一批只刷一份 WAL,一个阶段就够了,于是合并逻辑收缩成一个 BuildBatchGroup 加一个解锁窗口;InnoDB 一批要过两个持久化点,阶段就得拆开排队,leader 和追随者的身份在每个阶段还要重组。日志份数和持久化点数决定了队列要几段。
PostgreSQL 也有 group commit,但采用了另一种平衡:commit_delay 参数让提交前先主动等一小段时间(微秒级),攒够数据再刷,攒不够就白等。默认是关的,交给 DBA 按负载调整。差异的根源在服务对象:PostgreSQL 面向负载千差万别的通用数据库,硬编码一个等待时间没有普适答案,不如暴露成参数;LevelDB 的合并是“顺路捎带”——反正后面的人已经在排队了,捎上他们不增加任何等待时间,这种隐式自适应不需要参数,也就没有调参负担。约束不同:一个是“等待换吞吐”的主动取舍,一个是“无代价搭车”的被动收益。
Redis 命令处理是单线程,天然没有并发写请求可合并;但更本质的原因是它的“贵”步骤根本不在请求路径上——AOF 配 everysec 时,主线程只往 aof_buf 内存缓冲区里写,刷盘由后台线程每秒一次执行。把 fsync 挪出请求路径,就无所谓合不合并。这和上面 sync=false 的实验互为印证:LevelDB 的写路径在 sync=false 时也几乎没有昂贵步骤,合并收益同样趋近于零。殊途同归的是,everysec 的后台线程攒一秒的修改一次刷下去,其实就是时间维度上的 group commit——用“攒时间”替代了“攒并发”。
线程安全是库的承诺,写合并也是库内置的,业务层不需要也不应该再自己做一层写队列或加锁串行化——那等于把库里的队伍推倒重来一遍,还享受不到合并。短链服务多 worker 并发建短码,就是最直接的用法。
单线程 fsync 是全额付费,多线程排队是拼单;对“掉电也不能丢”的关键写(比如短链的创建),sync=true 加上适度并发,延迟的绝对值未必不可接受。
GetProperty("leveldb.num-files-at-level0")(db_impl.cc:1396)能直接看到 L0 文件数量:到了 8 说明正在过减速带,到了 12 就是红灯停车。很多“写变慢了”不是写本身的问题,是后台 Compaction 跟不上了。
LevelDB 没有为写入设后台线程,leader 就是普通请求线程,干完活把接力棒传给下一任。任何“攒一批再刷”的场景——日志上报、metrics 上报、批量落库——都可以套这个模式:队列加条件变量,队首兼任批处理者,省掉一个常驻线程和一级线程间转发。
BuildBatchGroup 的两档上限(小批限增量 128KB、大批封顶 1MB)是吞吐与组内等待时延的折中。做批量上报时同样要回答“一批多大”——只按条数或只按字节数封顶都偏粗糙,“小的时候随便长、大了就封顶”是更平滑的策略。
Write 里加锁的区间只包含队列和序列号操作,AddRecord、Sync、InsertInto 全在锁外。反过来看更清楚:凡是 IO 期间还攥着锁的代码,队列越长,所有排队者付的冤枉钱越多。
到这里,写路径上的排队与合并就完整了:一个栈上的 Writer,一条 writers_ 队列,leader 合并、解锁落盘、逐个唤醒、交棒下一任。但队伍解散时,每个线程拿到的只是“成功”,还有一个黑盒没打开——BuildBatchGroup 拼出来的那个大 batch,究竟长什么样?八个线程的数据混在里面,每个成员怎么分到自己的序列号?为什么说一批就是一次原子写、要么全在要么全不在?
下一篇,讲 WriteBatch。
// examples/shorturl/write_bench.cc:并发写压测——观察 Writer 队列与写合并的效果。// 固定总写入条数,均分给多个线程并发 Put,统计吞吐(ops/s)。// 用法:write_bench <dbpath> <threads> <total_writes> [sync(0/1)]// 例:./.output/write_bench .output/bench-t1 1 20000// 编译(仓库根目录,macOS 用 clang++,Linux 用 g++):// clang++ -std=c++17 -I leveldb-1.23/include examples/shorturl/write_bench.cc \// .output/build/libleveldb.a -o .output/write_bench -lpthread#include <atomic>#include <chrono>#include <cstdio>#include <cstring>#include <string>#include <thread>#include <vector>#include "leveldb/db.h"int main(int argc, char* argv[]) {if (argc < 4) {std::fprintf(stderr, "usage: %s <dbpath> <threads> <total> [sync(0/1)]\n",argv[0]);return 1;}const std::string dbpath = argv[1];const int nthreads = std::atoi(argv[2]);const long total = std::atol(argv[3]);const bool sync = argc > 4 && std::strcmp(argv[4], "1") == 0;leveldb::Options options;options.create_if_missing = true;leveldb::DB* db = nullptr;leveldb::Status s = leveldb::DB::Open(options, dbpath, &db);if (!s.ok()) {std::fprintf(stderr, "open error: %s\n", s.ToString().c_str());return 1;}leveldb::WriteOptions wo;wo.sync = sync;std::atomic<long> next_key(0);auto worker = [&](int tid) {char key[32], val[64];while (true) {long k = next_key.fetch_add(1);if (k >= total) break;std::snprintf(key, sizeof(key), "c:B%06ld", k);std::snprintf(val, sizeof(val), "https://example.com/%06ld", k);leveldb::Status ws = db->Put(wo, key, val);if (!ws.ok()) {std::fprintf(stderr, "put error: %s\n", ws.ToString().c_str());return;}}};const auto t0 = std::chrono::steady_clock::now();std::vector<std::thread> threads;for (int i = 0; i < nthreads; i++) threads.emplace_back(worker, i);for (auto& t : threads) t.join();const auto t1 = std::chrono::steady_clock::now();const double secs =std::chrono::duration_cast<std::chrono::microseconds>(t1 - t0).count() /1e6;std::printf("threads=%d total=%ld sync=%d elapsed=%.3fs throughput=%.0f ops/s\n",nthreads, total, sync ? 1 : 0, secs, total / secs);delete db;return 0;}