ARTICLE · 1130125
开放权重的大模型能免费下载,为什么接进来反而更贵?
权重能下载,不等于能省钱。这句话听着别扭,但你只要算过机房那本账,就明白它是真的。
十月初,一款叫 Beam 的开放权重模型放出来,5010 亿总参数,激活 230 亿,1M 上下文,本月底放权重。官方说它在编程和智能体任务上对标 GLM-5.2、逼近 Qwen3.8-Max,推理算力只要三分之一到四分之一。数字很好看,但真到自己机房里跑,故事是另一回事。
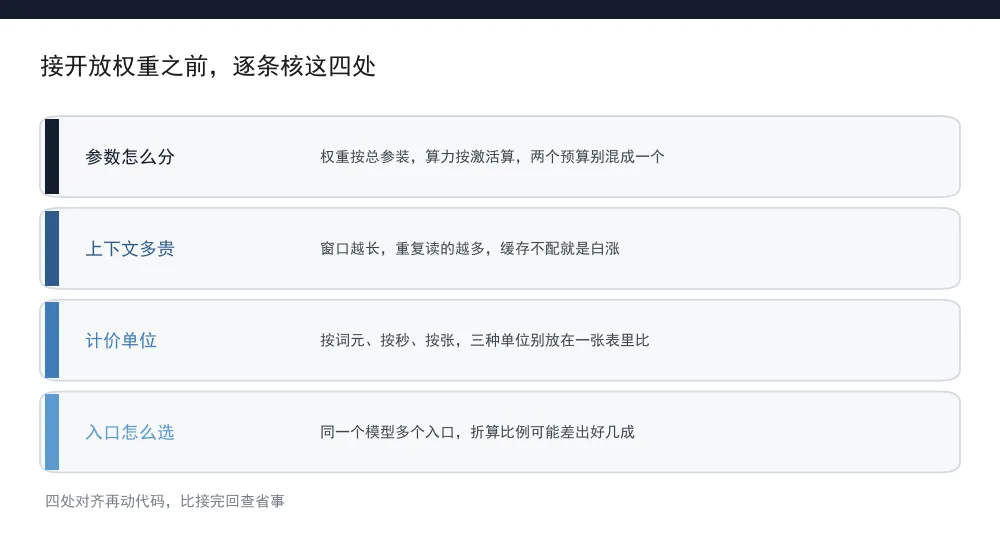
先分清两个参数。总参数决定权重占多大显存,激活参数决定每一步的计算量。Beam 这种稀疏结构,权重按 5010 亿装,算力按 230 亿算。装不下,就跑不起来;算不省,就跑不快。两个数不能混着看。
用大白话再讲一遍:权重是你要装进机房的那堆文件,激活是你每次真正调动的人手。5010 亿的权重,按半精度算是不小的存储开销;但每次只叫醒 230 亿,实际计算量就小得多。开放模型的门槛从来不在算力贵,而在你装不装得下。
这里有个容易算错的点。自己部署看起来省了单价,但你要付的是机房、运维和人。真正划算的场景,往往是数据敏感、调用量稳定且很大;如果只是偶尔跑跑,走聚合反而更便宜。别被“免费权重”这四个字带着走。
再看上下文。1M 词元听上去很爽,但长上下文的每一轮对话都要把前面的内容重新读一遍。除非你的框架把缓存用起来,否则窗口越长,账单涨得越快。
第三处是计价单位。站上有的按百万词元算,有的按秒算,有的按张算。同一张账单上混着三种单位,最容易算错。接之前先确认你用的那个入口按什么计价。
还有个细节,按秒计价的档位通常不看你传了多少字,只看时长。做语音转写、视频理解这类活,按秒比按词元直观,但预算的算法完全不同。
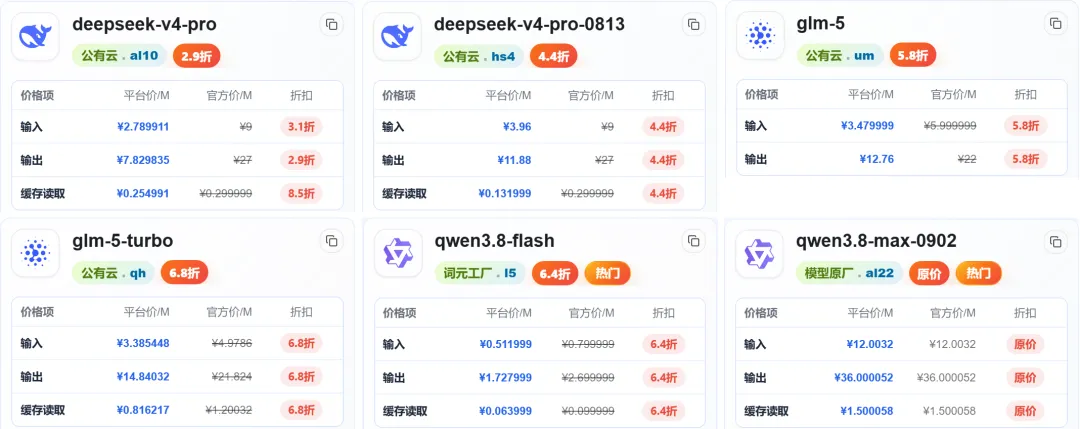
最后是入口。同一个模型往往有多个入口,折算比例不一定一样。站上同一批文本档位摆在一起,比例能从不打折一路铺到 2.9 折。你选的那个入口,决定你付的是哪一档。
还有一个坑:带日期后缀的版本,往往和主版本不是同一个价。名字看起来差不多,折算比例可能差一截,接入前一定把型号串逐字核对一遍,别凭记忆写。
把这四处对齐,再看可选档位就清楚了。deepseek-v4-pro-0813 走公有云渠道挂 4.4 折,三行折算比例整齐一致,适合作为常规主力;deepseek-v4-pro 挂 2.9 折更便宜,但它的三行里缓存读取那一行是 8.5 折,比另外两行贵不少,重复调用多的场景要留意;qwen3.8-flash 挂 6.4 折,文本与多模态都能接,适合需要读图的团队。
缓存这一栏,落地的时候有两件事要注意。一是把固定的系统提示词和参考资料放在请求最前面,框架才能识别出重复的前缀;二是同一批任务尽量在同一个会话里跑完,别拆成几十个独立请求。这两点做好,命中率能差出一大截。
接入的顺序也有讲究。
先把端点换过来,跑通一条最简单的请求,确认返回结构对不对;再拿一条真实的长任务压测,看词元消耗和延迟;最后才把缓存那一栏配起来。反过来做,前两步多半会把钱白花掉。
权重免费,运维不免费。算得清,才是真的省。
关注水木词元。
回复“体验”领 100 万 token 试用包,切过来先对着日志比一遍账单