ARTICLE · 1134265
超实用!临床数据录入的 2 种方法:Excel、EpiData!
今天这篇文章,我会介绍建库的核心逻辑,以及临床数据录入的 2 种方法,帮你踏出自建数据库的第一步!
先想清楚:你要验证什么,再决定录什么
建库第一步,不是急着打开电脑开始暴风输入,而是先确定主线。
我举个例子,你想复现这样一篇文章:NHANES 的横断面研究,主做 TYG 和中风的关联;CHARLS 做纵向队列,验证发生风险。
那你的本地数据库,就要围绕这个主线来收集。基于 NHANES 和 CHARLS 已经做好的内容,再来建本地库,这是最快捷的路径。
根据文献里出现的变量,直接把变量名复制过来,照着录就行。
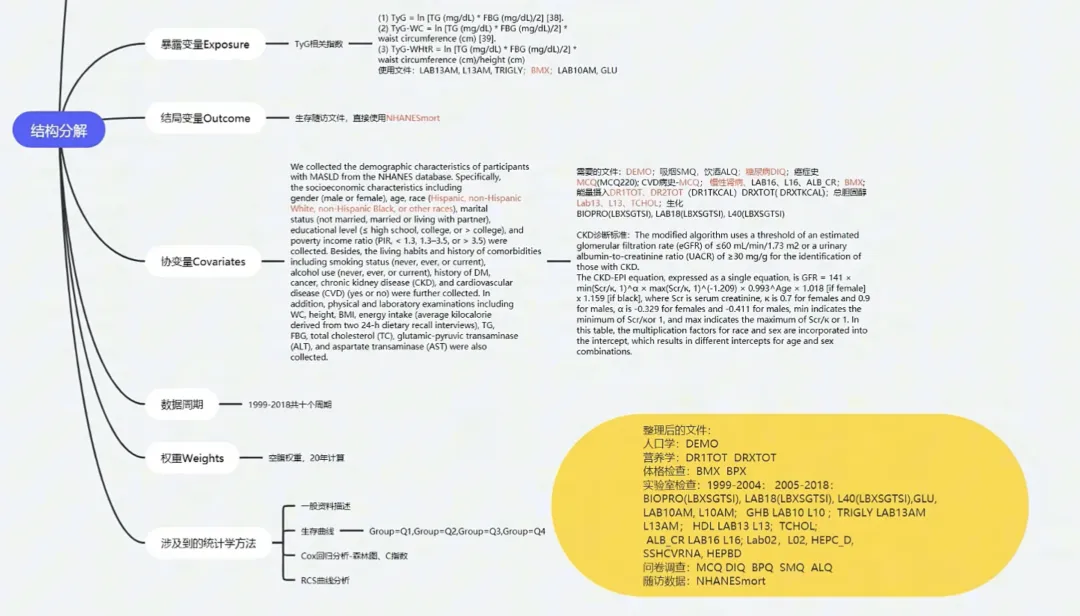
常见的变量清单我列一下:性别、年龄、种族、教育水平、婚姻状况、BMI、腰围、高血压、糖尿病、空腹血糖、甘油三酯、ALT、AST、白蛋白、心血管疾病史、癌症病史、饮酒、吸烟、肝病史、CRP 等。
TYG 不是直接录的,要用甘油三酯和葡萄糖计算。单位要注意,甘油三酯和葡萄糖一般用毫摩尔每升,但算 TYG 的时候要用毫克每分升。
种族在中国人里不用搞太复杂,直接写「是否汉族」就行。家庭收入水平很难从病历系统里拿到,建议不要录。婚姻状态可以简化成三类:未婚、已婚或同居、离异或丧偶。
录多少例?
一般至少 200 例左右。按一个科室 50 张床位算,两个月出院的病人大概 300 例,去掉 TYG 缺失、结局缺失的,剩下 200 例左右,就够用了。最好是连续性收集,比如从 2021 年 1 月 1 日收到 2026 年 2 月 28 日,整月收集,不要挑挑拣拣。
第一种录入方式:Excel——最原始,也最可靠
Excel 是最直接的方法。找个安静的办公室,打开两个屏幕,一边是病历系统,一边是 Excel,一个一个录。住院号、姓名都写上,自己录的不怕泄露信息,将来有问题还能溯源。我自己以前也有几千例数据,很多都是我自己录的,带着学生录,还要检查录得对不对。自己录最可靠。
缺点是变量多了容易出错,身份证号这种长数字还可能乱码,因为 Excel 不能识别那么长的数字,尾数可能变成零。但 100 到 200 例,问题不大。
我算过一笔账:27 个变量,一个病例 15 分钟左右,每天晚上花一个小时,录 5 例,40 天就能录完 200 例。如果你还想深挖,将来这个数据库可以反复用来验证不同的 idea,那我建议你多录点变量,比如用药情况、抗板药、抗凝药、护脑护胃的药,甚至保健品、维生素 D 的使用,一次性录好,后面就不用反复返工。
第二种录入方式:EpiData——流行病学领域的经典录入软件
EpiData 是免费的数据录入软件,中文版叫「临床数据录入神器」,官网可以下载绿色版、和谐版。流行病学领域用得比较多,我当年做大型临床流行病学调查的时候,用的就是这个。
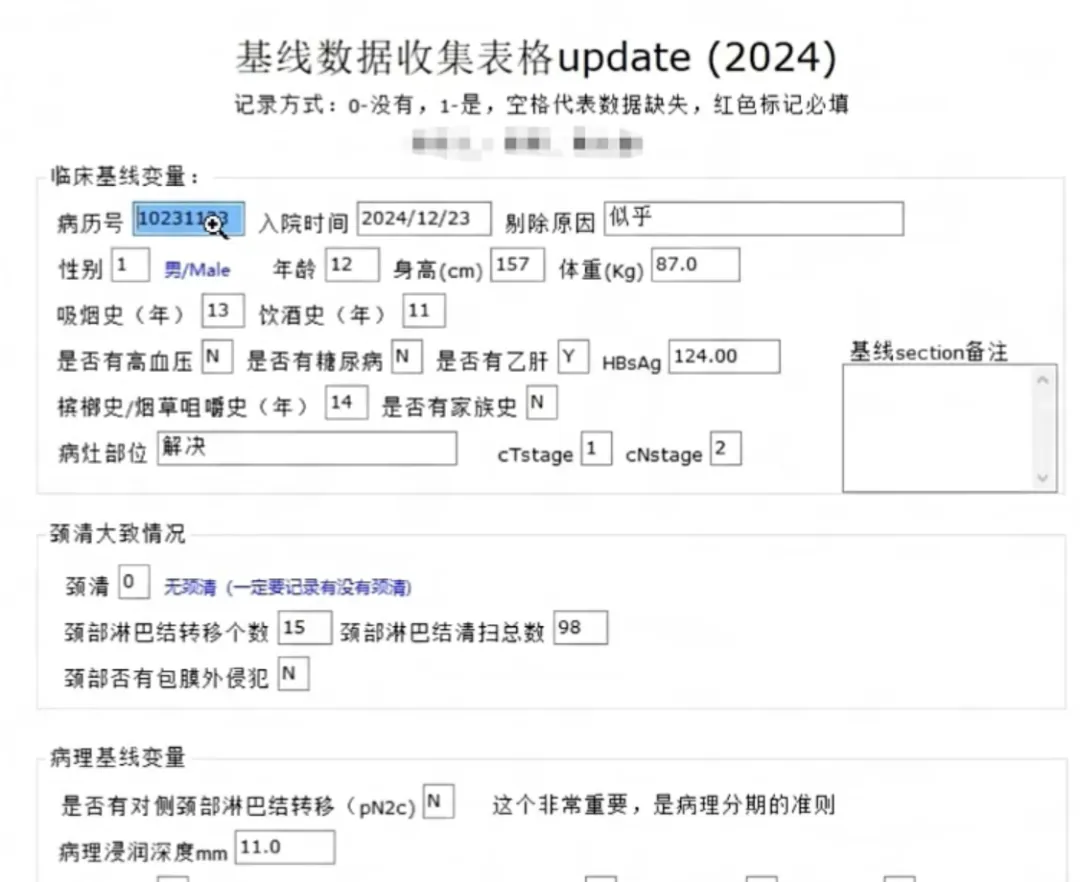
具体怎么用?先在 EpiData Manager 里新建一个项目,然后添加数据表,编辑你要录的字段。字段可以设置类型和录入规则,比如时间字段必须录时间,不是时间就报错,无法进入下一步。分类变量可以设置编码,比如 1 是男、2 是女,录入时直接敲数字,方便后续统计软件识别。设置好之后,录入界面就是一个空格一个空格地敲,敲完第一个回车,自动进入第二个空,再回车进入第三个,最后一个空格录完回车,自动进入下一例。特别适合变量多、需要规范录入的研究。
EpiData 的好处是:可以详细备注每个编码是什么意思,可以设置必填项和跳转逻辑,减少录入错误。录完可以导出 Excel,然后清洗分析。网上有详细的使用教程,先下载软件,在 Manager 里新建项目,把要录的变量一条一条录进去,很快就能上手。
如果你想系统学习本地数据库的建立、验证和文章写作,科研会员里有完整路径。别等到别人都发了,你还在犹豫。如果你希望有系统课程,从选题到成稿跑完整个链条,欢迎加入我们的科研会员。
零基础选科研会员带你发第一篇 SCI
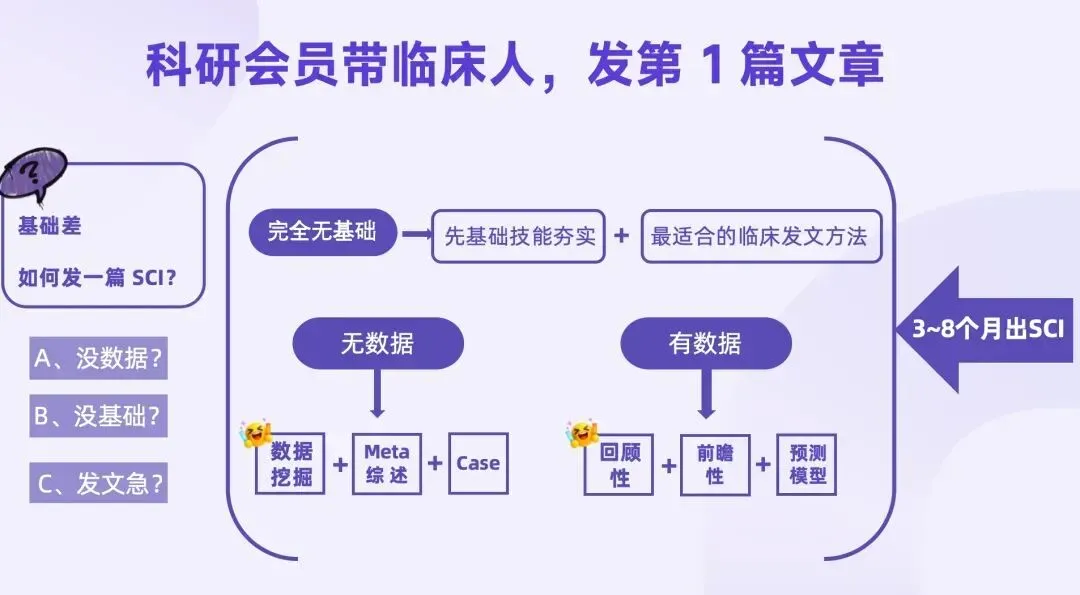
科研会员每年更新,目的是把更优质的临床科研课程带给大家,如果 2025 年想发 SCI,你是 ——
- 0 基础想发第 1 篇
- 🈶️数据不知道怎么发文章
- 🈚️数据想做数据挖掘
- 想发高分临床模型
1 个科研会员就够啦~
现在加入科研会员,你的第一篇 SCI 近在眼前!