ARTICLE · 1137664
OpenAI开源前沿模型数学结果AI做科研,从”答题“变成“交论文”
发生了什么:一个开源仓库,一次发布治理
不是又一篇「模型屠榜」通稿,而是一批可打开、可质疑、可形式化的研究产物。
OpenAI 公开了仓库 github.com/openai/math(2026 年 10 月 6 日创建,Apache-2.0)。仓库里不是 benchmark 榜单,而是由内部前沿模型产出的数学手稿及配套证明材料。
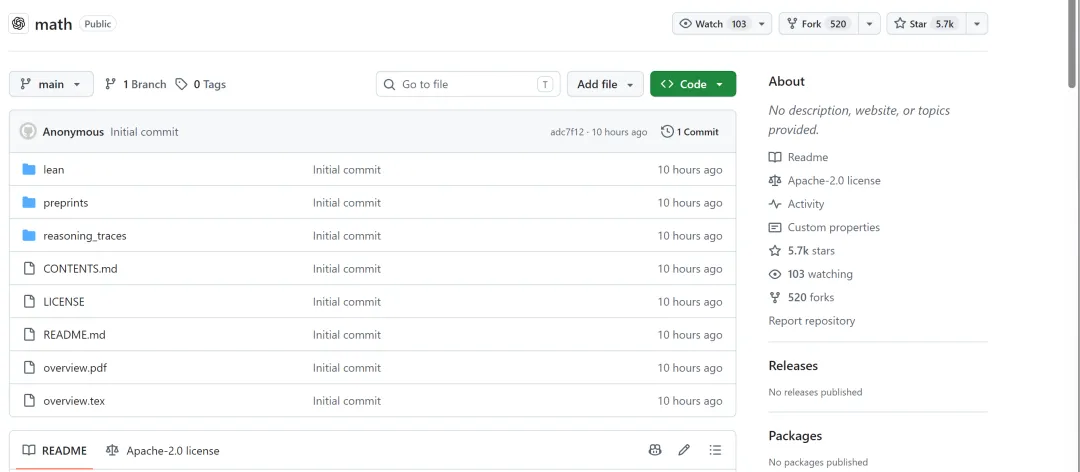
更值得注意的是发布方式:OpenAI 表示,在公开前咨询了高等研究院(Institute for Advanced Study)数学与人工智能独立顾问小组,并参考该小组建议与公开推荐来决定如何发布。Greg Brockman 转发此事时称,这朝「加速科学发现、改善每个人生活质量」的方向迈进了一步。
读这类新闻,我习惯先问三件事:交付物是什么?验收机制是什么?发布者自己承认了哪些风险?这次三问都有答案——这比「AI 解决了世纪难题」的标题党重要得多。
这次真正的新东西,不是模型又多聪明,而是AI 科研产物第一次按公开仓库的标准被交出来。
仓库里到底有什么:722 篇手稿,不是 722 个「已证定理」
标题很炸,状态标签更关键:验证阶段不同,可信度就不同。
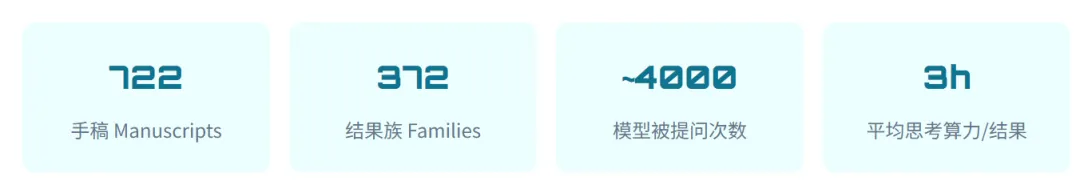
按仓库 README 与内容索引:当前目录包含 722 篇手稿,按主题归入 372 个结果族。同一族里可能有主结果、配套论证、推论或替代证明,按数学分支分类。
抽样看族标题,冲击力很强:涉及 Milne 有理化猜想、BSD 公式、Catalan 常数无理性、π 的无理性指数、Kaplansky 猜想、自由群因子同构、相对论 Vlasov–Maxwell 等。仓库还公开了 10 个结果族的模型推理摘要(reasoning summaries)。
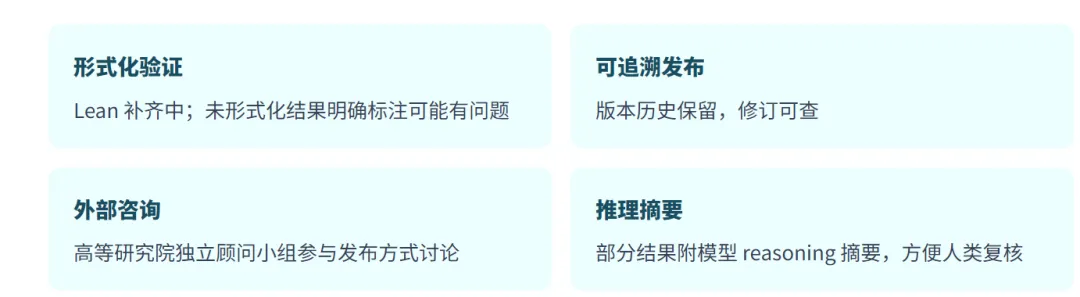
但同一份 README 写得很克制:并非所有结果都附带 Lean 形式化;形式化会陆续补齐;部分尚未形式化的结果可能存在问题,团队称会尽快修正;也正在探索社区托管这些材料的方式。
读标题时的冷静开关
仓库出现「π 的无理性指数」「BSD 公式」这类字眼,不等于社区已承认对应猜想被彻底解决。OpenAI 自己就把「验证完成度」写在了发布说明里。把「仓库收录」与「学界确认」划等号,是最容易踩的坑。
怎么产出来的:约 4000 题,平均三小时思考
不是突然「开窍」,而是评测饱和之后,把开放研究问题当成新的评价场。
仓库说明写得直接:随着现有数学评测接近饱和,团队把模型开发中的评测扩展到开放研究问题。绝大多数结果出自同一套流程,使用的是尚未发布的内部 OpenAI 模型。
两个数字最值得记住:
评测过程中,模型被提出的问题大约 4000 个; 平均每个结果,使用了约 3 小时的 ChatGPT Pro 思考算力(thinking compute)。
团队把输出聚合成结果族与手稿,并要求结果达到适当的显著性门槛,才进入当前目录。少数例外单独说明:黎曼 ζ 函数零点区域相关工作,以及关于 CM 阿贝尔簇 Hodge 猜想的证明路径;其中 ζ 函数 Re(s) > 11/12 零点区域的文稿,还做过人工可读性编辑。
所以「AI 做数学」在这批材料里的真实形态是:长时思考 + 开放问题 + 后续聚合与验证,而不是一次性输出一篇完美论文。这对做 AI 产品的人更重要——能力叙事背后,永远要拆开评测场景和算力预算。
评测饱和之后,下一个战场不再是选择题,而是「开放问题 + 可验收的交付物」。
信任机制在哪:Lean、版本记录、顾问小组
科学发布的核心不是声量,是可复核路径。
OpenAI 没有只发 PDF 吸引眼球,而是把「可被检查」写进仓库结构:overview、手稿地图、preprints 源文件与引用说明、Lean 库与形式化目录,以及 comparator 检查指令。未完成形式化的部分也照实说,并承诺持续更新。
版本策略同样重要:公开发布历史会保留,更正与修订以新版本记录,旧版本仍可访问。这更接近学术出版,而不是产品发布——允许改,但不允许悄悄改。
再叠加外部顾问角色:发布前咨询高等研究院数学与人工智能独立顾问小组,并参考建议与公开推荐决定发布方式。这传递的信号是:前沿模型开始触碰「科学可信度治理」,而不是只优化模型能力。
Greg Brockman 说的是愿景:加速发现,不是取代数学家
官方叙事偏未来;仓库 README 偏工程诚实——两者要一起读。
Greg Brockman 转发时,把这件事放进「加速科学发现、改善每个人生活质量」的长期叙事里。这是典型的产品方表述:强调方向与杠杆效应。
仓库 README 则更像工程日志:承认验证分级、承认部分结果可能有问题、承诺补齐 Lean 与修正。把两段合在一起看,信息才完整:模型在开放问题上已具备「产生可讨论研究产物」的生产力;是否构成科学事实,仍取决于验证链路与学界审查。
对普通读者,这反而是好消息:你不必在「吹神迹」和「全是假的」之间二选一。正确姿势是——先看交付物,再看验证,再看叙事。
愿景负责吸引注意力,仓库负责经得起挑剔。只看转发,会高估;只看 README,会低估。
对行业意味着什么:AI 科学发现进入「发布治理」阶段
能力已经外溢到开放研究;下一步拼的是验证、声誉与协作。
过去两年,AI + 科学更常见的是「辅助写代码、辅助做实验、辅助检索文献」。这次发布把讨论推进了一步:模型开始批量产出接近研究论文形态的材料,而且以公开仓库方式进入可批评范围。
这会倒逼三件事:
- 验证基建升值
:Lean、自动检查、形式化目录从边缘工具变成发布要件; - 发布协议出现
:什么时候放模型结果、要不要外部顾问、如何标注未验证部分,会逐渐形成惯例; - 人机分工重画
:模型擅长长时搜索与构造候选论证,人类更擅长定义问题、仲裁标准与发现盲点。
也有明显风险:若社会只传播「标题级成果」,忽视验证状态,科学传播会再次被流量逻辑劫持。OpenAI 自己把风险写进 README,社会传播侧也应跟上同等诚实。
普通人怎么读 AI 数学新闻:四步判断法
下次再看到「AI 解决 X 猜想」,用这四步,几乎不会被带偏。
第一步,找交付物。有没有仓库、PDF、Lean、可引用材料?只有通稿、没有可打开文件,先降低信任。
第二步,看验证等级。手稿、预印本、形式化学术证明、学界接受,是四个不同等级。这次仓库明确处于「手稿 + 部分形式化」区间。
第三步,读发布者自己的免责声明。比第三方吹捧更可信的,往往是作者写的「可能有问题」「正在补 Lean」。
第四步,分清能力与结论。「模型能产出大量候选研究材料」是能力事实;「某猜想已被数学界确认解决」是科学结论。两者不能偷换。
一句话版
这次发布的最大增量,不是「AI 已经是数学家」,而是「AI 的数学产出开始按可复核的科学资产被管理」。
写在最后:加速发现,也加速责任
当模型交出论文形态的东西,发布方式就是科学的一部分。
OpenAI 这次把前沿模型的数学结果放进公开仓库,并引入外部顾问讨论发布方式,说明行业已经意识到:AI 进入开放研究,意味着新的责任结构——不是少发布,而是把不确定性一并公开。
如果你是研究者,值得打开仓库看 Lean 与手稿结构;如果你是产品人,值得研究「饱和评测之后如何设计新场景」;如果你只是吃瓜,请记住那句朴素判断:能一起公开的,不等于已经对齐到学界共识——先看验证,再看标题。
科学发现被加速的前提,是信任机制也被加速。