ARTICLE · 1143172
AI Agent 地理空间工作流插件EasyGEE深度实测:从朝阳公园 NDVI 到宁波“烟花”洪涝分析
这次体验了一下EasyGEE,从具体问题开始的。先安装插件、配置 Earth Engine,再打开地图查看北京朝阳公园,预览 2024 年夏季 NDVI;随后把任务推进到宁波市台风“烟花”期间的洪涝分析。
EasyGEE 的价值,在于把自然语言需求、地理数据、处理脚本和地图检查连接起来。 一个需求可以逐步落成数据选择理由、可运行代码、图层、面积表和 GIS 文件,分析过程中发现的问题也能继续追查。
本文以本次实际使用的 0.4.1 版为基础,结合项目公开文档介绍功能。图 1、图 2 为概念示意;图 3—图 6 使用真实遥感数据或已保存的计算成果绘制。具体分析脚本包含 Agent 按任务编写的部分。
图 1|EasyGEE 功能概览。此图为项目能力示意,不代表真实遥感观测或实际软件界面。
EasyGEE 是什么
EasyGEE (https://github.com/Rimagination/easygee)是面向 AI Agent 的地理空间工作流插件,项目提供 Codex、Claude 插件入口。它把 Earth Engine 与 geemap 的使用方法、数据目录工具、本地地图工作台,以及 GIS 和遥感方法资料组织在一起,让 Agent 可以根据任务选工具、写代码、调用计算并检查结果。
可以把它理解为三个相互配合的部分:方法知识告诉 Agent 应该考虑什么,工具提供稳定的查询与操作入口,地图和输出文件让人看见并核对结果。 真正的计算仍由 Earth Engine 云端或本地 Python/GIS 环境承担。
对遥感学习者,它降低了从问题到第一份可运行流程的门槛;对已经会写 GEE 的用户,它有助于整理数据核验、参数检查、批量计算和成果交付这些重复工作。
从安装和授权开始
第一条需求很直接:
“帮我安装这个插件。”随后是“打开 EasyGEE 地图工作台”和“帮我完成配置与授权”。这一步涉及的事情比安装一个 Python 包多:插件需要被宿主识别,Python 需要能使用 Earth Engine 和 geemap,还要选对 Cloud 项目,并确认账号授权后能够初始化。
EasyGEE 提供环境检查和授权引导。实际操作时,应使用项目 ID,而不是只凭控制台里的显示名称判断项目。OAuth 凭据由本地授权流程管理,验证码、令牌和凭据文件不需要贴到聊天里。
我也遇到过“localhost 拒绝连接”。它提醒我,本地地图页面依赖一个正在运行的服务。排查时要分清:是本地服务或端口出了问题,还是 Earth Engine 授权、网络或影像瓦片加载出了问题。几类故障表面上都可能是“地图看不到”,处理方式却不同。
功能一 把数据选择变成可解释的过程
做遥感分析,最容易被忽略的工作之一就是选数据。名字相似的产品,可能具有不同的时间覆盖、处理级别、波段和单位;能搜到的 ID,也未必就是当前适用的资产。
EasyGEE 提供 5,000 多条官方与社区目录记录的检索入口,可以按 ID、产品名称、中英文主题或任务查找,并结合来源、弃用状态和匹配证据筛选。这里的数量是目录记录规模,不表示全部都是官方产品,也不保证每个记录都已完成实时可用性检查。
我的 DEM 需求就很适合这套流程:先限定“官方、未弃用”,再比较产品,最后核验准备写入代码的 ID。这样,产品比较可以落到分辨率、覆盖、数据类型和适用性,而不只是列出几个名字。
如果问题是“山区洪水风险应该用什么数据”,它还能按角色组织候选:灾情观测、历史水体基线、地形、降雨,以及人口或建筑暴露。推荐一组数据,是分析设计的起点;最终仍要结合区域、事件和目标核验。
数据检索与核验说明:https://github.com/Rimagination/easygee/blob/main/skills/easygee/references/dataset-discovery.md
功能二 在地图上选区 叠加和检查
地图工作台是这次体验里最直观的入口。AOI 指感兴趣区域,也就是后续筛选影像、计算指标和导出的空间范围。
围绕北京朝阳公园,我实际获得了 Sentinel-2 真彩色、夏季 NDVI、有效观测天数和单景影像等预览图层。切换图层,可以同时检查“植被指数看起来如何”和“这块结果背后到底有没有足够观测”。
工作台支持绘制 AOI、控制图层可见性和透明度、调整图层顺序,并保存部分本地会话状态。项目还提供 XYZ/TMS、ArcGIS、WMS/WMTS、栅格 PMTiles 和 COG 等地图数据接入能力。具体服务是否可用,仍取决于地址、网络、访问条件和所需密钥。
地图工作台说明:https://github.com/Rimagination/easygee/blob/main/skills/easygee/references/browser-preview.md
本次朝阳公园预览使用的是临时范围,当时尚未最终确认手绘 AOI。开展正式区域统计和导出之前,还需要确定研究边界。
功能三 按任务选择云端计算或本地 GIS
有了数据和区域,下一步是决定在哪里处理。
对大范围遥感影像筛选、去云、指数计算、时间合成和区域统计,Earth Engine 适合承担主要计算。对本地 GeoJSON 检查、坐标转换、精确文件处理、矢量化和复杂后处理,本地 GIS 工具往往更直接。两者也可以组合:云端生成中间结果,本地统计、制图并核对文件。
EasyGEE 的方法路由区分这些场景,内置 GeoMaster 资料帮助 Agent 处理坐标系、栅格与矢量、空间分析和格式转换。geemap 则为 GEE 的 Python 交互、地图探索和数据交接提供支持。
方法路由说明:https://github.com/Rimagination/easygee/blob/main/skills/easygee/references/geomaster-integration.md
我提出“有一个本地 GeoJSON,应该用 GEE 还是本地 GIS”时,实际文件还没有提供,得到的是可运行的检查与重投影脚本。等实际文件提供后,还需检查其坐标系、几何有效性和空间范围,再执行处理。
功能四 把配额和导出参数放进工作流
“能运行”之后,还要考虑“能否在当前资源条件下完成”。
EasyGEE 提供 Earth Engine 项目配额与用量查询工具,帮助区分项目层级、配额限制和可见用量。有些值需要相应权限或监控接口才能读取;读取不到时,不应把未知数写成零。我的体验中形成过一份项目用量报告,但它只是查询时点的快照,不能当作今天的剩余额度。
配额查询说明:https://github.com/Rimagination/easygee/blob/main/skills/easygee/references/quota-monitoring.md
成果导出也需要把参数讲清楚:输出范围是哪一个 AOI,像元大小是多少,投影采用什么,选择哪些波段,保存为栅格还是表格,以及发送到哪里。项目资料覆盖 Google Drive、Cloud Storage、Earth Engine Asset 和本地文件等交付路径,实际调用取决于任务和授权条件。
导出模式说明:https://github.com/Rimagination/easygee/blob/main/skills/easygee/references/export-patterns.md
本次北京 NDVI 的 Drive 导出因为最终 AOI 尚未确定,没有提交。后面的宁波分析则实际交付了本地 GeoTIFF、GeoPackage、CSV、图件和脚本。
还有一个容易混淆的地方:Agent 账户额度与 Earth Engine 项目配额是两套资源。 聊天可以继续,并不意味着云端计算配额随之增加。
功能五 为遥感 AI 提供方法入口
除了常规遥感处理,EasyGEE 还整理了 GeoAI 方法参考,覆盖识别、目标检测、语义与实例分割、变化检测、像素回归,以及 SAM、卫星嵌入和视觉语言模型等方向。相关资料会把数据准备、训练或推理、空间评估和地理坐标输出联系起来。
项目也提供多模态地理矢量化相关技能,用于把影像标注组织成带坐标参考的 GeoJSON 或 GeoPackage。中文案例资料则可以帮助寻找指数、时序、水体和分类任务的思路。
GeoAI 方法入口:https://github.com/Rimagination/easygee/blob/main/skills/easygee/references/geoai-encyclopedia.md
这部分更适合理解为可供 Agent 调用的方法知识与工作流程。具体模型、权重、运行环境、训练数据和精度评估,仍要按任务配置。本文的宁波案例使用基于规则的遥感判别,没有开展模型训练。
一张图看懂项目架构
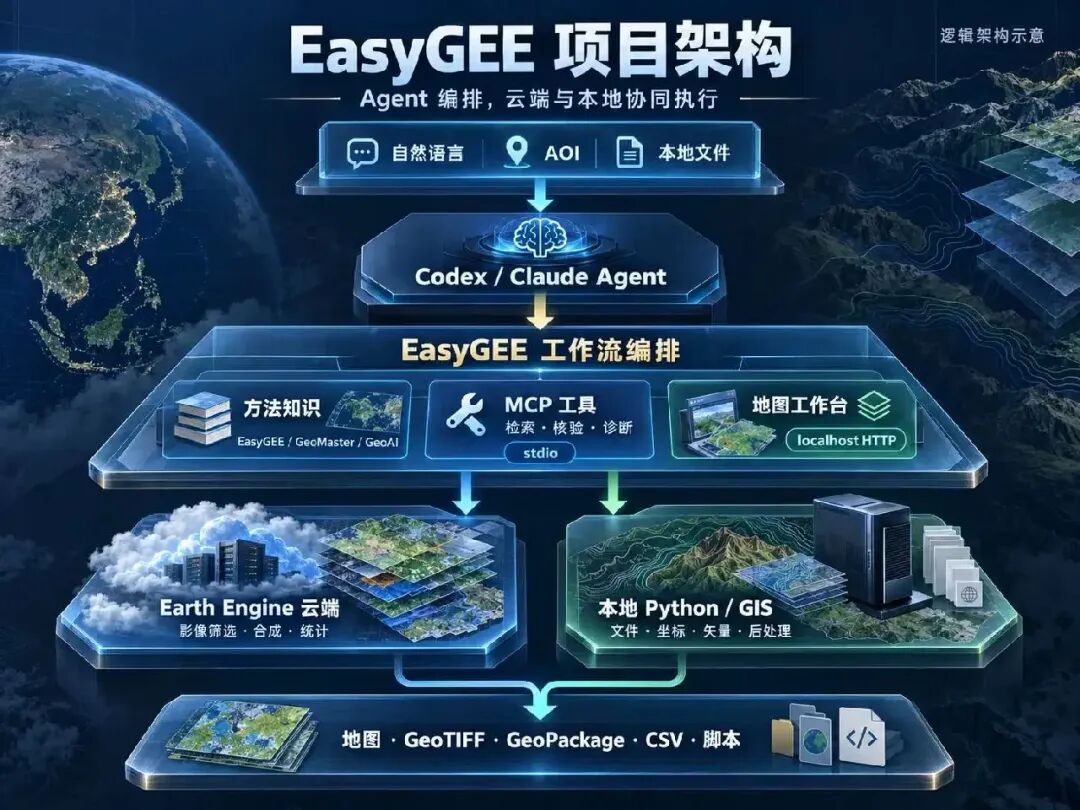
图 2|EasyGEE 工作流架构示意。展示宿主、工具、计算与交付的职责关系,不是实际软件界面或遥感观测结果。
架构图把不同职责分开:宿主 Agent 负责理解和组织任务;本地 MCP 工具提供目录、环境、配额等能力入口;Python 脚本再连接 Earth Engine 或本地 GIS 库执行具体处理。
地图工作台通过本地 HTTP 服务运行,接收 AOI、图层和会话操作;Agent 与 MCP 服务之间使用的 stdio 是另一条通信通道。浏览器显示结果,与后端真正完成计算,是两个需要分别验证的环节。
这也解释了宁波案例为什么可以在在线瓦片不稳定时,改用已完成的本地矢量结果继续检查。插件提供了工作流基础,本次分块下载、面积汇总以及地图矢量样式补充,则由 Agent 围绕任务实现,不能都当作默认的一键洪水分析功能。
实例一 北京朝阳公园:把夏季 NDVI 和原始观测放在一起看
我最初的需求是:
“打开地图工作台,先看看北京朝阳公园附近,再手动画一个 AOI。”随后,我希望分析这里 **2024 年夏季的 NDVI**,并在浏览器里叠加 Sentinel-2 真彩色,检查云和植被情况。这一步实际形成了真彩色、夏季 NDVI、有效观测天数和单景影像等图层。下面的图沿用当时的预览范围和处理方法,从真实 Earth Engine 数据重新取数制图,方便放进公众号。它是原流程的结果重绘,不是当时浏览器界面的截图。
为什么选这组数据
主体数据采用 Sentinel-2 地表反射率协调集合COPERNICUS/S2_SR_HARMONIZED,配合 GOOGLE/CLOUD_SCORE_PLUS/V1/S2_HARMONIZED 提供的 Cloud Score+ 质量信息。
选择它的理由很具体:朝阳公园及周边绿地属于城市尺度目标;计算 NDVI 用到的红光 B4 和近红外 B8 都有 10 米波段,能够表达较细的绿地、水面和建设用地差异。地表反射率产品也适合跨日期进行植被指数比较。Cloud Score+ 则为像元级去云提供辅助,避免只凭“整景云量不高”就接受局部有云的像元。
时间范围是 2024 年 6 月 1 日至 8 月 31 日;脚本的结束日期写作 9 月 1 日,因为 GEE 日期过滤的右端点不包含在内。当时的检索记录得到 24 景、24 个获取日期,但每个像元通过云筛选的有效天数并不相同。
从影像到三个互相参照的结果
处理先去除不满足云质量阈值的像元,并结合 SCL 排除云、阴影、雪等类别。Cloud Score+ 的 cs_cdf 阈值设为 0.60。对保留的像元,用近红外与红光计算:
NDVI =(B8 − B4)/(B8 + B4)
同一天的影像先拼接,再对各日期的 NDVI 取中位数,得到夏季合成结果。真彩色用 B4、B3、B2 分别进行季节中位数合成;“有效观测天数”则记录每个位置有多少天的数据参与 NDVI 计算。
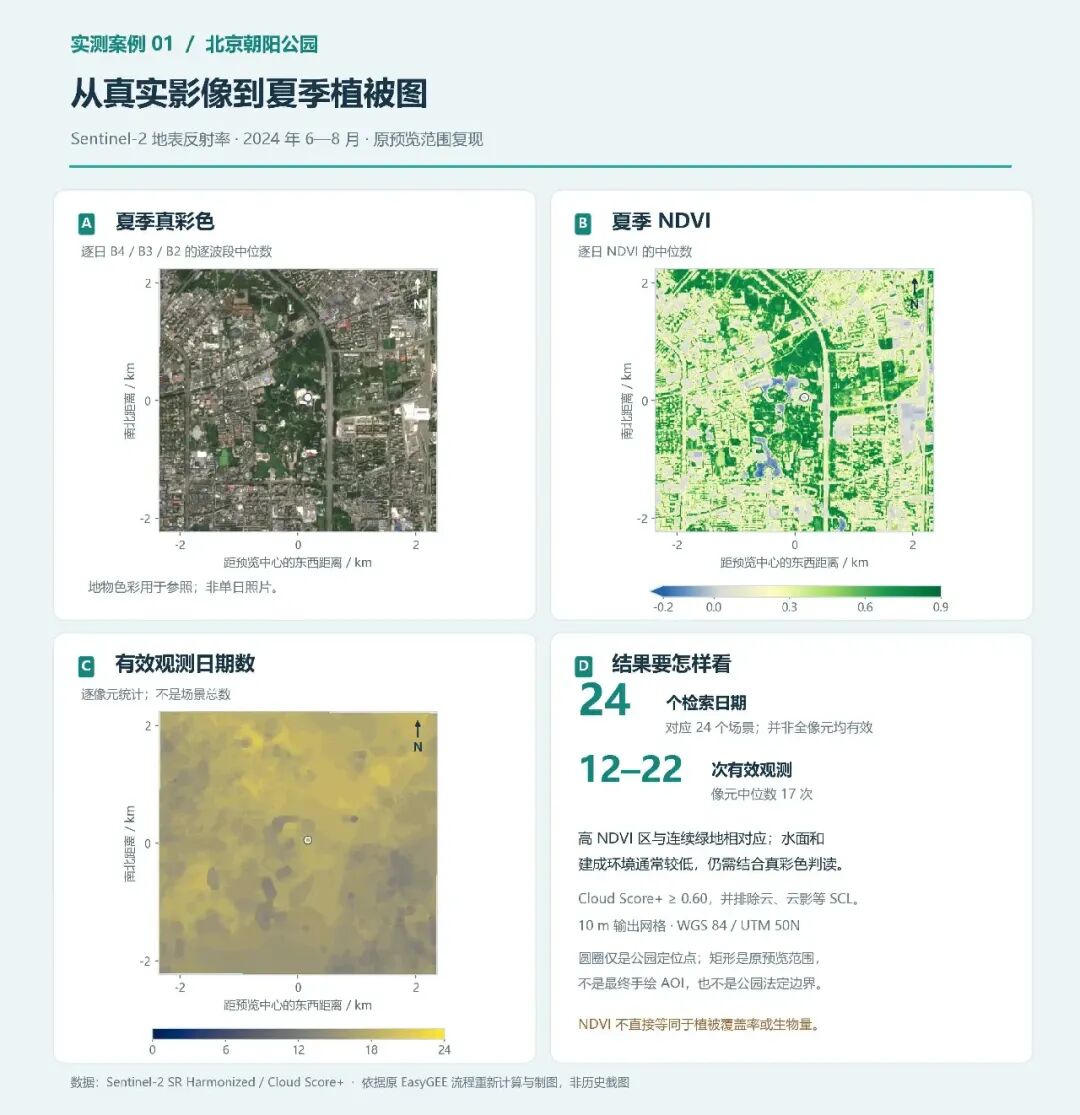
图 3|北京朝阳公园及周边,2024 年夏季真实影像处理结果。沿用原脚本的临时预览范围重新取数制图;真彩色是季节合成,有效观测天数是逐像元统计。图中范围不是已经确认的公园边界或最终手绘 AOI。
读这张图时,我会先在真彩色里认出绿地、水面和周边建筑,再对照 NDVI 的空间分布。较高的 NDVI 通常与植被较丰富的区域对应,但它不能直接换算成绿化覆盖率或生物量。中位数描述的是这一时段观测中的典型状态,也不会保留每一次短期变化。
第三个面板很关键。这次按原流程复现后,仍检索到 24 个日期;预览范围内,有效像元实际由 12—22 次有效观测支撑,像元有效次数的中位数为 17 次。这些统计描述的是整个预览矩形,不是单独针对公园边界的统计。
同样一块绿色,如果只依赖少数几个有效日期,解释时就需要更谨慎。 有效天数图能帮助判断结果是不是由很少的观测支撑;缺测位置也不能被当成 NDVI 为零。这比只输出一张颜色漂亮的指数图多了一层可检查的依据。
本次还准备了 10 米、UTM 50N(EPSG:32650)、Float32、NoData 为 −9999 的 NDVI 导出方案,以及 COG 格式和 Google Drive 导出脚本。由于当时没有最终确认手绘 AOI,Drive 任务尚未提交。因此,这里展示的是已计算的预览成果,不编造公园整体 NDVI 均值,也不展示不存在的导出成功记录。
实例二 宁波“烟花”洪涝:从一句需求到最大观测候选范围
接下来的任务复杂了很多:
使用 Sentinel-1 和 Sentinel-2,完成宁波市台风烟花期间的洪涝淹没分析,计算最大淹没范围。这个案例更能体现 EasyGEE 如何参与完整工作流:明确范围和时间、检查影像库存、安排不同数据的角色、执行云端计算,再把结果下载到本地统计、制图和复核。
第一步:先约定“最大范围”怎样计算
本次采用宁波市 10 个区县组成的研究范围,设置了三个时间窗口,日期均按北京时间解释。
这里的“最大观测范围”,指各次可用观测中被识别为候选淹没的像元,取空间并集。同一地点即便多次被识别,也只计一次。
它表达的是“这些日期里,卫星曾经看见哪些位置出现候选积水”,不是某一个时刻全市同时被淹的面积。卫星过境之间的短暂洪峰也可能漏掉,因此不能把结果直接当作真实洪水峰值。
第二步:先看卫星实际拍到了什么
Sentinel-1 雷达能够在多云条件下提供观测,是这次主期分析的主要来源;Sentinel-2 提供地表反射率、水体指数和灾前状态信息。DEM 用于坡度筛选,历史水体产品用来减少把原有河湖误判为新增积水。
具体使用了 COPERNICUS/S1_GRD、COPERNICUS/S2_SR_HARMONIZED 和 Cloud Score+,并辅以 JRC/GSW1_4/YearlyHistory、ESA/WorldCover/v100 以及本次运行时核验的 COPERNICUS/DEM/GLO30_2024_1。这些数据各有职责,不能互相替代。
影像库存检查带来了一个直接影响算法的发现:7 月 23 日和 24 日的 Sentinel-1 升轨影像能够匹配同轨灾前参考,7 月 25 日和 26 日的降轨影像却缺少对应参考。
于是,流程把两类证据分开处理:
同轨变化候选,简称“核心”:同方向、同相对轨道的灾前与灾后雷达对比,要求灾后出现暗水特征,并且相对灾前明显下降。这里的“核心”是方法分类名称,不代表已经过地面验证。 补充疑似候选:对于缺少同轨雷达基线的观测,结合灾前光学的干地证据与灾后雷达暗水特征筛查,单独保留,不与同轨变化证据混写。
Sentinel-2 在主期有 7 月 22、24、27 日的影像,但受到明显云遮挡。完成去云、灾前观测次数等全部筛选后,主期有效区域的并集仅 37.98 km²,没有检出满足本流程条件的新增水面。这个“零”表示没有得到合格的光学新增水体检测,不能解释为宁波没有洪水。
因此,这次也不能写成“Sentinel-1 和 Sentinel-2 共同确认了主期淹没范围”。Sentinel-2 实际主要支持了灾前基线和后续退水期分析。
第三步:把判别条件变成可复核的参数
整套结果统一到 UTM 51N(EPSG:32651)的 20 米网格。先筛选坡度小于 5° 的区域,并排除历史永久水体以及灾前经常为水体的位置,再开展新增水面识别。
雷达处理还包括在线性功率域建立参考和进行 30 米半径平滑,以减少斑点噪声。以上阈值是本次流程的规则设置,并非对所有地形、城市和洪水事件都适用的通用答案。
这个设计更适合筛查低坡度区域可见的开放水面。建筑物、茂密植被、风浪和稻田管理等,都可能造成漏检或混淆。20 米代表输出像元大小,不等于实际洪水边界具有 20 米精度。
第四步:看主期结果地图,而不只看一个面积
全域 74 个计算分块已完成,随后在本地合并栅格、生成矢量并汇总面积。下图直接使用这次运行保存的分类栅格、质量标记与区县边界重绘。
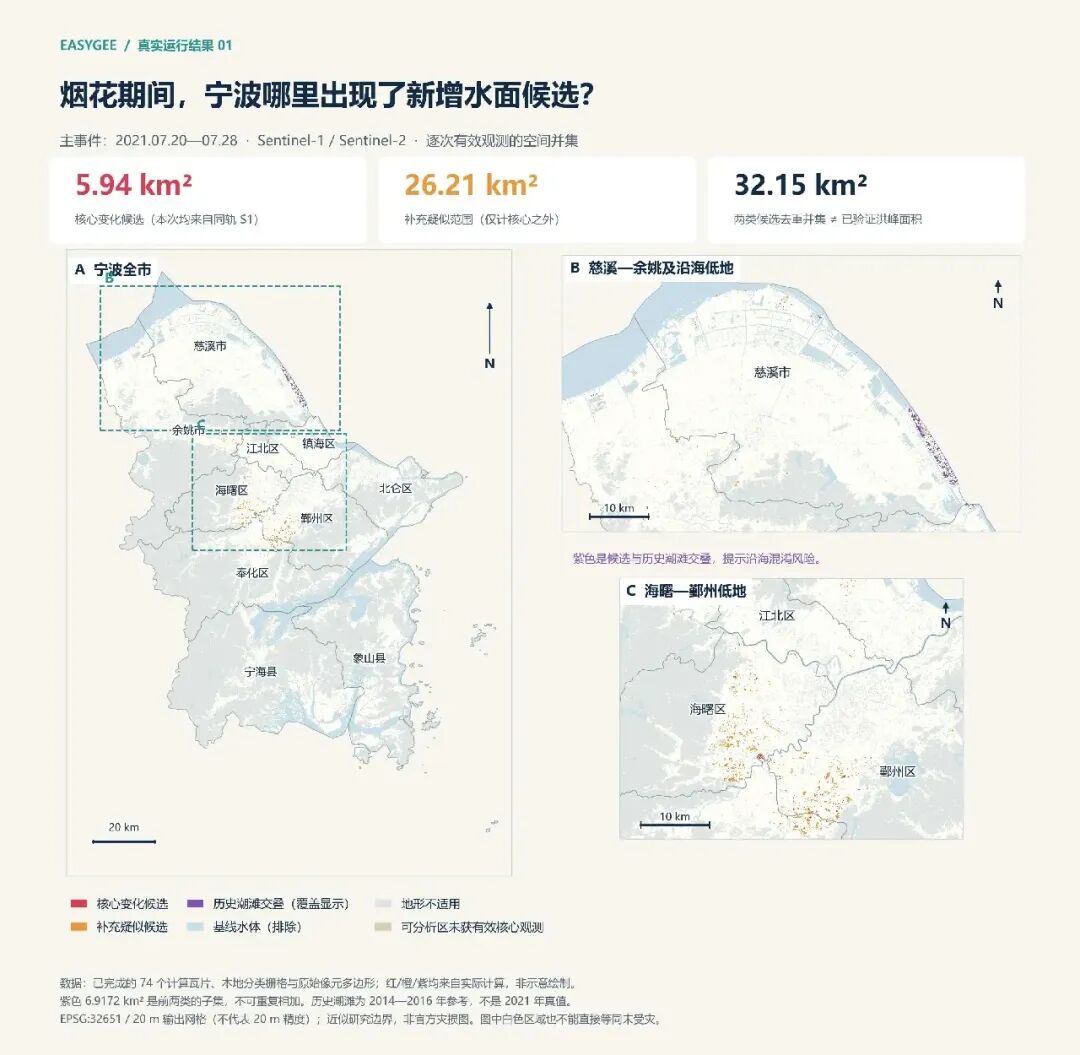
图 4|2021 年 7 月 20—28 日的最大观测淹没候选范围。核心与补充表示两种证据来源;历史潮滩重叠是已有候选的质量提示子集,不能作为第三类面积再相加。底图与边界用于空间定位,不是灾前或灾后真彩色照片。
本次主期结果为:
| 去重后的主期候选并集 | 32.1536 km² |
“核心之外”这个限定很重要。补充方法原本识别了 28.0796 km²,其中 1.8668 km² 与核心相交;去掉重复后,才得到表中的 26.2128 km²。直接把不同图层面积相加,就会把同一片区域重复计算。
地图还能暴露单看数字时不容易发现的问题。与 2014—2016 年历史潮滩资料叠加后,**6.9172 km² 候选落在旧潮滩内,占全部候选的约 21.5%**;其中,核心候选有 3.5832 km² 与旧潮滩相交,占核心的 **60.3%**。
这意味着沿海的雷达变化需要进一步区分潮位、岸线或围垦变化与灾害积水。旧潮滩也不能机械删除,因为到 2021 年土地状态可能已经改变。潮滩之外剩余的 25.2364 km²,同样只是候选,不是经过核验的净洪水面积。
第五步:拆到区县,理解范围分布
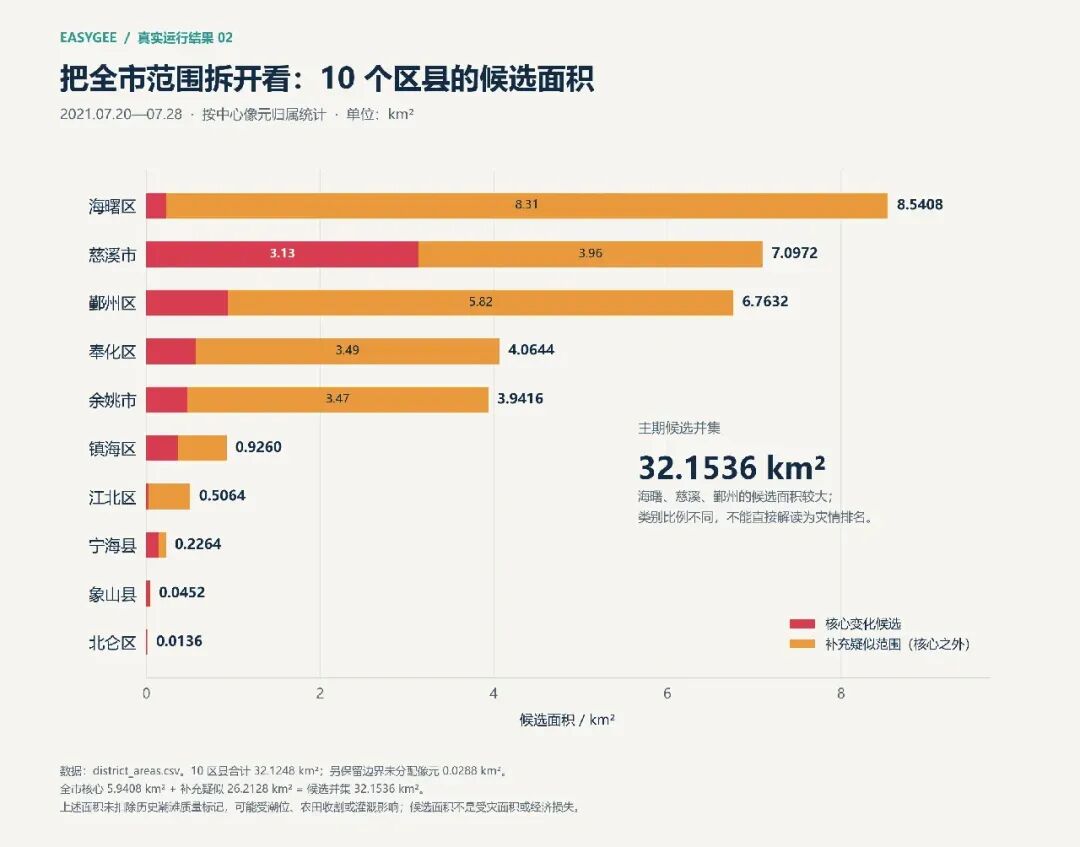
图 5|由本次区县面积表重绘。每个条形拆分同轨变化候选与补充疑似,面积单位为 km²。另有 0.0288 km² 边界像元未归入单一区县,单独保留以便与全域结果核对。
按本次候选并集统计,海曙为 8.5408 km²,慈溪为 7.0972 km²,鄞州为 6.7632 km²,是数值较大的三个区县。但条形内部的构成并不一样:海曙的补充疑似占大部分,慈溪则包含 3.1328 km² 同轨变化候选,需要结合前面的潮滩提示继续核查。
这张图适合回答“下一步优先查看哪些区域、采用了哪些证据”,不能直接回答“哪个区县灾损最重”。不同区县的有效观测、土地类型和可见水面条件并不相同。
与 2020 年 WorldCover 叠加,候选中有 24.3164 km² 落在耕地类,约占 75.6%。它提示后续需要重点辨别农田积水、灌溉和耕作变化,也不等于已经确定了同样面积的农作物受灾。
第六步:把结果放回真实过境日期
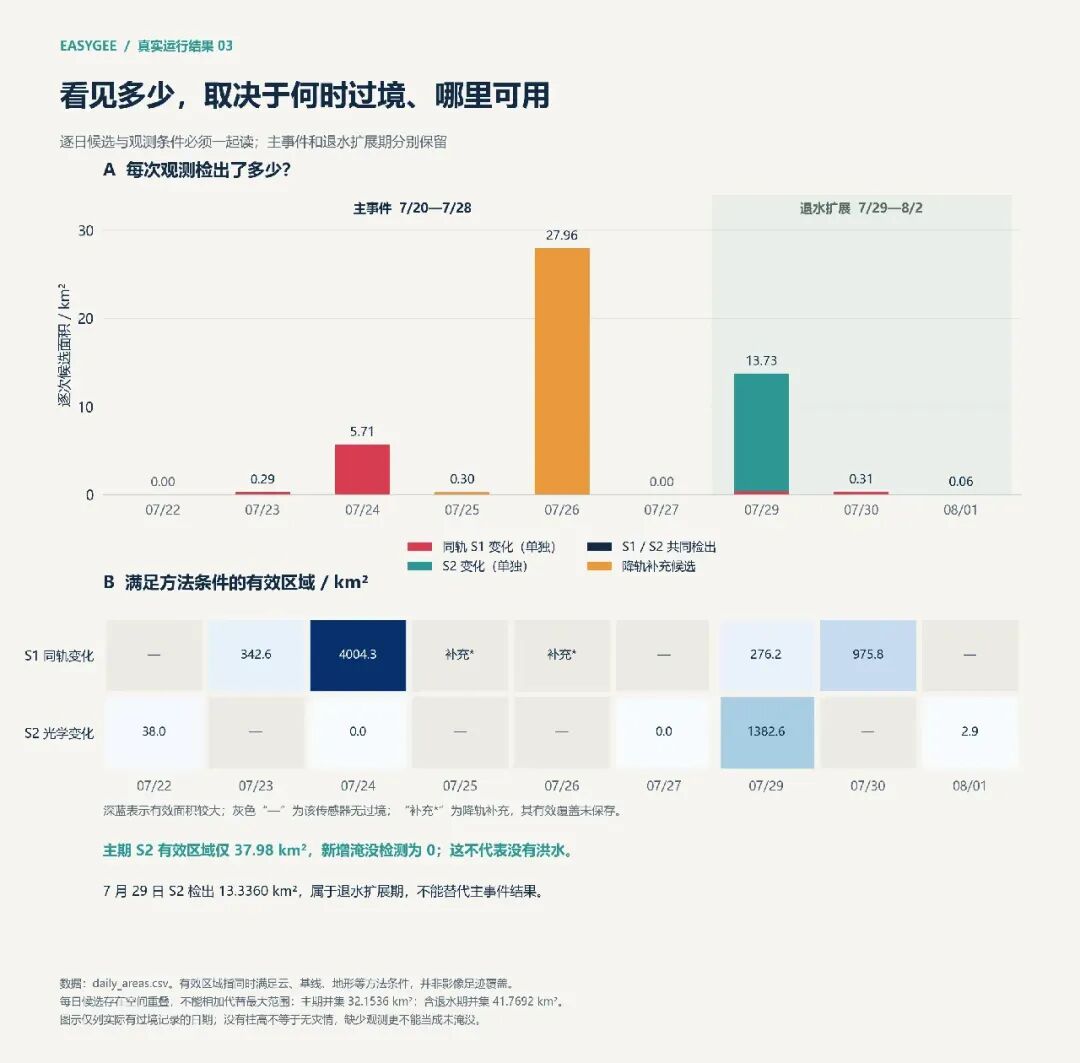
图 6|由实际逐次观测记录重绘。主事件期与退水扩展期分别标注;图中各日数值是不同观测条件下的检测结果,不能当成连续洪水过程线,也不能直接累加为最大范围。
7 月 24 日同轨变化检测为 5.7120 km²;7 月 26 日补充方法检测为 27.9552 km²。两天使用的证据条件不同,不能仅据后者更大,就认定 7 月 26 日是真实洪峰。
7 月 29 日进入退水扩展期,光学条件改善,当日 Sentinel-2 新水面检测为 13.3360 km²。后续光学观测补充了主期受云限制的信息,但不能把后续检出倒推为主期已淹没;后续检出较多,也不自动意味着洪水比主期更严重。
把观测扩展到 8 月 2 日后,候选空间并集变为 41.7692 km²,相比主期新增 9.6156 km²。公众号正文和地图必须保持时间口径一致:主期范围图对应 32.1536 km²,41.7692 km² 对应加入退水观测后的扩展范围。
流程还分别采用严格、中心和宽松判别阈值复算核心候选,得到 2.3848、5.9408、12.8004 km²。变化幅度提醒我们,阈值选择确实影响结果;这些数值是敏感性检查,不是统计置信区间或地面验证精度。
最终交付了什么
这个实例留下的不只有一张展示图,而是一组能够继续检查的成果:
GeoTIFF:20 米网格的主期分类结果,以及质量信息和历史潮滩重叠图层。 GeoPackage:同轨变化候选与补充疑似矢量,可继续在 QGIS 等软件中检查。 CSV:区县面积表、逐次观测面积与有效覆盖记录。 Python 脚本与运行清单:数据来源、时间窗口、处理参数和分块状态。
栅格计数、矢量面积与区县汇总经过一致性检查。但这种检查保证的是文件与统计口径能对上,并不替代真实洪水范围的独立验证。
边界也需要交代:本次使用 DataV 区县边界,并做了近似坐标转换,包含概化的海岸线与水域;它不是专门恢复的 2021 年法定边界。因此,案例适合作为一次有明确来源、参数和质量提示的遥感筛查流程,若要用于正式灾情认定,还需更严格的边界、独立观测和现场资料。
对我来说,这个案例展示了 EasyGEE 更具体的价值:它把数据检索、观测核查、脚本执行、地图检查和文件交付串起来,也让“为什么得出这个范围、哪些地方仍然不确定”成为结果的一部分。
这次体验最值得保留的三个习惯
先核验数据,再生成分析代码。 精确 ID、资产类型、波段、单位、时间范围和 QA 规则,会直接影响结果。目录检索能缩小选择范围,实际任务仍要做最终核验。
把地图当作检查入口。 NDVI、真彩色、有效观测天数可以一起看;洪涝候选则可以分层显示核心变化、补充疑似与潮滩交叠。不同证据分开呈现,解释起来才有依据。
把交付做完整。 一张地图之外,还应留下参数、数据来源、面积表和可运行脚本。出现云遮挡、缺少参考轨道或边界不确定时,也应让这些限制留在报告里。
对我而言,这次体验最有意义的变化是:每一步都可以继续追问,计算结果也有文件和依据可以回头检查。
想上手 可以这样描述需求
第一次使用时,可以把任务写成“区域 + 时间 + 目标 + 交付物 + 检查要求”。例如:
请分析某公园 2024 年夏季的植被状况。先推荐并核验数据,说明去云与合成方法,再把 NDVI、真彩色和有效观测次数放到地图上。等我确认 AOI 后,再确定导出范围。灾害分析则可以写得更具体:
请比较某次洪水前后的水体变化。先检查实际过境日期和灾前参考,分开输出变化证据与补充疑似,统计空间并集,并保留云遮挡和地形限制等质量信息。这样的表达能让 Agent 更早明确研究口径,也能减少“代码运行成功,但结果回答了另一个问题”的情况。
项目地址:Rimagination/easygee:https://github.com/Rimagination/easygee。
准备使用时,可把仓库链接交给支持的宿主 Agent,要求它按项目说明检查安装、Python 环境与 Earth Engine 授权。项目采用 MIT 许可证;数据产品、第三方服务和模型仍需遵循各自使用条件。
如果你正在做遥感学习、区域环境分析或地理空间原型开发,EasyGEE 提供了一个值得实践的入口:用对话逐步明确问题,用工具执行,再用地图和文件检验结果。