ARTICLE · 1153915
中科逸视文档抽取系统:把一堆"看不懂"的纸张,变成能算能查的数据
中科逸视文档抽取系统:把一堆"看不懂"的纸张,变成能算能查的数据你去银行办贷款,客户经理要在厚厚的材料里找你的收入证明;公司财务月底报销,桌上一叠发票、行程单等着录进系统。这些材料有个共同的麻烦:它们大多躺在纸、PDF 或者一张随手拍的照片里,机器"读得出来",但"看不懂"。 这就是中科逸视(北京)科技有限公司在做的一件事——用一套"智能文档抽取系统",把合同、票据、证照、病历、银行流水这些非结构化文档,自动拆成能被业务系统直接使用的结构化数据。下面我们把它拆开,看看机器是怎么一步步"读懂"一张纸的。 
一个类比:它更像"翻译官",而不是"扫描仪" 很多人对OCR(光学字符识别)的印象还停留在"扫一扫、转成文字"。但请注意,认字 ≠ 读懂。 举个直观的例子。一份合同上写着"甲方:某某公司,开户行:某某银行",下面紧接着是"乙方:某某公司,开户行:某某银行"。传统 OCR 会把这几行字原样抄下来,却分不清哪个开户行属于甲方、哪个属于乙方——两个字段太像了,只靠"认字"没法判断。 文档抽取系统要更进一步:不仅把字认出来,还要结合整篇文档的上下文,判断每个字段到底是什么意思、属于谁、值多少钱。它像个翻译官——把"文档语言"翻译成"数据库语言"。官方把这套底层设计叫"视觉感知底座 + 大模型认知引擎"的双轮驱动,我们一层层拆开看。 技术原理:文档是怎么被"读懂"的 整个流程可以理解成四层递进:前一层的输出是后一层的输入,但又不是简单的"串糖葫芦"——视觉模块和大模型之间是深度融合的。 第一层:先把"照片拍糊了"的问题解决掉 现实里的文档很少是干干净净的:可能是手机随手拍的、有手抖造成的倾斜;可能有台灯反光糊掉一块;可能是发黄的老档案,字迹模糊;还可能盖了公章,红章压住关键文字。 这一层就是给图像"整容"。系统用卷积神经网络这类算法做四件事: 做完之后,输出一张"画质规整、文字清晰"的图——素材太差,再聪明的算法也白搭。 第二层:不只会认字,还要看懂版式 这一层是视觉感知的核心,干两件事:认结构和认文字。 先说认结构。版面分割算法会像经验丰富的排版工一样,把文档切成不同区域:哪些是正文文本块、哪些是嵌套表格、哪里盖了公章、哪里有签名、标题和页眉页脚在哪儿。每块内容都会被标上页面上的空间坐标——这很关键,它让机器知道"这段话在哪儿、和谁挨着",为后面判断字段归属埋下伏笔。 再说认文字。系统用端到端的深度学习OCR 模型,能同时应付印刷体、手写批注、多语种混排、倾斜文字。识别出的每个字,除了内容本身,还带上置信度(机器对"认得对不对"的把握)和空间位置。 表格是最麻烦的一环。遇到合并单元格、跨行表头、多层嵌套表格,普通OCR 就"散架"了,行列对不上。系统用专门的表格解析算法把合并单元格拆开、把嵌套表格还原,保留单元格之间原本的对应关系,做到"原图长啥样,抽出来就啥样"。 到这里,文档抽取系统不只是"认字",而是完整读懂了文档的物理版式,输出的是带着空间位置的多维视觉特征——相当于把"视觉信息"和"文字信息"的通道打通了。 第三层:让大模型来"讲人话、懂业务" 前两层解决"看得见",第三层才是真正"读得懂"。传统 OCR 输出的是一串碎片化文本,不知道这些字组合起来是什么意思。这一层把 OCR 识别出的文字、版面坐标、区块特征一起喂给一个经过行业微调的大语言模型,做深度语义解析: 第四层:交出来的必须是"能用"的数据 光抽出来还不够,得保证抽出来的对、能直接对接业务系统。最后一层做结果校验:内置规则校验、数值格式校验、时间格式筛查,把明显不合规的字段拦下来。通过后输出成JSON、Excel 等标准结构化数据,同时支持"原始文档 + 抽取结果"对照预览,让人一眼看出哪个字段是从原文哪儿抽出来的。这样一个从"原始文件"到"可直接接入业务系统"的闭环才算真正闭上。 它到底有哪些"不一样"的地方 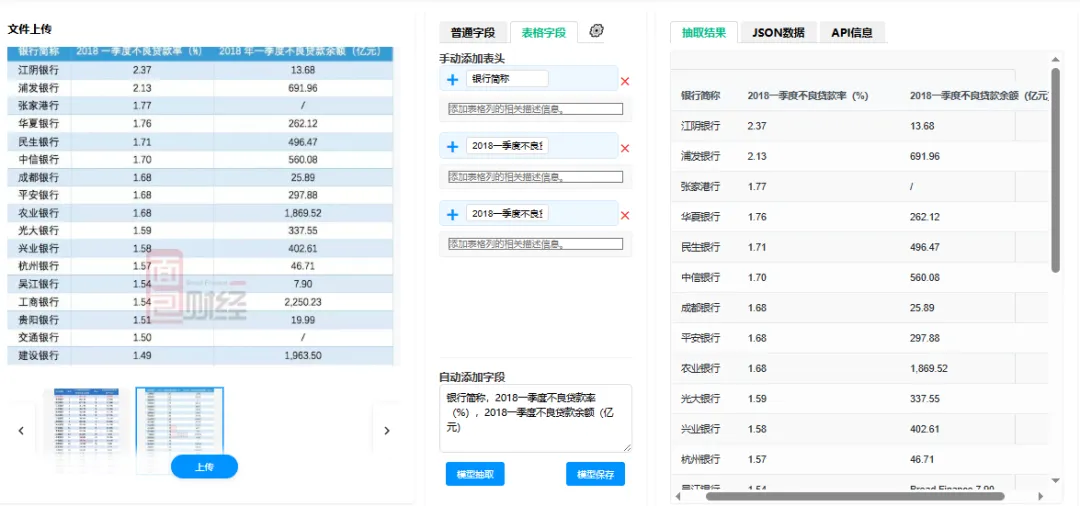
它已经在这些行业里干活了 我们每天产生的大量数据,其实都"锁"在文档里——锁在扫描件里、锁在 PDF 里、锁在一张拍糊了的照片里。过去要把它们变成能算、能查的数据,靠的就是人工一个字一个字地敲。 中科逸视文档抽取技术想解决的,本质上是"让机器从'看得见'走到'读得懂、抽得出、用得上'"。它背后的思路——用视觉感知打底、用大模型做认知——也代表了当下 AI 文档处理的一个方向:光会认字已经不够了,能理解上下文、懂业务逻辑,才算是真的"读懂了"。
摆正:把倾斜的文档自动转正; 去噪:清掉光斑、污渍、纸张褶皱的干扰; 增强:做二值化处理,拉开文字与背景的对比度; 修复:针对印章遮挡、反光、老旧模糊、手写涂改做像素级修复。
轻量化微调:不用拿海量数据从头训练,用少量行业样本就能让模型"适配"某个领域,学会不同字段的上下文表达习惯——这也是它落地门槛低的原因之一。 用提示词定义目标:你想抽什么字段,用自然语言告诉它即可。模型会结合全文消除歧义、区分相似字段——回到合同的例子,它能分清甲方乙方各自的"开户行""签订日期""付款金额"。 多模态融合推理:文档抽取系统会综合印章盖在哪儿、签名在哪个区域、表格怎么排布来辅助判断,用视觉线索纠正单纯文字识别可能出现的错误。也就是说,它不只听你说了什么,还看你写在了哪里。 实体关系识别:梳理文档里机构名称、证件编号、金额、时间、权责条款之间的逻辑关联。
打个比方:前两层是"逐字誊抄",第三层则是那个能一边读、一边思考、最后告诉你"这份合同关键风险点在哪"的老手。
抗"疑难杂版式":不少文档工具是 OCR 和 NLP 各干各的,遇到印章遮字、手写备注、多栏排版、老旧扫描件就容易翻车。这套系统把视觉特征和语义特征打通,靠上下文语义修正识别失误,对复杂版式更稳。 少样本就能定制:传统做法要给某种文档准备成千上万份标注数据,成本很高。它用的是少样本学习框架——用户只要提供 2 到 5 份典型样本、标一下想抽的字段,就能把一种新文档类型适配好,不需要深度算法开发团队。 全格式、多模态一起上:纸质扫描件、照片、PDF、加密截图基本都兼容;文字、复杂表格、公式、插图、签章信息可以一起抽。 全流程自动化:从上传、图像优化、版面拆分、文字识别、字段抽取到数据导出一条龙,可批量处理成千上万份存量档案,把员工从枯燥录入里解放出来。 不挑模板:格式固定的发票、表单能处理,版式自由、每份排版都不一样的合作协议、招标文件、手写档案也能适配,突破了传统"模板识别"工具只能认固定版式的短板。
金融与保险:自动抽取车险、健康险保单和病历里的关键诊疗记录,缩短理赔周期;对比新旧合同条款、圈出风险点;解析网银对账单,还原交易对手与余额变动。 智慧政务与企业服务:批量处理营业执照、身份证、资质证书辅助工商登记;从招标文件里汇总投标人业绩与评分要素。 财务共享中心:对发票、行程单、住宿清单做验真和关键字段提取,再和ERP 系统自动对账。 医疗与健康:把病历、处方、检查报告转成电子病历系统可读的结构化数据,方便后续统计和科研。 物流与供应链:从快递面单、入库单提取收件人与货物明细,自动同步到仓储、运输管理系统。