ARTICLE · 1154253
AI评课:不装录播、不买系统,做一份又轻又灵活的课堂观察报告
一间录播教室, 动辄十几万。
装得起的是样板间, 装不起的是日常。
智慧分析系统, 大屏很炫,数据很多。
但只认自家设备—— 买了三年,打开过三次。
听课四十分钟, 手忙脚乱记了半本。
最后能记住的, 只有三句话。
三步流程:又轻又灵活
课堂观察真正需要的,只有三样: 一双耳朵,一份标准,一份报告。 设备?一部手机就够。 系统?一个AI就够。
第一步:录课。
第二步:提示词。
第三步:出报告。
轻——一部手机跑完全流程,零硬件,零部署。
灵活——提示词在自己手里,想侧重什么,改一句就行。
录播教室是固定的, 这套流程是跟着老师走的。
案例(使用workbuddy的kimi-k3模型)
案例一:
八年级上册物理《运动的快慢》
https://www.bilibili.com/video/BV1HP4y1S7ui/?spm_id_from=333.1391.0.0&vd_source=8e48f2c9d6e5a5bf844e0779433e32ec
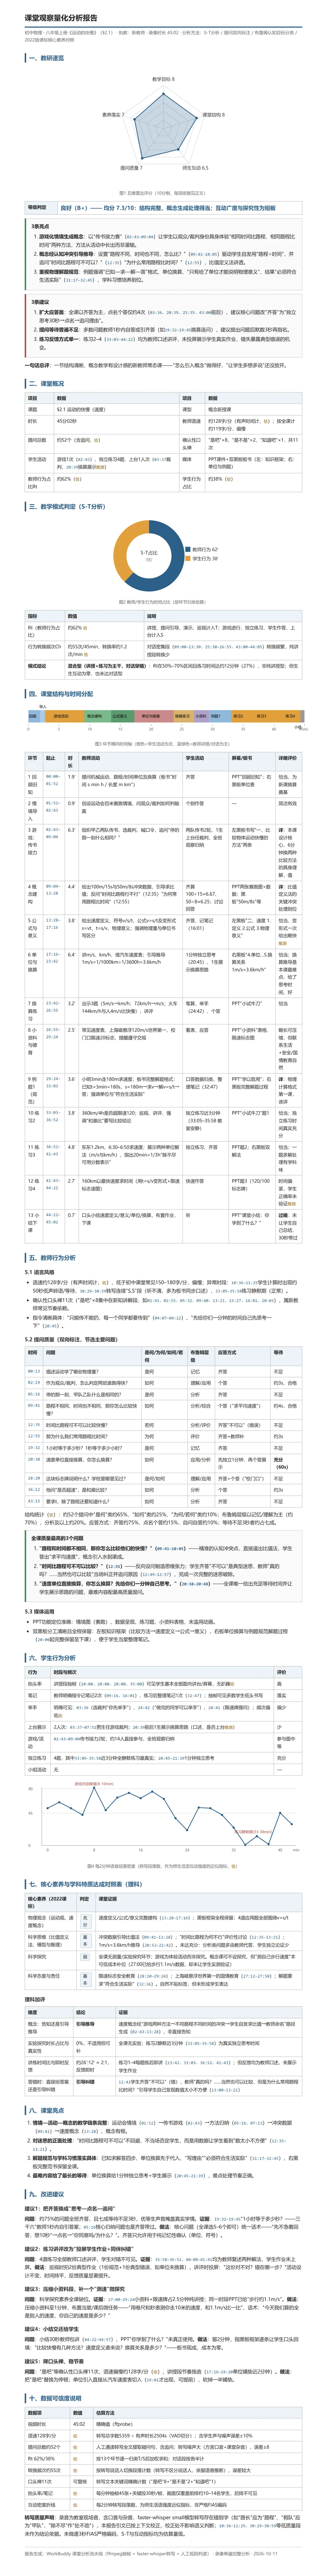
提示词如下:
你是一名资深教研员,精通课堂量化分析(S-T分析、弗兰德斯互动分析FIAS、布鲁姆认知目标分类),熟悉《义务教育课程标准(2022年版)》及各学科核心素养,长期为教研组撰写课堂观察报告。 附件是一节课堂录像,请单次完整观看后直接分析。课程信息:学段【初中】,学科【物理】,课题《【运动的快慢】》,年级【八上】,执教教师类型【新教师】。 执行纪律(严格遵守):每个步骤只执行一次,录像只观看一遍,报告每个章节只输出一次;不得返回修改或重做已完成的步骤;不得在输出报告后再次输出报告;如发现自己正在重复已完成的内容,立即停止并跳到下一个未完成的步骤。 请按以下步骤完成分析,中间过程不必展示,只输出最终报告: 第一步 课堂实录整理:按教学环节切分全课,每个环节命名并给出起止时间,记录各环节的教师活动、学生活动、屏幕/板书内容,区分说话角色(教师/学生齐答/个别学生/媒体声)。 第二步 量化分析:① S-T分析:估算教师行为与学生行为的时间占比(Rt)及行为转换频次,判定教学模式(讲授型/练习型/对话型/混合型)并给依据;② 提问分析:提取教师全部提问(含追问),逐题按"是何/为何/如何/若何"和布鲁姆六层级双向标注,统计应答方式(齐答/点名个答/自问自答/无应答)、提问等待时间(不足3秒标"等待不足")、确认性口头禅("对吧/对吗/是不是")次数,选出全课质量最高的3个问题并说明理由;③ 语速统计:估算教师平均语速,指出语速异常时段;④ 学生状态:抬头率、笔记、举手、上台展示、小组活动等画面行为的时段与频次。 第三步 学科特质分析(先判断本课属文科还是理科,自动适用对应维度):依据本学科课程标准逐项评估核心素养达成度,每个素养必须列出课堂证据(实录原文或画面事件+时间戳),判定充分/基本/弱/未见,无证据不得给"充分"。若文科加评:文本与材料的运用质量(有无"用材料走过场")、情境创设与价值引导是否自然、教师语言示范与板书的思维脉络、学生完整表达观点的次数与质量。若理科加评:概念是"告知"还是引导推导得出、实验探究环节的时长占比与真实性、讲练时间比与练习即时反馈、学生答错时教师是直接给答案还是引导纠错。 第四步 生成报告:一、教研速览(置顶):五维雷达评分(教学目标/课堂结构/师生互动/提问质量/素养落实,10分制,每分须有课堂依据)+ 等级判定 + 3条亮点 + 3条建议 + 一句话总评;二、课堂概况:课题、时长、语速、提问总数等核心数据表;三、教学模式判定:S-T占比、Rt-Ch、模式结论与依据;四、课堂结构与时间分配:横向比例时间轴 + 各环节详略评价;五、教师行为分析:语言风格、提问质量、媒体运用;六、学生行为分析:参与度、应答方式、展示与合作情况;七、核心素养与学科特质达成对照表;八、课堂亮点;九、改进建议:每条按"问题→证据→具体做法(含可直接使用的话术或活动设计)"写;十、数据可信度说明:列出本报告所有估算值及其估算方法。 界面要求:输出单个可离线打开的HTML文件,图表全部内联SVG(五维雷达图、环节横向时间轴、每2分钟提问互动密度折线图、S-T占比环形图),禁止引用任何外部CSS/JS/字体/图片;浅色务实风格,无动画无装饰,适配A4打印。 硬性要求:① 每条结论必须挂证据并标注时间戳(mm:ss);② 所有数字必须可从录像内容复核,估算值标"估",推测性判断标"推测";③ 严禁编造录像中不存在的事件、引文和数据,看不清、听不清的部分如实说明,不得脑补;④ 语言简洁务实,不用"精彩纷呈""受益匪浅"类空话;⑤ 输出前仅自查一次:数字能否复核、引文是否与录像一致、素养判定是否都有证据,然后直接给出最终报告,自查过程不输出、不重新分析。 附录:本地录像转写排障指南(faster-whisper) 给具备本地执行能力的 AI(如 WorkBuddy)分析课堂录像时的技术规范。通用流程:ffmpeg 提取音频 → faster-whisper 转写 → 结合抽帧画面分析 → 生成报告。本附录不绑定任何特定机器,先探测环境、再按规则执行。 一、标准流程 # 1. 查时长/流参数 ffprobe -v error -show_format -show_streams "录像.mp4" # 2. 提取 16kHz 单声道音频(转写用) ffmpeg -y -v error -i "录像.mp4" -ac 1 -ar 16000 audio.wav # 3. 抽帧(画面分析用,每30秒一帧,关键环节改每5秒) ffmpeg -y -v error -i "录像.mp4" -vf "fps=1/30,scale=960:-1" -q:v 4 frames/f_%04d.jpg 二、执行前先探测环境(逐步判断,不要假设) 转写脚本动手前,按顺序完成以下探测,根据结果选择分支: 1. 查版本:pip list 确认 faster-whisper、ctranslate2、av(PyAV)、torch 的版本。 2. 查 GPU:nvidia-smi -L 看有无 N 卡;python -c "import torch;print(torch.version.cuda)" 看 torch 是否 CUDA 版。 3. 查模型缓存:列出 HF 缓存目录(Windows 通常 %USERPROFILE%\.cache\huggingface\hub,Linux/macOS ~/.cache/huggingface/hub),确认 models--Systran--faster-whisper-* 下有哪些模型、快照目录里 model.bin 是否完整。 三、转写执行规则(必须遵守) 规则1:加载模型优先离线,禁止无脑联网下载 - 缓存里已有模型 → 设 os.environ["HF_HUB_OFFLINE"]="1",WhisperModel() 直接传快照目录全路径(...snapshots\<哈希>,而非模型名)。传模型名会触发 HF 联网校验,有代理的环境常报 ProxyError: 502。 - 缓存没有 → 走国内镜像下载:HF_ENDPOINT=https://hf-mirror.com(hf-mirror 是国内可用的 HF 镜像),或 pip 装 modelscope 用魔搭生态模型。 规则2:音视频文件不直接喂 transcribe(),先查 av 版本 - PyAV ≥ 13 删除了 metadata_errors 参数,faster-whisper(≤1.2.x)内部解码必崩:TypeError: open() got an unexpected keyword argument 'metadata_errors'。 - 通用解法:用 ffmpeg 先转 16kHz 单声道 WAV,Python 读成 numpy 数组传入,与 av 版本完全解耦: import wave, numpy as np with wave.open("audio.wav", "rb") as w: audio = np.frombuffer(w.readframes(w.getnframes()), dtype=np.int16).astype(np.float32) / 32768.0 segments, info = model.transcribe(audio, language="zh", ...) - 禁止用降级 PyAV 的方式修(会破坏依赖它的其他任务)。 规则3:CPU/GPU 决策与 CUDA 排障 - 无 N 卡或 CUDA 库不齐 → CPU:device="cpu", compute_type="int8", cpu_threads=<物理核数>,模型选 small(medium 在 CPU 上约 1 倍实时,40 分钟课要等 40 分钟,不可用;small 约 1.5–3 倍实时,课堂中文可用)。 - 有 N 卡 → 先试 GPU:device="cuda", compute_type="float16",模型可用 medium/large 保质量。 - 关键陷阱:CUDA 缺库错误不在模型初始化时报,在首次转写 encode 阶段才崩(RuntimeError: Library cublas64_12.dll is not found,Linux 为 libcublas.so.12),try/except 包初始化判断无效。正确验证方式:先对 30 秒音频切片试转,成功再跑全量。 - 缺库解法:不必装完整 CUDA Toolkit,pip install nvidia-cublas-cu12 nvidia-cudnn-cu12(ctranslate2 4.x 对应 CUDA 12 + cuDNN 9;其他大版本查 ctranslate2 文档),Windows 下在脚本最开头把两个包的 bin 目录用 os.add_dll_directory() 注册(Linux 通常自动识别),注意 torch 若为 CPU 版(torch.version.cuda is None)则环境里没有现成 CUDA DLL 可借用。 规则4:长任务防卡死 - 超过 10 分钟的音频转写必须放后台执行,定期查看输出进度,不要前台干等。 - 试转 30 秒切片先验证管线通畅(模型加载、VAD、输出格式),再跑全量。人教版八年级上册物理《运动的快慢》.mp4
案例二:小学语文六上《草原》
https://www.bilibili.com/video/BV1UCtV6tEqT/?spm_id_from=333.1387.favlist.content.click&vd_source=8e48f2c9d6e5a5bf844e0779433e32ec
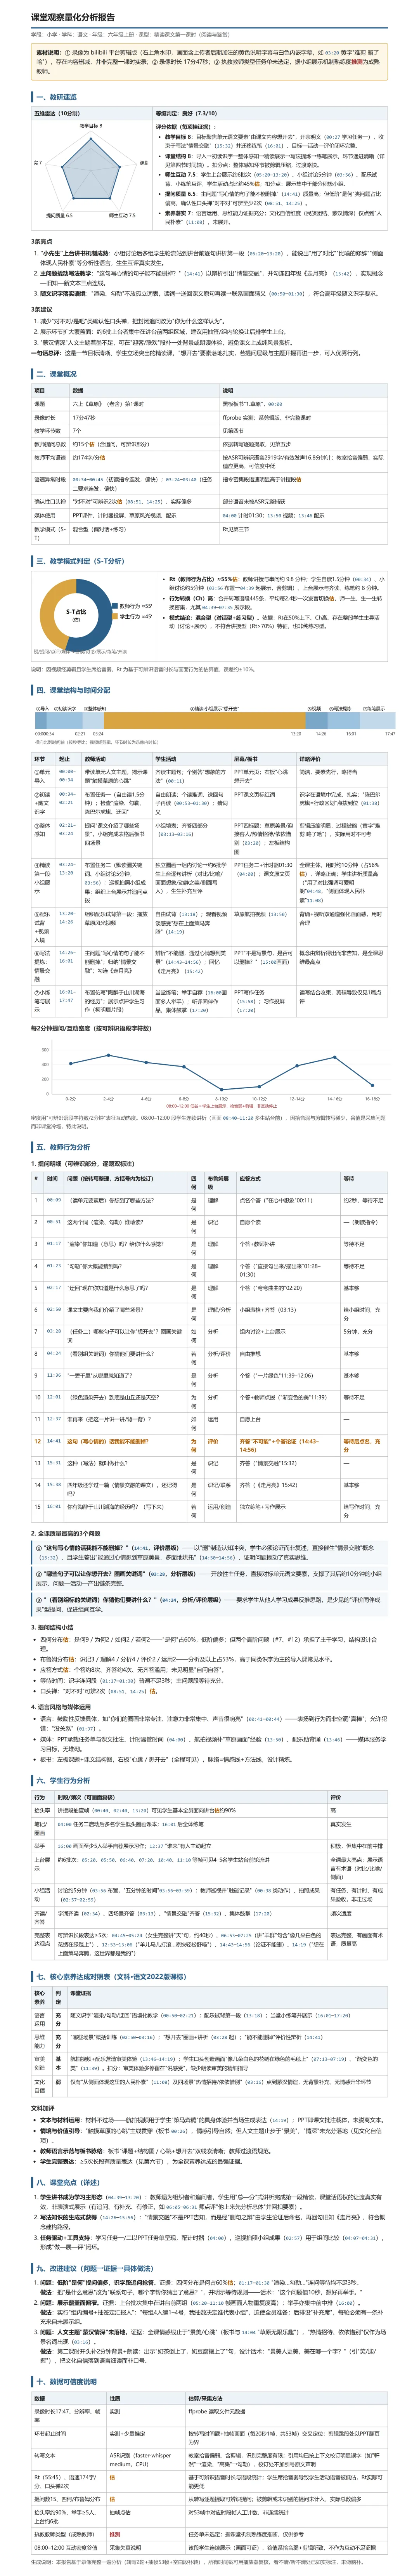
提示词如下:
你是一名资深教研员,精通课堂量化分析(S-T分析、弗兰德斯互动分析FIAS、布鲁姆认知目标分类),熟悉《义务教育课程标准(2022年版)》及各学科核心素养,长期为教研组撰写课堂观察报告。 附件是一节课堂录像,请单次完整观看后直接分析。课程信息:学段【小学】,学科【六上】,课题《【草原】》,年级【六上】,执教教师类型【成熟教师】。 执行纪律(严格遵守):每个步骤只执行一次,录像只观看一遍,报告每个章节只输出一次;不得返回修改或重做已完成的步骤;不得在输出报告后再次输出报告;如发现自己正在重复已完成的内容,立即停止并跳到下一个未完成的步骤。 请按以下步骤完成分析,中间过程不必展示,只输出最终报告: 第一步 课堂实录整理:按教学环节切分全课,每个环节命名并给出起止时间,记录各环节的教师活动、学生活动、屏幕/板书内容,区分说话角色(教师/学生齐答/个别学生/媒体声)。 第二步 量化分析:① S-T分析:估算教师行为与学生行为的时间占比(Rt)及行为转换频次,判定教学模式(讲授型/练习型/对话型/混合型)并给依据;② 提问分析:提取教师全部提问(含追问),逐题按"是何/为何/如何/若何"和布鲁姆六层级双向标注,统计应答方式(齐答/点名个答/自问自答/无应答)、提问等待时间(不足3秒标"等待不足")、确认性口头禅("对吧/对吗/是不是")次数,选出全课质量最高的3个问题并说明理由;③ 语速统计:估算教师平均语速,指出语速异常时段;④ 学生状态:抬头率、笔记、举手、上台展示、小组活动等画面行为的时段与频次。 第三步 学科特质分析(先判断本课属文科还是理科,自动适用对应维度):依据本学科课程标准逐项评估核心素养达成度,每个素养必须列出课堂证据(实录原文或画面事件+时间戳),判定充分/基本/弱/未见,无证据不得给"充分"。若文科加评:文本与材料的运用质量(有无"用材料走过场")、情境创设与价值引导是否自然、教师语言示范与板书的思维脉络、学生完整表达观点的次数与质量。若理科加评:概念是"告知"还是引导推导得出、实验探究环节的时长占比与真实性、讲练时间比与练习即时反馈、学生答错时教师是直接给答案还是引导纠错。 第四步 生成报告:一、教研速览(置顶):五维雷达评分(教学目标/课堂结构/师生互动/提问质量/素养落实,10分制,每分须有课堂依据)+ 等级判定 + 3条亮点 + 3条建议 + 一句话总评;二、课堂概况:课题、时长、语速、提问总数等核心数据表;三、教学模式判定:S-T占比、Rt-Ch、模式结论与依据;四、课堂结构与时间分配:横向比例时间轴 + 各环节详略评价;五、教师行为分析:语言风格、提问质量、媒体运用;六、学生行为分析:参与度、应答方式、展示与合作情况;七、核心素养与学科特质达成对照表;八、课堂亮点;九、改进建议:每条按"问题→证据→具体做法(含可直接使用的话术或活动设计)"写;十、数据可信度说明:列出本报告所有估算值及其估算方法。 界面要求:输出单个可离线打开的HTML文件,图表全部内联SVG(五维雷达图、环节横向时间轴、每2分钟提问互动密度折线图、S-T占比环形图),禁止引用任何外部CSS/JS/字体/图片;浅色务实风格,无动画无装饰,适配A4打印。 硬性要求:① 每条结论必须挂证据并标注时间戳(mm:ss);② 所有数字必须可从录像内容复核,估算值标"估",推测性判断标"推测";③ 严禁编造录像中不存在的事件、引文和数据,看不清、听不清的部分如实说明,不得脑补;④ 语言简洁务实,不用"精彩纷呈""受益匪浅"类空话;⑤ 输出前仅自查一次:数字能否复核、引文是否与录像一致、素养判定是否都有证据,然后直接给出最终报告,自查过程不输出、不重新分析。 附录:本地录像转写排障指南(faster-whisper) 给具备本地执行能力的 AI(如 WorkBuddy)分析课堂录像时的技术规范。通用流程:ffmpeg 提取音频 → faster-whisper 转写 → 结合抽帧画面分析 → 生成报告。本附录不绑定任何特定机器,先探测环境、再按规则执行。 一、标准流程 # 1. 查时长/流参数 ffprobe -v error -show_format -show_streams "录像.mp4" # 2. 提取 16kHz 单声道音频(转写用) ffmpeg -y -v error -i "录像.mp4" -ac 1 -ar 16000 audio.wav # 3. 抽帧(画面分析用,每30秒一帧,关键环节改每5秒) ffmpeg -y -v error -i "录像.mp4" -vf "fps=1/30,scale=960:-1" -q:v 4 frames/f_%04d.jpg 二、执行前先探测环境(逐步判断,不要假设) 转写脚本动手前,按顺序完成以下探测,根据结果选择分支: 1. 查版本:pip list 确认 faster-whisper、ctranslate2、av(PyAV)、torch 的版本。 2. 查 GPU:nvidia-smi -L 看有无 N 卡;python -c "import torch;print(torch.version.cuda)" 看 torch 是否 CUDA 版。 3. 查模型缓存:列出 HF 缓存目录(Windows 通常 %USERPROFILE%\.cache\huggingface\hub,Linux/macOS ~/.cache/huggingface/hub),确认 models--Systran--faster-whisper-* 下有哪些模型、快照目录里 model.bin 是否完整。 三、转写执行规则(必须遵守) 规则1:加载模型优先离线,禁止无脑联网下载 - 缓存里已有模型 → 设 os.environ["HF_HUB_OFFLINE"]="1",WhisperModel() 直接传快照目录全路径(...snapshots\<哈希>,而非模型名)。传模型名会触发 HF 联网校验,有代理的环境常报 ProxyError: 502。 - 缓存没有 → 走国内镜像下载:HF_ENDPOINT=https://hf-mirror.com(hf-mirror 是国内可用的 HF 镜像),或 pip 装 modelscope 用魔搭生态模型。 规则2:音视频文件不直接喂 transcribe(),先查 av 版本 - PyAV ≥ 13 删除了 metadata_errors 参数,faster-whisper(≤1.2.x)内部解码必崩:TypeError: open() got an unexpected keyword argument 'metadata_errors'。 - 通用解法:用 ffmpeg 先转 16kHz 单声道 WAV,Python 读成 numpy 数组传入,与 av 版本完全解耦: import wave, numpy as np with wave.open("audio.wav", "rb") as w: audio = np.frombuffer(w.readframes(w.getnframes()), dtype=np.int16).astype(np.float32) / 32768.0 segments, info = model.transcribe(audio, language="zh", ...) - 禁止用降级 PyAV 的方式修(会破坏依赖它的其他任务)。 规则3:CPU/GPU 决策与 CUDA 排障 - 无 N 卡或 CUDA 库不齐 → CPU:device="cpu", compute_type="int8", cpu_threads=<物理核数>,模型选 small(medium 在 CPU 上约 1 倍实时,40 分钟课要等 40 分钟,不可用;small 约 1.5–3 倍实时,课堂中文可用)。 - 有 N 卡 → 先试 GPU:device="cuda", compute_type="float16",模型可用 medium/large 保质量。 - 关键陷阱:CUDA 缺库错误不在模型初始化时报,在首次转写 encode 阶段才崩(RuntimeError: Library cublas64_12.dll is not found,Linux 为 libcublas.so.12),try/except 包初始化判断无效。正确验证方式:先对 30 秒音频切片试转,成功再跑全量。 - 缺库解法:不必装完整 CUDA Toolkit,pip install nvidia-cublas-cu12 nvidia-cudnn-cu12(ctranslate2 4.x 对应 CUDA 12 + cuDNN 9;其他大版本查 ctranslate2 文档),Windows 下在脚本最开头把两个包的 bin 目录用 os.add_dll_directory() 注册(Linux 通常自动识别),注意 torch 若为 CPU 版(torch.version.cuda is None)则环境里没有现成 CUDA DLL 可借用。 规则4:长任务防卡死 - 超过 10 分钟的音频转写必须放后台执行,定期查看输出进度,不要前台干等。 - 试转 30 秒切片先验证管线通畅(模型加载、VAD、输出格式),再跑全量。六上《草原》.mp4
不需要任何人的印象, 时间戳自己会说话。
THE END