ARTICLE · 1161020
AI 读 300 页 PDF,5 分钟提取我要的 8 个数
AI 读 300 页 PDF,5 分钟提取我要的 8 个数上个月我要看一份产品白皮书,页脚标着 312 页。我真正需要的只有 8 个数:几个接口、各自的参数、有没有权限说明、有没有已知限制。 以前这种东西的处理方式只有两种:要么硬着头皮读一下午,要么假装读过,等别人问起来再翻。 现在多了一种:扔给 AI,5 分钟,8 个数全出来,还能告诉我哪些页码不用看。 这篇把它拆成四步,全程手机能操作。最后会说一个很多人不知道的坑:AI 读文档最大的问题不是读得慢,是它会"顺手编数"。 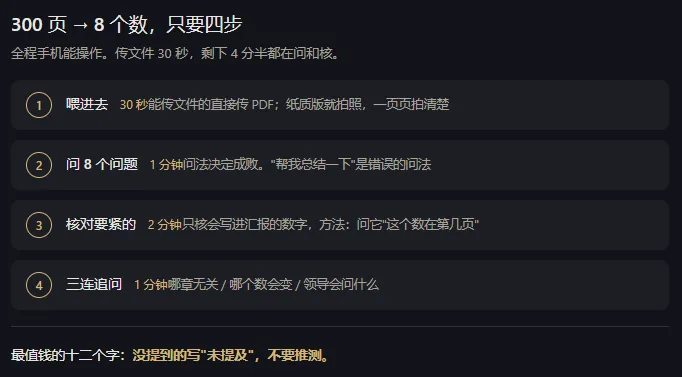
能传文件的工具(豆包、Kimi、DeepSeek 都行): 点输入框旁边的"+"号,选"文件",把 PDF 直接传上去。300 页的文件可能要等十几秒解析,等它提示"已读取"再提问。 只能发图或者干脆没有文件(纸质文档、截图、别人发的朋友圈长图): 手机直接拍照,一页一页拍清楚,几张到几十张都行,全选发给 AI,跟着说一句"这是同一份文档的连续几页"。 ⚠️ 两种情况必须提醒你: 带公章或要签字的文件,拍照前想想这文件能不能外传。公司内部资料、别人家的合同,丢给外面的 AI 服务之前先过一遍脑子。涉密的东西别传,这条没有例外。 扫描件如果字迹模糊、歪斜,AI 会认错字,认错字就会给错数。模糊的扫描件宁可自己读。
同样一份文档,问法不同,结果天差地别。 错的问法: "帮我总结一下这份文档。" 它会给一份四平八稳的总结,看起来什么都说了,其实你要的那 8 个数一个都没提。这不是 AI 的问题,是问题没问对。 对的问法: 两个细节说一下。 第 7 条是省时间的核心。它告诉你哪几页可以不看,300 页可能直接砍到 60 页。这一条很多人不知道,等于白扔一半效率。 第 8 条是防编造的关键。让它自己标注"哪些我不确定",等于让它自首。它标出来的部分,你重点核对;它没标的部分,基本可靠。 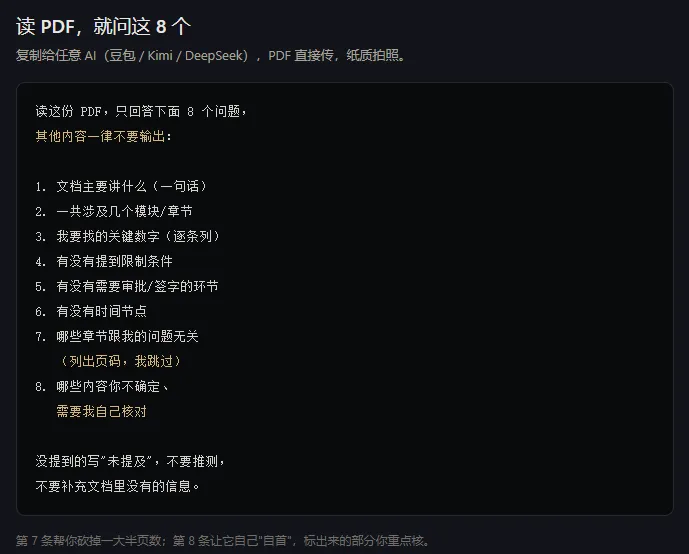
上一篇说过,要签字的数字必须自己核。读文档同理,但不用全核,分三档: 要核的:会写进邮件、汇报、决策里的数字。方法:在 AI 的回答里挑出关键数字,问它"这个数在第几页",翻过去看一眼。30 秒一个。 不用核的:只是帮你判断"这文档值不值得细读"的背景信息。它错了也无所谓。 绝对要核的:涉及钱、法条、生效日期的。这类数我建议找到原文页,自己读一遍原句。AI 读表格特别容易串行,把 A 项的数字安到 B 项头上,看着毫无破绽。 我自己翻过一次车:让它读一份报价单,它把"税前 48 万"读成了"税后 48 万",就差两个字,差点在会上说出去。从那以后凡是数字,我必问页码。 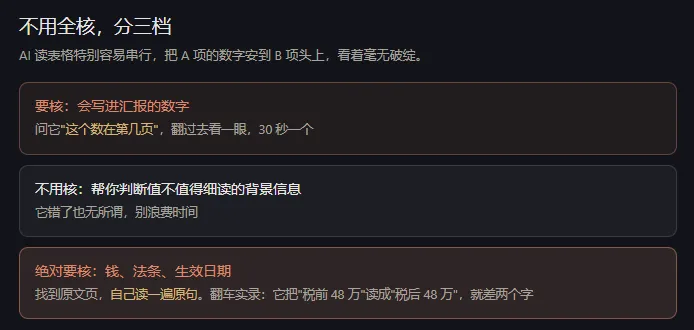
第一次提问的答案回来后,别急着关。还有三连问,每一问都很便宜: 第 3 问是我用得最爽的。它替你预演领导会刁钻地问什么,你提前把答案找好。有一次汇报,领导果然问到了它预判的三个问题里的两个,我当时心里给它磕了一个。 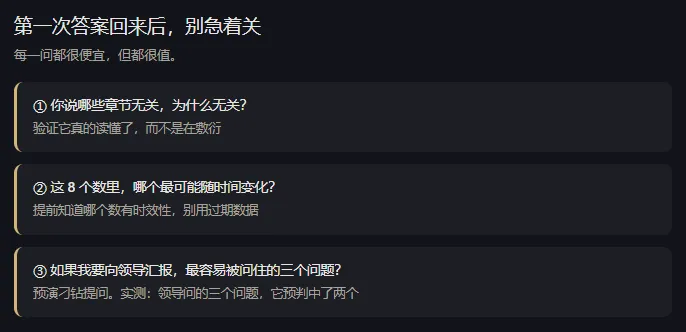
说了半天好处,泼两盆冷水。 法律文件别只靠它。合同、协议、章程,AI 提取完你自己还是要通读一遍关键条款。它漏掉一句"乙方有权单方解除",你按它的总结签字,麻烦就是你的。 需要形成自己判断的别这么干。读论文、读竞品报告,目的是消化成自己的东西。全靠 AI 提取,你得到了 8 个数,没得到理解。这种我一般让 AI 先提取,然后关掉它的答案自己再读一遍原文重点,多花 20 分钟,值。 扫描质量差的别勉强。上面说过了,模糊件认错字是常事,给错数你还查不出来。
整套流程串下来:传文件(30 秒)→ 问 8 个问题(1 分钟)→ 核对要紧数字(2 分钟)→ 三连追问(1 分钟)。5 分钟出头,300 页变成你手里的 8 个数。 记住那句最值钱的:没提到的写"未提及",不要推测。十二个字,能挡住 AI 大部分的编造。 提问模板和追问模板都放在菜单「省时间 → 提示词合集」里了,直接抄。
你最近一次被长文档折磨是什么时候?是合同、白皮书还是公司发的几十页通知?留言说说文档类型,我按你踩的坑出一版专用提问模板。
第一步:把文档喂进去
第二步:问对问题(这步决定成败)
读这份 PDF,只回答下面 8 个问题,其他内容一律不要输出:1. 文档主要讲什么(一句话)2. 一共涉及几个模块/章节3. 我要找的关键数字是多少(逐条列)4. 有没有提到限制条件5. 有没有需要审批/签字的环节6. 有没有时间节点7. 哪些章节跟我的问题无关(列出页码,我跳过)8. 哪些内容你不确定、需要我自己核对没提到的写"未提及",不要推测,不要补充文档里没有的信息。
第三步:核对,只核要紧的
第四步:追问,榨干剩余价值
追问 1:第 7 条里你说哪些章节无关,为什么无关?追问 2:这 8 个数里,哪个最可能随时间变化?追问 3:如果我要向领导汇报这份文档,最容易被问住的三个问题是什么?