ARTICLE · 1161389
AI自主发现新酶?或是假的!
如果有一天,你花了四年熬夜攒出的博士课题,被AI在21小时内“独立发现”,你会作何感想?
这不是科幻,是正在发生的科学争议。
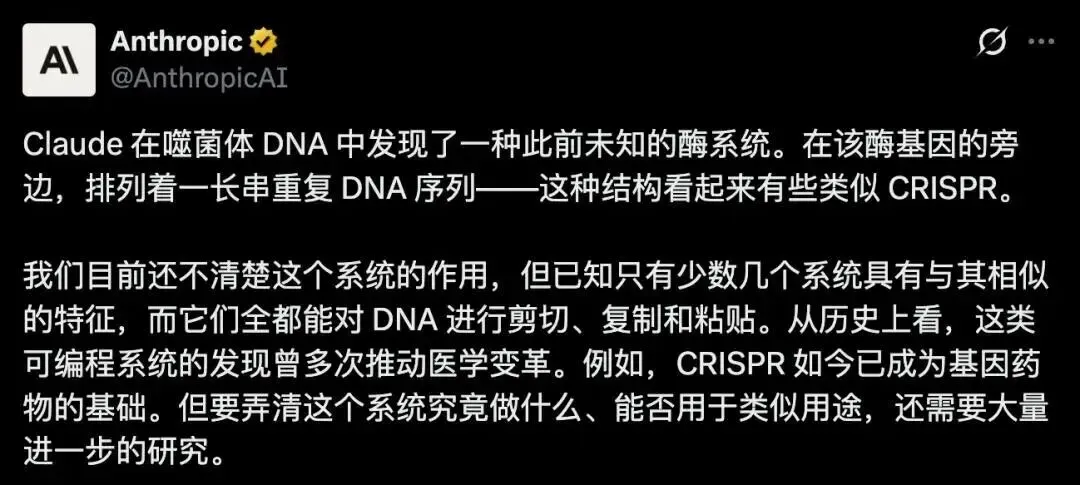
哥本哈根大学计算生物学博士生马里奥最近公开质疑:Anthropic高调宣布的“AI自主发现全新酶系统”,与他尚未发表的博士论文高度重合。(此前曾报道,点击图片查看报道原文)
而更令他不安的是,过去几年里,他一直是Claude的重度用户,论文草稿、实验数据、未发表手稿,全都喂给过这个对话框。
📢 AIX生物医药微信群已开启
扫描上方群二维码,加入AI生物医药交流群,进群备注姓名、公司名、相关领域,交流一线产业观点。
Anthropic的回应来得很快:Claude没碰用户私聊记录,分子生物学团队也接触不到私密对话;这项发现是从2022年公开数据集里重新挖掘的。
但关键问题悬而未决,他们没公开当时给Claude的提示词。
AI到底是逻辑推理出的,还是被隐性记忆“启发”的?
瓜田李下,说不清。
这场争论的核心,其实不在于“谁先发现”。
德克萨斯农工大学团队几年前就鉴定出这种单体酶。
真正的焦点是那个更大的生物系统:反转录酶旁边一串重复DNA序列,能转录小分子RNA,还搭配未知伙伴蛋白,结构上确实像CRISPR的远亲。
但Anthropic自己在报告里承认,后十次独立测试中,AI Agent经常漏掉那串关键重复序列,只有直接喂序列才能识别。
这说明什么?AI的“自主科研”,离真正的独立思考还差得远。
这里有个细节值得玩味。
Anthropic给这个系统起名ARTs,马里奥团队内部叫它Jumbotrons,同一个东西,两套命名,背后是两种发现路径的碰撞。
AI公司擅长把“重新挖掘公开数据”包装成“自主发现”,但科学界要问的是:如果没有马里奥们四年的积累,AI能不能从零识别出这个系统?
如果AI只是在海量参数里“复现”了人类已喂给它的知识,那所谓的“发现”,含金量究竟几何?
更现实的问题摆在每个科研人面前。
曼彻斯特大学等高校已紧急出台AI使用指南,反复告诫:别把未公开数据直接上传商业AI。
可人有惰性,面对一个随叫随到、无所不知的助手,谁能保证每次都忍住不把核心数据丢进去试试?
这场风波给医药科研界提了个醒:AI可以是加速器,但不能是记忆库。
当你的未发表数据成为模型参数的一部分,你失去的不仅是一篇论文的优先权,更是对科学发现边界的掌控权。
技术狂奔的时代,保护未公开数据,就是保护下一个“从0到1”的可能。
毕竟,真正的科学发现,从来不是概率生成的结果,而是人类好奇心与坚持的产物。
AI可以帮忙整理线索,但那条通向未知的路,还得人自己走。