ARTICLE · 1173878
32岁零基础学AI量化 第19~21周: 扩大样本、精简特征、引入模拟交易,涨停回踩模型再优化
上篇结尾说了先不折腾了,但是结果懂的都懂,,没忍住又继续折腾了几版,今天更新后续又调的三个版本,代码只附关键部分,主要跟大家分享一下优化的逻辑和结果,以及踩过的坑,,本文排版一般,请大家多多包容,排版没有花太多时间优化,另外要讲下的是,本系列文章都是本人学习量化的个人笔记,不构成任何投资建议,股市有风险入市需谨慎。
模型问题分析
模型特征信息不够,缺少分时特征;
很多特征重复,关联性低;
目前模型仍停留在二分类问题,不能直接回测出年化收益;
前三次优化
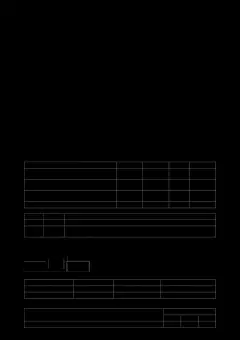
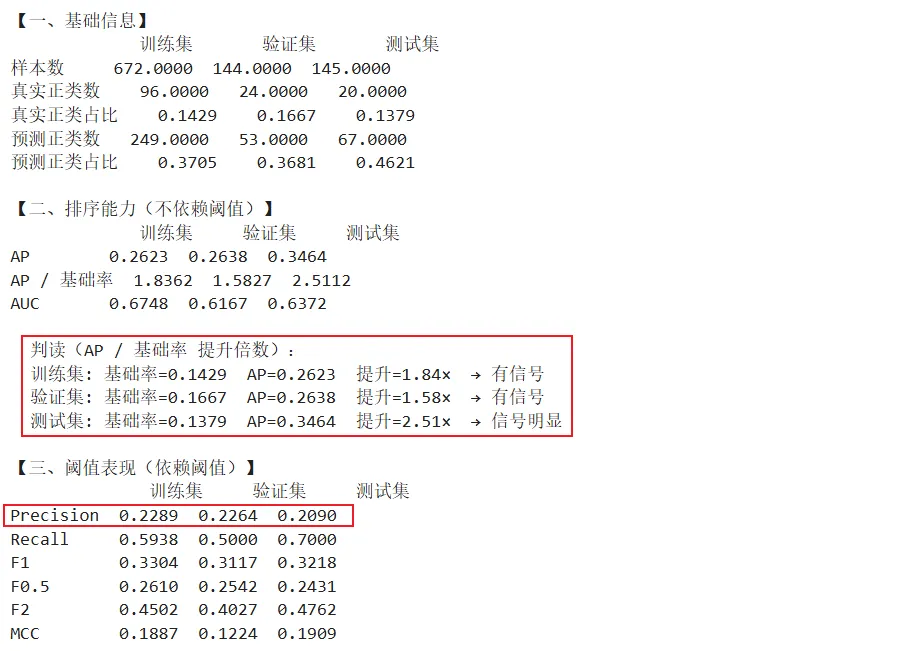
第一次优化将代码将原一体代码拆分成五部分,每部分模块化独立运行,数据独立保存本地(parquet及csv格式),同时将原本2年的数据量扩充到5年,决策阈值使用遍历列表方式得出验证集F0.5最优阈值;第二次优化增加个股强度特征将17个特征值扩充到22个,结果有改善;第三次优化增加浅层神经网络模型,模型训练集结果变化,验证集结果恶化。最终我们在最优版本,也就是第二次优化的2.0版本上进行继续优化,这里附上2.0版本的最终优化结果,以供后面对比:
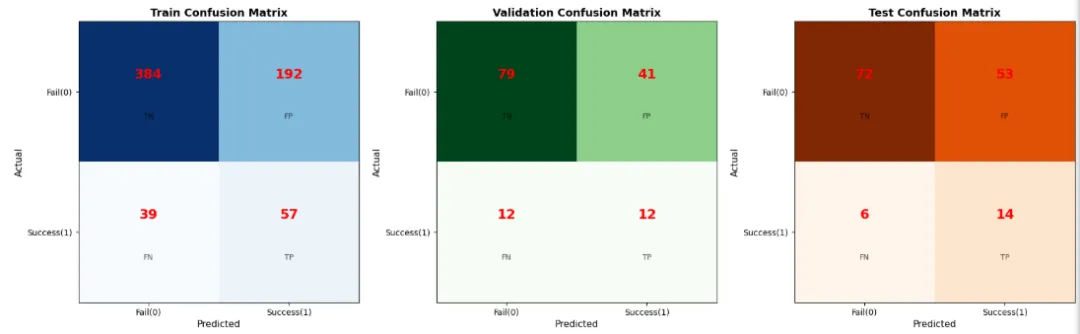
第四次优化
问题:
经过上面三次优化,明显可以看出来扩展特征值是一个有效路径,但是特征值又不能无限增加,因为样本量有限,特征值和正类样本比例一般要>10,现在2.0版本的训练集样本中正类样本数与特征值之比(96:22 ≈ 4.3)远不足 10 ,因此自然我想到了要扩大样本量同时扩大特征值数量顺便将分时特征也加进去。
改善方案:
一.扩大样本量
在目前的筛选条件下5年总样本量961,正类样本更少,只有140(2.0版本下的筛选样本代码如下),原因主要是筛选条件过于苛刻,于是我想到将筛选条件部分放宽或者删除,同时将这些放宽或删除的条件改为特征值,让模型自己去筛选哪些条件是重要的。
改前样本筛选逻辑:
1.d0涨停,且非一字板,前一天须有收盘价;
2.cond_a : 必须严格阶梯回踩 , d0['close'] > d1['close'] > d2['close'] > d3['close']
3.cond_b : 必须按0.9倍率严格缩量, d1['volume'] * 0.9 > d2['volume']) and (d2['volume'] * 0.9 > d3['volume']
4.cond_c :涨停后第二天必须冲高,d1['high'] > d0['close']
5.cond_d :d3收盘价不得跌破d0主体1/3处,d3['close'] > (d0['open'] + (d0['close'] - d0['open']) / 3)
#改前筛选样本条件for i inrange(n - 4): row_d0 = df_stock.iloc[i]# 需要前日收盘价,若为NaN则跳过(第一行或缺失)if pd.isna(row_d0['pre_close']):continue#排除d0非涨停ifnot is_limit_up(row_d0['close'], row_d0['pre_close'], row_d0['high'], limit_threshold):continue#排除一字板if row_d0['close'] == row_d0['open']:continue d0 = df_stock.iloc[i] #涨停日 d1 = df_stock.iloc[i+1] #开始回踩日 d2 = df_stock.iloc[i+2] d3 = df_stock.iloc[i+3] #买入日 d4 = df_stock.iloc[i+4] #期望放量日# 条件判断(注意使用 'volume' 列名) cond_a = (d0['close'] > d1['close'] > d2['close'] > d3['close']) cond_b = (d1['volume'] * 0.9 > d2['volume']) and (d2['volume'] * 0.9 > d3['volume']) cond_c = d1['high'] > d0['close'] cond_d = d3['close'] > (d0['open'] + (d0['close'] - d0['open']) / 3)ifnot (cond_a and cond_b and cond_c and cond_d):continue改后样本筛选逻辑:
1.d0放量涨停,且非一字板,前一天不能是涨停(保证为首板);
2.形态过滤从4个缩减到3个:
①.d1['high'] > d0['close'] 第二天创新高(说明有资金尝试过继续上攻)
②.d3['close'] > d0['open'] 第三天不低于首板开盘价 (回踩不破关键位)(条件放宽)
③.d3['close'] <= d0['close'] 第三天只要有回踩即可(条件放宽)
for i inrange(n - 5):if i < 1:continue# 第一行没有前一日数据,跳过 d0 = df_stock.iloc[i] d_1= df_stock.iloc[i-1]# ---- 过滤 1:d0 必须是放量涨停且不是一字板 ----ifnot is_limit_up(d0, d0['pre_close']):continue# ---- 过滤 2:前一天不能是涨停的 ----if is_limit_up(d_1, d_1['pre_close']):continue# ---- 过滤 3:vol_5_mean 无效(0 或 NaN)时跳过这个样本 ----if pd.isna(d0['vol_5_mean']) or d0['vol_5_mean'] == 0:continue# 取出 d1~d4 d1 = df_stock.iloc[i + 1] d2 = df_stock.iloc[i + 2] d3 = df_stock.iloc[i + 3] d4 = df_stock.iloc[i + 4]# 改后4个筛选条件改为3个# ---- 形态过滤 3个条件 ----# cond_a:d1 最高价突破 d0 收盘(说明有资金尝试过继续上攻) cond_a = d1['high'] > d0['close']# cond_b:d3 收盘价仍高于 (回踩不破关键位) cond_b = d3['close'] > d0['open']# cond_c:d3收盘小于d0收盘 (确认是回踩,同时防止买在高位) cond_c = d3['close'] <= d0['close']ifnot (cond_a and cond_b and cond_c):continue
经过调整,5年样本量从961扩大至14721,同时正类样本来到了2934。
二.扩大特征值数量
当样本量来到了14721个,正类样本2934,此时就不必担心 正类样本量:特征值 <10 了,此时可以尽情扩充特征值数量了;
从以下六个维度,将22个特征值扩充至68个(56个日线特征,12个分时特征):
回踩形态:回踩期间价格及成交量趋势、从支撑、缩量、突破、振幅四个方面描述其形态;
资金关注:异常成交额 RPS,5 日和 20 日双窗口;
板块效应:板块趋势、动量、涨停家数、个股相对板块强弱(个股所在板块相对全板块以及个股在板块内相对强度);
市场环境:涨跌停数、成交额、大盘(市场牛熊情况);
个股动量:前 10 、5 日、d0~d3 相对大盘的强度(涨停回踩期的相对强度);
日内行为:d0 涨停形态(首板特征)、d3 日内形态(买入日特征)。
特征值详细内容如下:
引入了两个共用计算函数(后面很多特征靠这两个函数来计算):
1. 趋势效率 trend_efficiency(prices)
范围约在 [-1, 1],越接近 1:序列越接近单调上涨;越接近 -1:序列越接近单调下跌;接近 0:震荡、路径效率低。
特征值计算中用于收盘价、成交量、振幅的趋势情况的描述。
2. Spearman秩相关 spearman_rank_corr(values)
计算序列与时间序号 [0,1,2,...] 的Spearman秩相关:越接近 1 越单调递增;越接近 -1越单调递减;接近 0 无明显单调关系。
回踩形态与特征描述
特征 含义 计算办法 pullback_close_trend d0~d3 收盘价趋势效率 trend_efficiency(d0~d3 close) pullback_close_spearman d0~d3 收盘价单调性 spearman_rank_corr(d0~d3 close) pullback_volume_trend d0~d3 成交量趋势效率 trend_efficiency(d0~d3 volume) pullback_volume_spearman d0~d3 成交量单调性 spearman_rank_corr(d0~d3 volume) d0_vol_ratio d0 放量程度 d0.volume / d0.vol_5_mean,其中 vol_5_mean = volume.shift(1).rolling(5).mean(),即前 5 日均量,不含 d0 pullback_low_vs_d0_low 回踩最低点相对 d0 最低价 (pullback_low - d0.low) / d0.low,pullback_low = d1~d3 low 最小值 pullback_vol_shrink_avg 回踩期平均缩量程度 d1~d3 volume.mean() / d0.volume pullback_vol_shrink_max 回踩期最大缩量程度 d1~d3 volume.max() / d0.volume high_break d1 向上突破 d0 收盘的幅度 d1.high / d0.close - 1 pullback_amplitude_trend d0~d3 振幅趋势效率 trend_efficiency(d0~d3 amplitude),amplitude = (high - low) / pre_close pullback_amplitude_spearman d0~d3 振幅单调性 spearman_rank_corr(d0~d3 amplitude) 这组特征主要反应五个问题:
回踩时价格走势是否逐日走低?
回踩时成交量走势是否萎缩?
回踩最后与d0 关键支撑位关系,是否守住支撑位)?
d1 是否有过向上的尝试?
d0放量情况,涨停的强势程度?
异常成交额 RPS 特征描述
核心思想:用“当日成交额 / 过去 N 日平均成交额”衡量资金异常关注度,再按交易日做全市场百分位排名,得到 RPS,其中5 日窗口记录短期异动,20 日窗口记录中期波动,RPS 越高说明资金相对更关注;
计算步骤:
①求左移区间(window)平均成交量(过去一段时间平均成交量,不包括当天)
计算方法: amount_ma = amount.shift(1).rolling(window).mean()
②求异常成交量(当前成交量和过去一段时间的平均成交量的比值)
计算方法: abnormal_vol = amount / amount_ma
③根据异常成交量做全市场百分比排名(比如全市场有100只股票,该股票资金相对关注度超全市场95只股票,那么资金相对关注度RPS就为95%)
特征 含义 计算办法 首板当天(d0)市场相对关注度 d0_abnormal_rps_5d d0 涨停日短期资金异常情况 5 日窗口下 d0 的 RPS,缺失填 0.5 d0_abnormal_rps_20d d0 中期资金异常情况 20 日窗口下 d0 的 RPS,缺失填 0.5 回踩期间(d1~d3)市场相对关注度 pullback_abnormal_rps_5d_avg 回踩期平均短期资金关注情况 d1~d3 RPS 平均,缺失填 0.5 pullback_abnormal_rps_5d_max 回踩期最大短期资金关注情况 d1~d3 RPS 最大值,缺失填 0.5 pullback_retention_5d 回踩期资金留存情况 mean(d1~d3 RPS) / d0 RPS,再clip(0,5) pullback_abnormal_rps_20d_avg 回踩期平均中期资金关注情况 d1~d3 的 20 日 RPS 平均 pullback_abnormal_rps_20d_max 回踩期最大中期资金关注情况 d1~d3 的 20 日 RPS 最大 pullback_retention_20d 回踩期中期资金留存情况 mean(d1~d3 20d RPS) / d0 20d RPS,再clip(0,5) 买入当天(d3)市场相对关注度 d3_abnormal_rps_5d d3 当日短期资金关注情况 d3 的 5 日窗口 RPS,缺失填 0.5 d3_abnormal_rps_20d d3 当日中期资金关注情况 d3 的 20 日窗口 RPS 板块特征
特征 含义 计算办法 sector_trend_eff_d0d3 板块 d0~d3 趋势效率 对板块指数 sector_index 做 trend_efficiency sector_rps_10 板块 10 日动量 (sector_index_d3 - sector_index_d3-10) / sector_index_d3-10 sector_limit_up_count_d3 d3 板块涨停家数 sector_df.loc[d3, 'limit_up_count'] sector_relative_strength 个股相对板块强度 个股 d0d3 收益 - 板块 d0d3 收益 sector_vol_ratio 板块成交额/规模近似 n_stocks / 5000 sector_momentum_d0d3 板块 d0~d3 动量 (sector_index_d3 - sector_index_d0) / sector_index_d0 sector_limit_up_change 板块涨停家数变化 d3 limit_up_count - d0 limit_up_count stock_vs_sector_d3 d3 单日个股相对板块强度 d3 个股 pct_chg/100 - d3 板块 sector_ret/100 这组特征主要刻画:板块整体趋势、板块动量、板块涨停效应、个股在板块中的相对强弱。
市场情绪特征
先按交易日构建市场情绪表:limit_up_count = sum(pct_chg >= 9.8)limit_down_count = sum(pct_chg <= -9.8)advance_count = sum(pct_chg > 0)decline_count = sum(pct_chg < 0)total_turnover = sum(amount)sentiment_ratio = limit_up_count / (limit_down_count + 1)advance_decline_ratio = advance_count / (decline_count + 1)turnover_ma20 = total_turnover.shift(1).rolling(20).mean()turnover_ratio = total_turnover / (turnover_ma20 + 1e-8)然后取 d3 当天的值:
特征 含义 market_limit_up_count d3 全市场涨停家数 market_limit_down_count d3 全市场跌停家数 market_sentiment_ratio 涨停/跌停情绪比 market_advance_decline_ratio 上涨/下跌家数比 market_turnover_ratio 总成交额 / 20 日均额 这组特征用于描述 d3 买入时的大盘的市场情绪,反应市场是否强势。
两融特征
特征 含义 计算 margin_change_d0d3 融资余额变化 (d3.margin_balance - d0.margin_balance) / d0.margin_balance margin_buy_ratio d3 融资买入额 直接取 d3.margin_buy short_change_d0d3 融券余额变化 (d3.short_balance - d0.short_balance) / d0.short_balance 衡量杠杆资金在涨停回踩期间是流入还是流出。
市场指数特征
分别对上证和深证的特征计算:
特征 含义 计算 sh_pct_chg / sz_pct_chg d3 指数涨跌幅 pct_chg / 100 sh_vol_pct_chg / sz_vol_pct_chg d3 成交量相对前一日变化 (cur_vol / prev_vol - 1) * 100 sh_trend_eff_d0d3 / sz_trend_eff_d0d3 指数 d0~d3 趋势效率 对指数收盘价做 trend_efficiency 用于刻画买入时点(d3)的两大指数的涨跌和趋势,依旧是反应市场情绪。
个股动量与相对强度
特征 含义 计算 pre10_cum_ret d0 前 10 日累计收益 用 d0 前 10 日到 d0 前一日收盘价计算 relative_strength_10d 个股 10 日相对大盘强度 个股前10日收益 - 大盘同期收益 relative_pre5_ret d0 前 5 日相对强度 个股前5日收益 - 大盘同期收益 relative_ret_d0d3 d0~d3 相对大盘强度 个股 d0d3 收益 - 大盘 d0d3 收益 判断个股在涨停前后是否强于大盘判断它到底有没有独立行情。
K 线形态特征
d3 形态 6 个
特征 含义 计算办法 d3_ret d3 相对 d2 涨跌幅 (d3.close - d2.close) / d2.close d3_amplitude d3 振幅 (d3.high - d3.low) / d3.pre_close d3_close_strength 收盘在当日区间位置 (d3.close - d3.low) / (d3.high - d3.low) d3_net_shadow 净影线 (下影线 - 上影线) / 全日振幅 d3_position_in_d0_range d3 收盘在 d0 实体中的位置 (d3.close - d0.open) / (d0.close - d0.open) d3_vol_ratio_d0 d3 量比 d0 d3.volume / d0.volume d0 形态 3 个
特征 含义 计算办法 d0_body_ratio d0 实体占比 abs(d0.close - d0.open) / (d0.high - d0.low + 1e-8) d0_lower_shadow d0 下影线占比 (min(d0.open, d0.close) - d0.low) / (d0.high - d0.low + 1e-8) d0_vs_ma5 d0 收盘相对 5 日线高度 (d0.close - d0.close_5_mean) / d0.close_5_mean 这组特征描述 d0 涨停强度、d3 回踩 K 线形态和支撑位置。
分时特征
1. d0 涨停形态 6 个
用 d0 当天 5 分钟分时数据计算,涨停价:limit_price = round(prev_close \times (1 + 0.098), 2)
特征 意义 计算方式 limit_time_ratio 首次涨停时间比例 首次触及涨停价的索引 / 当日总K线数 acceleration 涨停前拉升加速度 若涨停前有 60 根 K 线:最后10分钟涨幅 - 之前50分钟涨幅;否则用最后 10 分钟涨幅 n_open_times 涨停后开板次数 统计涨停后跌破涨停价的次数 max_pullback 开板期间最大回落 max((limit_price - close) / limit_price) reseal_time_ratio 平均回封时间比例 平均回封时间 / 涨停后剩余时间 stability_ratio 封板时长占比 封板K线数 / 涨停后剩余时间 刻画 d0 涨停早晚,拉升速度,封板稳定性,封板强度等特征
2. d3 日内分时形态 6 个
用 d3 当天 5 分钟分时数据计算。
特征 意义 计算方法 d3_open30min_ret 早盘 30 分钟涨幅 前 6 根 5 分钟 K 线首尾收盘价涨幅 d3_last30min_ret 尾盘 30 分钟涨幅 后 6 根 5 分钟 K 线首尾收盘价涨幅 d3_high_time_ratio 最高价出现时间比例 最高价索引 / (n-1) d3_low_time_ratio 最低价出现时间比例 最低价索引 / (n-1) d3_intraday_slope 日内价格斜率 对分钟收盘价做一次线性拟合,slope / mean_price d3_vwap_deviation 收盘相对 VWAP 偏离 (收盘价 - VWAP) / VWAP,VWAP 用分钟收盘价×成交量加权 刻画 d3 买入日的日内强弱:早尾盘、最高/最低出现时间、日内趋势和相对均价的偏离特征。
小结:
1、所有特征所用数据必须是d4前的数据,防止数据泄露;
2、d4只用于生成标签,不用于特征值计算;
3、缺失值需要有默认填充值,如0.5
4、趋势效率和spearman秩相关是两个很好的工具,将连续单一的价格数据转化为可量化的趋势形态特征;
5、因为涨停属于日内形态,日内的特征需要使用分时数据进行刻画;
6、RPS必须是相对值的RPS,因为市场中每个股票或者板块其体量是不一致的,为了将不同体量的个体拿到一起公平比较就必须使用相对数据进行比较,比如:个股当天成交量/个股前五天成交量均值。
改善结果:
如下图,测试集AP较2.0版本无明显提升,训练集验证集均有明显提升,但是F0.5从0.24提升至0.36,精确度从0.21提升至0.35,同时测试集正类数量从70提升至638,总体看提升巨大;
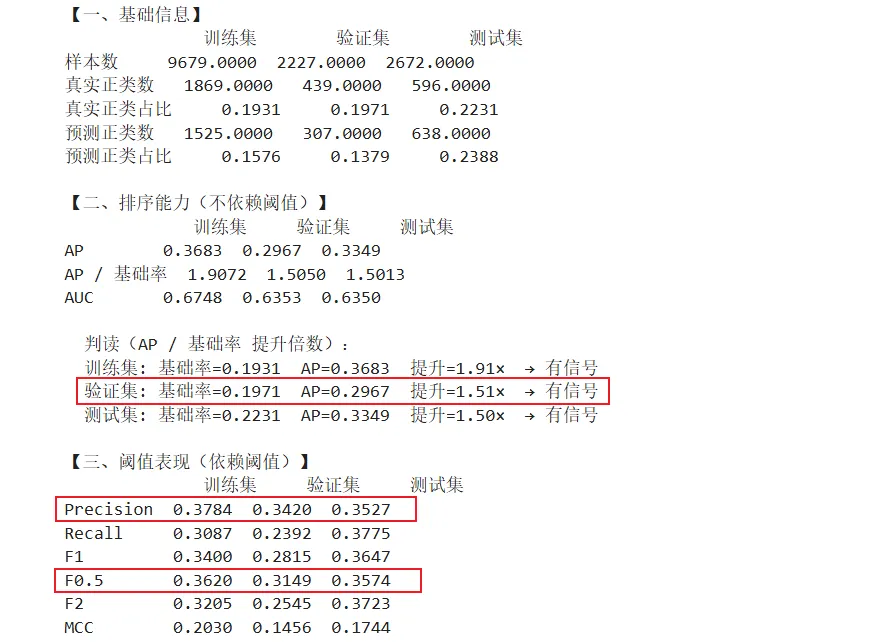
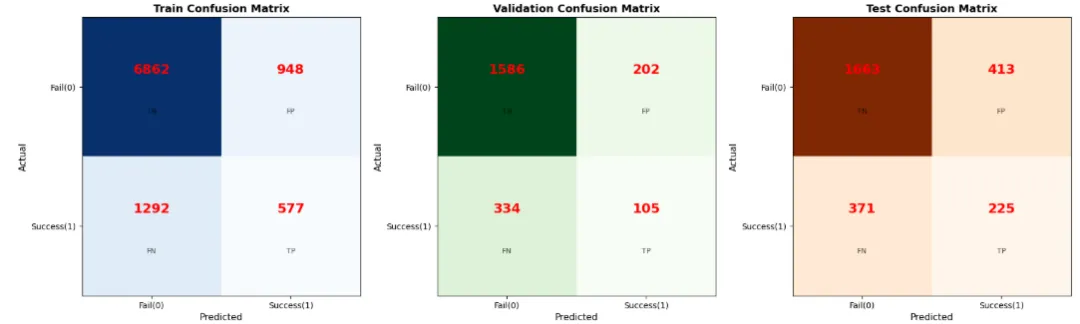
模型版本:v2.5
第五次优化
问题:
为了提升AP,针对68个特征值,其中可能有不重要或者重复性高的特征对模型有干扰,因此需要对特征值进行精简;
同时训练数据之前我没有特别关注,不确定里面是否有异常值,异常值也会对训练过程产生干扰,需要剔除;
改善方案:
精简特征值
需要对68个特征值进行精简,如何精简? 需要去除冗余特征,同时对特征太细的要精简,以及区分特征是否是噪声,首先我们对特征值的重要性进行排序,对排名靠后的特征值进行删除。
特征重要性分析:
网上搜索教程了解到重要性分析需要用GradientBoosting (一种模型)进行交叉验证,使用它的permutation importance (排列重要性)主要思路是:1、先算该模型在这组数据上的初始AP(average_precision)记作base_score;2、将某一列特征随机打乱,其他列不变;3、再使用该模型对这组数据进行预测,计算打乱后的AP,记作permuted_socre;4、排列重要性(PI)= base_score - permuted_score
如果打乱后的得分明显下降,也就是说permutation importance >0,说明这组特征重要,如果 ≈ 0 ,说明这组特征不重要也就是可有可无,如果<0说明这组特征就是干扰项,删掉后AP会上升。
搜索网上教程,做了一个对特征值重要性进行排序的代码,运行结果如下:
Permutation Importance(基于 AP):====================================================================== feature importance_mean importance_std rank d3_amplitude 0.038177 0.004898 1 d3_last30min_ret 0.016350 0.002138 2 d0_vol_ratio 0.013126 0.002059 3 market_advance_decline_ratio 0.008273 0.000817 4 d3_ret 0.008257 0.000915 5 sz_pct_chg 0.006917 0.000808 6 market_turnover_ratio 0.006345 0.000979 7 relative_ret_d0d3 0.005926 0.000846 8 sector_limit_up_change 0.004109 0.000350 9 relative_strength_10d 0.003401 0.000855 10 d3_open30min_ret 0.003215 0.000520 11 pullback_amplitude_trend 0.003138 0.000247 12 relative_pre5_ret 0.002854 0.001447 13 sh_pct_chg 0.002798 0.000652 14 d3_high_time_ratio 0.002202 0.000219 15 pullback_low_vs_d0_low 0.002133 0.000521 16 d3_intraday_slope 0.001989 0.000515 17 sz_vol_pct_chg 0.001930 0.000539 18 d3_abnormal_rps_20d 0.001696 0.000372 19 sector_momentum_d0d3 0.001670 0.000468 20 margin_change_d0d3 0.001582 0.000260 21 d0_vs_ma5 0.001506 0.000369 22 market_limit_down_count 0.001373 0.000399 23 sector_trend_eff_d0d3 0.001352 0.000293 24 sh_trend_eff_d0d3 0.001160 0.000321 25 sector_relative_strength 0.001100 0.000200 26 pullback_abnormal_rps_5d_max 0.001053 0.000372 27 sector_rps_10 0.001020 0.000167 28 pre10_cum_ret 0.000704 0.000316 29 d3_vwap_deviation 0.000649 0.000141 30 d3_position_in_d0_range 0.000642 0.000241 31 d3_low_time_ratio 0.000621 0.000077 32 pullback_vol_shrink_max 0.000619 0.000195 33 d3_close_strength 0.000614 0.000360 34 max_pullback 0.000589 0.000179 35 d0_abnormal_rps_20d 0.000586 0.000133 36 market_limit_up_count 0.000476 0.000154 37 sh_vol_pct_chg 0.000468 0.000071 38pullback_abnormal_rps_20d_avg 0.000408 0.000112 39 pullback_retention_5d 0.000364 0.000126 40 limit_time_ratio 0.000363 0.000105 41 pullback_close_trend 0.000341 0.000121 42 d3_vol_ratio_d0 0.000283 0.000064 43 short_change_d0d3 0.000000 0.000000 44 pullback_retention_20d 0.000000 0.000000 45 pullback_volume_trend 0.000000 0.000000 46 stock_vs_sector_d3 0.000000 0.000000 47 pullback_volume_spearman 0.000000 0.000000 48 pullback_vol_shrink_avg 0.000000 0.000000 49 sector_vol_ratio 0.000000 0.000000 50 stability_ratio 0.000000 0.000000 51 reseal_time_ratio 0.000000 0.000000 52 pullback_close_spearman 0.000000 0.000000 53 n_open_times 0.000000 0.000000 54 acceleration 0.000000 0.000000 55 high_break 0.000000 0.000000 56 d3_abnormal_rps_5d 0.000000 0.000000 57 d0_lower_shadow 0.000000 0.000000 58 d0_body_ratio 0.000000 0.000000 59pullback_abnormal_rps_20d_max 0.000000 0.000000 60 margin_buy_ratio 0.000000 0.000000 61 d3_net_shadow 0.000000 0.000000 62 market_sentiment_ratio 0.000000 0.000000 63 pullback_amplitude_spearman 0.000000 0.000000 64 d0_abnormal_rps_5d 0.000000 0.000000 65 pullback_abnormal_rps_5d_avg 0.000000 0.000000 66 sz_trend_eff_d0d3 0.000000 0.000000 67 sector_limit_up_count_d3 0.000000 0.000000 68特征值重要性排序结果分析:
1.把这68 个特征按重要性排名分成 4 档:
档位 排名 重要性范围 特征数量量 占比 核心 1~10 0.003~0.038 10 15% 有效 11~28 0.001~0.003 18 26% 边缘 29~43 0.0003~0.0007 15 22% 垃圾 44~68 = 0 25 37% 令我惊讶的是37%的特征是无效的,前15%的特征居然贡献了大部分的预测力;
2.d3 当天日内状态起决定性作用:
排名 特征直 特征说明 重要性PI 1 d3_amplitude d3振幅:(d3['high'] - d3['low']) / d3['pre_close'] 0.0382 2 d3_last30min_ret d3尾盘 30 分钟涨幅last_6['close'].iloc[-1] - last_6['close'].iloc[0])/ last_6['close'].iloc[0] 0.0164 5 d3_ret d3涨跌幅(相对于d2收盘)(d3['close'] - d2['close']) / d2['close'] 0.0083 这说明了d4的表现和d3日内状态关系很大
3.市场环境比个股形态更重要
前 10 名里有 3 个是市场/板块特征:
排名 特征 含义 4 market_advance_decline_ratio 全市场涨跌比 7 market_turnover_ratio 成交额相对变化 9 sector_limit_up_change 板块涨停数变化 第 6 名 sz_pct_chg(深证涨跌)、第 14 名 sh_pct_chg(上证涨跌)、第 18 名 sz_vol_pct_chg——市场特征整体很强,因此d4 能不能放量上涨还需要看大盘状态;
4.相对强度是关键
第 8 名 relative_ret_d0d3、第 10 名relative_strength_10d、第 13 名 relative_pre5_ret——3 个相对强度特征全部进入前 15,说明个股相对大盘的相对强度也是筛选强势股的核心;
5.d0 的日内形态几乎无效
d0 分时特征的排名如下:
特征 排名 limit_time_ratio 41 n_open_times 54 acceleration 55 reseal_time_ratio 52 stability_ratio 51 max_pullback 35 都在边缘和垃圾区域,这个有点反直觉,因为以之前对涨停回踩策略的了解,一般d0涨停具体是怎么涨的也是一个选股要素,有三个解释,一是目前用的5分钟分时,颗粒度大,看不出细节(后续优化可以考虑1分钟数据,数据量会成倍增长),二就是d0与d4相隔太久。
6.RPS 特征有信号但不强
特征 排名 d3_abnormal_rps_20d 19 pullback_abnormal_rps_5d_max 27 sector_rps_10 28 d0_abnormal_rps_5d 65(0) pullback_abnormal_rps_5d_avg 66(0) RPS 系列里,只有 3 个进有效区,虽然RPS 有信号,但只在特定组合下才能发挥效果。
7.两融特征几乎无效
特征 排名 margin_change_d0d3 21 margin_buy_ratio 61(0) short_change_d0d3 44(0) 两融整体贡献 < 0.002,删掉不影响 AP,主要原因可能是两融覆盖不足另外两融变化滞后并且数据颗粒度大只到日级等
8.pullback 系列中等偏弱
特征 排名 pullback_low_vs_d0_low 16 pullback_amplitude_trend 12 pullback_abnormal_rps_5d_max 27 pullback_vol_shrink_max 33 pullback_retention_5d 40 其他 pullback 特征 45+ 一开始回踩硬筛选条件可能已经起到过滤作用,剩下的信息有限;
改善方案:
针对以上特征重要性总结,目前最简单的就是删除部分垃圾特征,于是我选出垃圾特征将其放入特征黑名单:
# 特征黑名单:删掉重要性接近 0 的特征# ============================================================DROP_FEATURES = ['short_change_d0d3', # 重要性 0'sector_limit_up_count_d3', # 重要性 0'market_sentiment_ratio', # Permutation=0'margin_buy_ratio', # Permutation=0'sector_vol_ratio', # Permutation=0'n_open_times', # RF 低 + 分时'acceleration', # RF 低 + 分时'reseal_time_ratio', # RF 低 + 分时'max_pullback', # 重要性 0'pullback_close_spearman', # 重要性 0'pullback_volume_spearman', # 重要性 0'pullback_vol_shrink_avg', # 重要性 0'limit_time_ratio', # 重要性 0'pullback_abnormal_rps_20d_max',# 重要性 0'pullback_abnormal_rps_5d_avg', # 重要性 0'd0_lower_shadow', # 重要性 0'd3_abnormal_rps_5d', # 重要性 0'd3_net_shadow', # 重要性 0'd0_body_ratio', # 重要性 0]# 从特征列表里排除feature_cols = [c for c in feature_cols if c notin DROP_FEATURES]结果如下:
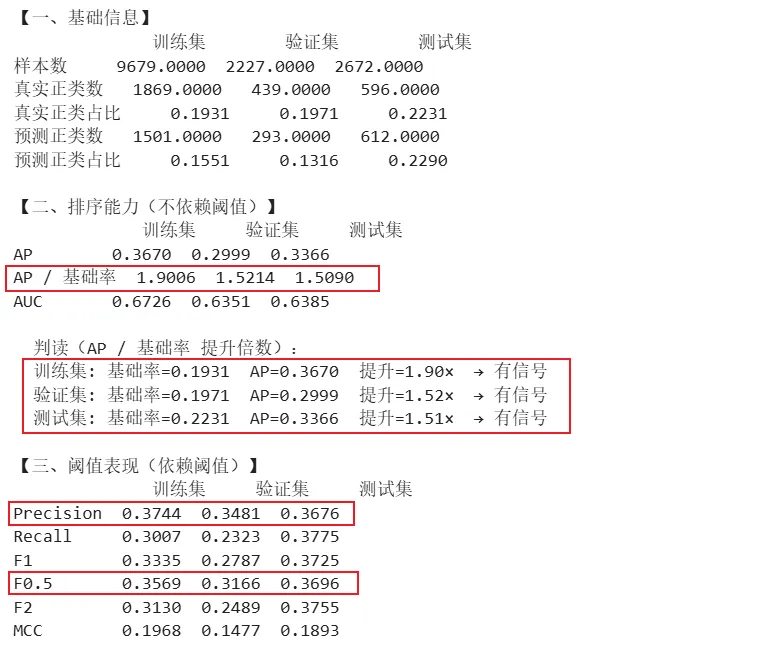
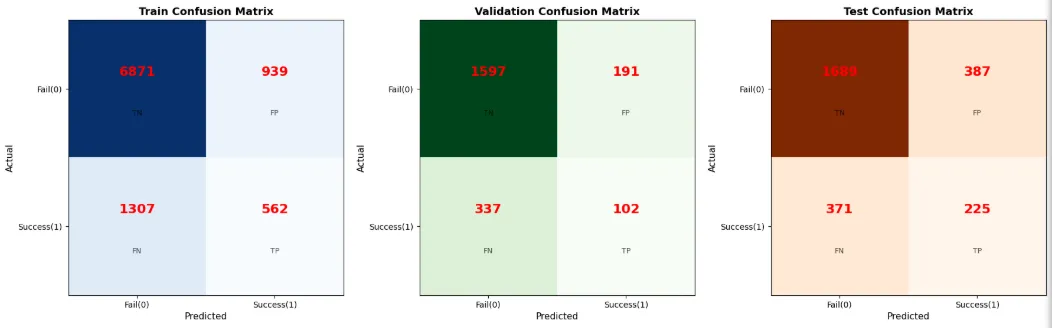
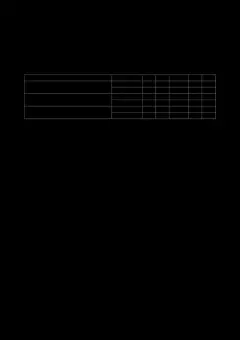
版本:v2.5.2
可以看到在删除了19个特征值后,AP / 基础率 在验证集和测试集上均提升了0.01,虽然提升不多,但都没有下降,因此这19个特征删除后对模型排序能力无影响,而且在一定程度上提升了模型的稳定性,同时模型在验证集和测试集的精确率也有一点点提升,改善是有效的。
另一个改善方向是顺着目前的排序,将重要性排名靠前的 d3 当天日内分时特征以及市场情绪特征再细化,比如d3分时数据精确到1分钟,同时获取以下特征:
可加特征 需要数据 逻辑 d3 尾盘 30 分钟成交量占比 5 分钟 尾盘资金青睐度 d3 大单净流入 Level-2 主力流向 d3 成交量分布(1分钟数据) 1 分钟 早盘 vs 尾盘对比 d3 相对 MA5/MA10/MA20 位置 日线 短期 d3 跳空缺口大小 日线 强势信号 d3 上下影线占比 日线 抛压/承接 d3 收盘相对 d0 开盘位置 日线 回踩深度 以及市场情绪特征当前只有涨跌比、成交额比,太粗,可以增加新特征,如:
考虑增加的特征 数据 主要逻辑 涨停家数 市场日线 情绪强度 跌停家数 市场日线 恐慌程度 连板高度 市场日线 情绪持续性 炸板率 市场日线 分歧程度 昨日涨停今日表现 市场日线 情绪延续性 全市场成交额分位数 市场日线 资金活跃度 大盘 MACD 状态 指数 技术形态 这些是后续优化方向,目前就先这样了,没啥时间继续优化了。
第六次优化
问题:
目前的所有版本均围绕d4最高超5%来设定的二分类模型,不可以直接知道盈亏结果,d4超5%并不能说明什么,因为你不一定能抓得住;
改善方案:
增加label2标签:实际盈亏结果
将实际盈亏百分比做成label标签,即在满足潜在条件的样本里,计算d3买入后(尾盘买入,为方便起见,默认d3['close']),使用涨超5%后若回落超0.5%时止盈,跌幅超支撑位(如五日线)时止损卖出,最迟到d6,如果不触发卖出则收盘前以收盘价卖出,这样将每个样本的实际盈亏结果和一个设定阈值做比较,如果高于阈值则记为1,此时为买入信号,如果低于阈值则记为0,此时建议不买,这样可以做到预测结果和收益直接关联;
改前标签(v2.5.2及之前版本):
以d4 最高是否高于5%作为判断条件,是则为1不是则为0:
label = 1if (d4['high'] - d3['close']) / d3['close'] >= 0.05else0改后标签(摘自v2.7)
将盈利超过 2%”定义为正类,解决前一版本标签与收益不挂钩的问题:
THRESHOLD = 0.02#阈值条件df_actual['label2'] = (df_actual['actual_return'] >= THRESHOLD).astype(int)而具体盈利怎么计算?于是下面我引入了模拟交易路径
模拟交易:
引入模拟交易原则:止盈止损以及到期卖出
d4涨超 5% 后,从高点回落一定幅度(如1%)时止盈;
d4跌破止损价则止损;
最迟到 d6若仍未触发买卖则收盘按收盘价卖出,
这样得出连续收益actual_return 而非 0/1标签。
具体代码逻辑如下:
1.买入点:d3收盘价d3_close
2.d4~d6数据来源:d4~d6 5 分钟分时数据,从缓存 {ts_code}_{d0_date}_extra.parquet 读取(预先下载好的缓存数据)
3.止损价:先取结构低点 d0_low 与 buy_price - 1.5*ATR 中更低者,再与 buy_price * 0.95 取较高者,保证最大亏损不超过 5%
wider_stop = min(d0_low, buy_price - 1.5 * atr)stop_price = max(wider_stop, buy_price * 0.95)4.止盈:
①触发点位 (take_profit):tp_trigger_price = buy_price * (1 + take_profit),默认 take_profit=0.05,即上涨超5%;
②回落量(trail_drop):从最高点回落 trail_drop 时卖出;
5.止损:任一时刻价格 price <= stop_price 即卖出;
6.到期:若一直到 d6都未触发止盈止损,则在d6收盘价卖出;
7.返回:(收益率, 卖出原因),收益率 = (卖价 - 买价) / 买价
模拟交易完整代码
# 计算止损价defcompute_stop_price(buy_price, d0_open, d0_low, ma5, atr, stop_type='combo1'):""" 计算止损价。 combo1 = max(buy_price - 1.5×ATR, d0_low, buy_price × 0.95) """if stop_type == 'combo1':# 先在结构低点和ATR止损中选更低的,给足空间 wider_stop = min(d0_low, buy_price - 1.5 * atr)# 再用最大亏损限制兜底保证亏损不超5%returnmax( wider_stop, buy_price * 0.95 )elif stop_type == 'pct':return buy_price * 0.98elif stop_type == 'ma5':return ma5elif stop_type == 'd0_low':return d0_lowelse:return buy_price * 0.98# 路径模拟:从 d3 收盘买入,到触发卖出defsimulate_trade_path(d3_close, d4_d6_min, stop_price, take_profit=0.05, trail_drop=0.01):""" 模拟从 d3 收盘买入,到触发卖出的过程。 规则: 1. 涨 5% 后,从高点回落 0.5% → 止盈 2. 跌破 5 日线 → 止损 3. 最迟到 d6 收盘 → 按收盘价卖出 参数: d3_close : d3 收盘价(买入价) d4_d6_min : d4~d6 的分钟数据(含 datetime, close) ma5_at_d3 : d3 收盘时的 5 日线(固定不变,防止前视) take_profit : 止盈触发线(默认 5%) trail_drop : 回落止盈幅度(默认 0.5%) 返回: (收益, 卖出原因) 收益 = (卖价 - 买价) / 买价 卖出原因: 'take_profit' / 'stop_loss' / 'time' """if d4_d6_min isNoneorlen(d4_d6_min) == 0:return (0.0, 'no_data') buy_price = d3_close tp_trigger_price = buy_price * (1 + take_profit) highest = buy_price df = d4_d6_min.sort_values('datetime').reset_index(drop=True)for _, row in df.iterrows(): price = row['close']# 1. 止损(跌破传入的止损价)if price <= stop_price:return ((price - buy_price) / buy_price, 'stop_loss')# 2. 更新最高价if price > highest: highest = price# 3. 止盈:曾涨 5% 且从高点回落 1%if highest >= tp_trigger_price:if price <= highest * (1 - trail_drop):return ((price - buy_price) / buy_price, 'take_profit')# 4. 到 d6 收盘 last_price = df.iloc[-1]['close']return ((last_price - buy_price) / buy_price, 'time')# d4~d6 分时数据读取defload_minute_extra_days_from_cache(ts_code, d0_date):""" 从缓存读 d4~d6 分时数据。 """ cache_path = os.path.join( MINUTE_CACHE_DIR,f"{ts_code}_{str(d0_date).replace('-', '')}_extra.parquet" )ifnot os.path.exists(cache_path):return pd.DataFrame()try:return pd.read_parquet(cache_path)except Exception:return pd.DataFrame()在 extend_with_minute_features 函数中的调用上面函数片段
# 【新增】d4~d6 路径模拟 buy_price = row['d3_close'] d0_open = row['d0_open'] d0_low = row['d0_low'] ma5 = row['ma5_at_d3'] atr = row['atr_at_d3']# 计算止损价(combo1)if pd.notna(buy_price) and pd.notna(atr) and atr > 0: stop_price = compute_stop_price( buy_price, d0_open, d0_low, ma5, atr, stop_type='combo1' )else: stop_price = buy_price * 0.98if pd.notna(buy_price) else0# 读 d4~d6 分时 d4_d6 = load_minute_extra_days_from_cache(ts_code, d0_date)ifnot d4_d6.empty and pd.notna(buy_price): ret, reason = simulate_trade_path( buy_price, d4_d6, stop_price, take_profit=0.05, trail_drop=0.01 )else: ret, reason = 0.0, 'no_data' actual_returns.append({'actual_return': ret,'exit_reason': reason, })
label2 标签原理与完整代码
1. 原理
2. 完整代码(摘自v2.7)
在 extend_with_minute_features 中,使用模拟交易得到 actual_returns 列表后:
python
# ---- 合并 + 保存 ---- df_minute = pd.DataFrame(minute_features_list) df_actual = pd.DataFrame(actual_returns) # 【新增】 # 新增:生成 label2(第二个标签:盈利标签) THRESHOLD = 0.02 # 收益阈值,可根据需要调整 df_actual['label2'] = (df_actual['actual_return'] >= THRESHOLD).astype(int) samples_out = pd.concat([samples, df_minute, df_actual], axis=1)输出统计与不同阈值对比:
python
print(f"\n新增标签 label2(阈值 = {THRESHOLD:.2%}):") print(f" 正类占比:{df_actual['label2'].mean():.2%}") print(f" 正类数: {df_actual['label2'].sum()}") print(f" 负类数: {len(df_actual) - df_actual['label2'].sum()}") # 不同阈值下的label2正类占比对比 print(f"\n不同阈值下的正类占比:") for t in [0.01, 0.02, 0.03, 0.04, 0.05]: pos = (df_actual['actual_return'] >= t).mean() print(f" 阈值 {t:.0%}:正类占比 {pos:.2%}")后续第三部分数据初处理中,label2 被排除在特征之外,并作为分类标签使用:
python
EXCLUDE_COLS = ['ts_code', 'trade_date', 'label', 'actual_return', 'exit_reason', 'd0_open', 'd0_low', 'd3_close', 'ma5_at_d3', 'ma10_at_d3', 'atr_at_d3', 'ex_in_features', 'ex_in_labels', 'label2', # 二分类标签,不是特征 ]# 分离标签y_train_cls2 = train_df_orig['label2'].to_numpy()y_val_cls2 = val_df_orig['label2'].to_numpy()y_test_cls2 = test_df_orig['label2'].to_numpy()第四部分逻辑回归中,v2.7 明确用 label2 作为预测目标:
python
y_train = y_train_cls2.reshape(1, -1)y_val = y_val_cls2.reshape(1, -1)y_test = y_test_cls2.reshape(1, -1)第五部分超参数搜索中:
python
Y_raw = y_train_cls2.flatten() # 使用新的标签label2先对每个样本使用上面的模拟交易原则得到每个样本的 actual_return(连续收益率,小数形式,如 0.021 表示 2.1%)。
设定阈值 THRESHOLD,默认 2%。
若 actual_return >= THRESHOLD,则 label2 = 1,否则 label2 = 0。
这样就把盈利和二分类标签挂钩。
阈值可调,报告中可对比 1%、2%、3%、4%、5% 下的正类占比。
改善结果:
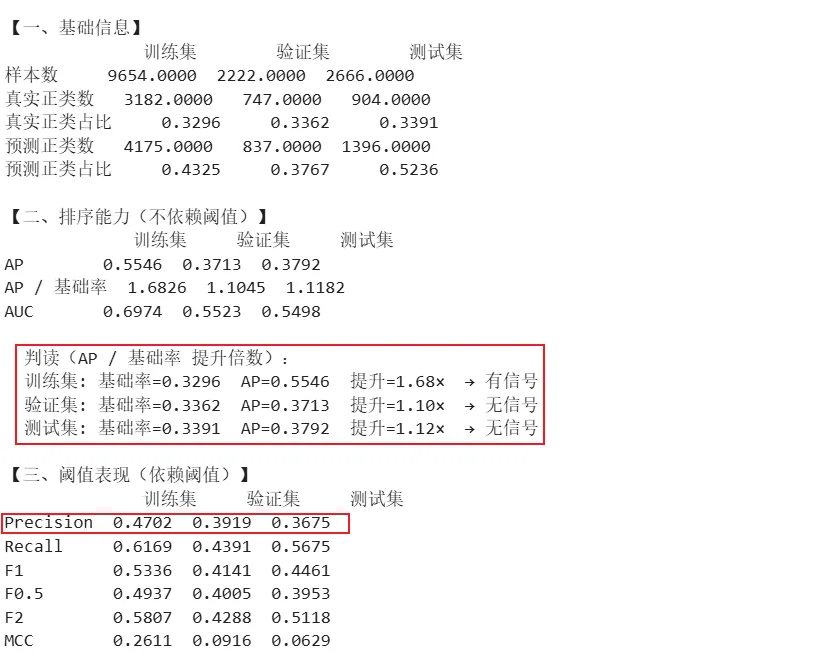
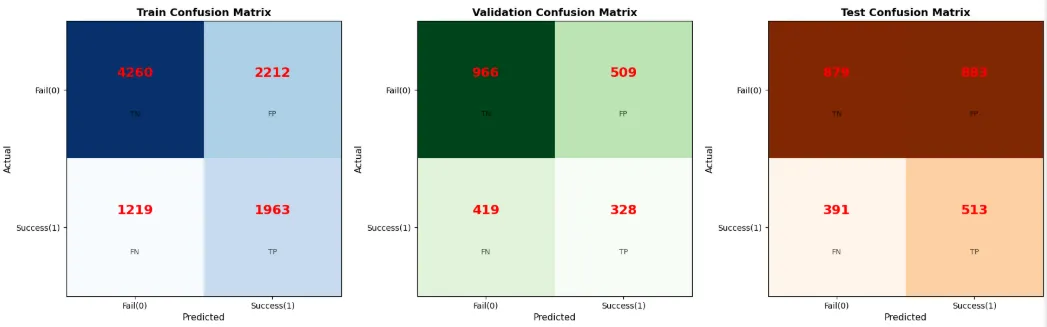
分析:结果出来说实话有点失落,可以看出AP / 基础率 倍率明显下降,直接从之前的1.5以上到现在验证集只有可怜的1.1不到,根本原因我大概分析了应该是以下几个方面:1.模型从预测短期事件(d4冲高)变成了预测长期事件(d4~d6盈利),预测难度明显增加,但是我的信息量(特征值的丰富程度)并没有增加,因此预测能力明显下降;2.正类的基础率有提升,分母变大倍率自然变小;3.我的模拟交易原则说白了就是一个拍脑袋决定的结果,并没有验证这个方案是不是合理,这个方案引入了新的噪声,所以预测难度更高了;
改进方向:
增加d4~d6 持有期收益相关的特征:d4~d6 的信息对结果影响很大,但目前的模型并没这方面信息,现有特征对未来的解释力很弱,因此可以增加一些关于d4~d6的K线特征、大盘、资金流向、个股强度等特征,但前提是不可以造成数据泄露。
优化标签:该版本的根本目标是预测收益大小而并非分类问题,因此回归模型会更接近目标,回归可以避免二分类阈值造成的信息损失。
模型正则化:模型有明显的训练集效果好,验证集测试集效果差,典型的过拟合现象,因此需要增加正则化。
检查模拟交易原则的合理性:止损止盈参数不能按自己的喜好给,需要遍历不同参数选最合理的交易原则。
本轮优化总结:
增加分时特征确定是有用的方式,在第四轮优化中,模型AP得到了有效的提升,同时第五次优化中的精简特征值,对模型的稳定性也有贡献,在第六次优化中,我们发现对于未来更久时间及更复杂结果的预测,模型出现了明显的力不从心,此时我们就需要寻找能够提供更多信息量的特征值,这一轮优化完,我确定要先去补充基础知识了,而不是在这个项目上一直耗着,在我目前的能力下,这个项目对我来说就是一个无底洞,在这个项目上我学到了很多,同时也认识到了很多不足,写这些文章的时候有很多主观性,读者可能看了一头雾水或者也有可能看了觉得这个优化过程很呆,也有可能和我一样学到了一些东西,但是不管怎样,这个项目到此先结束了,谢谢看完,晚安~~~~~~~~~