ARTICLE · 1181849
把老文档全塞给 AI?这是最容易踩的坑
新项目从零积累知识不难。
难的是老项目:资料已经散落各处好几年了。
PRD、设计文档、会议纪要、排障记录、第三方官方文档……还有最容易被忽略的一类:过去和 AI 聊出来的结论。
01 两个常见的坑
坑一:全量复制。把所有文档原样搬进来。Wiki 变成又一个文档仓库,还可能顺手带进密钥、客户数据和生产日志。
坑二:只记链接。Wiki 里只有一堆地址,AI 照样看不到内容。
PDC 的做法是:不同资料,不同处理深度。
02 按类型处理
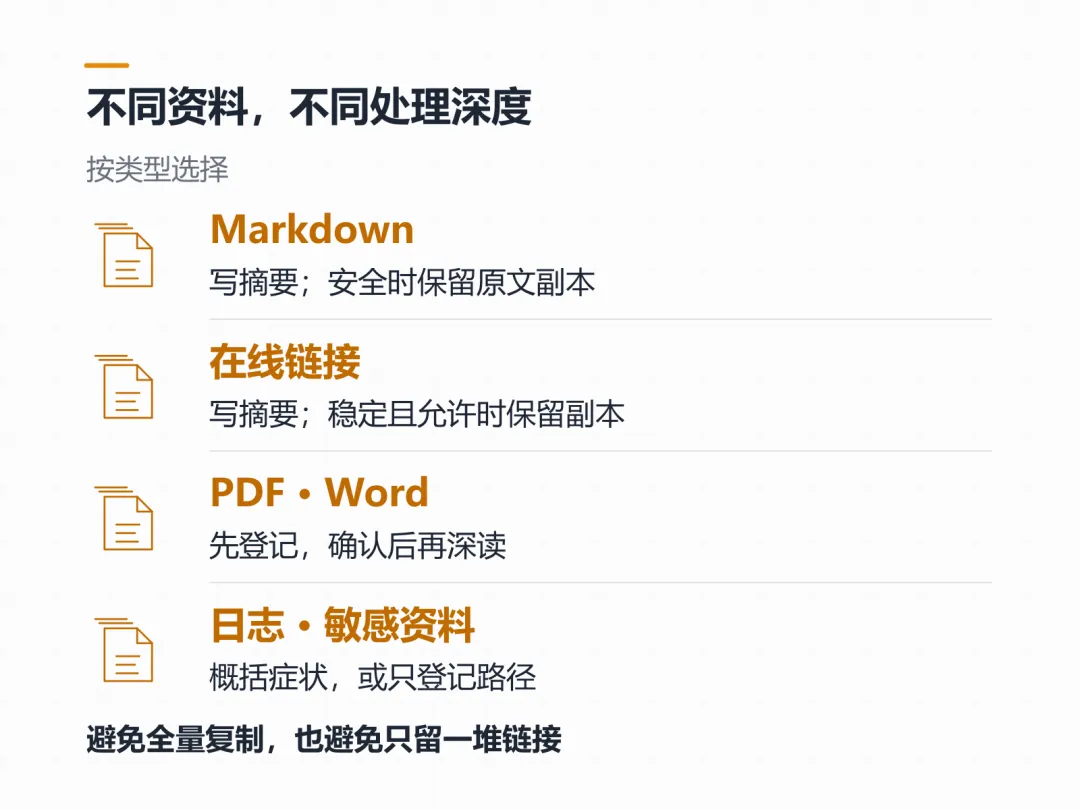
Markdown 文档:写摘要,安全时再存一份原文副本。
在线链接:写摘要,内容稳定且允许时才存副本。
PDF、Word:先登记路径,确认后再读。
日志和敏感资料:只概括症状,或者只记路径。
遇到有风险的资料,AI 会先问一句:
这份资料可能包含敏感数据,要不要只记录路径?
多问一句成本很低。把生产日志写进团队共享的 Wiki,代价很高。
03 每次导入都可追溯
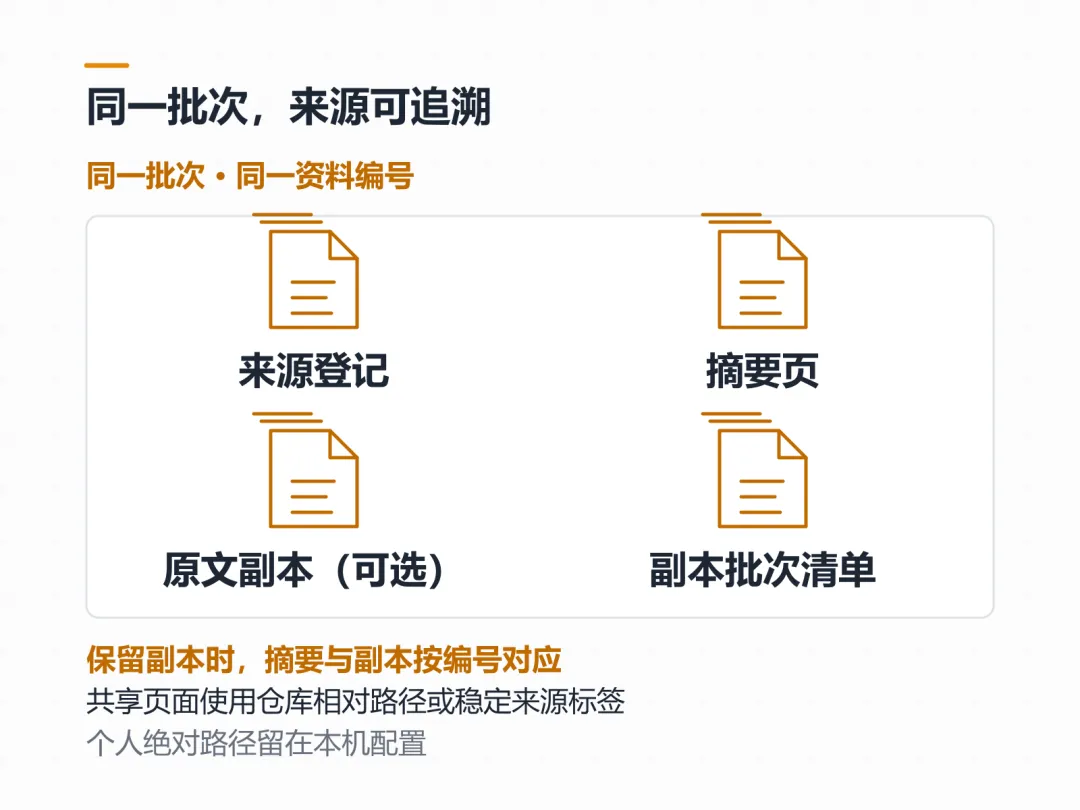
资料按批次登记;有原文副本的批次会附清单,摘要与副本按编号对应。
还有一条硬规则:个人电脑上的绝对路径,不写进团队共享的 Wiki 页面。
否则一提交,同事看到的就是一堆打不开的 D 盘地址。
04 进来的资料,默认只是“候选”
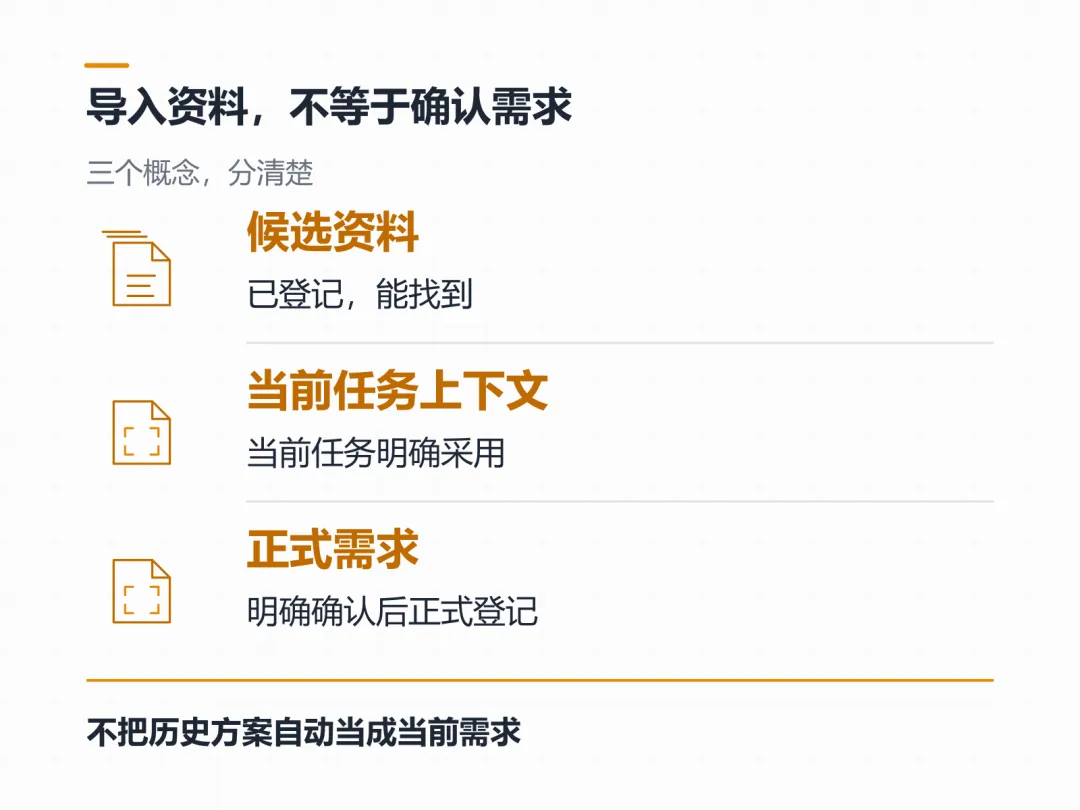
这是最容易被忽略的设计。
资料进入 Wiki,只代表它存在、能被找到。它不会自动变成当前任务的上下文,更不会自动变成需求。
这避免了一个真实风险:AI 把几个月前的废弃方案,当成当前需求去实现。
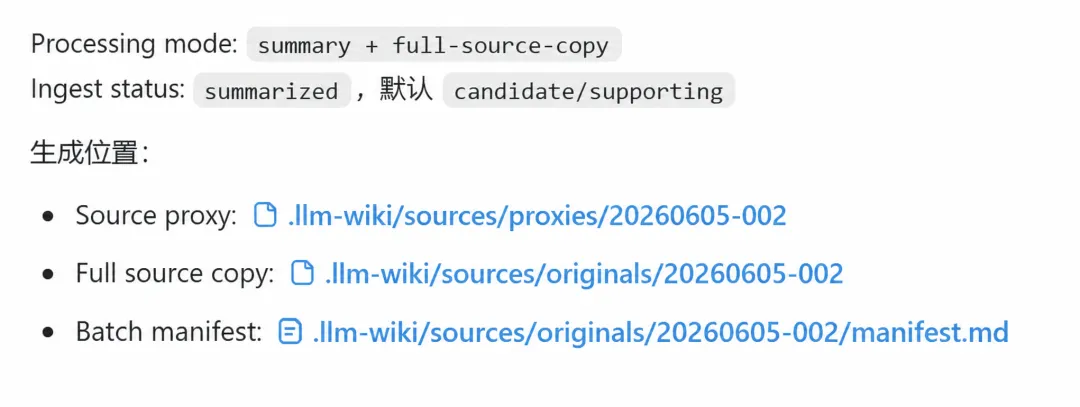
历史摄入回执片段:处理模式为摘要加原文副本,状态为 summarized,默认 candidate/supporting;下方列出同批次的摘要、副本与清单位置。 图片经 AI 裁整,模式、状态及三条路径已对照原始截图核对。 点击图片可查看大图。
05 聊天记录为什么要单独处理
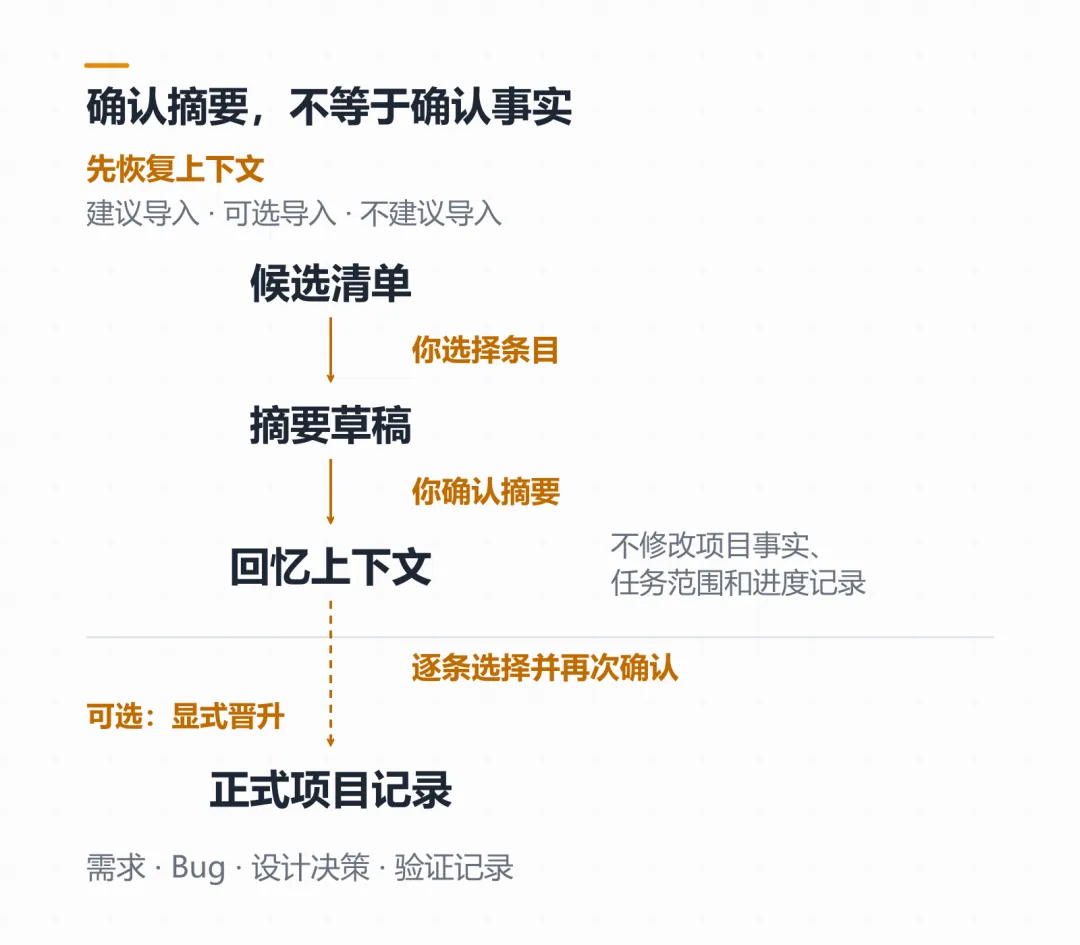
依据文中约定绘制;确认回忆摘要与正式登记条目分开处理。
很多关键结论从没写进文档,只存在于某次和 AI 的长对话里。
但对话很乱:需求线索、Bug 症状、设计决策、失败尝试、闲聊、过时的想法,全混在一起。
直接把它们写成需求,就是在制造虚假的项目事实。当时随口一句“就这么做吧”,可能早被推翻了。
所以 PDC 处理对话分三步:
第一步,AI 给出候选清单:建议导入、可选导入、不建议导入。
第二步,你挑选要保留的条目,AI 生成摘要草稿。
第三步,你确认后才写入,并且明确标注:
只用于回忆,不修改任何项目事实。
如果某一条确实是需求,要再走一次“显式晋升”,由你确认后才正式登记。
06 冲突时听谁的
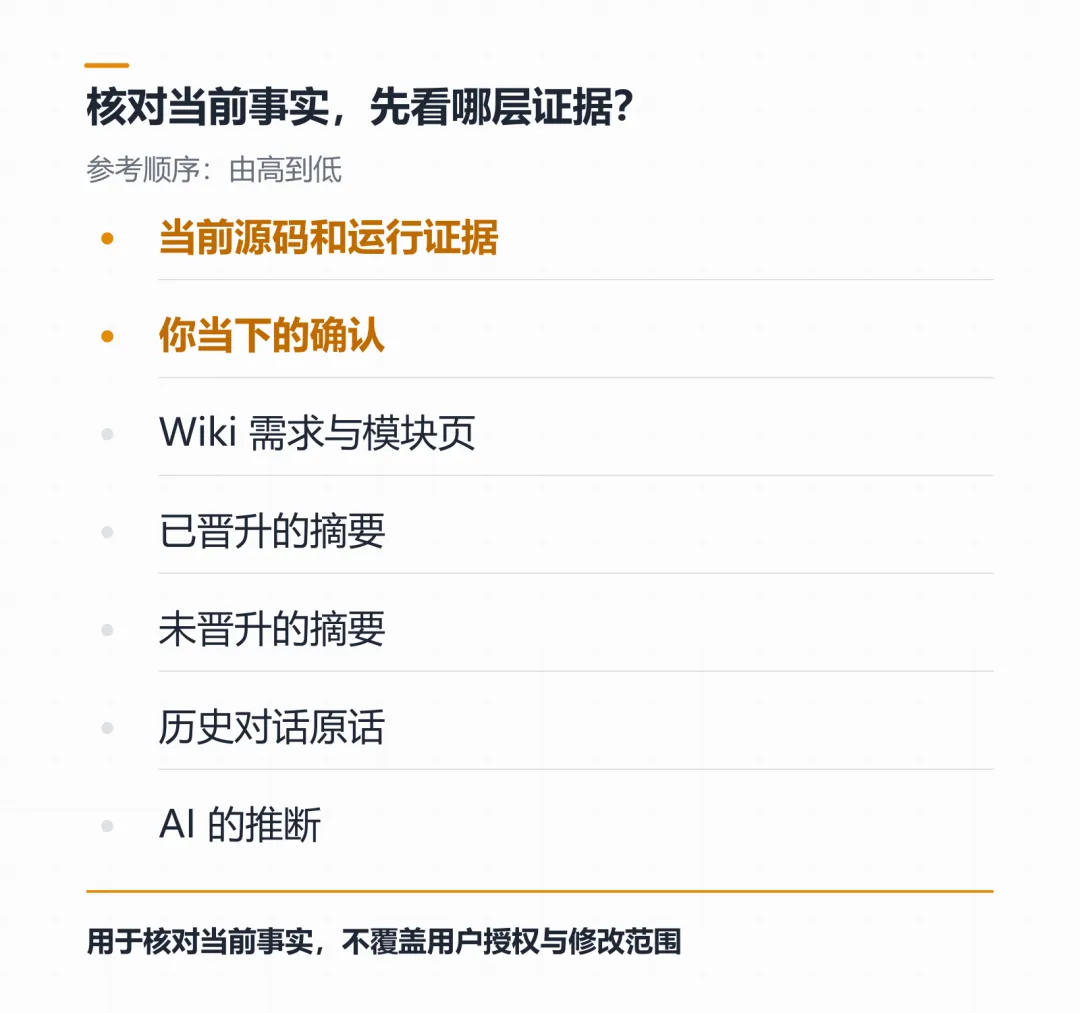
核对当前项目事实、处理信息冲突时,PDC 按下面的顺序参考证据,从高到低:
当前源码和运行证据 → 你当下的确认 → Wiki 里的需求和模块页 → 已晋升的摘要 → 未晋升的摘要 → 历史对话原话 → AI 的推断。
历史对话很有价值,但它不是事实。
写在最后
接入老资料,关键不在导得多,而在三件事:
按类型选择深度,默认只作候选,来源永远可追溯。
但资料进来了,总有过期的一天。下一篇讲我最看重的设计:怎么防止 Wiki 腐烂。
项目已开源,地址:
https://github.com/huajiexiewenfeng/role-copilot-skills/tree/main/project-agent-copilot/project-develop-copilot
你会把和 AI 的聊天记录当成项目文档吗?欢迎留言。