ARTICLE · 1217926
AI设计日报 · 20261020 | 视频提速 22 倍,编辑搬进对话框
AI设计日报 · 20261020
视频提速 22 倍,编辑搬进对话框
ISSUE No.011 · 2026年10月20日 · 星期二 本期主题:AI 视频与图片设计领域的工具、方法与短剧智能体动态
速览表
编号 | 领域 | 标题 | 一句话看点 |
01 | 视频模型 | fal × Black Forest Labs 发布 FLUX 3 Max | 10 秒视频 10.95 秒出片,同画质下比 Seedance 2.5 快 22 倍 |
02 | 图片编辑 | Krea 3 发布:2K 原生编辑进 8 秒 | 首个支持 LoRA 微调的编辑模型,1K 定价 0.03 美元 |
03 | 设计工具 | Adobe 把 Photoshop 编辑器搬进 ChatGPT | 选区+滑块+对话三者双向同步,PDF 批注也进侧边栏 |
04 | 开源工作流 | HeyGen 开源 HyperFrames,HTML 直接渲染 MP4 | 6.7 万星、Apache-2.0,视频生产从"剪时间线"变成"写代码" |
05 | 短剧工业化 | 华西证券:AI 短剧全年或破 400 亿 | 精品剧成本降 90%,TikTok 短剧分成破 3100 万美元 |
06 | 内容出海 | 中央广播电视总台发布多语种短剧漫剧 AI 平台 | 打通创作/译制/审核/分发全流程,同步推出 AI 漫剧《莉雅》 |
07 | 智能体底座 | NVIDIA 开源 Nemotron 3.5 Super VL 与 Bolt | 1200 亿参数、视觉理解专攻智能体,24GB 可端侧跑 74B |
01 · FLUX 3 Max:10 秒出 10 秒,视频生成进入"实时时代"
发生了什么
10 月 19 日,生成式媒体平台 fal 宣布与 Black Forest Labs 联合发布 FLUX 3 Max。这是 BFL 首次把基础模型交给外部团队做深度后训练——fal Research 负责后训练、强化学习与推理优化,BFL 提供 FLUX 3 底座。
关键数字
指标 | FLUX 3 Max | 对比 |
Artificial Analysis Video Arena(图生视频) | 1,139 Elo(4,868 票) | 与 Seedance 2.5(1,139)持平 |
10 秒视频生成耗时 | 10.95 秒 | Seedance 2.5 需 277.80 秒 → 快 22 倍 |
相对初代 FLUX 3 | Elo 1,089 → 1,139 | 质量 +50 分 |
相对初代 FLUX 3 | 126.44 秒 → 10.95 秒 | 推理快 11.5 倍 |
发布定价 | $0.0425 / 秒输出 | 按秒计费,无订阅门槛 |
为什么值得关注
1."快"第一次成为和"好"并列的独立指标。 过去视频模型的竞争只看画质分,这次 fal 明确把"10.95 秒出 10 秒"当作和 Elo 同等的宣传核心——这意味着迭代式创作(同一分镜改 5 遍)第一次在经济上可行。
2.同画质下 22 倍速,直接改写成本结构。 在同样 1,139 Elo 的队列里,Seedance 2.5 需要 277.8 秒,FLUX 3 Max 只需 10.95 秒。做 100 条 10 秒素材的差别是「等 7.7 小时」与「等 18 分钟」。
3.当前边界要说清楚。 目前仅开放 720p,支持文生视频与图生视频两个端点,官方页面同时列了关键帧生视频但尚未全部上线;需要 1080p 以上或精细关键帧控制的团队要先确认可用性。
给设计工作流的实际建议
·分镜预演阶段用 FLUX 3 Max 做高频试错,正式出片再用可灵 4.0 / Seedance 这类支持 30 秒原生的模型锁定终稿——"快"和"可控"目前仍是两个模型。
·按秒计费 + 无最低消费的模式,非常适合小团队做多版本 A/B 测试。
🔗 来源:https://aixvz.cc/news/fal-launches-flux-3-max-video-model-with-black-forest-labs
🔗 来源:https://www.morningstar.com/news/pr-newswire/20261019sf75635/fal-launches-flux-3-max-delivering-1-tier-image-to-video-quality-at-industry-leading-speeds
02 · Krea 3:图片编辑进入"可交付"阶段
发生了什么
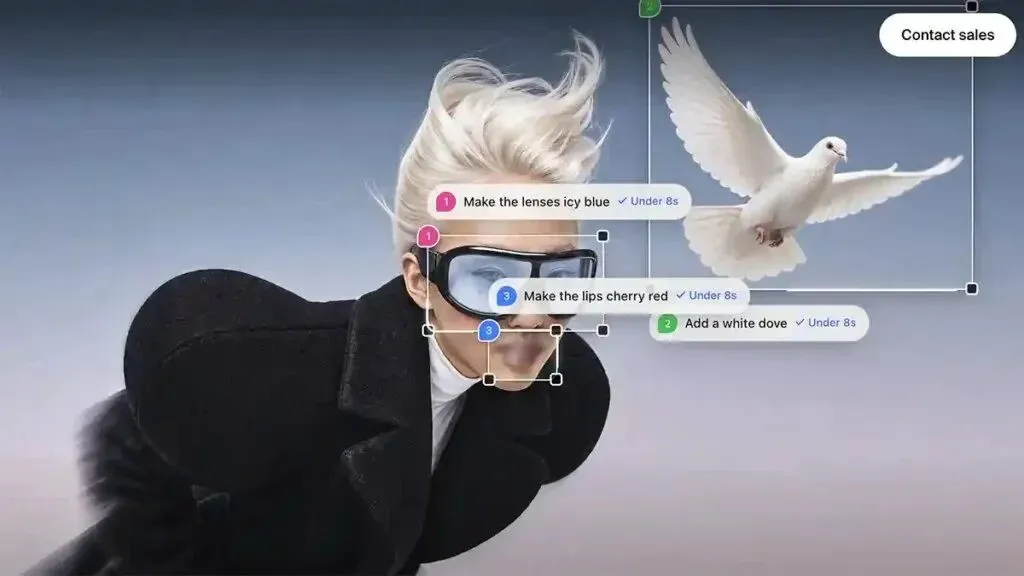
Krea 推出新一代图像编辑模型 Krea 3,主打生产级可用性——速度、可控性与一致性三线同时推进。
核心能力
·速度:2K 编辑端到端低于 8 秒。官方称比 GPT Image 2 快 10 倍,比 Nano Banana Pro 快 4 倍。
·分辨率:原生 2K 输出,最高支持 4K(印刷与大屏)。
·区域编辑与框选定位:只改指定区域,其余画面完全不动;新增元素可通过边界框精确落位。
·参考图:单次编辑最多支持 6 张参考图,含风格参考。
·LoRA 微调:官方称这是首个支持针对特定商品、人物或风格做 LoRA 微调的编辑模型——意味着一批图能保持高度一致。
·CPI-Bench 得分 4.81 / 5(官方数据),仅次于 GPT Image 2.5,高于 GPT Image 2、Seedream 5 Pro、Nano Banana 2 / Pro。
价格与可用性
项目 | 价格 |
1K 输出 | $0.03 / 张 |
2K 输出 | $0.06 / 张 |
已上线 krea.ai、Krea API,并可通过 fal、Replicate、Together AI、OpenRouter 使用。
为什么值得关注
Krea 官方把这块业务说得很直白:电商团队把产品快照转成影棚级packshot、生成配色变体,营销团队把一张广告图改成系列——这是在和摄影棚的档期直接抢活。Pixelcut 已在用,其反馈是产品图的光线看起来像专业摄影师布的。
LoRA 微调这一条尤其关键。电商和品牌客户过去的一致性方案是"参考图 + 提示词",属于概率控制;LoRA 是把特定商品焊进模型里,属于资产固化。
使用建议
·商品图批量换场景/换配色:框选 + 6 张参考图是最低成本路径。
·品牌系列图:先花一次成本做 LoRA,比每次靠提示词硬凑一致性便宜得多。
·数据都在厂商口径,真实产品的小字、细纹理表现建议用自己的素材实测一遍再上量。
🔗 来源:https://camerajabber.com/photography-news/krea-3-ai-image-editing-model-price-features-and-availability-announced
03 · Adobe 把 Photoshop 编辑器搬进 ChatGPT
发生了什么
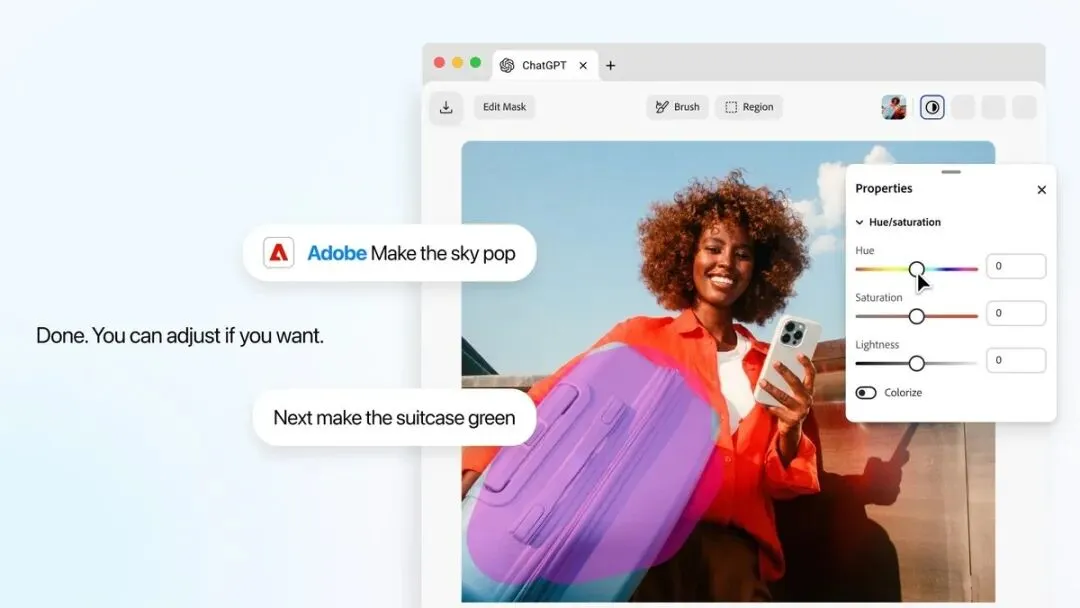
10 月 19 日,Adobe 宣布在 ChatGPT 内的 Adobe 插件中引入交互式编辑。此前该插件已支持用户在 ChatGPT 中调用 Adobe 旗舰产品的核心能力,这次补上了"手动精修"这一环。
具体怎么用
4.在 ChatGPT 侧边栏的交互式编辑器里,用画笔或对象选择工具框选要改的区域;
5.在对话框里提出修改要求(如"把天空变跳一点");
6.编辑器会按任务类型弹出对应控件——改颜色就出色相/饱和度滑块,改影调就给对比度 lightness;
7.对话与编辑器双向同步:在编辑器里做的修改会写回对话上下文,不需要重新解释或重新上传素材;
8.PDF 走 Acrobat 能力,可在侧边栏打开、改文字、高亮段落加批注,并基于选中内容继续对话。
Adobe 近期已把创意与生产力工具整合成跨 ChatGPT、Claude、Slack 的单一插件,这次是把"编辑与控制"能力跟上 AI 对话平台的发展节奏。
为什么值得关注
这一条的分量不在功能,在入口。
专业设计软件此前最大的摩擦是"要切换窗口"。Adobe 承认这一点,官方说法是:让用户少花时间理解工作流,把时间花在把内容落到想要的结果上。
更深一层:当编辑器的操作会被写回对话上下文,AI 就能"看见"用户手动做了什么调整。下一轮生成时,这些调整就是上下文而不是重新描述的负担——手动精修从"打断自动化"变成了"给自动化喂数据"。
对电商与社媒团队的意义
批量做图时,"AI 出大方向 + 人工拖滑块微调"这条混合路线的性价比会明显上升。建议提前把品牌色的色相/饱和度区间测成具体数值,而不是每次靠提示词描述。
🔗 来源:https://en.sedaily.com/technology/2026/10/19/adobe-adds-interactive-editing-to-its-chatgpt-plug-in
🔗 来源:https://news.qq.com/rain/a/20261019A0BF5Y00
04 · HyperFrames:把视频生产从"剪时间线"变成"写代码"
发生了什么
HeyGen 开源 HyperFrames——一个用 HTML、CSS 和可定位动画直接渲染确定性 MP4 的框架。截至 10 月中旬,该项目在 GitHub 已达约 6.7 万星(7 天涨 5.7k),采用 Apache-2.0 许可。
工作方式
```html
data-start="2" data-duration="3" data-track-index="1"
src="logo.png" />
```
·无需构建步骤:一个 index.html 就是完整合成件,带 data-start / data-duration / data-track-index 属性,浏览器里直接播。
·确定性输出:用 Puppeteer 驱动无头 Chrome 逐帧步进,FFmpeg 合成——同样的 HTML 永远产出同样的 MP4。
·可定位动画适配器:GSAP、CSS、Lottie、Three.js、Anime.js、WAAPI,以及自定义适配器插槽。
·19 个 Agent Skill:含一个 /hyperframes 路由 Skill,把自然语言需求映射到 /product-launch-video、/pr-to-video 等具体工作流。
·`frame.md` 步骤:把现有的 design.md 反转成面向画幅的 DESIGN.md 超集,解决"设计规范是为浏览器视口写的、不是为定长视频帧写的"这个断层。
·组件目录:npx hyperframes add 可装着色器转场、社媒浮层、动效图表等。
·分布式渲染:本地或 AWS Lambda 均可。
为什么值得关注
这是视频工具链上一次范式切换,而不是又一个模型发布。
Remotion 押注 React 组件 + 学习组件时间线;HyperFrames 押注纯 HTML——人和智能体都容易写。Remotion 是 source-available(大规模商用需付费许可),HyperFrames 是真正的 Apache-2.0 开源,无 per-render 费用、无席位上限。
对做 AI 短剧 / 电商视频的团队,最实际的一点是:同一条流水线可以同时被人和 Agent 驱动。脚本先生成分镜 JSON,Agent 生成 HTML 合成件,人再手改一处继续跑——这解决了"全自动质量不可控、全手动效率太低"的两难。
另外 hyperframes-registry Skill 支持抓取 URL 转视频,remotion-to-hyperframes Skill 可以把已有 Remotion 工程迁移过来,迁移成本不高。
🔗 来源:https://github.com/heygen-com/hyperframes
🔗 来源:https://topgit.dev/repo/heygen-com/hyperframes
05 · 华西证券:AI 短剧全年市场规模或破 400 亿
发生了什么
华西计算机发布 AI 短剧行业透视,给出两个核心判断。
判断一:规模爆发,巨头竞速
指标 | 数据 | 来源 |
2026 全年市场规模 | 有望突破 400 亿元,同比约 +138% | DataEye |
用户规模 | 上半年突破 6 亿 | DataEye |
精品剧成本降幅 | 约 90% | DataEye |
平台侧的动作同期密集:腾讯上线微信"绿泡泡短剧"主打广告变现并依托腾讯云布局技术;字节打通番茄小说→红果→抖音的内容链条,并以 40 万重金激励创作;快手以可灵 AI 技术为核心,配合单剧激励与全民创作季扶持创作者。
判断二:商业化提速,分账与 IP 授权拓宽盈利空间
·TikTok 短剧总分成金额突破 3100 万美元,本土 AI 短剧分成增长 55%,超 270 家版权方当月收入环比增长超 100%;
·30 部 AI 短剧获平台爆款激励 70 万美元,累计发放超 170 万美元;
·剧本授权累计分成超 88 万美元,30 多个 IP 授权分成超 1 万美元;
·河马剧场:4 家版权方分账超 100 万元,64 部剧目单部分账超 20 万元;
·阅文 2025 年 AI 漫剧收入破亿元,部分作品单剧分账超 200 万元。
必须同时看到另一面
这份报告也明确提示:分账和业务收入不等于净利润,实际盈利仍取决于制作、投流及运营成本。
这个警告在同期另一份行业数据里得到了印证——DataEye《2026 上半年 AI 剧漫剧数据报告》显示,仅有 1.3% 的 AI 漫剧作品达到盈亏平衡线,98.7% 无法回本。一分钟制作报价从 2025 年下半年约 5000 元跌至如今数百元的同时,投流约占微短剧全链路总成本的七到八成,免费短剧平台每万次播放的广告分成已从 2025 年的 30-100 元腰斩到 5-10 元。
给从业者的判断
成本优势已经确立到不再值得当卖点的程度——单分钟成本降 90% 之后 everyone's 成本都降了 90%,这不再是壁垒。决定一部剧能不能突围的,重新回到了 IP、剧本和审美本身。
🔗 来源:https://finance.sina.com.cn/roll/2026-10-19/doc-inivtchv7574976.shtml
🔗 来源:https://epaper.ynet.com/html/2026-10/20/content_452737.htm
06 · 总台发布多语种短剧漫剧 AI 制作发布平台
发生了什么
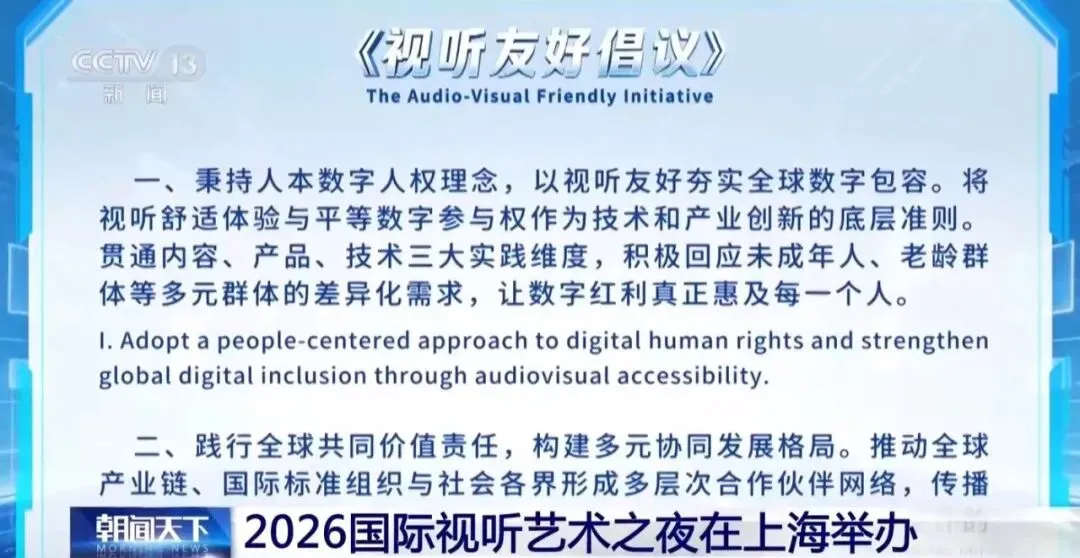
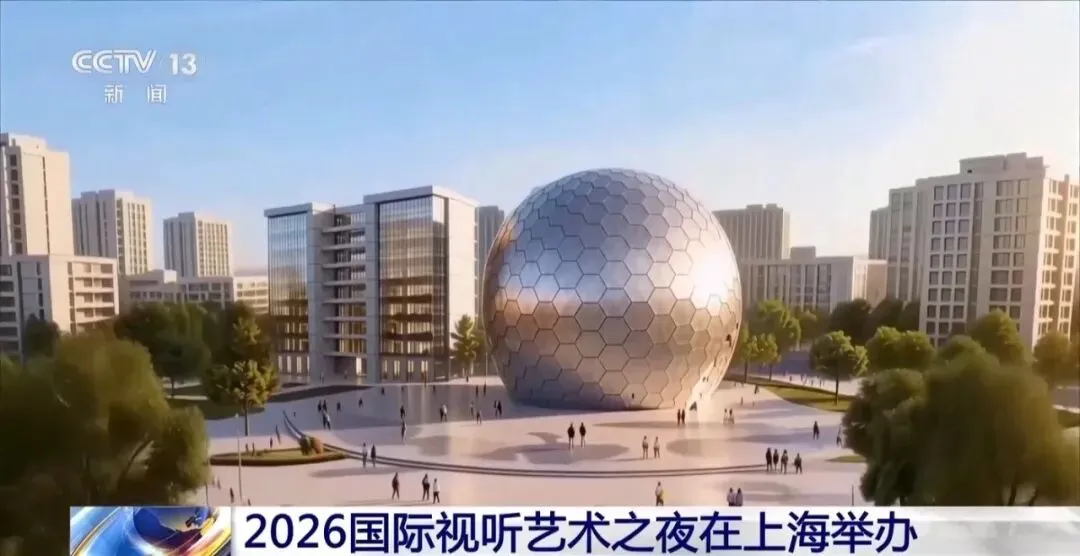
10 月 18 日晚,"2026 国际视听艺术之夜"在上海展览中心举办,作为"2026 国际视听艺术嘉年华"的收官活动。现场发布多项视听科技前沿成果。
核心发布:多语种短剧漫剧 AI 制作发布平台
依托 AI 大模型与多语种语料资源,打通内容创作、译制、审核、分发全流程。同步推出用该平台打造的 AI 漫剧《莉雅・与群星相遇》,片中总台虚拟主播莉雅将带着"相遇手记"开启穿越文明的旅程。
其他同期成果
成果 | 内容 |
《视听友好倡议》 | 秉持人本数字人权理念,以视听友好夯实全球数字包容;践行全球共同价值责任;深化国际协作与跨学科创新 |
沉浸式球幕技术内容服务平台 | 落地静安"视听静界"上海市超高清视听产业集聚区,以 55 米直径超高清 LED 球幕与无柱体大空间为载体 |
GPMI 超级一线通 | 我国主导研发的泛媒体终端互联总线,一根总线连通多媒体设备、双向同时传输并同时供电,推动中国标准赋能全球视听行业 |
嘉年华期间,上海南京西路、苏河湾、大宁三大商圈销售额同比增长 30% 以上,延展活动累计吸引超 300 万人次参与,全网触达超 15.2 亿人次。
为什么值得关注
这一条的价值在于它标记了 AI 短剧从"能生成"到"能发行"的分界。
此前行业的所有进展都在生成端——模型更快、成本更低、画质更高。但一部短剧要真正出海,卡在三个地方:译制成本、审核合规、分发渠道。总台这个平台一次性把这三段拉通,用的还是官方多语种语料和审核体系。
对比 05 条里"58% Token 耗在代码、55% Token 耗在短剧生成"这样的结构,整个行业的算力都压在生成一环;平台方开始往上收调度、译制和分发的价值,这是产业链位置的重新分配。
对团队的启示
·有 multilingual 需求的(出海小语种、本地化改编),这类平台化方案值得重新评估——自建译制链路的成本比想象中高。
·55 米球幕这类沉浸式形态,是文旅和线下空间的新内容载体,有实体场景资源的团队可以关注后续落地。
🔗 来源:https://finance.sina.com.cn/jjxw/2026-10-19/doc-inivtiqt7513054.shtml
07 · NVIDIA 开源 Nemotron 3.5 Super VL 与 Bolt:智能体底座下沉到端侧
发生了什么
NVIDIA 扩展 Nemotron 系列,一次性推出三款开放权重模型,覆盖从企业级服务器到边缘设备的全场景智能体部署。
三款模型
模型 | 参数 | 定位 | 状态 |
Nemotron 3.5 Super VL | 1,200 亿 | 专用常驻企业智能体 | 已可用 |
Nemotron 3.5 Bolt 74B-A9B 24GB | 740 亿(MoE) | 本地智能体工作负载 | 已可用 |
Nemotron 3.5 Bolt E4B 4GB | — | 快速响应对话式智能体 | 10 月 23 日发布 |
Super VL 的关键数据
·与 NVIDIA 最大规模推理模型相比,参数量约为其五分之一,但在指令遵循、工具调用、多步骤业务工作流与视觉理解上达到相近精度;
·速度是同类次优开放智能体模型的 5 倍;
·视觉能力专攻实际智能体任务:OCR、表格与图表处理、视觉文档中的结构化信息、网页解析、读图与洞察提取;
·训练规模约 26 万亿 tokens,后训练约 380 万样本 + 数十环境的强化学习。
视觉能力为什么对设计工作流重要
Super VL 把文本与视觉理解合并进单个模型,意味着智能体不需要在系统之间路由任务——从读设计稿、到提取规范、到做决策,上下文得以保留。
对做 AI 设计工作流的人来说,这直接对应一个长期痛点:让 Agent 读懂一份 Figma 稿、一套品牌规范、一组参考图,今天需要接三四个模型 + 一堆胶水逻辑。Super VL 这类模型在压缩这个链路。
端侧 Bolt 的意义
·Bolt 74B-A9B 采用原生 2-bit 量化,装进 24GB 内存,可与其他应用并发运行;
·在 PinchBench 上居开放模型第一,BrowseComp 第二;
·用户可以把从网页搜索到写代码、调试的活派给它,敏感负载不出云;
·已在 Hugging Face、OpenRouter、ModelScope 上线,支持 llama.cpp、Ollama、LM Studio、Unsloth、vLLM。
已定制 Super VL 的企业包括 Scale AI(为 EY 并购尽调、Skydance 财务运营做后训练)、Ramp(财务文档智能)、CrowdStrike(网络安全蓝队)、Atlassian、Salesforce、Perplexity、Synopsys 等。
"不必在能力与可部署性之间取舍"
NVIDIA 开放模型与软件副总裁 Kari Briski 的原话是:任何希望在 NVIDIA 基础设施上运行智能体的组织,现在都能按自身层级获得开放且经过优化的模型,不必在能力与可部署性之间取舍。
这句话对着的是闭源实验室的结构性优势——开放权重 + 私有化部署,是英伟达对抗 AWS Trainium、Cerebras 和各厂自研芯片的护城河。这场仗的胜负手不在模型能力,而在"企业愿不愿意把数据留在自己机房里"。
🔗 来源:https://blogs.nvidia.com/blog/nemotron-3-5-super-vl-bolt/
🔗 来源:https://www.siliconreport.com/nvidia-releases-120-billion-parameter-nemotron-3-5-super-vl-model
本期主线判断
这 7 条不是 7 件独立的事,它们指向同一个转向:竞争单元正在从「模型」整体上移到「交付链路」。
·01 和 02 解决速度:FLUX 3 Max 把「10 秒出 10 秒」变成可宣传的指标,Krea 3 把 2K 编辑压进 8 秒。快不是为了炫技,是为了把试错次数这个变量放大——迭代次数上去,好片子的产出概率才上去。
·03 和 04 解决入口与编排:Adobe 把编辑器塞进对话窗口,HyperFrames 把视频生产改写成写 HTML。两者共同点是让人和 Agent 用同一套产物(对话上下文 / HTML 文件)驱动同一条流水线。
·05 和 06 解决变现与分发:400 亿市场规模与 1.3% 盈亏平衡率同时被披露,说明流量红利已经见顶;而总台这类平台的出现,说明价值正在从生成端向译制、审核、分发迁移。
·07 是底座层的同一逻辑:开放权重 + 私有化部署,本质也是让企业不被锁定在别人的机房里。
给不同角色的一句话
角色 | 本周最该做的一件事 |
视觉 / 电商设计 | 把 Krea 3 的 LoRA 微调测一遍——这是目前唯一能把"商品一致性"从概率变成资产的路径 |
视频 / 短剧团队 | 用 HyperFrames 重构一条现有产线:同一条流水线让人和 Agent 同时能改,比换模型见效更快 |
独立创作者 | 学 frame.md 的思路:先把设计规范写成机器能读的形式,再谈自动化 |
企业技术负责人 | 评估 Nemotron 3.5 Bolt 端侧方案:24GB 跑 74B 且数据不出云,可能是合规成本最低的一次升级 |
短剧出海团队 | 重新算一遍自建译制链路的成本,对比总台这类平台化方案 |
本刊由 AI 辅助整理,图片版权归原作者所有。所有数据均来自公开报道,厂商口径已如实标注。
ISSUE No.011 · 2026-10-20