ARTICLE · 1227825
【excel提取升级版】按分组提取最长公共前缀,这条Excel公式直接搞定
最近就碰到一个更细化的场景:按A列分组,只在每组第一行输出公共前缀,完全没有公共前缀时还要给出明确提示。 一条嵌套公式就能实现,今天把完整逻辑、变量拆解和踩坑点全部整理出来,复制就能用。
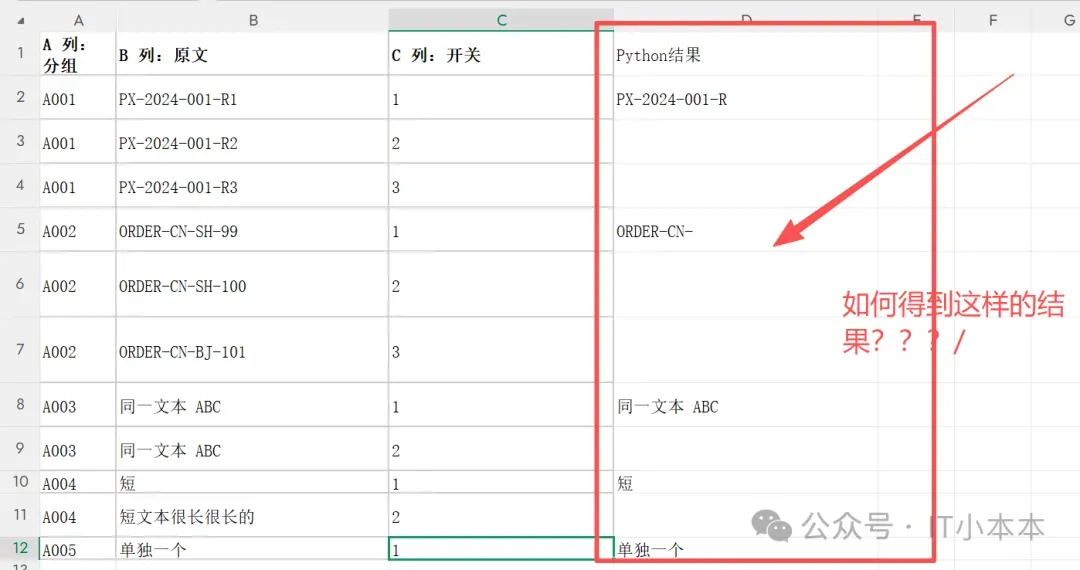
一、先看最终实现效果
我们用一组真实数据演示,表格结构如下:A列是分组编号,B列是原始文本,C列是组内序号,最终实现效果:
只有每组C列=1的首行,显示该组的最长公共前缀 组内文本有公共前缀时正常截取 组内文本完全相同时返回原文 组内文本首字符就不同、无公共前缀时返回提示文本
6组典型场景全覆盖:正常前缀、中段分叉、完全一致、长短不一、单条数据、无公共前缀。
二、公式完整拆解
完整公式如下(D2单元格输入,下拉填充即可):
=IF(C2=1,
    LET(
        t, FILTER(B$2:B$100, A$2:A$100=A2),
        L, MAX(LEN(t)),
        k, SEQUENCE(,L),
        ch, MID(t,k,1),
        same, BYCOL(ch, LAMBDA(c, AND(c=INDEX(c,1)))),
        p, MATCH(FALSE,same,0)-1,
        IFERROR(
            IF(p=0, "没有相同的,无法提取", LEFT(B2,p)),
            B2
        )
    ),
    ""
)
核心用LET函数把多层嵌套拆成了7个命名变量,一层层看逻辑非常清晰。
变量逐个拆解
t | |
L | |
k | |
ch | |
same | |
p | |
举个直观的例子,A001组的三条文本拆成字符矩阵后:
P X - 2 0 2 4 - 0 0 1 - R 1
P X - 2 0 2 4 - 0 0 1 - R 2
P X - 2 0 2 4 - 0 0 1 - R 3
前13列全为TRUE,第14列首次出现FALSE,因此p=13,截取前13位就是最终的公共前缀。
三、3个最容易踩的细节坑
这条公式看起来嵌套多,核心逻辑并不复杂,真正容易出错的是三个边界场景。
1. 为什么要用IFERROR兜底?
当组内所有文本完全一致时(比如A003),same数组里全是TRUE,MATCH找不到FALSE会直接返回#N/A错误。 外层的IFERROR就是捕获这个错误,直接返回原始文本。 这是Excel公式里很常见的“用异常处理正常逻辑”的写法,功能没问题,但读公式的时候很容易忽略这个分支。
2. 为什么要单独判断p=0?
很多人会把“无公共前缀”和“文本完全相同”混为一谈,其实是完全相反的两种场景:
文本完全相同:找不到差异点,MATCH报错,走IFERROR分支 首字符就不同:第一个位置就是FALSE,p=0,走正常分支
如果不加IF(p=0,...)的判断,p=0时LEFT(B2,0)会返回空字符串,你根本分不清是“首字符不同”还是“公式没算出来”。 加上明确的提示文本,业务逻辑会清晰很多。
3. 文本长短不一时,会不会越界报错?
比如A004组,一条只有1个字,一条有8个字。 Excel的MID函数在取值超过文本长度时,会返回空字符串"",而不是报错。空字符串会正常参与比对,因此第二位就会判定为不同,公共前缀停在第1位,结果完全符合预期。 这是Excel内置的特性,如果是转Python代码,反而要专门处理越界的问题。
四、拿来即用,注意这2点
可直接复制的紧凑版公式
=IF(C2=1,LET(t,FILTER(B$2:B$1000,A$2:A$1000=A2),L,MAX(LEN(t)),k,SEQUENCE(,L),ch,MID(t,k,1),same,BYCOL(ch,LAMBDA(c,AND(c=INDEX(c,1)))),p,MATCH(FALSE,same,0)-1,IFERROR(IF(p=0,"没有相同的,无法提取",LEFT(B2,p)),B2)),"")
使用说明
修改数据范围:把公式里的 B$2:B$1000和A$2:A$1000改成你实际的数据行范围,$绝对引用符号不能删,否则下拉填充时范围会错位。版本要求:公式用到 LET、FILTER、LAMBDA、BYCOL等动态数组函数,需要Excel 2021、Microsoft 365及以上版本,WPS 2021及以上版本支持。
最后
很多人觉得嵌套多层的Excel公式很“炫技”,但真正好用的公式,从来不是为了嵌套而嵌套。 用LET把逻辑拆成一个个命名变量,每一步做什么清清楚楚,既能快速调试,也方便后续修改。