ARTICLE · 1231120
我把「lieflat-less-ai-tone 去AI味」做成了一个网页工具附下载链接
这些清单从没被认真检验过。直到我刷到lieflat-less-ai-tone——629 篇文章、282 万字的人机对照统计,把清单过了一遍筛子。结果是 11 项成立、15 项是误会,其中 3 项方向反了:人类用比喻的频率是 AI 的 2.4 倍,正文设问是 17 倍。按流行建议「删掉设问」,只会让文章更不像人写的。
这份数据值得做成工具。于是我把它写成了一个单文件网页应用,没有任何依赖,拷到哪台电脑都能跑。下面把界面从头到尾走一遍。
一、页面整体
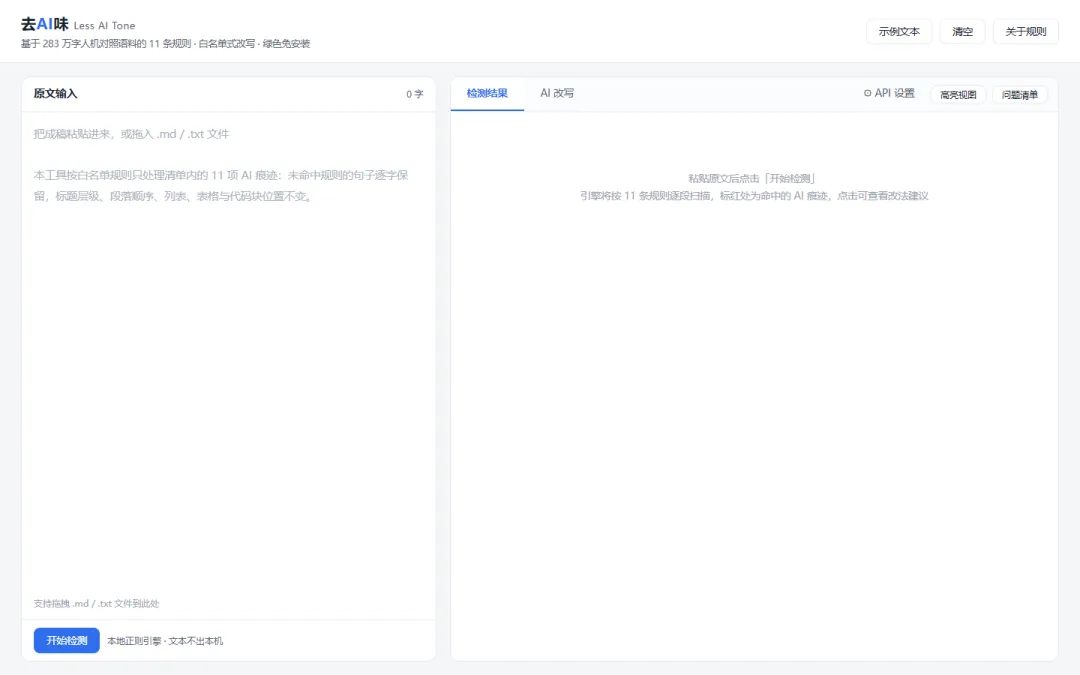
界面只有三块,不需要学习成本:
顶栏:标题旁写着规则来源的规模(283 万字语料),右边三个按钮——「示例文本」内置一段埋了 8 类 AI 痕迹的稿子,点一下就能看到检测效果;「清空」清掉输入和结果;「关于规则」弹出规则全文摘要。 左栏:原文输入区,右上角实时显示字数。可以直接粘贴,也可以把 .md/.txt拖进来。底部提示「本地正则引擎 · 文本不出本机」——检测全程在浏览器里跑,断网也能用,稿子不会上传到任何服务器。右栏:结果区,两个标签页「检测结果」「AI 改写」,右上角是「⚙ API 设置」。
二、检测模式:标红 + 「体检报告」
点「开始检测」或「示例文本」,右栏会先出一排统计标签,再出正文。
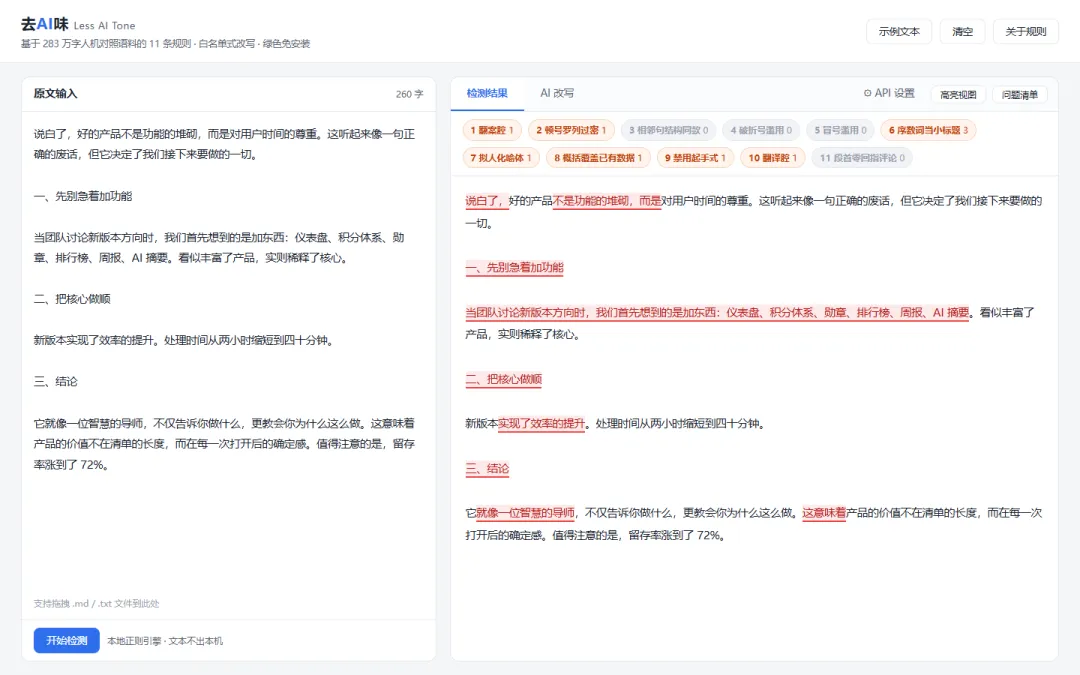
统计标签(chips)是整篇的体检概览,每格是「规则编号 + 名称 + 命中次数」。命中过的显示为橙色,没命中的是灰色。灰色那一排本身就有信息量:它提醒你这项别自己吓自己——比如「3 相邻句结构同款 0」「11 段首零回指评论 0」,那就说明这两项在这篇里没问题,不用硬改。
高亮视图里,命中的片段标红加下划线。示例稿一眼望去能看出几个典型病灶:
开头「说白了,」——规则 9 禁用起手式; 「不是功能的堆砌,而是对用户时间的尊重」——规则 1 翻案腔; 「一、先别急着加功能」这类整排编号——规则 6; 「实现了效率的提升」——规则 8,名词化概括; 「就像一位智慧的导师」——规则 7 拟人化喻体; 「这意味着」——规则 10 翻译腔。
点任意一处红色标记,右侧会跳到对应的问题卡片并高亮。
问题清单:每条都给改法
切到「问题清单」视图,每处命中是一张卡片:
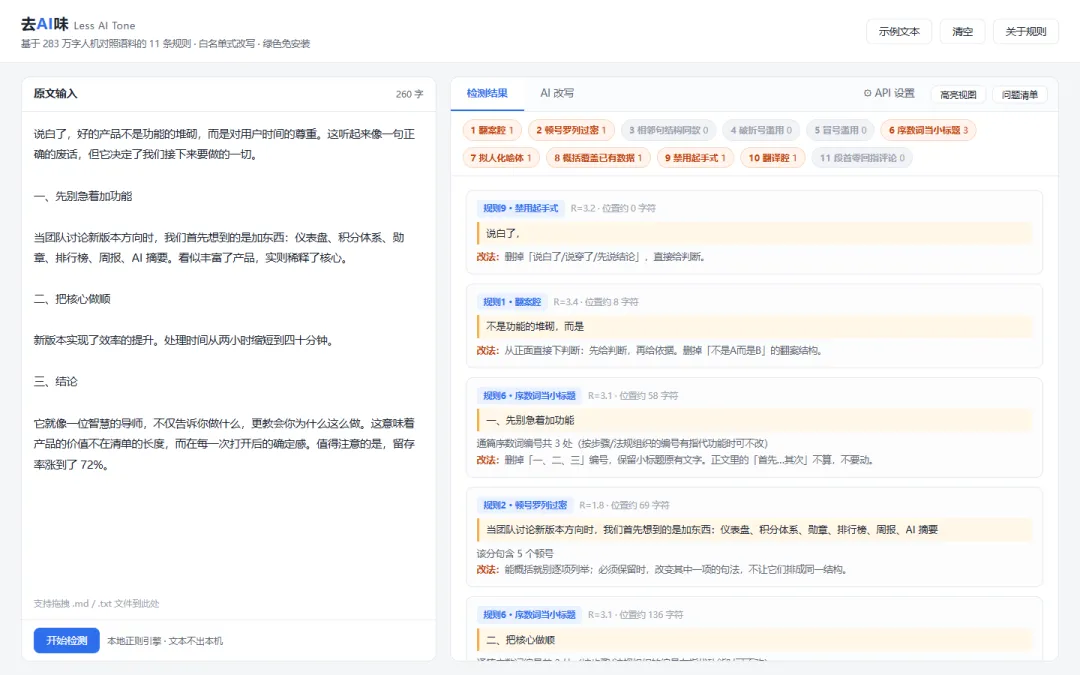
卡片上有四行信息,都是照着原项目的研究口径来的:
规则标签 + 实测倍率:如「规则 1 · 翻案腔 R=3.4」,R 是生成侧与人类侧的频率比,数值越大说明这项越有区分力。这个数字让你知道该先改哪一条——规则 11(段首零回指,R=4.4)分值最高,优先级也最高。 位置:第几个字符,方便在大稿子里定位。 引文:触发片段原文,黄底标出。 改法:直接给动作,比如「从正面直接下判断:先给判断,再给依据」「能概括就别逐项列举」。
规则 2 的卡片还会附一句量化的说明——「该分句含 5 个顿号」,比笼统说「有点密」更有用。
顶部两个按钮「高亮视图 / 问题清单」可以来回切,长文用清单视图逐条处理,通读用高亮视图。
三、改写模式:把规则交给大模型执行
检测只能指出问题,改还得靠模型。切到「AI 改写」,右上角 ⚙ 展开设置:
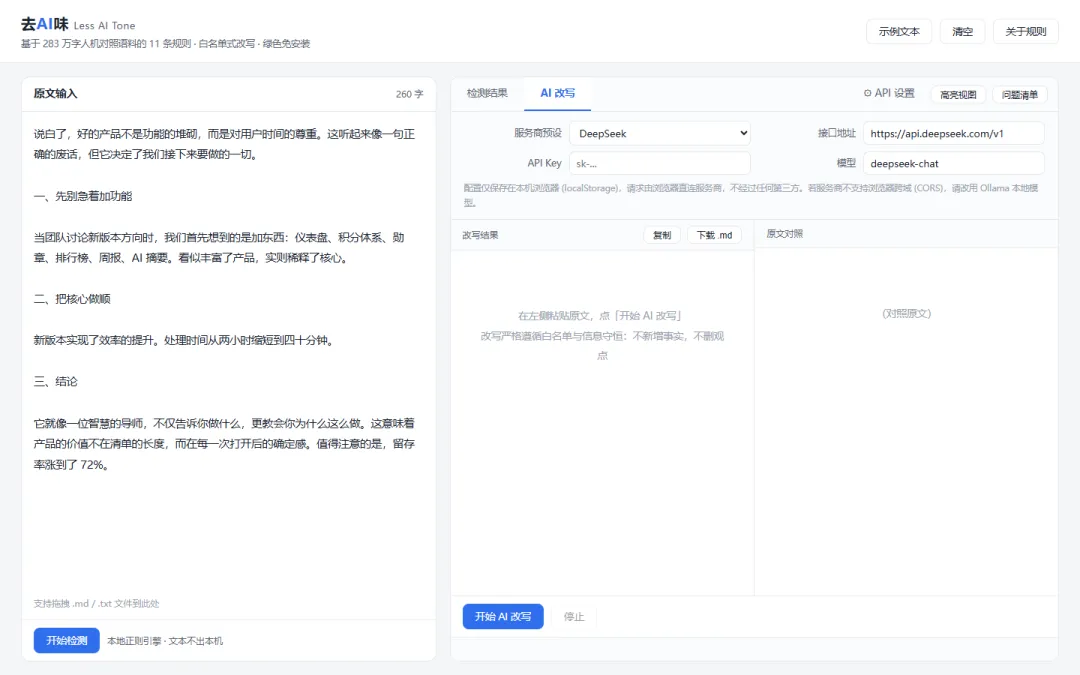
设置只有四项,全部走 OpenAI 兼容协议,所以主流的服务都能接:
https://api.deepseek.com/v1 | |
deepseek-chat、glm-4-plus |
选「Ollama」就等于完全离线跑本地模型,一条命令都不用改。下面那行小字是关于跨域的实话:请求由浏览器直连服务商,如果对方不允许跨域(CORS),就只能换服务商或走本地模型。这是我为了「单文件绿色包」付出的代价——没有中转服务器,也就没有替你兜底的余地。
改写结果:双栏对照 + 机器复核
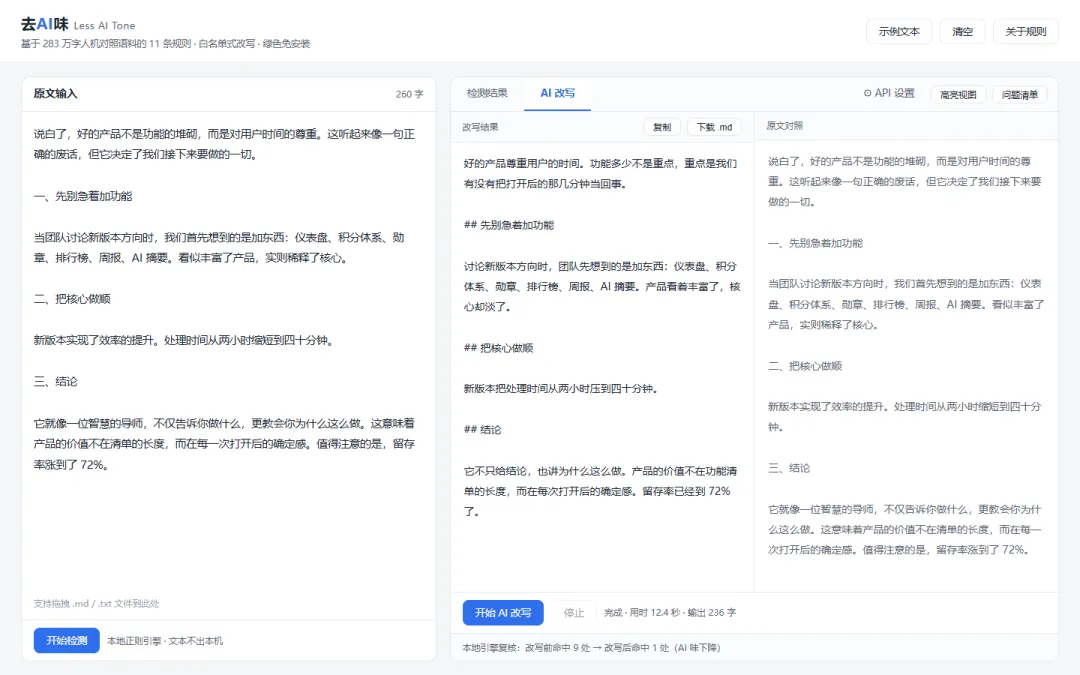
左栏是改写结果,右栏保留原文,一眼就能核对信息有没有被偷改。示例这段的结果值得看细节:
「说白了,」删掉,直接给判断; 「不是功能的堆砌,而是对用户时间的尊重」翻正为「好的产品尊重用户的时间」; 「一、二、三」编号消失,标题文字原样保留; 「实现了效率的提升。处理时间从两小时缩短到四十分钟」合并成「把处理时间从两小时压到四十分钟」——具体数字提到了概括词的位置,没添一个新事实; 「就像一位智慧的导师,不仅告诉你…更教会你…」换成「它不只给结论,也讲为什么这么做」。
底部那行字是我特意加的:「本地引擎复核:改写前命中 9 处 → 改写后命中 1 处」。改写完立刻用同一套正则再跑一遍,用数字回答「到底降了多少」。剩下的那一处多半是模型没改利落,也可以是你明知故犯——有些结构作者本人就爱用。
结果能一键复制,也能下载成 .md。
四、规则来源弹窗
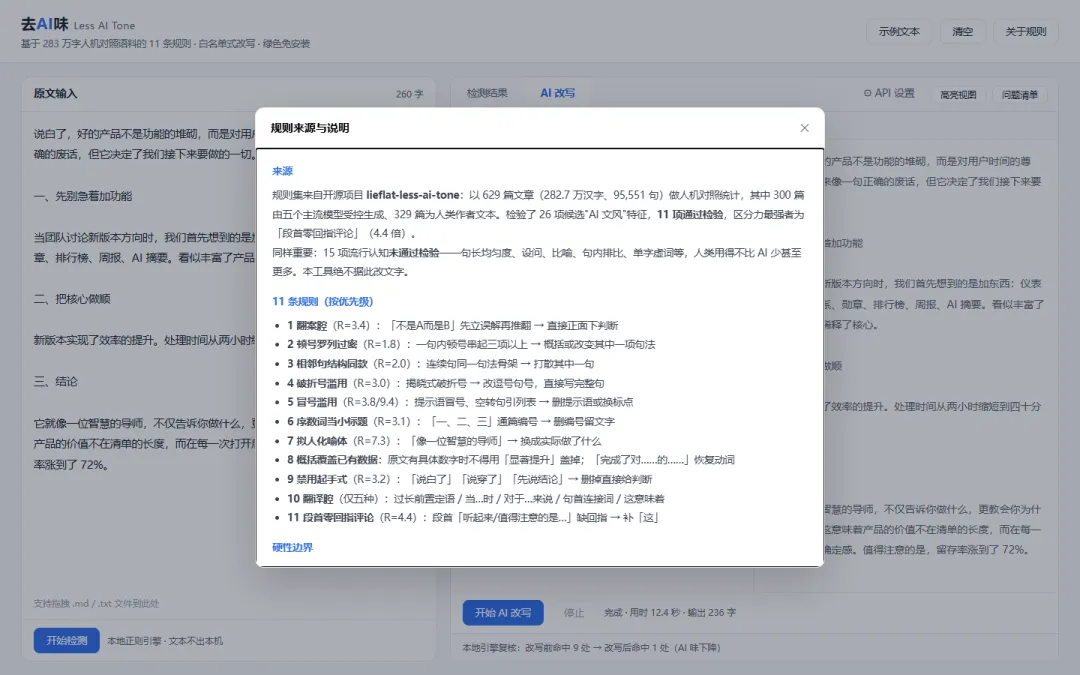
「关于规则」把 11 条规则连同倍率列全,还写了两块容易被忽略的内容:
来源:629 篇、282 万字、95,551 句,五个模型各 60 篇,人类侧 329 篇; 硬性边界:白名单、信息守恒、框架不动。
把边界摆到界面上,是怕用户把它当润色器使。这个工具的定位是「只清理清单内的痕迹」,不是「帮你把文章改得漂亮」。
五、几个不肯让步的设计
白名单,不是润色器。原项目最克制的地方是它的否定式清单:未命中规则的句子逐字保留,不顺手润色,不调语气详略。「可能提升」改成「提升」属于篡改判断强度,不是去 AI 味。这些约束我原样写进了系统提示词。
反着来的 15 项也写了进去。工具明确拒绝按「不成立特征」动手:不为制造节奏调句长,不删设问,不动句内排比,不删比喻。这类「看着像但不能改」的判断,比改法本身更容易被人忽略。
绿色包。三个文件:index.html(全部逻辑,约 45 KB)、start.bat(双击启动)、使用说明。不需要装 Node、不需要 Python、不需要联网注册。拷进 U 盘,在任何 Windows 上解压双击即可。
Key 不上传。没有后端,自然没有存 Key 的地方,配置只在你自己的浏览器里。
六、它做不到什么
作者在论文里交代得很干脆,我也照抄一遍:比喻贴不贴切、案例是不是在凑数、设问有没有回答真问题,这些语义层判断正则做不到,工具也不假装能做到。所以本地检测是体检报告,AI 改写是处方,最后一道关仍然是你自己读一遍。
还有时效性。模型在向人类文风收敛,GPT 的破折号频率一年内从「近乎每句一次」掉到 0.11。所有倍率都是某个时点的观测,不是铁律。
七、三步用起来
双击 start.bat(或直接打开index.html);把稿子粘进左栏,点「开始检测」,先看灰色标签——没命中的规则不必硬改; 想批量处理就配好 API,切「AI 改写」,改完对照右栏检查,看底部复核数字。
页面内置示例文本,点一下就能看到 11 条规则各自怎么触发。建议先拿自己被同事吐槽过「一股 AI 味」的稿子试一次,再决定要不要信它。
网盘下载地址:
https://pan.baidu.com/s/1gxAnVklMjekV8r9Gxo1EwQ?pwd=f77d