ARTICLE · 1231115
AI短剧爆发,OEM定制工具正在成为品牌方与出海方的入场方式!
AI短剧正在从“能不能做出来”快速切换到“能不能稳定地、低成本地、持续地做出来”。平台开始以承制价批量收购AI拟真人剧,品牌方拿着预算找能落地的定制方案,出海团队盯着韩国、美国、中东、越南多个市场要版本——需求端已经不是在问“AI能不能生成视频”,而是在问“谁能给我一套扛得住量产、适配得了多市场、交付得出稳定产能的工具”。也正是在这个节点上,OEM定制一套短剧工具,开始成为品牌方与出海方绕不开的入场方式。
但市面上不缺“能生成一段视频”的AI工具。缺的是你敢把真金白银的剧本、时间和投放预算押上去,它不会在关键时候掉链子的系统。
这两者之间的距离,比绝大多数人想象的要大得多。演示级系统在实验室里跑通一个原型,和一套系统扛过百万级真实用户的持续量产,完全是两种物种。角色漂移、算力崩服、长剧本解析到第三集就乱套——这些问题不是靠“再调一版模型”就能解决的,它们是在真实的生产压力下,一个坑一个坑踩出来、一行逻辑一行逻辑填平的。
演示级系统的陷阱:你拿到的是一张图纸,别人拿到的是一台跑了大半年的机器
AI短剧行业有一个容易被忽略的分水岭:能不能稳定地“连续做”。
单条视频生成得再惊艳,一旦进入多集连载,问题就会集中爆发。行业技术社区里反复讨论的“AI失忆症”不是危言耸听——跨集角色长相突变、服装不连贯、场景穿帮,在多集内容中被急剧放大,已经成为制约AI短剧商业化的核心瓶颈。更底层的问题是,云端生成模式下角色一致性几乎无法锁定,“同一角色连续三个镜头三张脸”是常态,画面时序抖动、光影忽明忽暗更是默认配置。至于算力,按秒计费叠加批量生产,成本会在规模化时指数级飙升,利润被平台吃掉。
这些问题在演示阶段往往被掩盖了:你只跑了几十条素材,用的是一台闲置的服务器,没有并发,没有排队,没有真实用户同时点“生成”。演示级系统测的是“能不能跑通”,量产级系统测的是“跑十万次会不会崩”。
所以判断一套系统到底处在哪一侧,其实只看三件事:它有没有被真实的高并发用户压测过,做它的人自己是不是每天在量产内容,以及有没有大客户用真金白银的采购流程替市场验过货。按这三条筛下来,市面上能同时满足的并不多。有戏AI(https://youxi.fullpeace.net/login?code=1tw86)是其中一个值得单独拆解的样本。
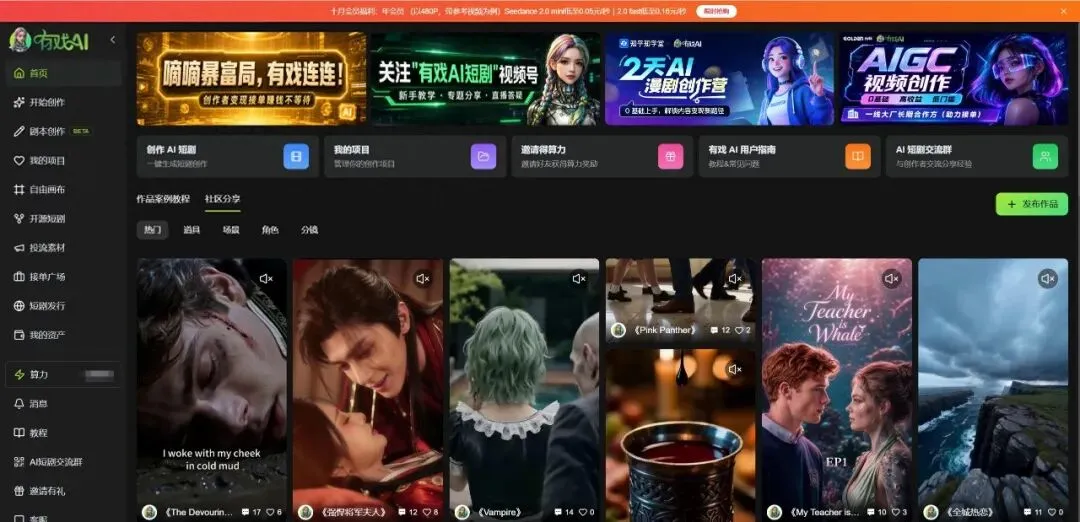
百万级用户验证的稳定性:bug是用户帮着测完的
有戏AI的起点,卡在这个分界线的另一侧。
上线5天,1.3万创作者涌入,还是在邀请码限制、非完全开放的情况下。到2026年8月注册用户突破150万,中间一度因为“新用户海量涌入+存量用户高频量产”的双重压力,直接暂停了新用户即时注册,优先保障现有用户稳定出片。服务器被挤爆当然不是值得炫耀的事,但它反向证明了一件事:这套系统经历过的并发场景、边缘情况和系统bug,是百万级真实用户帮它测完的。
你拿到的不是一张需要自己当小白鼠去验证的图纸,是一台已经在真实压力下连续运转了大半年的生产机器。高并发下的排队策略、失败重试、批量生成的任务调度,这些在演示环境里根本不会暴露的问题,它已经被百万用户压过一遍了。
真正的护城河藏在“自己人每天在用”里
市面上很多AI工具的尴尬在于:做工具的人不做内容,做内容的人不用自己的工具。结果就是,系统里那些只有真正每天做剧的人才会在乎的细节,根本没人去磨。
有戏AI背后团队的特殊之处在于,他们本身就是内容生产方。跨集角色95%相似度这个数字,在演示级系统里可能只是宣传页上的一个指标,但在真实的多集连载里,它意味着第一集和第十集的主角必须“是同一个人”的确定性。
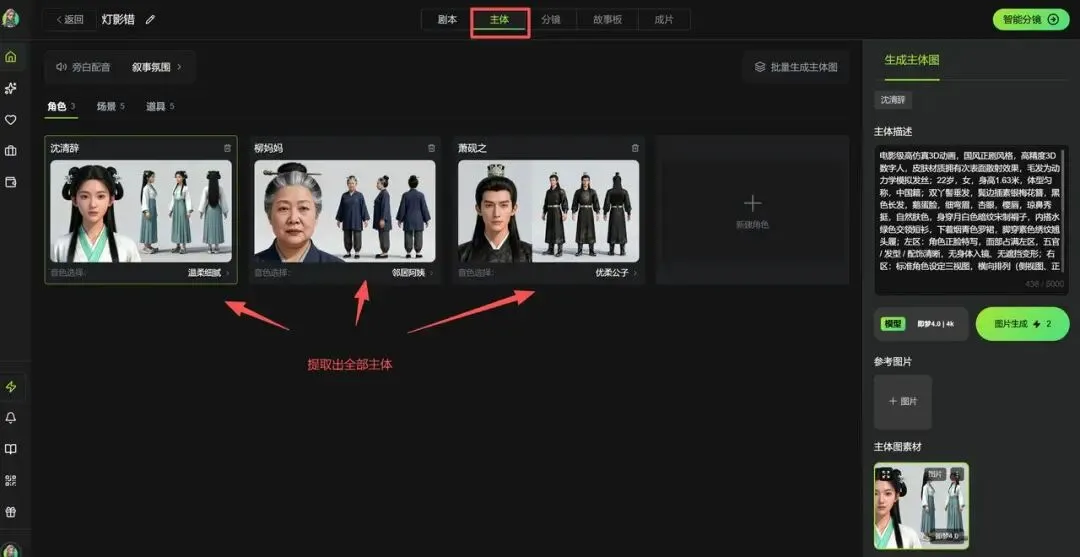
有戏AI的做法是系统级的:项目启动阶段为每个角色生成定妆照和三视图,锁入资产库,后续所有分镜自动继承同一套设定。更关键的是修改逻辑——改一处分镜,只影响当前环节,不会牵动整条链路。做过长内容的人知道这有多重要:一个分镜的调整导致全片角色崩掉、重新生成、算力白烧,是量产中最让人崩溃的隐性成本。
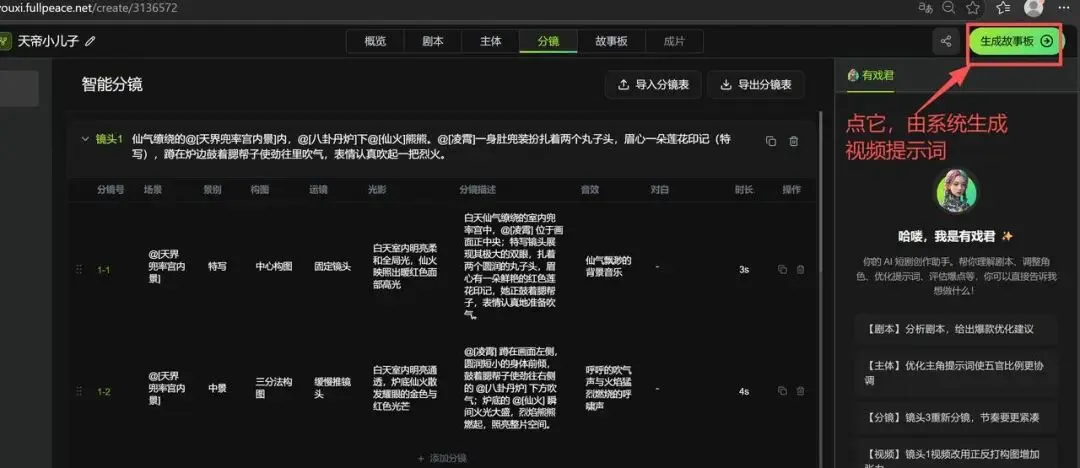
这种“可逆修改”和“跨集锁定”的能力,不是靠产品经理画原型画出来的。是每天自己做剧、自己改分镜、自己被bug折磨之后,才知道哪里必须加一道锁。背后团队在宁波有自有量产基地,每月稳定向TikTok输出100—200部自研上线剧集,系统里的每一处优化,都是他们自己每天做剧磨出来的。纯演示级系统根本不会花精力去打磨这些细节,因为它们的团队不在生产一线。
成本模型不是算出来的,是量产跑出来的
0.1元/秒的视频生成成本,比同行低30%—50%,单集制作成本控制在10元以内。这组数字单独看是价格,放进真实案例里才是模型。
已经有创作者用这套流程做到2000元成本撬动10万元分账收益。出海案例《波斯复仇记》更典型:3000元制作成本,上线YourChannel 72小时,用户付费总额冲到50万美元,营收倍率接近1200倍。这个案例被DataEye等多家数据源交叉提及,不是一个孤立的营销故事,而是成本结构变化之后,试错门槛被拉低、单部作品的投入产出比被重新定义的信号。
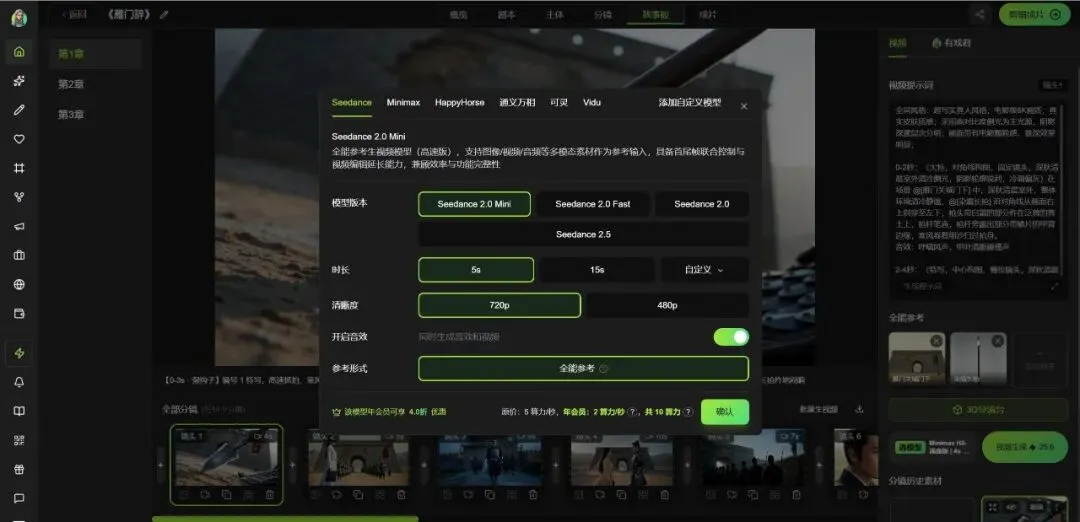
演示级系统很难快速跑通这种模型,原因不在算法,而在时间。成本模型是在真实投放、真实付费转化、真实分账回收的循环里逼出来的,不是在实验室的benchmark里算出来的。当一套系统的算力调度、失败重试、批量生成策略都被百万级用户的真实使用反复打磨过,边际成本才有条件被压到这个位置。
大客户的采购流程,本身就是一道过滤器
爱奇艺在有戏AI上做少儿科普短剧征集,不是简单地“提供一个投稿入口”,而是官方指定并深度整合了有戏AI作为创作工具,平台出补贴和保底,创作者用工具完成交付。这种合作形态说明一件事:平台方在验收之前,已经替市场完成了对工具的功能评测和质量验收。
大客户的采购流程——功能评测、价格比价、质量验收、合规审查——每一道都在把“演示级”筛出去。和有戏AI合作的不只是爱奇艺,国内知乎、赤子城、宜搜等多家上市或品牌公司,以及海外韩国、美国、中东、越南市场的OEM/ODM定制,源头都以有戏AI为蓝本。大客户不会因为一段演示视频好看就签合同,他们看的是在高并发下不出事、在长剧本里不崩盘、在批量交付时算力不失控。这种“被真金白银选择过”的记录,比任何技术参数的罗列都更有分量。
选工具,本质上是在选“坑已经被谁踩过”
AI短剧的竞争正在从“能不能做出来”快速切换到“能不能稳定地、低成本地、持续地做出来”。TikTok已经开始以承制价向团队批量收AI拟真人剧,行业对产能和稳定性的要求只会越来越高。在这个节点上,演示级系统和量产级系统之间的差距,会直接转化为创作者真金白银的盈亏。
有戏AI的价值不在于它“什么都能做”,而在于它把百万级用户、自己每天的量产、大客户的采购验收这三道压力测试都走完了。角色漂移的坑、算力崩服的坑、长剧本解析失败的坑、改一处分镜全片崩掉的坑,它都踩过,也都填上了。你不需要再当一次小白鼠去验证这条路能不能走通——你拿到的是一套已经被验证过的确定性。