ARTICLE · 1233493
和 AI 聊过的方案总找不到,我干脆用GPT做了一个「织网」一个跨记忆
之前有个问题,一直让我挺烦。
我平时会用 GPT,也会用 WorkBuddy、WorkBuddyAI 和 Codex。不同工具各有顺手的地方,做一件事,经常会在几个工具之间来回切。
比如在 WorkBuddy 里把一个想法讨论得差不多了,我想再交给 GPT 深入分析,或者接着写成一篇文章。
这时候,工作往往卡在一个很不起眼的地方:之前那段讨论,到底放哪儿了?
记得聊过,连大概内容都记得。可真要用,还得先想在哪个工具里,再翻对话、找原文、复制粘贴,告诉另一个 AI:我们前面讨论到这里了,请接着做。
有时方案找到了,相关文档又不知道存在哪个文件夹。
本来想让 AI 帮我省点事,结果我先在几个 AI 之间搬了一轮资料。
我想把已经讨论过的东西接起来
我是老兵小白,做了十多年电商,现在正尝试用 AI,把自己的经验慢慢做成工具和工作流。
用得越多,我越在意一个问题:那些讨论过的方案、推翻过的思路、改过的文案,能不能在下一次做事时接着用?
如果每换一个工具,都要把项目重新介绍一遍,那前面的讨论就很容易断掉。
于是我先给自己做了一个跨 AI 的本地记忆工具。
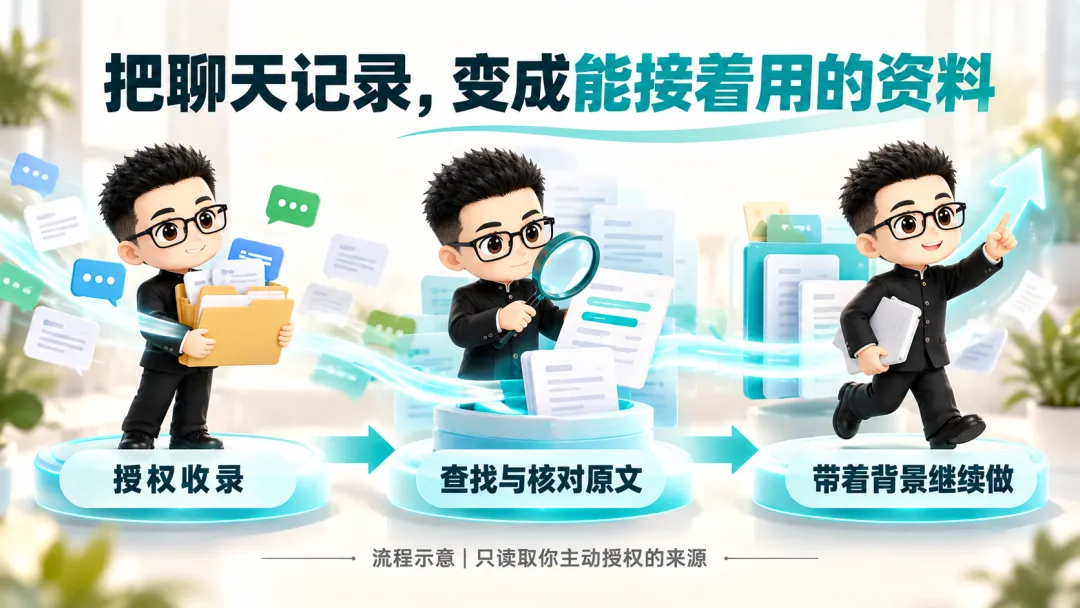
我的要求很具体:把我允许收录的聊天记录整理到一起,能够搜索、看到出处、打开原文;需要继续做的时候,再把选中的背景交给正在使用的 AI。
后来我在群里聊起这件事,发现不少宝子也有同样的困扰。
大家未必缺一个新的 AI,却经常找不到自己之前已经和 AI 做过的功课。
我就想,既然这个问题别人也会遇到,那可以再往前做一步,把它变成大家能安装、能看懂、能用起来的产品。
这就是「织网」——一个跨 AI 记忆助手。
现在,它能帮你做什么?
最直接的,是少翻几个工具,先把记录找回来。
目前织网支持收录本机 WorkBuddy、WorkBuddyAI 和 Codex 的聊天文字记录,前提是你主动开启对应来源的授权。
你可以在面板里搜索关键词,也可以按来源、日期缩小范围。找到之后,打开原文,看看当时到底怎么讨论的。
我很在意“能看原文”这一点。只看到一个标题,或者一小段摘要,未必够用。有时真正重要的,是我们为什么否定了前一个方案、最后又加了什么条件。
另一个,是把讨论和相关产出尽量放在一起。
聊天里识别到的本地文件引用,会出现在相关产出里。图片可以看缩略图、点开查看;文档可以用电脑上的默认软件打开。
当然,文件如果被移动或删除,原来的路径可能就失效了。织网并没有把电脑里的所有文件都重新复制一份,找到引用也不代表文件一定还在。
再往前一步,是让 AI 自己来查这份记忆。
把织网 MCP 配置到支持的客户端,并在客户端信任、启用后,就可以让它查询已授权收录的记录。
比如在 Codex 的新对话里说:
用织网找一条我之前在 WorkBuddy 讨论过的方案,先给我来源和相关原文,等我确认后再接着做。
这句话里,我特意保留了“先确认”。找到了相似内容,还是要核对是不是当前项目,不能搜到一条就直接当成结论。
这里也说清楚:**当前并不是所有 AI 的记录都已经自动互通。**GPT 网页版的聊天记录还没有接入自动收录。要把织网中找到的背景交给 GPT,可以在面板选择内容、复制背景和任务,再粘贴过去继续做。
本地保存与交给 AI 处理,也要分开理解。记录索引放在本机;当你选择把原文交给某个 AI 时,那部分内容会进入对应工具处理的范围,敏感资料仍要自己把关。
真正花心思的,是让别人知道下一步怎么做
自己能用,和交给学员用,差别还挺大。
这几天我一边让 AI 帮我开发,一边盯着页面和使用步骤,反复改。
比如,相关产出最初展示了不少路径和“所在文件夹”的文字。后来我觉得,找图片的人,第一眼应该先看到图片;找文档的人,应该先看到文件名和打开入口。
于是图片改成了缩略图,复制路径、打开文件夹这些操作收进“更多”。
还有首次配置。原来内容一长,得往下翻,普通用户很难一眼知道自己做到哪一步。
后来我们把它整理成横向四步:选择来源、核对收录、连接 AI、实际查询。**需要时再展开详细配置,旁边保留图文教程。
这里有个特别容易误会的地方:面板里能看到 WorkBuddy 的记录,说明收录成功了;想让 WorkBuddy 自己调用织网,还要完成 MCP 配置,并回到客户端启用。
所以我们把“实际查到来源和原文”放在最后一步。配置文件写进去了,还得真的查一次,才知道通没通。
昨天又把安装、激活、升级和重复安装的流程在自己电脑上跑了一遍,检查原来的记录和 AI 配置有没有保留。
现在有 Windows 安装版,可以先交给同事和学员小范围体验。不过,本机测试通过还不够,不同电脑、不同安装位置的问题,接下来还要继续收集和修复。
后面准备怎么做?
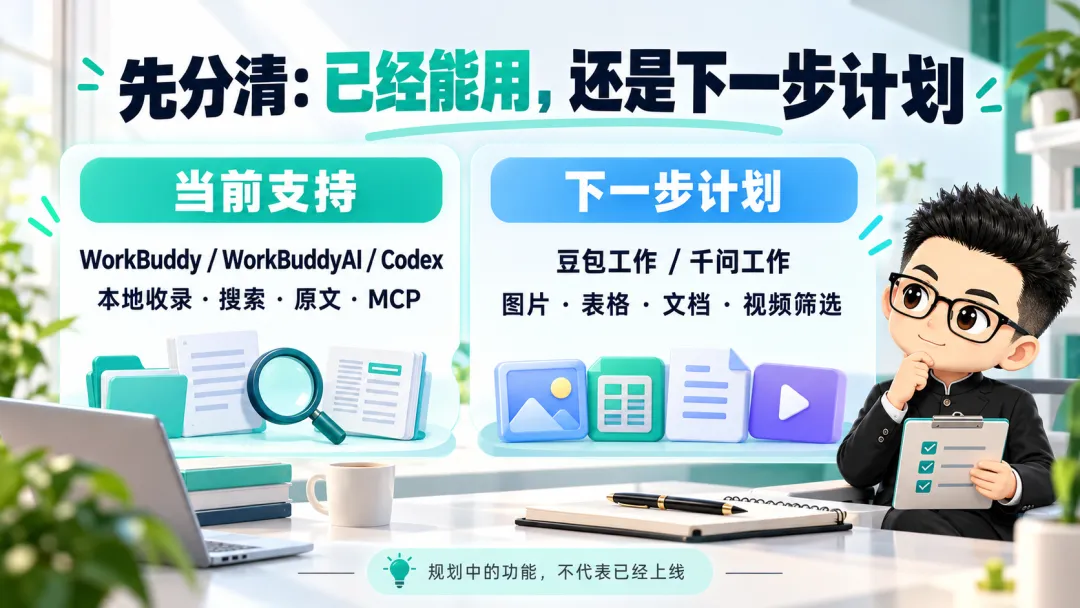
第二轮,我们已经把豆包工作、千问工作放进了计划。
这里会分两件事做:让它们通过 MCP 查询织网,以及把它们自己的聊天记录收录进来。两件事需要分别验证,不能因为有连接器,就默认聊天记录也已经能读。
另一块,是把产出找得更方便。
比如只勾选“图片”,就看所有已接入平台的图片;再选“Codex”,就只看 Codex 里的图片。表格、文档、视频也按这个逻辑做,找到文件后,还能回到所属聊天看上下文。
更后面,再考虑软件内更新、跨电脑迁移或同步,以及 Mac 版本。它们都还属于后续方向,我不想现在就把承诺铺得太大。
先把现有这条路跑顺:装得上、收得到、查得准、接得下去。
这个过程,也改变了我做工具的想法
织网一开始,就是从自己工作里一个反复出现的小麻烦长出来的。
我先说清楚自己在哪里卡住,再和 AI 一起把它做出来。等它能用了,又站在第一次安装的学员角度,重新检查每一个入口、每一句提示和每一步操作。
这套过程,我觉得也值得给正在尝试用 AI 做工具的宝子参考:先找一件自己经常重复、又确实麻烦的事,把发生场景和想要的结果讲清楚,再拿一个能用的小版本去验证。
如果你也在几个 AI 之间切来切去,可以回想一下:最近一次接着做旧项目,你花了多少精力在找记录和补背景上?
这就是我想用织网慢慢解决的问题。
找回聊过的,接着做想做的。
有兴趣的宝子,可以关注「AI电商运营学习社」。后面我会继续分享织网的使用、开发过程和真实反馈,包括哪些地方顺了、哪些地方还没做好。