ARTICLE · 1270396
65 万字白皮书,官方做成了文档站,我做成了能点、能拖、能听的学习站
65.2 万字,62 篇可读文章,19 个企业案例,按每分钟 400 字算,完整读完大约 27 小时。
这是《AI Agent Handbook》的体量。它讲企业级 Agent 的工程实践,从架构、构建、运行一直写到治理、调优和案例。内容很密,密到不少章节读完之后会有同一个感觉:每个字都认识,合上页面却拼不出一张完整的图。
2026 年 9 月 23 日,我开始给这本书做一个交互学习站。10 月 10 日,官方仓库合并了自己的 VitePress 阅读站。两个站面对同一本书,做的却不是同一件事。
一、先把官方站的位置说清楚
官方站是一个合格的文档站,而且在几个地方做得比我好。
它用 VitePress 1.6 搭起来,有中文搜索、移动端目录、字号调节、阅读位置记忆、图片放大、Mermaid 图渲染和当前章节打印。章节地址是稳定的,正文就是仓库里的 Markdown,改一处内容就能重新发布。对一本书来说,这些是地基:读得准、找得到、引得出。
我的站没有去复制这些。复制一个官方站,最多得到一个更差的官方站。
官方站回答的是「这本书写了什么」。我想回答另外三个问题:我该从哪里开始读,这些概念之间是什么关系,读完以后怎么知道自己真的学会了。
一个是 documentation,一个是 course。文档追求准确和稳定,课程追求路径和反馈。定位不同,功能才会长成不同的样子。
官方站上线后,我反而轻松了一点:权威入口有人接了,我可以把时间全部花在交互层,而不是再维护一套本地镜像。
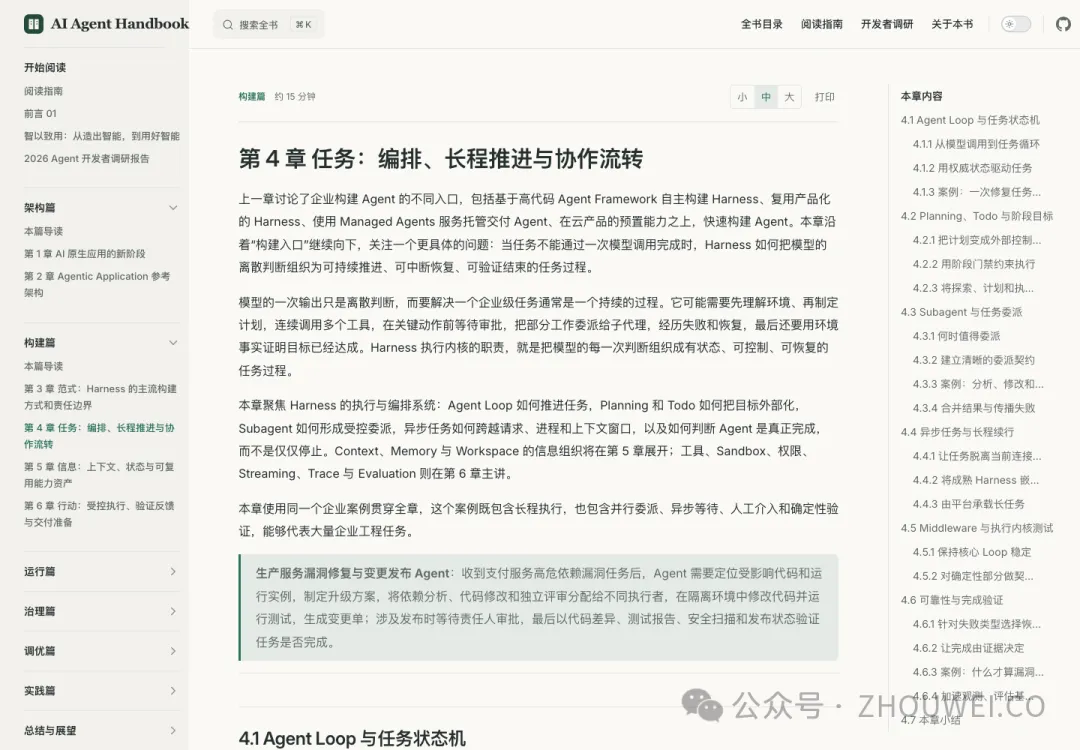
来源:官方阅读站线上截图,2026-10-28。
二、学习站多做的五件事
1. 把目录变成路径
62 篇文章按 8 个篇章排好,目录是清楚的,但清楚不等于知道从哪读。
路径的内容来自官方阅读指南,那里已经按角色给了 5 条推荐顺序。我做的是把它从一页文字变成 5 张可点击的卡片:第一次系统了解企业 Agent、正在把 Agent 接入生产、正在建设多 Agent 系统、负责评估与持续优化、负责选型或项目立项。每条路径 5 到 12 篇,标出篇数,点「从这里开始」就能进入第一篇。
同一个目录,对不同角色给出不同入口。平台工程师和项目负责人不需要从第 1 章按顺序读到第 30 章。
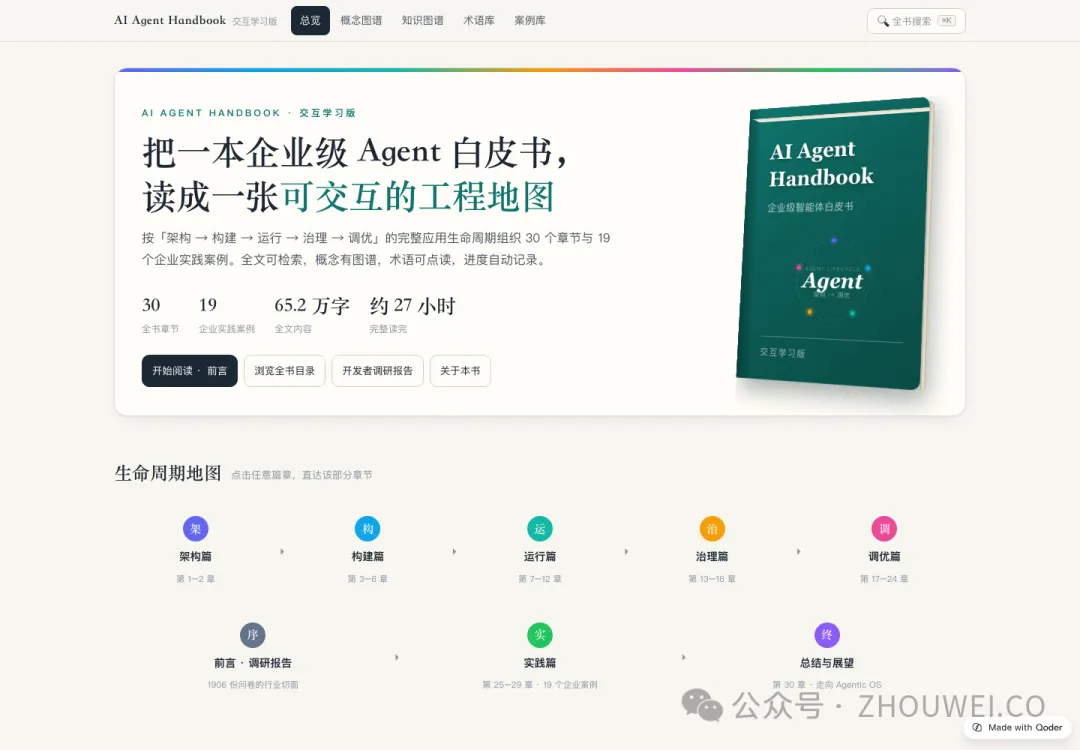
来源:交互学习站线上截图,2026-10-28。
2. 把静态图变成可以操作的实验
书里有大量架构图和流程图。官方站用 Mermaid 渲染,能看,也能展开源码。但看图和做实验是两件事。
我把书里最关键的 22 个结构做成了可操作的图解。比如第 4 章的 Agent Loop,可以点「单步执行」,看一次修复任务怎样从 Prepare 走到 Model、Act、Observe、Verify,再回到下一轮;第 6 章的 HITL 决策,可以选四个不同风险的动作,看策略给出 ALLOW、ASK 还是 DENY;第 9 章的预算不变量,可以拖四个滑杆,亲眼看到重试次数相乘之后,最坏消耗怎样从直觉里的几百变成 9 倍。
这些图不是配图,是把一段文字压缩成一次操作。读完文字,你可能记住「预算要按调用链乘积核算」这句话;拖过滑杆,你会记住那个数字跳红的瞬间。
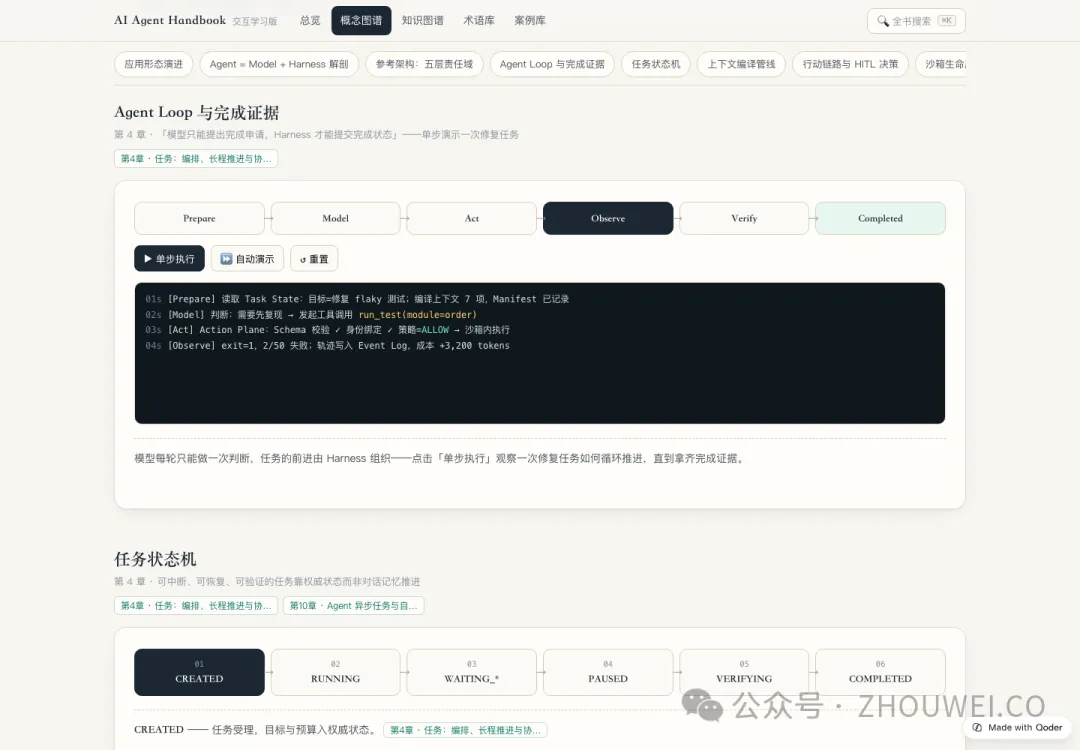
来源:交互学习站线上截图,2026-10-28。
3. 把章节变成概念网络
书的目录是线性的,概念不是。
我抽了 37 个核心概念,连了 60 条关系,做成一张可以用鼠标拖拽、缩放、悬停查看的知识图谱。节点按篇章着色,边分四类:包含、依赖、流转、治理。点一个节点,可以直接跳到解释它的章节或图解。
读第 11 章 Multi-Agent 的时候,你会看到它和 Agent Loop、任务状态、通信协议、可观测性都连着。这种「这一章在整张图里站在哪」的感觉,目录给不了。
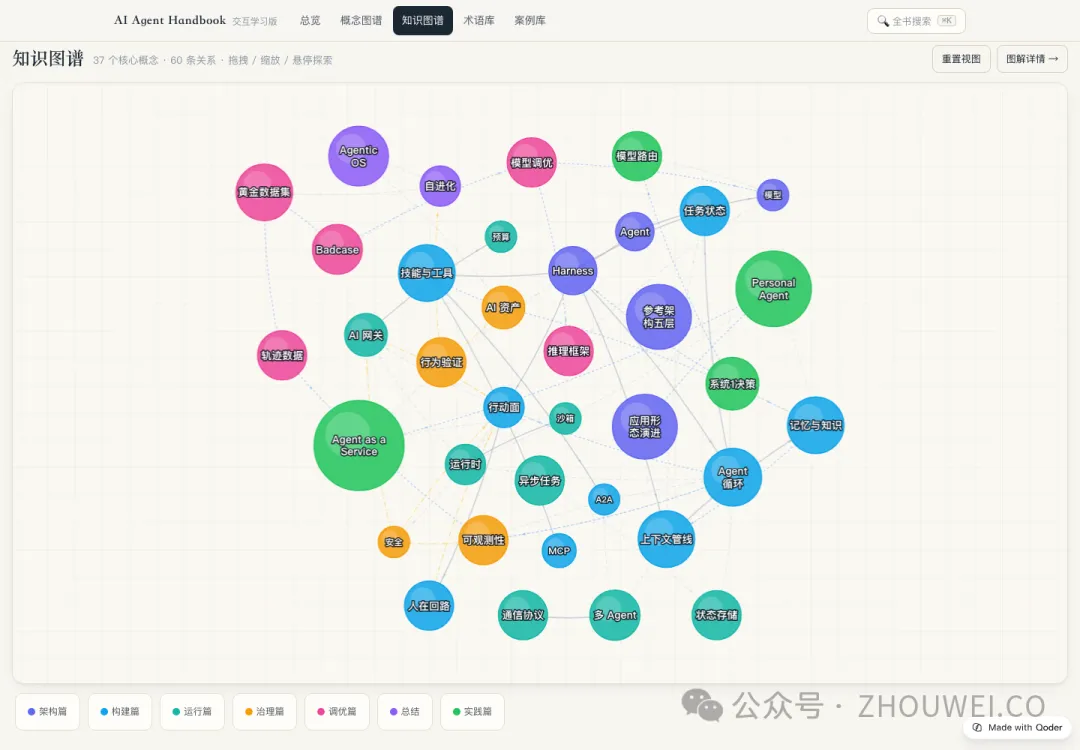
来源:交互学习站线上截图,2026-10-28。
4. 把术语和案例变成可查的索引
书里有一批反复出现、但第一次出现时不一定解释清楚的概念。我整理了 99 条术语,每条给出原文定义、所属篇章和相关章节。正文里第一次出现某个术语时,会自动标注,点开就是词条;词条页再反向链接回相关章节。
案例也做了同样的处理。19 个企业实践加 6 篇专题,不再只是标题列表,而是一张张卡片:谁做的、解决了什么问题、大概读多久。可以按研发效能、设计工程、运维与安全、客户与销售、Agent Infra 等方向筛选。
术语解决「这个词是什么意思」,案例解决「别人是怎么做的」。两件事都不在正文的线性阅读路径上,但它们是学习时最常回头查的东西。
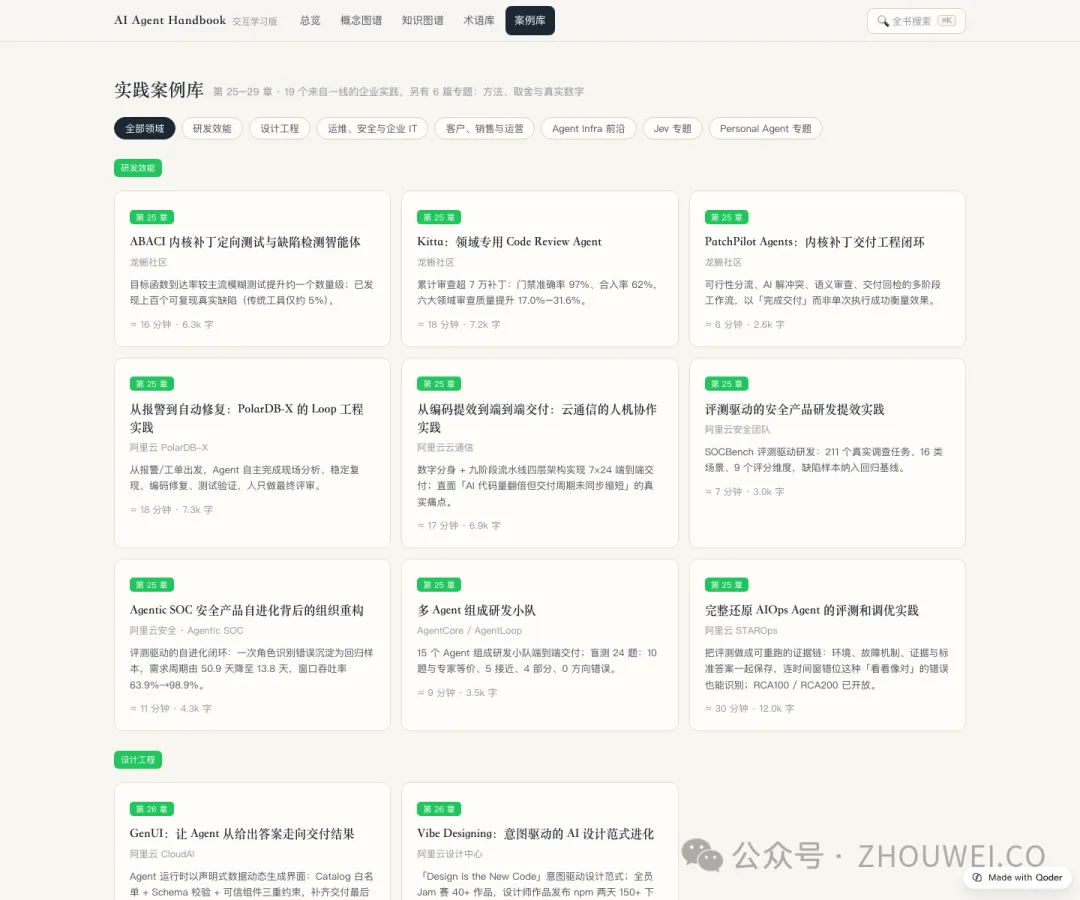
来源:交互学习站线上截图,2026-10-28。
5. 把「读完」变成「学完」
文档站通常记录你读到哪一页。学习站还要回答:你读完了多少,下一步该读什么。
首页按 8 个篇章显示进度,每章可以手动标记完成,下次打开自动回到上次的位置。搜索不是只给一个结果列表,而是 414 个段落级索引,命中后带着上下文和所在章节,按 ⌘K 随时唤起。
阅读页还加了朗读。浏览器自带的语音合成按句朗读,读到哪句高亮哪句,可以调语速、选音色,也可以连听下一章。通勤路上不方便看屏幕的时候,至少可以让它先读一遍。
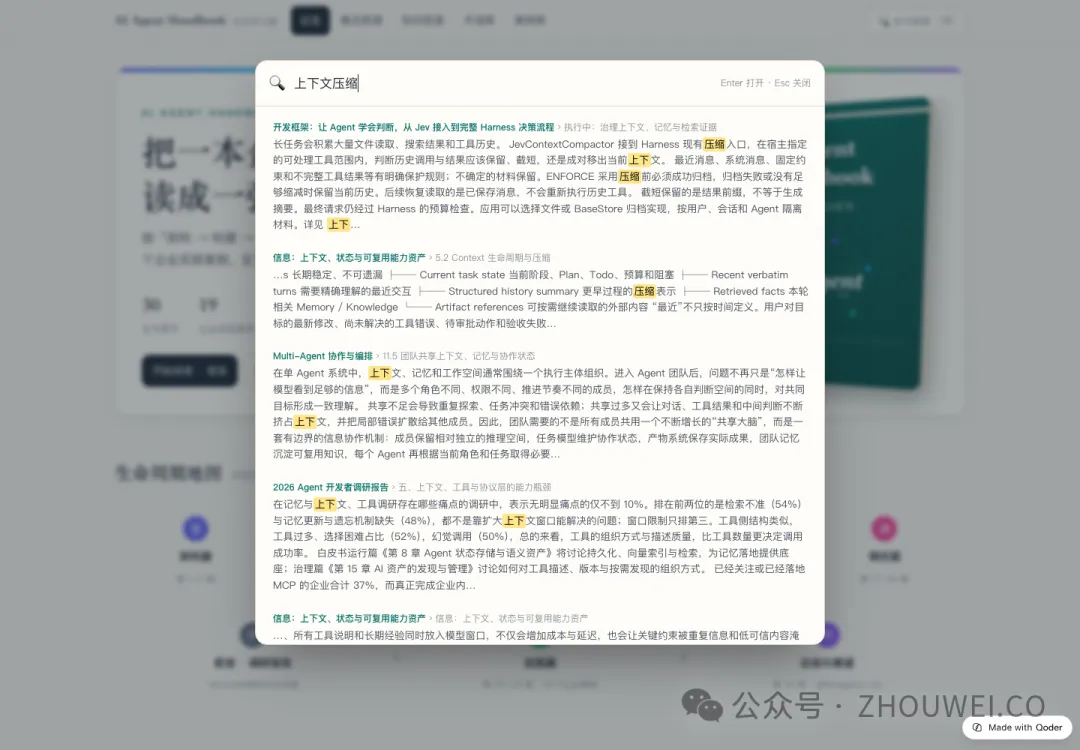
来源:交互学习站线上截图,2026-10-28。
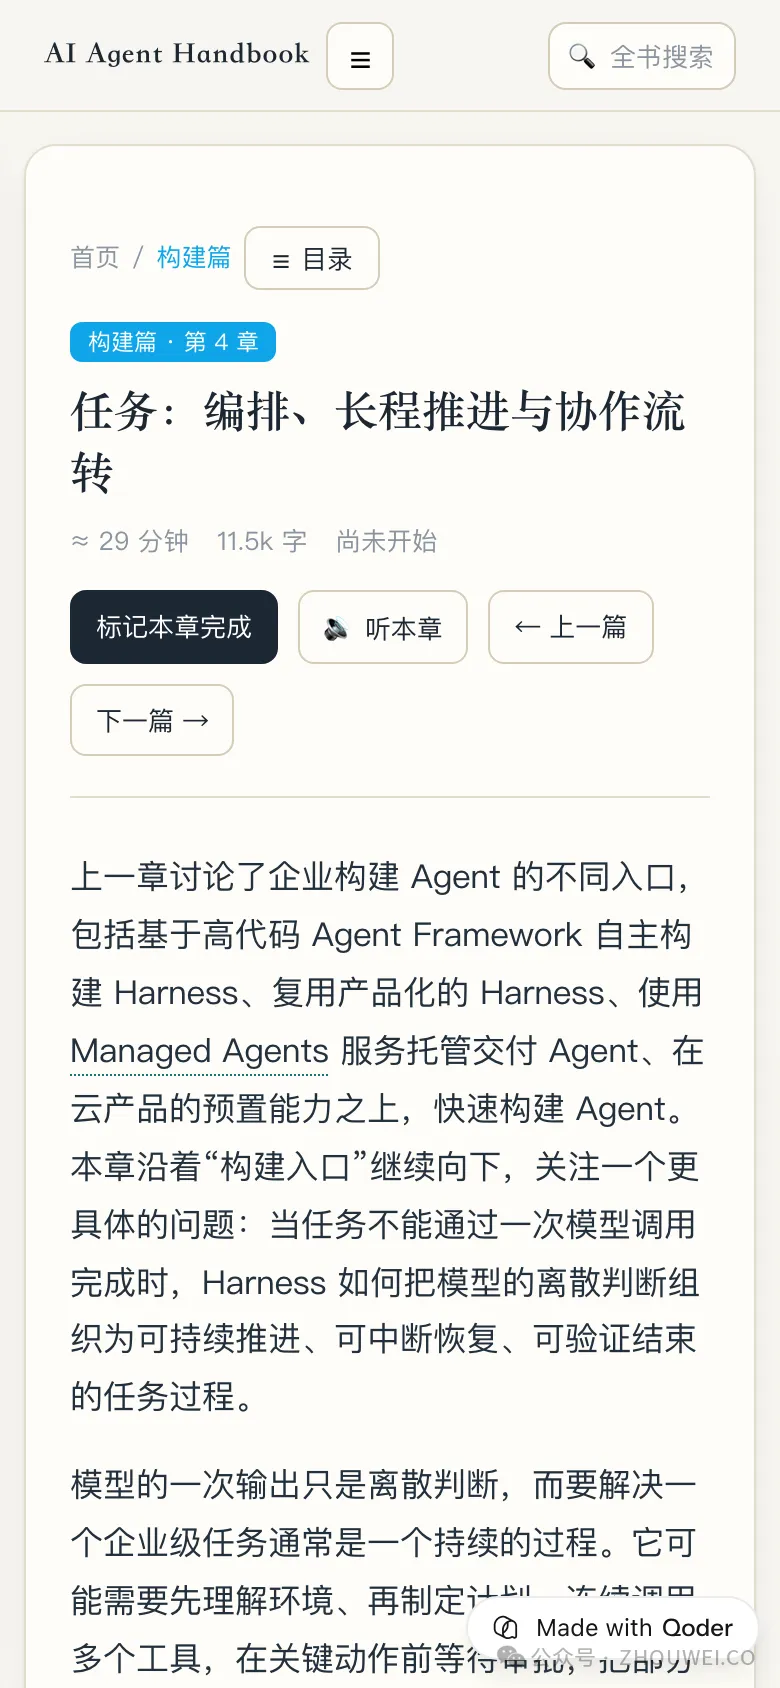
来源:交互学习站线上截图,2026-10-28。
三、一张表看清边界
这张表里没有「谁更强」,只有「谁更适合当下的动作」。查一段定义、引用一个链接、打印一章给同事,官方站更合适。想系统过一遍、把概念连起来、在手机上听一段,学习站更合适。
这些能力没有出现在官方站里,不是因为官方没想到。VitePress 的地基是 Markdown 和稳定 URL,交互图解、知识图谱、朗读都不在它的职责里。文档站的第一优先级是准确、稳定、可引用,任何会漂移的东西都是负债。
反过来,我这个站是派生层。它可以从上游同步内容,也可以随时改交互、改版式、改数据口径,试错成本比官方站低得多。这是位置带来的自由,不是技术上的优越。
四、做成这样,靠的不是框架
很多人以为交互站用了很重的前端技术。实际上它没有 React,没有 Vue,没有打包器。四个 JavaScript 文件加一份 CSS,哈希路由,localStorage 记进度,浏览器直接加载。
真正花时间的,是四件看起来不性感的事。
第一,构建期把数字算准。 文章清单、搜索索引、总字数、阅读时长、案例数、术语数,全部由构建脚本从 Markdown 和清单文件算出来,页面只负责显示。首页写「65.2 万字」,正文里就不会出现另一个「56.8 万字」。这个项目之前真的出现过两套数字打架,后来把统计收成了一个来源。
第二,锚点要稳定。 最早的标题锚点是按位置生成的 s1、s2、s3,标题一增删,全站深链集体错位。后来改成按标题文本哈希生成,构建时再把上一代的旧锚点迁成别名。现在有 1017 条旧链接可以继续跳对,地址栏还会自动升级成新锚点。
第三,图表引擎要能在弱网下活下来。 早期 Mermaid 挂在外部 CDN 上,网络一抖,21 张图全部退化成「引擎未加载」加一坨源码。后来把 5.5 MB 的引擎打进站点,按需加载,渲染失败也有源码可展开、有大图可看。
第四,每次发布都要换版本号。 iOS Safari 的缓存很凶,不换 ?v=,用户看到的还是上一版。现在这件事交给脚本,漏挂一个文件、少换一个版本号,脚本直接报错退出。
还有一类问题,只有真的在手机上读才会暴露。点击目录后标题被固定顶栏遮住,是因为定位用了浏览器原生的 scrollIntoView;图片和图表异步撑高页面,跳过去之后目标又漂走几百像素,是因为「版面稳定 200 毫秒」这个判据在引擎还没下载完时也会成立。Chrome 的原生滚动锚定会掩盖这个问题,iOS Safari 不会。最后是给定位循环加了一条规则:目标上方还有没落定的图,就不许退场。
这些修法后来都变成了测试。现在站点有 189 条冒烟断言,其中 27 条是源码级的不变量守卫;另有 20 条证伪用例,专门把每条守卫改回坏形态,确认测试真的会挂。修一个 bug 只改代码,下次重建一定重蹈覆辙,所以每修一个,都要留下一条断言、一条守卫和一条证伪。
五、真正的成本在维护
做站是一次性投入,维护是长期租金。
这本书的上游仓库隔几天就有新章节、新专题、新配图。站点里有一半的东西是构建脚本自动生成的,另一半是手工策展:术语库、知识图谱、22 张图解、案例卡的署名和钩子、5 条阅读路径、7 个章和专题的落地页。这五层不会随着构建自动更新,每来一篇新文章,都要有人判断它属于哪一章、要不要补术语、要不要进阅读路径。
最险的一次,上游一次带进 3 篇新文章,清单没登记,构建不报错,站点静默少了 3 篇。后来加了一条扫盘守卫:按清单里的顶层目录扫描所有 Markdown,有没登记的直接 FAIL。这条守卫本身也证伪过,第一版把仓库根写错了,扫的是不存在的目录,永远 PASS,等于没测。
现在有一个每天 7 点跑的定时任务:拉取上游、快进合并、重建数据、升版本号、跑冒烟、发布、线上校验。一个人加一条定时任务,能维持每天同步,但这套东西不适合「做完就放着」。
所以我不建议每个人都去做一个交互站。先问自己一个问题:你愿不愿意为五层策展持续付租金。愿意,它会长成一个真的学习系统;不愿意,它会很快变成一个比官方站更差的镜像。
六、谁该用哪个
适合用学习站的人:想系统过一遍这本书的工程师,带团队做内训或读书会的人,通勤路上想听一段的人,以及需要把「架构、构建、运行、治理、调优」连成一张图的人。
更适合用官方站的人:只想查一个定义、需要引用稳定 URL、要打印或归档、希望内容由上游直接维护的人。这些场景里,官方站是更正确的入口。
两个站不是替代关系。官方站把书读准,学习站把书学进。
两个入口:官方站 https://aliyun.github.io/ai-agent-handbook/[1],交互学习站 https://ai-agent-handbook-buqw1y310io.qoder.zone/[2]。
如果这件事有什么可复用的结论,大概是一句:把一本书搬到网上,不等于把它变成学习材料。真正值得做的,不是再做一个文档站,而是给读者一张自己能走的地图。
引用链接
[1]https://aliyun.github.io/ai-agent-handbook/
[2]https://ai-agent-handbook-buqw1y310io.qoder.zone/