ARTICLE · 1278319
当AI问诊量超过全国门诊总量:边界与责任在哪里
最近一组对比数据,正在医疗圈流传:据第一财经报道,豆包每日健康咨询人次突破2000万;
而国家卫健委公开数据显示,全国所有公立、私立医院单日线下门诊总量为1000万出头。
一个通用AI应用的日问诊量,约等于全国医院的两倍。
量级关系已经说明问题:AI问诊不再是"未来话题",它已嵌入相当一部分人的就医路径——先问AI,再进诊室,甚至带着AI的结论"考"医生。
这篇文章不讨论"AI该不该用于健康咨询",那已是既成事实。我们讨论三个更实际的问题:
AI问诊的真实水平线在哪里?
诊室里的冲突,责任怎么算?
对从业者、研究者与投资者,边界应该画在哪里?
一、就医路径已经改写,争论还停在"要不要用"
国内侧,除了豆包的2000万日咨询量,百度健康披露的另一组数据是:
全国7亿AI用户中,47%曾从AI工具获取过医疗健康相关信息。
国际侧,OpenAI官方披露,2026年1月全球每周有超过2.3亿人在ChatGPT上询问健康相关问题,到7月,这个数字升至3亿。
医生端的变化同样剧烈。
2026年10月媒体披露的一项医生调查显示:约七成受访医生在门诊遇到过患者用AI查询健康信息,其中36%的医生每月遇到两到四次,24%每周四次以上。
有三甲医院医生透露,一上午接诊三十位患者,二十多位是带着AI生成的诊断结论来的。
10月,一张"门诊告示"截图冲上热搜:"已在豆包获得诊断的患者,请勿再向我们寻求意见,请改向千问或元宝咨询。
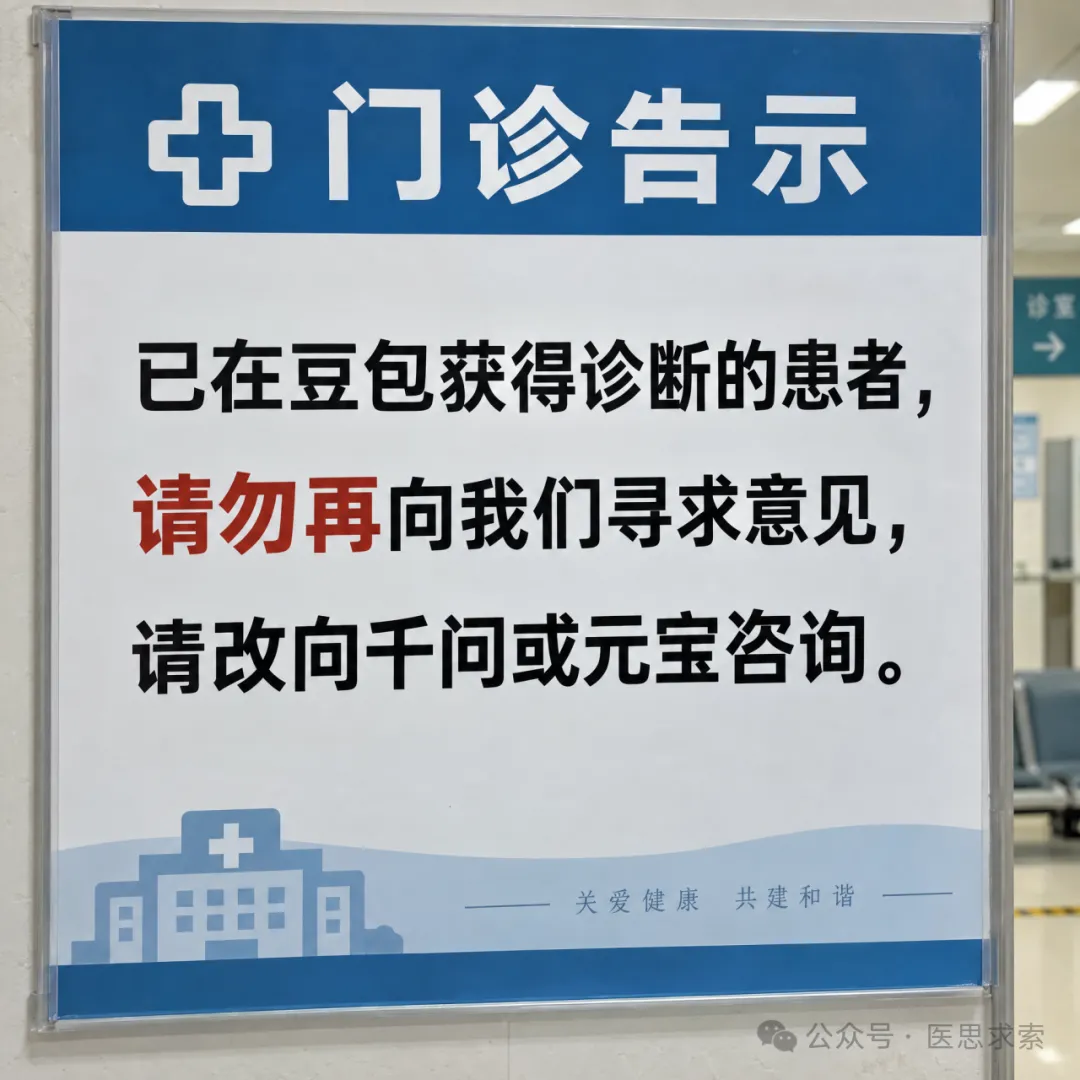
"经媒体多方核实,这张告示是网友恶搞。但一张假告示能刷屏,恰恰因为它戳中了真问题——患者带着AI结论走进诊室,已经不是个别现象。
这构成本文的第一个判断:对医疗行业而言,"要不要用AI"的讨论已经过期。
真实的问题是,AI已经在路径里,路径该怎么重排。而要回答这个问题,得先弄清AI问诊的真实水平。
二、诊室里的"三人会诊":被考试的是医生
#
先看现象。
有媒体把现在的诊室称为"三人会诊":患者先问AI,再拿着"参考答案"进诊室,一句"为什么你和它说的不一样",医生得先当裁判、再当解说、最后才当大夫。
#
被考验的不只是医生的耐心。
前述医生调查里有两个数字值得细看:81.33%的医生认为,AI健康建议最突出的问题是"缺乏个体化";
73.33%担心它增加患者对疾病的误解或焦虑。换句话说,一线医生对AI的主要疑虑,不在"它聪明不聪明",而在"它不知道面前这个人的具体情况"。
#
具体到科室,冲突有更锋利的形态。
有眼科医生反馈,曾接诊青光眼急性发作期的患者,执意要求按AI给出的方案直接做激光手术——而急性发作期的规范处理顺序,恰恰是先药物紧急降眼压,再评估手术时机。
下一节要详述的案例则更广为人知:家长因为AI判断"哮喘急性发作",拒绝了医生提出的胸片检查。
人民日报健康客户端采访中,世界中医药学会联合会中医药大数据产业分会副会长黄新霆的表态,可视为专业界的集中判断:AI存在知识不全面、信息滞后的问题,不能作为医疗决策依据。
需要说明的是,诊室冲突的账不能全记在AI头上。
前述调查显示,遇到诊断不一致时,48%的医生会结合AI内容和患者一起讨论,20%会详细解释差异——多数医生选择的不是对抗,而是把AI变成沟通素材。
真正的问题在于:解释差异挤占的是本就紧张的门诊时间,这部分新增的沟通成本,目前没有任何主体为之付费。
三、52.1%:一条必须读懂的水平线
AI问诊到底是什么水平?
2025年,大阪都会大学医学研究生院的一项系统性回顾与荟萃分析,给出了目前最具参照价值的答案。研究纳入GPT-4、Llama3 70B、Gemini 1.5 Pro、Claude 3 Sonnet等主流模型,其中GPT-4被研究得最多。
结论可以概括为三层:
第一,生成式AI的平均诊断准确率为52.1%,与非专家医生的表现相当;
第二,较专家医生仍有15.8%的差距;
第三,AI在皮肤科诊断中表现尤为突出,但研究者同时提醒,皮肤科诊疗不仅需要图像识别,还需结合临床推理与个性化决策。
这组数字怎么读?
52.1%的准确率,放在考试里是不及格;放在医疗里,意味着接近一半的病例会得到错误或不完整的判断。
研究者的结论也是克制的:生成式AI具备辅助医疗诊断的潜力,适用于医学教育、支持非专家医生以及医疗资源匮乏地区的诊断支持——"辅助"与"支持",始终是关键词。
比数字更值得警惕的,是数字背后的问题:AI不知道自己不知道。
医生的判断自带置信度表达——"典型表现,基本可以确定",或者"不典型,先排查别的";通用大模型的输出永远流畅、永远自信,错误答案与正确答案在语气上毫无区别。
人类医生对不确定性的感知,恰恰是医疗安全的最后一道闸门。
还有一道信息鸿沟常被忽略。北京佑安医院感染综合科主任医师李侗曾讲过一个病例:他怀疑患者是鹦鹉热,问家里养不养动物,患者答不养;反复追问才确认,家属接触过鹦鹉。
AI问诊只能处理"患者能文字化描述的信息",而关键线索往往藏在患者自己都没意识到的地方——更不必说查体、听诊这些只有医生本人能采集的信号。
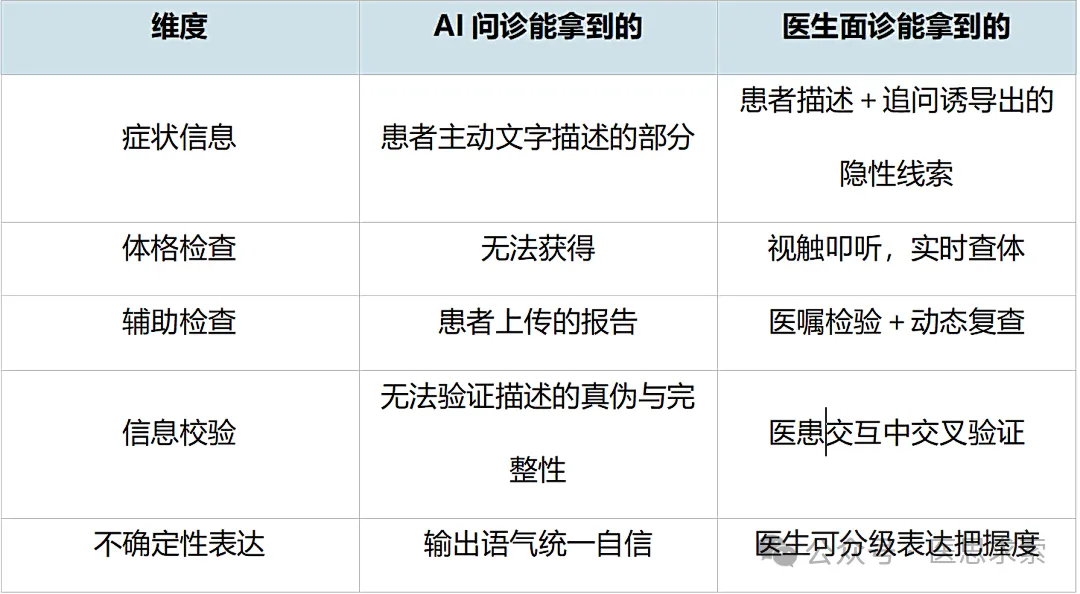
这张表解释了本节的核心结论:AI问诊的短板,不是"知识不够",而是"信息输入天然残缺"。
知识可以靠语料堆出来,输入残缺要靠问诊交互来补——而通用大模型恰恰没有为医疗场景设计信息采集流程。
四、一个3岁孩子的代价:当"信AI"变成"拒检查"
水平线的讨论,最终要落到具体的人身上。
据澎湃新闻等媒体报道:浙江一名3岁男孩阳阳(化名)有支气管哮喘病史,此前多次因喘息发作就诊。前段时间,阳阳断断续续咳嗽,妈妈把症状输入AI问诊,得到的判断是"支气管哮喘急性发作",建议雾化治疗。妈妈深信不疑,到医院后只要求开雾化药。
接诊的浙江省中医院儿科主任李岚听诊发现,孩子肺部有明显湿啰音,建议拍胸片。妈妈拒绝了,理由是"AI也说是哮喘发作"。两天后,阳阳因双肺大面积炎症紧急住院。
复盘这个案例,AI的错误不是随机的,而是结构性的:哮喘病史构成了强烈的锚定信息;家长输入的"咳嗽、喘息"天然指向既往诊断;而湿啰音——这个只有听诊才能采集、直接指向肺炎的关键证据,从一开始就不在AI的信息输入里。
AI基于残缺的输入给出了流畅自信的答案;家长把"健康咨询"用成了"诊断依据",拒绝了唯一能补全信息缺口的检查。
这里的责任链条值得逐环检查:
医生误诊,有执业责任和医疗损害鉴定体系兜底
医院管理失职,有管理责任
药品出问题,有不良反应监测体系
而AI给出错误判断,责任落在哪?通用大模型没有执业资质,服务条款里几乎都写着"本内容不构成医疗建议"——快和免费的前提,恰恰是把责任前置给了用户自己。
这才是当前AI问诊最深的结构性风险:不是它会犯错,而是它犯错之后,没有人、也没有机制为之负责。
五、三道边界:给从业者与研究者的判断题
数据、现象、水平线、代价——现在可以正面回答标题里的问题了。对本文的四类读者,答案可以收敛为三道边界。
第一道,信息边界。
如上所述,AI问诊处理的是"患者能描述的症状",医生处理的是"患者本人"。
这条边界决定了合理的使用清单:院前信息梳理、专业术语通俗化、检验报告初步解读、就诊科室建议——这些不依赖查体信息、定位为"咨询"的场景,AI是称职的。
而下诊断、定处方、做治疗决策,依赖的恰恰是AI拿不到的那部分信息。同一个模型,用在检索上是工具,用在决策上是越权。
第二道,责任边界。
现行规则已经给出方向:《互联网诊疗监管细则(试行)》第二十一条明确,"处方应由接诊医师本人开具,严禁使用人工智能等自动生成处方";
2026年发布的《医疗机构人工智能应用与治理专家共识》(40余家机构联合制定)基调是"人机协同、以人为主";国家药监局拟发布的相关指导原则,则要求AI"仅可辅助医师决策,不得单独作为诊疗依据"。
规则方向一致:AI可以出现在诊疗链条里,但责任主体必须是人。
对互联网医疗从业者,这条边界的含义是产品红线:不承接诊断责任的功能,就不要用诊断的措辞去获客;用"确诊""治愈"话术拉新的产品,等于把监管风险写进了自己的增长模型。
对关注医疗AI的投资者,含义同样清晰:这类产品的核心竞争项不是模型参数,而是能否定义清楚责任主体、能否通过临床质控。责任能力,就是护城河;讲不清谁来担责的产品,也讲不清估值逻辑。
第三道,使用边界——这一条是给医生的。
AI前置问诊已是既成事实,与其对抗,不如把它变成质控节点:把患者带来的AI结论记进病历,把差异点显性化,关键检查不因AI结论而跳过。
调查中48%的医生选择"结合AI内容和患者一起讨论",这条务实路径的沟通成本,最终需要门诊制度来消化;但至少在个体层面,把AI结论从"考题"变成"病历素材",是医生现在就能做的转身。
结语
回到标题:AI问诊量超过全国医院日门诊总量,是事实;它不等于诊疗能力超过医生,也是事实。
2000万次日咨询里,绝大多数是合理的信息需求;被推到台前的,是那部分越界成"诊断依据"的使用,以及误诊之后无处安放的责任。
技术便利与责任承担之间的这段距离,就是医疗AI未来几年真正要填的坑。
填坑的方式,不会是让AI更快、更便宜,而是让它更清楚自己不知道什么——并且让每一次输出的背后,站着一个能负责的人。
END
关于医思求索
医思求索研究中心,是医思求索生命科学研究(惠州)有限公司旗下的专业科研服务机构。我们拥有自建的标准化实验室,聚焦生命科学与生物医学基础研究,提供从数据库挖掘与生信分析、临床数据统计建模到动物 / 细胞基础实验、课题与方案设计的一站式科研支撑,我们也拥有自主研发的四大技术服务平台——生信分析服务平台、基础研究实验平台、医思求索科研服务平台、方案设计与数据质量管理平台。我们将以规范的质量管理保障数据真实、结果可追溯——让研究者把更多精力放回科学问题本身。