ARTICLE · 1279297
OXR 1.3B:文档解析能力与同条件测试对比
量子位于2026年10月27日介绍的开源文档解析项目OXR,参数规模为1.3B,可把PDF和文档图片解析为Markdown或JSON,覆盖13类文档元素,并处理阅读顺序与版面坐标。团队同条件测试显示,OXR解析100页文档平均约101秒。RSI则利用错样本、弱样本及外部模型生成下一轮训练数据,且新增数据无需人工标注。
OXR开源一周后的关注度
OXR开源一周后的传播规模,是这一节需要交代的第一项信息。量子位于2026年10月27日发布的内容称,项目在Github获得超1000 star,在X上的关注度破百万,并登上Today‘s news推荐。
这些数字对应的范围是OXR公开开源后的第一周。对关注文档解析工具的开发者来说,项目已经不只停留在技术介绍阶段;至于它是否适合具体任务,还需要继续查看解析范围、阅读顺序处理方式和测试条件。
OXR 1.3B解析范围
1.3B模型处理哪些文档元素
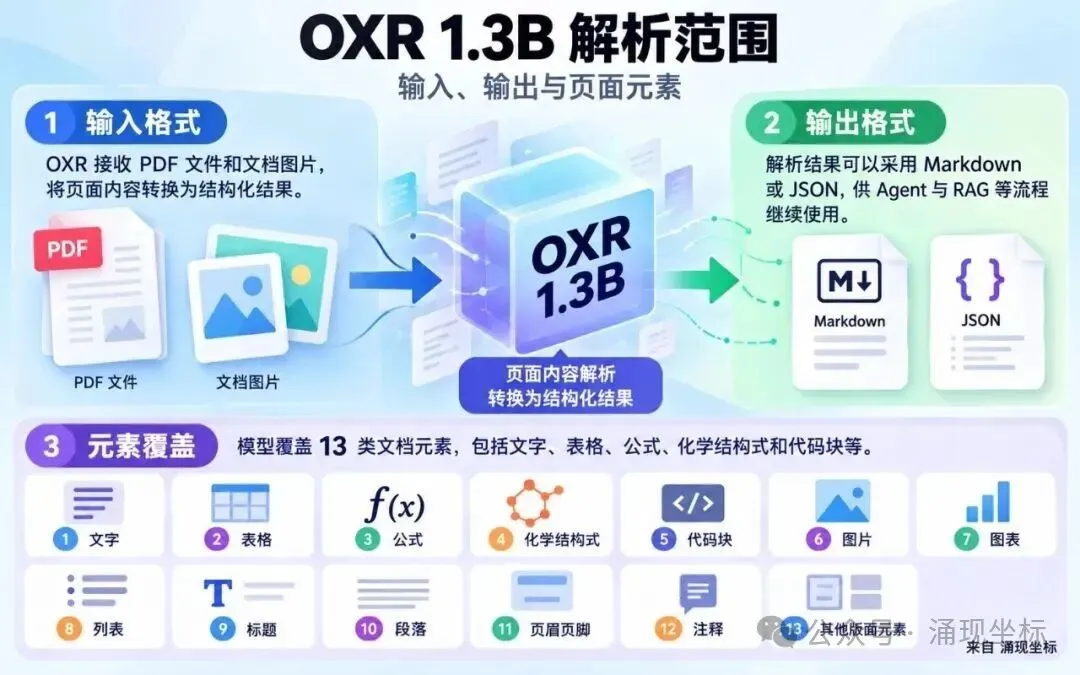
OXR 1.3B覆盖的输入和输出格式,是判断工具适用任务时需要先看明白的内容。量子位介绍称,它可以接收PDF与文档图片,并输出Markdown或JSON格式。
模型处理的页面内容包含13类文档元素,条目涉及文字、表格、公式、化学结构式和代码块等。输出结果面向Agent、RAG等下游流程,因此它与通用文本转录工具承担的任务并不相同。
100页文档测试对比
版面坐标与阅读顺序处理
版面坐标和阅读顺序,是OXR针对复杂文档结构给出的处理能力。量子位提到,即使页面中的各个区域都被识别出来,左右两栏内容按错误顺序拼接,或正文与旁注混在一起,也可能改变原文含义。
OXR在识别内容的同时处理前后关系,并给出内容所在的版面坐标,让位置信息随解析结果一起保留。该能力与13类元素识别共同作用于PDF和文档图片输入,输出仍是Markdown或JSON。
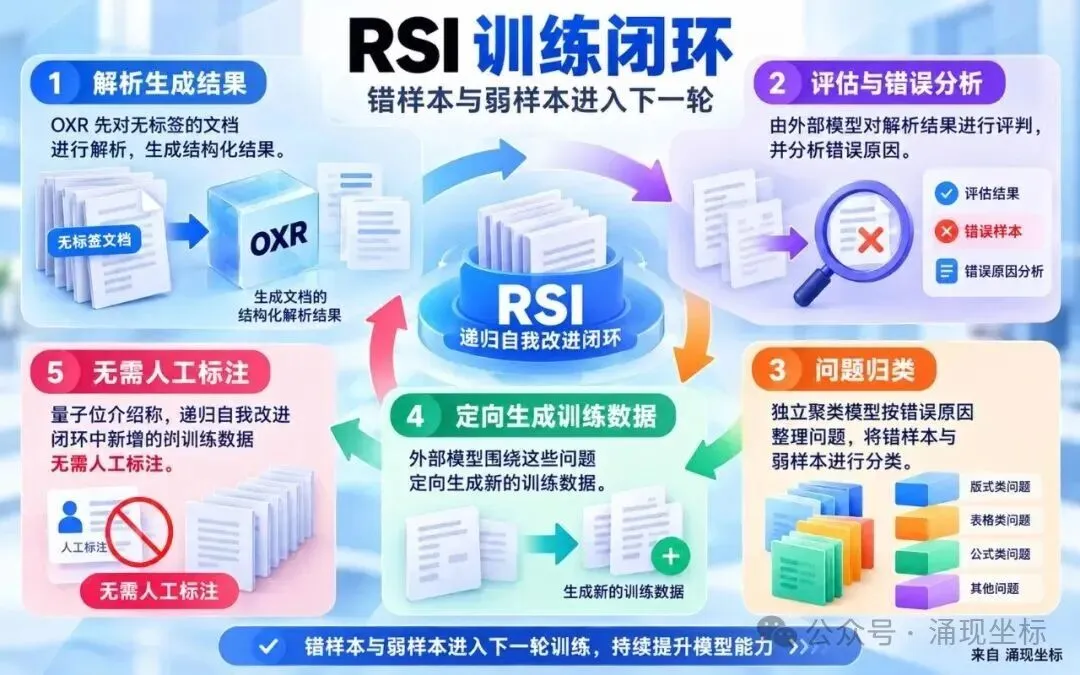
RSI训练闭环
RTX PRO 6000上的百页解析耗时
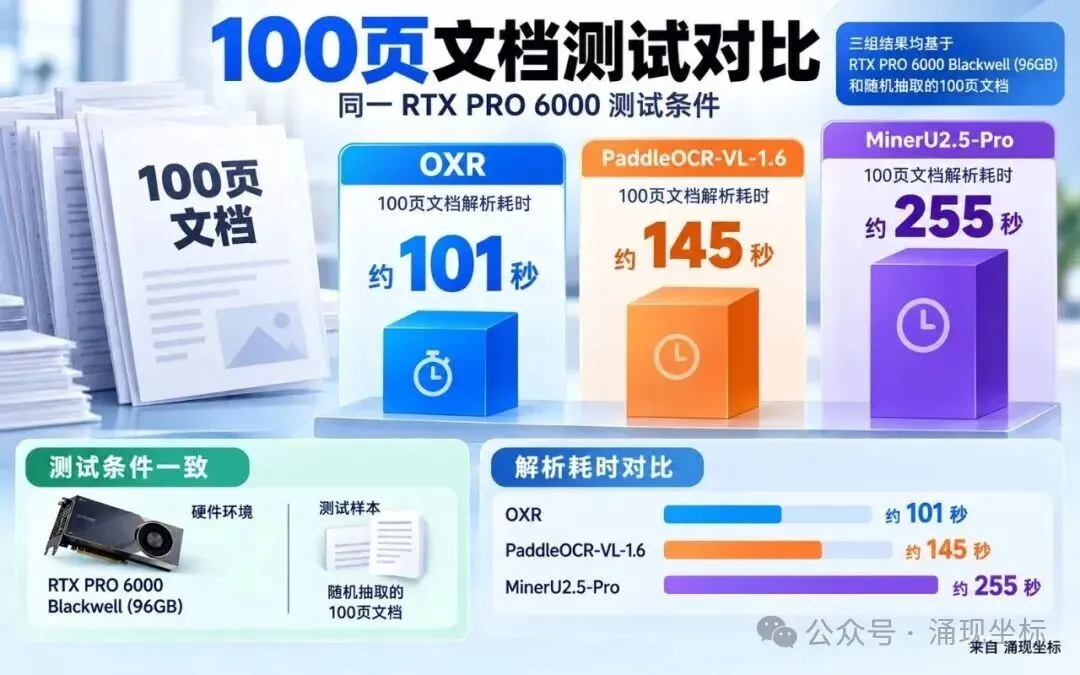
OXR、PaddleOCR-VL-1.6和MinerU2.5-Pro的解析耗时,可以在同一组测试条件下直接对照。量子位引用的团队完整解析测试使用同一张RTX PRO 6000 Blackwell(96GB)显卡,测试对象为OmniDocBench随机抽取的100页文档。
在那次测试中,OXR处理100页文档平均约101秒,PaddleOCR-VL-1.6约145秒,MinerU2.5-Pro约255秒。量子位同时强调,处理单份文档时几秒差距未必明显;当任务扩展到批量论文入库、档案整理或研报解析时,等待时间与算力占用才会受到影响。
轻量定位与主模型识别分工
OXR把版面定位、内容识别和顺序判断安排在不同模型阶段,这是理解其测试耗时的关键。量子位介绍称,轻量版面分析模型先负责定位内容区域,主模型接着处理内容识别与阅读顺序。
由于顺序判断被放进内容识别阶段,系统不必再单独运行一个阅读顺序处理环节,主模型也可以结合内容语义安排先后关系。这项架构设计与约101秒、145秒和255秒的同条件测试结果相关,但各项耗时仍限定在那张RTX PRO 6000 Blackwell(96GB)显卡和100页随机抽取文档中。
RSI如何生成下一轮训练数据
OXR在后训练阶段采用的递归自我改进流程,是其训练方法中区别于前述解析功能的一部分。量子位将其简写为RSI,完整名称是Recursive Self-Improvement,作用对象是文档解析中的错样本与弱样本。
具体流程先由OXR解析无标签文档并生成待评估结果,再由外部模型判断结果、逐个分析错误原因,独立聚类模型按照原因归类,随后外部模型围绕这些问题生成定向训练数据,供下一轮OXR训练使用。量子位称,闭环中新增加的训练数据无需人工标注;这项机制作用于训练数据准备环节,与运行阶段的解析速度和输出格式属于不同环节。
本文由“涌现坐标”主理人审核,使用 AI 辅助进行资料整理、初稿和配图制作。