ARTICLE · 1321810
测试大佬私藏的AI大模型产品测评助手——AIES,告别熬夜手敲接口脚本,从连通测试到定时回归全自动流水线搞定
做AI应用测试的人,大概都经历过这样的“版本上线前夜”:
老板问:“咱们这个接了大模型的客服助手,能不能上线了?”
你看着满屏的对话记录,只能硬着头皮回一句:“感觉……还行?”
为了证明这个“还行”,我试过所有能想到的“土办法”。
最开始,我把知识库文档和预设问题直接扔给大模型,让它给我打分。它确实能打,但问题来了:第一次,它给个5分,理由是“回答流畅”;第二次,它给个3分,理由是“语气不够专业”;第三次,它直接说“我无法判断”。我等于请了一个情绪极其不稳定的裁判,每次跑完测试,我还得自己对着Excel手动统计、肉眼找茬。
我也试过到处扒开源脚本。测接口连通用一套代码,算RAG的检索召回率和忠实度又得去跑另一个开源框架,最后再来个Locust跑性能。每次模型升级,或者知识库更新,甚至只是换了套Prompt,之前的环境配置全废,又得从头再来。
我等于给自己造了一堆散落的“零件”,每次测试都得重新拼装一台“战车”。
直到我被无数次格式错乱、环境报错和“只看成功率”的虚假繁荣折磨得筋疲力尽时,我才认真思考一个问题:既然大模型已经能写诗、能写代码、能当客服了,为什么测它,还非得靠我肉身去拼凑各种半成品工具?
后来我找到了答案——不是评测方法不行,是我的“打开方式”不对。问题不在模型不够聪明,也不在用例写得不好。我缺的不是测大模型的能力,而是一个能把接口连通、裁判打分、数据集设计、评测执行和定时回归串成完整闭环的“工程化容器”。
这也是 AIES(智能体测评平台)诞生的原因。
事实上,这不只是我一个人的痛点。一个很反直觉的现象正在发生:一方面,大模型和智能体在各类排行榜上的分数越来越高;另一方面,把它们放进真实业务环境里跑,翻车的方式却越来越让人看不懂。
问题不在于模型“不够聪明”,而在于我们衡量“好不好”的方式出了偏差。只看成功率,会掩盖能力真相。RAG 系统也一样,单靠一个总分根本判断不了能不能上线。真正缺的不是又一个“跑分工具”,而是一个把接口连通、AI 裁判、数据集设计、功能与非功能评测、定时回归串成完整闭环的工程化测评平台。
这正是 AIES 要解决的问题。
🔴 AIES 长什么样子
AIES(智能体测评平台)的核心设计可以用一句话概括:先连通,再评测;先诊断,再跑分。
平台把使用路径切成了九个前后依赖的步骤: 快速开始 → AI 接入 → 渠道配置 → 新建智能体 → 接口连通 → 知识库配置 → 功能测试 → 非功能测试 → 定时任务。
其中AI 接入和接口连通是两道硬门槛——没有配置用于裁判和出题的 LLM,没有把被测智能体的 HTTP/SSE 接口调通,后面的数据集生成、裁判打分、知识库入库全部无法执行。
工作台首页把“智能体测试”“AI 实验室”“全局系统设置”三个入口并列。AI 实验室下的 LLM 模型管理支持按厂商自动填充 Base URL;接口配置页则提供 OpenAI 兼容、FastGPT、Dify、Coze 扣子等预设模板,也支持完全自定义 HTTP。
一句更直白的描述:它不是给模型“打分”的排行榜,而是给智能体“做体检”的工作台。
🔴 一个例子:AIES 到底能测出什么
假设你手上有一个知识库问答智能体,接入了企业内部的规章制度文档,现在要回答一个很实际的问题:**它能不能上线?**
传统做法是人工问几十个问题,凭感觉判断“还行”。AIES 的做法是把这件事拆成可复现的工程流程。
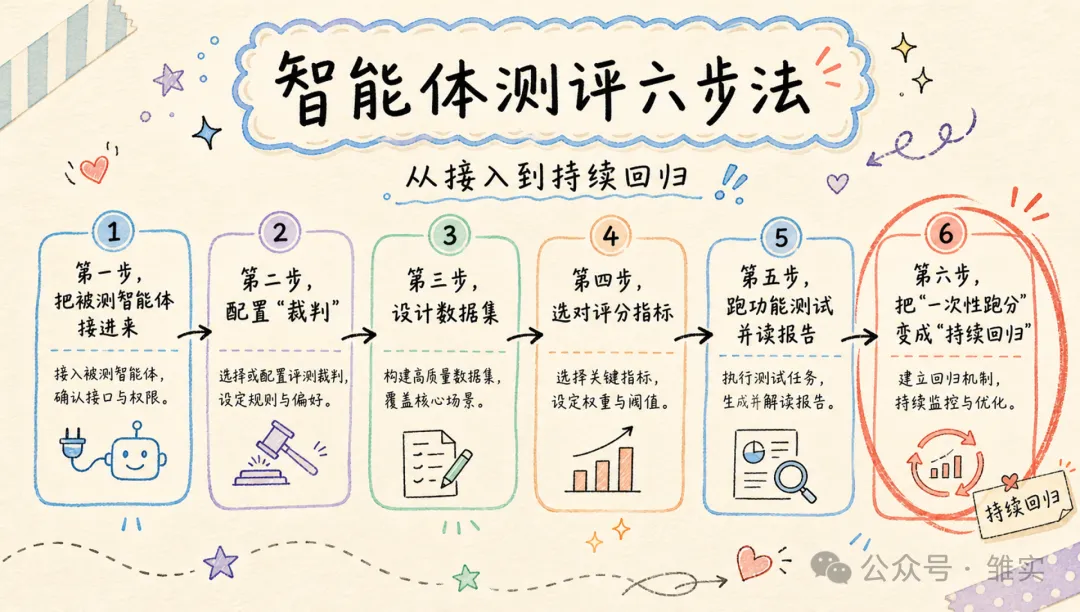
第一步,把被测智能体接进来。在接口配置中选择“OpenAI 兼容”预设,填入完整 URL、鉴权 Token,请求模板里保留 {{input}} 占位符,输出 JSONPath 设为 $.choices[0].message.content。点击“连通性测试”后,平台会显示 Total 端到端耗时、TTFT 首 Token 时间、TPOT 每 Token 耗时,以及“提取出的回答”是否确实抽到了可读字符串。
第二步,配置“裁判”。在 AI 实验室中选择一个已启用的 LLM,设为「对话生成」默认模型。这个模型不负责被测,负责当裁判——对被测智能体的回答做打分。平台不锁定单一裁判厂商,DeepSeek、Qwen、GPT、Ollama 本地模型都可以。
第三步,设计数据集。功能测试数据集支持三种方式组合使用:手工逐条新增、导入 JSONL/CSV/Excel 后做字段映射、或者让 AI 基于已入库的知识库材料生成候选再人工审核采纳。未采纳的候选不会污染评测集。
第四步,选对评分指标。这是 AIES 与“只看成功率”的工具最关键的区别。通用智能体默认看正确性和完整性;知识库问答默认使用 RAG 四元组:检索相关性、忠实度、答案相关性、上下文精确度。忠实度衡量回答是否可追溯到检索到的上下文——在合规、客服、内部制度等场景中,这比“答对了没有”更能反映真实风险。
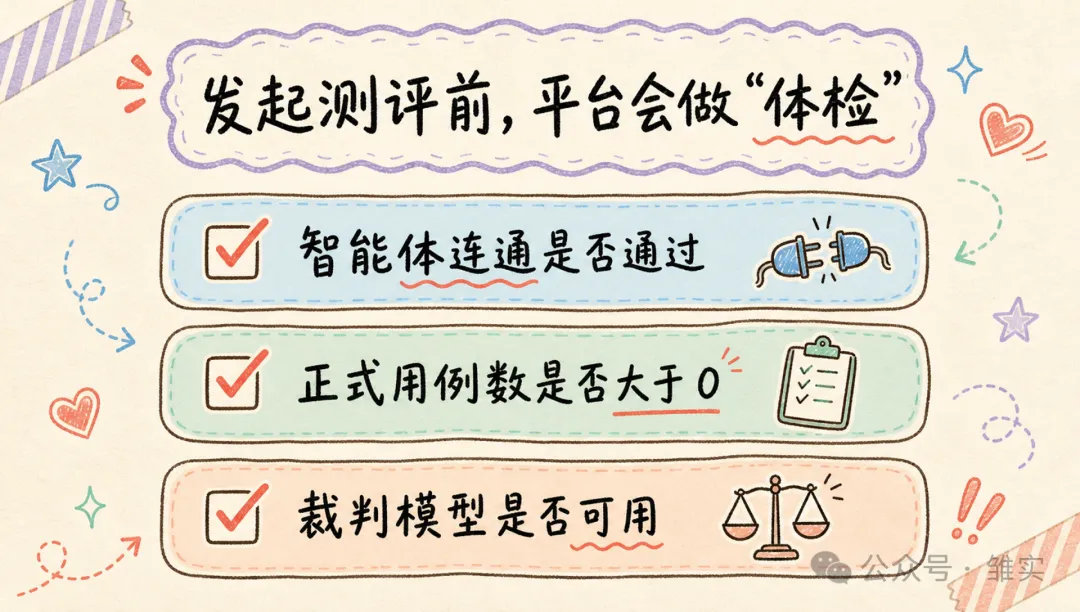
第五步,跑功能测试并读报告。发起测评前,平台会做“体检”:智能体连通是否通过、正式用例数是否大于 0、裁判模型是否可用。执行完成后,报告不只有一个通过率——它同时展示平均分、各指标均值、平均延迟,明细中可以筛选、展开看输入、实际回答、期望回答和裁判评语。如果只看通过率,一个靠宽松用例“顶”上去的高分和一个真正稳定的智能体看起来一模一样;指标拆开之后,“结果与能力背离”就藏不住了。
第六步,把“一次性跑分”变成“持续回归”。在定时任务中配置调度周期,选择数据集和评测维度,打开通知,绑定企业微信/钉钉/飞书 Webhook 或邮件收件人。此后每次版本迭代、模型切换,平台会自动跑一轮回归,并在通过率低于阈值或执行失败时推送告警。
🔴 和其他大模型、智能体的联动
AIES 的定位是测评层,而不是又一个“生成层”。这意味着它天然要和外部模型、外部智能体、外部知识库打交道。
• 模型侧:它不要求被测智能体和裁判模型来自同一家。被测智能体可以是 OpenAI 兼容接口、Dify 应用、Coze 扣子 Bot、FastGPT 工作流,也可以是自研的 SSE 流式接口。平台在接口配置中专门提示:**接口地址要填 API 地址,不要填商店页、分享页或文档站首页**——这是实际联调中最常见的“连通失败”原因之一。 • 知识库侧:支持上传多格式文档,走“待入库 → 排队中 → 处理中 → 已入库”的异步流程。它也提供**外部接入**能力:如果企业已有自己的检索 API,填入 URL 和请求头即可接入。AIES 做的是评测编排,不替代企业已有的 RAG 基础设施。 • 渠道侧:通知分两层:全局 SMTP 负责平台统一发信,智能体工作区里的“通知对象”决定具体发给谁。两层都配通,定时回归的结果才能真正送达人,而不是停留在页面上等人来看。
🔴 你可能会问的几个问题
Q1:接口连通测试失败,但 Postman 明明能通?重点检查三处:请求模板是否包含 {{input}} 占位符;JSON 是否合法;输出 JSONPath 是否能从真实响应中抽到字符串而不是整段 JSON 原文。抽不到可读回答,测试不会判定通过。
Q2:测评一直排队或不跑?先确认 Celery Worker 是否在运行。测评、AI 生成数据集、文档入库、定时任务都依赖异步任务队列。Linux 下可以用 docker compose --env-file .env.docker logs -f celery-worker 排查。
Q3:收不到邮件通知?按顺序检查:全局 SMTP 是否配置并测试通过;智能体通知对象是否已启用且测试成功;收件人是否用了英文逗号分隔;是否被垃圾箱拦截。失败可重发,但对象已删除则不可重发。
Q4:裁判不可用或 AI 生成数据集失败?去 AI 实验室检查 LLM 是否连通、是否设为「对话生成」默认、Key 和额度是否有效。知识库问答场景下,AI 生成数据集要求智能体已关联知识库或粘贴素材——空材料硬生成不会被允许。
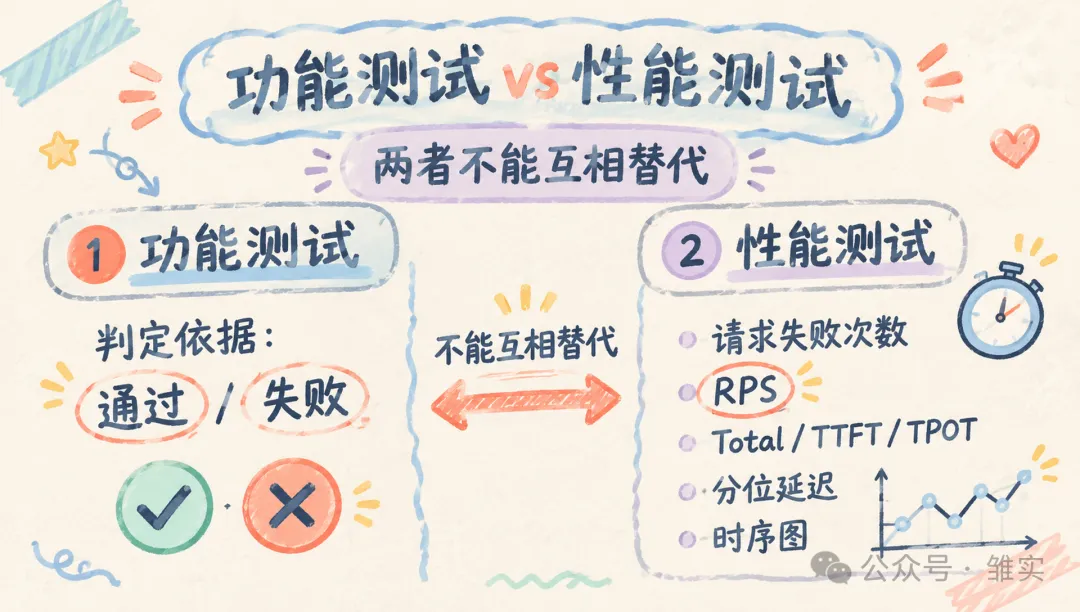
Q5:性能测试里,“请求失败”和“通过率”是一回事吗?不是。性能维度看的是 Locust 风格统计下的请求失败次数、RPS、Total/TTFT/TPOT、分位延迟和时序图,不是功能用例的通过/失败。并发用户数、启动速率、压测时长在参数中单独配置。
Q6:AIES 和 Promptfoo、Ragas、LangSmith 是什么关系?Ragas 在 RAG 指标计算上很专精,但范围窄;LangSmith 适合已经在 LangChain 生态中的团队;Promptfoo 适合 CI 集成和红队测试。AIES 的差异在于把接口连通、裁判配置、数据集设计、功能与非功能评测、通知和定时回归放在同一个工程闭环里,面向的是“我要持续测这个智能体能不能上线”。
🔴 AIES功能演示
🔴 最后
评测智能体,本质上是在回答一个比“跑多少分”更难的问题:它在什么条件下可靠,在什么条件下会塌。
AIES 不会替你决定用哪个模型,也不会替你写业务规则。它做的是把这些判断变成可复现的数据集、可解释的指标、可追踪的报告和可持续的回归。
如果你正在测 RAG、测 Agent、测 Dify 或 Coze 上的工作流,或者只是想知道手上的智能体离“能上线”还差多远——
👇 关注公众号,后台留言「666」,免费获取 AIES 体验账号。
先跑通连通性测试,再谈高分。让我们把时间留给更有价值的业务思考,而不是无休止的拼装工具。