ARTICLE · 1337916
WorkBuddy PDF 抽字段实操教程:20 份文件,我踩 5 个坑换 3 列
抽得出
更要核得回
20 份 PDF、5 个坑、三列留痕。从一堆扫描件到一张能筛的表。
CONTENTS · 这篇讲什么
00 这次做的是什么01 先把 20 份分堆02 拖进去之前,先把字段定死03 第一轮只跑 3 份04 它填不出来的空05 加三列,把「敢不敢用」写06 用三个数验一遍07 五个坑,每一个都不报错 最后一整个文件夹的合同 PDF,一共 20 份,来自不同对方,格式各写各的〔待补:博主真实经历——这批文件是什么合同、一共多少页〕。
我要的东西很具体:一张 Excel,一行一份文件,四列数据——签约方、合同金额、签订日期、付款方式。
再加三列留痕:来源页、原文摘句、状态。
按老办法,这活得这么干:打开一份,Ctrl+F 搜「金额」,复制,切 Excel,粘贴,下一份。
一份 2 分钟,20 份就是 40 分钟,还容易粘错行。
这次真正花在「动手」上的时间不到 10 分钟,剩下的全在核对〔待补:博主真实经历——这一轮实际用了多久、烧了多少积分〕。
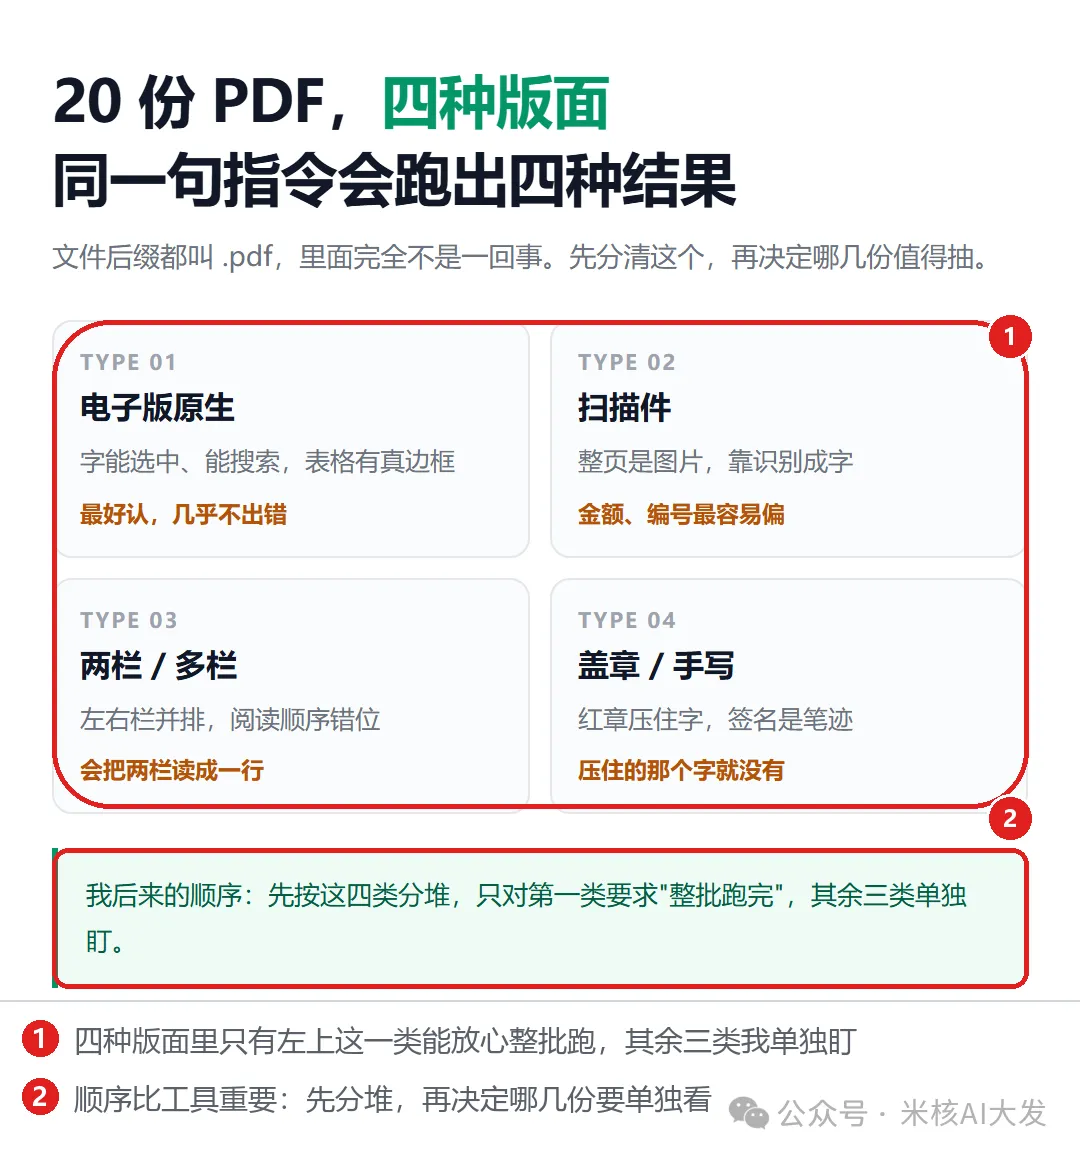
同样叫 PDF,四种版面四种命,先分清再动手
01
PART
先把 20 份分堆,别急着抽
SORT FIRST
文件后缀都叫 .pdf,里面完全不是一回事。
我用四个筐装:电子版原生、扫描件、两栏排版、盖章手写。
怎么一眼分?随便点开一份,鼠标能把字选中,就是原生;整页一块灰、选不中,就是扫描件。
这一步我给自己打 8 分。它几乎不花时间,但它决定了后面八成的错从哪儿来。
我的建议是:只有原生那一筐,才配得上「整批跑完」这四个字。
扫描件我单独放一批。两栏的和盖章的再各放一批。
听着麻烦,其实就三个文件夹。
我更愿意先花这五分钟分堆,也不愿意事后一行一行去查它错在哪。
这里我先做个减法:你要是只处理原生电子版,第 04 坑、第 03 坑可以直接跳过,剩下的部分照抄。
扫描件不是一页文件,它是一张照片。你让它从照片里抄,就跟你拿手机拍菜单再念给我听一样——光线、角度、字叠字,全是变量。
02
PART
拖进去之前,先把字段定死
FOUR-PART BRIEF
进 WorkBuddy,左下角选一个工作空间,把放 PDF 的那个文件夹指过去。
然后把文件拖进输入框,松手就行。
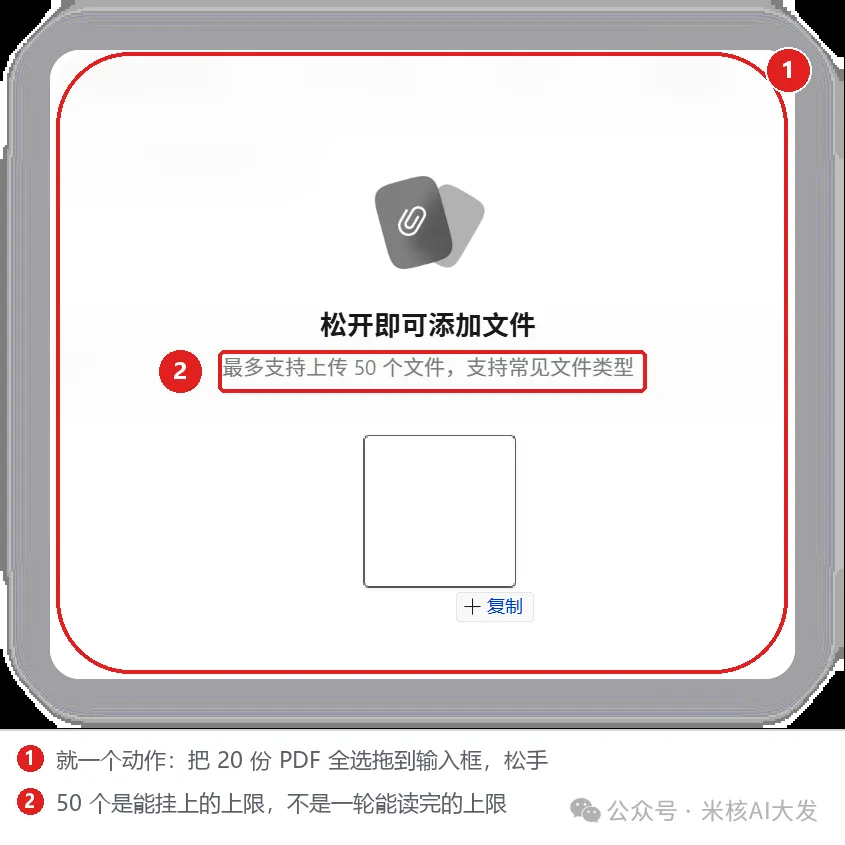
拖拽上传就一个动作,但那个 50 不是“一轮能读完”的意思
这里有两个数得说清楚。
第一,界面写着「最多支持上传 50 个文件」。20 份当然够。
但这个 50 是「挂得上」的上限,不是「一轮读完」的上限——这两个数在很多人脑子里是同一个,坑就从这儿开始。
第二,支持的格式比你以为的多。
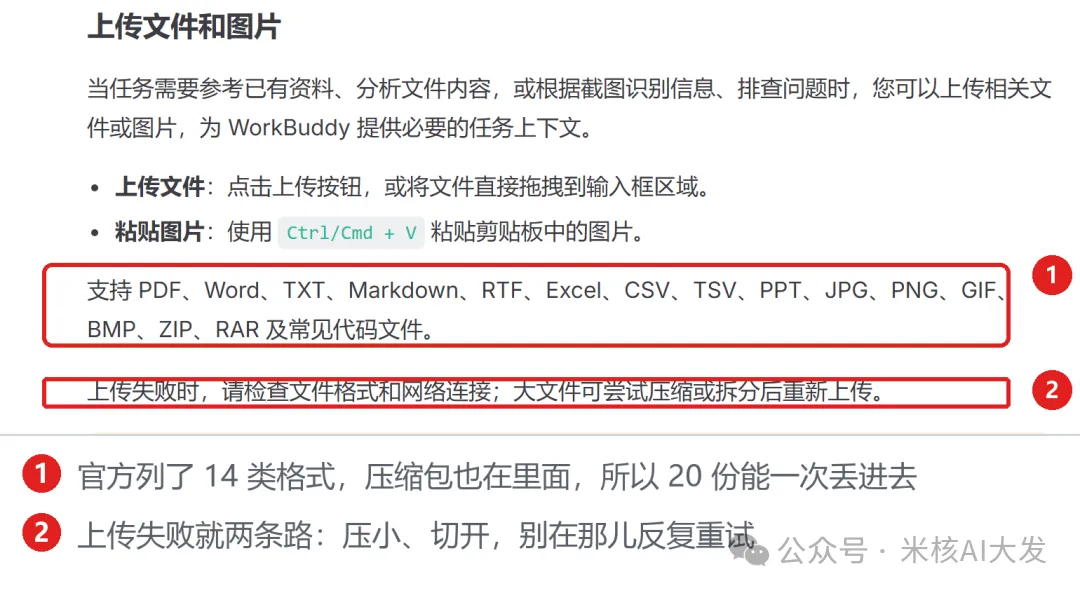
官方这份清单里,压缩包也在列,等于省了一步解压
PDF、Word、Excel、CSV、PPT、TXT、Markdown、图片、ZIP、RAR 都在里面。
所以 20 份没必要逐个拖——打个包直接丢,它自己会开。
好,现在说真正重要的一步:别写「帮我抽字段」,要写四段。
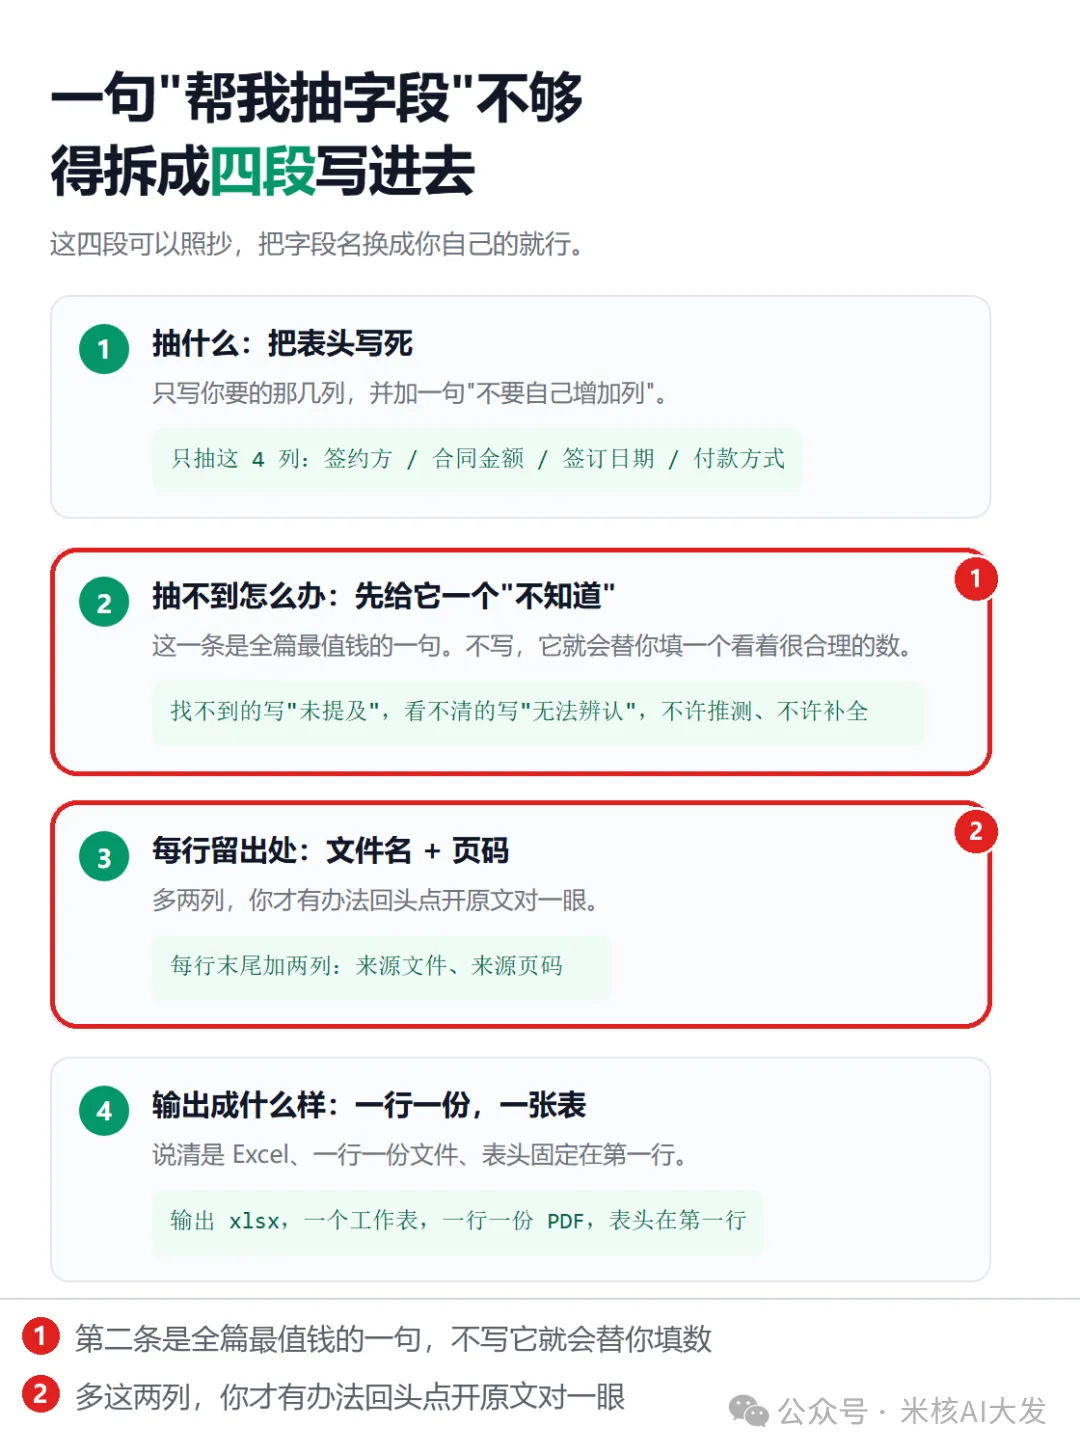
四段写进去,第三段是我加了两次才想起来的
我用的原话是这样:
这个文件夹里有 20 份合同 PDF。请逐份读取,抽成一张 Excel。只抽这 4 列,不要自己增加列:签约方、合同金额、签订日期、付款方式。另外加三列:来源文件、来源页码、原文摘句。找不到的写「未提及」,看不清的写「无法辨认」,不许推测、不许补全。输出 xlsx,一个工作表,一行一份 PDF,表头固定在第一行。列名用中文,金额只留数字不要单位和逗号。
五句话,第二句和第四句是命门。
第二句管住「别乱加列」,第四句管住「别乱编数」。
我的判断是:第四句写不写,决定了这张表是能用的还是只能看的。
大多数人卡在第三步——觉得「来源页」这种列多余,反正表都出来了。
不少余。这三列就像快递单上的单号:东西没丢的时候你从不看它,丢的那天它是唯一能查的东西。
03
PART
第一轮只跑 3 份,别跑 20 份
RUN THREE FIRST
官方文档在《实践一》里写得很直白:先小批量验证,确认效果再扩大范围。
我第一次看到这句的时候觉得是废话。真跑过一轮就懂了——20 份一起错,你连从哪儿查起都不知道。
所以第一轮我建议只丢 3 份,而且要故意挑不一样的:一份原生、一份扫描、一份两栏。
三种都过了,再放大。
顺带算笔积分账,这个很多人问。
体验版每月 500 积分,标准版 2000 基础加 2000 加赠,实得 4000;加量包 1000 积分 50 元,有效期 1 个月。
官方没有「每页多少积分」这种标价。它按模型单价和任务复杂度算,读 20 份长文档属于偏贵的那一档。
官方文档里那张示例截图,一次普通的文件任务显示「共消耗 18.92」。
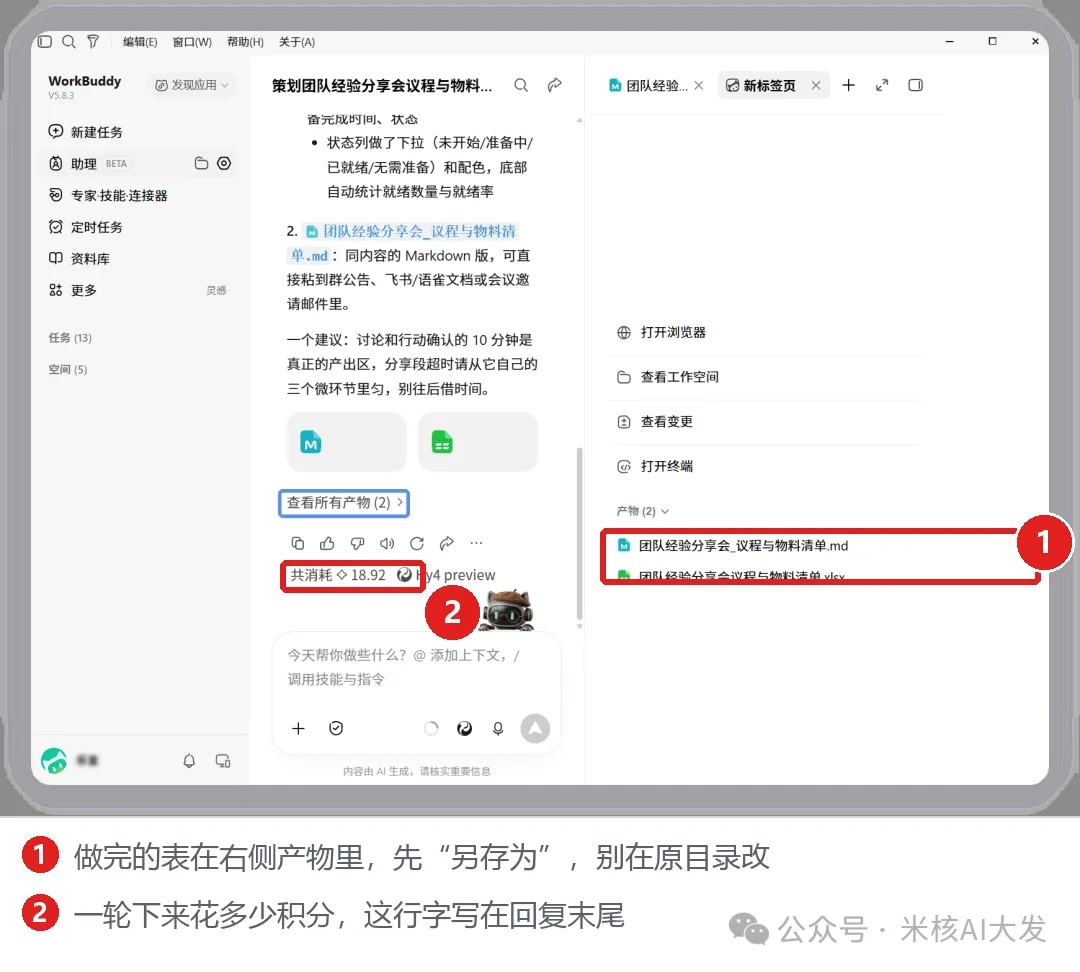
产物的位置和这轮的积分消耗,都在这一屏里
所以别指望我告诉你「20 份一共花多少」。我只能说:先跑 3 份,看一眼那个数,再乘。
这一步比任何估算都准。
04
PART
它填不出来的空,会自己补一个数
SAY I DON'T KNOW
这是这一篇里我最想说的一件事。
第一轮跑完,我抽查了几行。金额、日期、签约方,格式齐整,看着特别可信。
然后随手点开其中一份原文对了一眼——
那一栏原文写的是「详见附件二」,附件二压根不在这次的文件里〔待补:博主真实经历——第一次对账时发现它编的是哪一列、编成什么数〕。
表里却填着一个数。数字很顺,格式很对,全文里没有这一行。
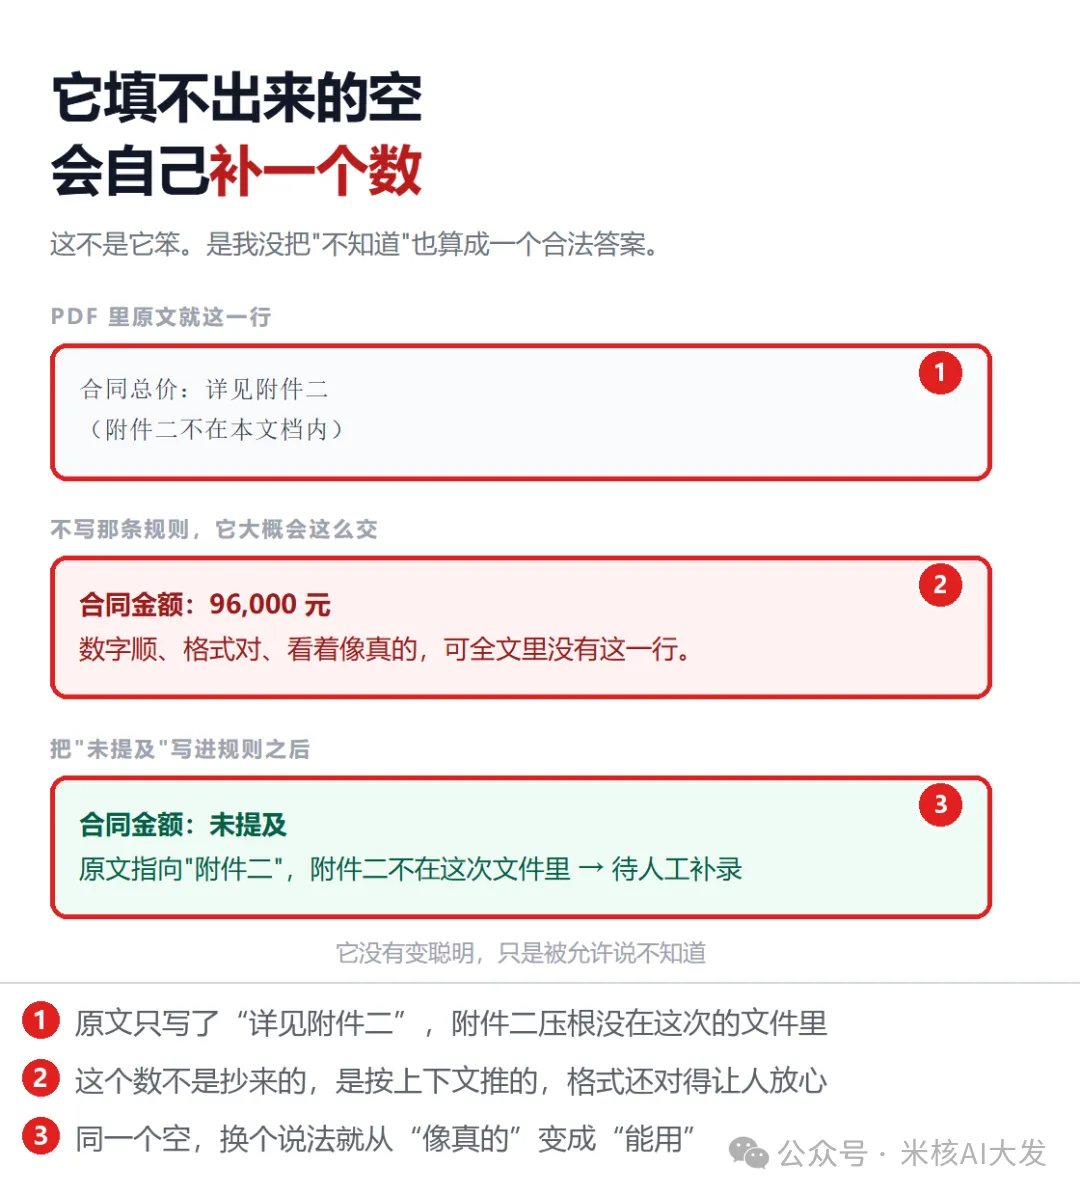
同一个空,写不写那句规则,出来是两个东西
我一开始以为这是它瞎编,是 bug。
后来才想明白:这不是它笨,是我没把「不知道」也算成一个合法答案。
在它的理解里,表里有一格空着就是没干完活。它宁可补一个看起来合理的,也不肯交一张有洞的表。
这个逻辑你得提前跟它说清楚:
刚才那版有几个数原文里没有。重做,只改一件事:找不到的写「未提及」,看不清的写「无法辨认」,并在原文摘句里写清楚为什么找不到。不要为了填满而推断。
改完那一版,同样的位置写的是「未提及」,摘句里写着「原文指向附件二,附件二未提供」。
这一版我能用。
所以这一条我给 9 分,扣 1 分是因为它不会主动提醒你哪几行是补的——你得自己写规则去逼它。
05
PART
加三列,把「敢不敢用」写进表里
THREE COLUMNS
表做出来了,6 列。
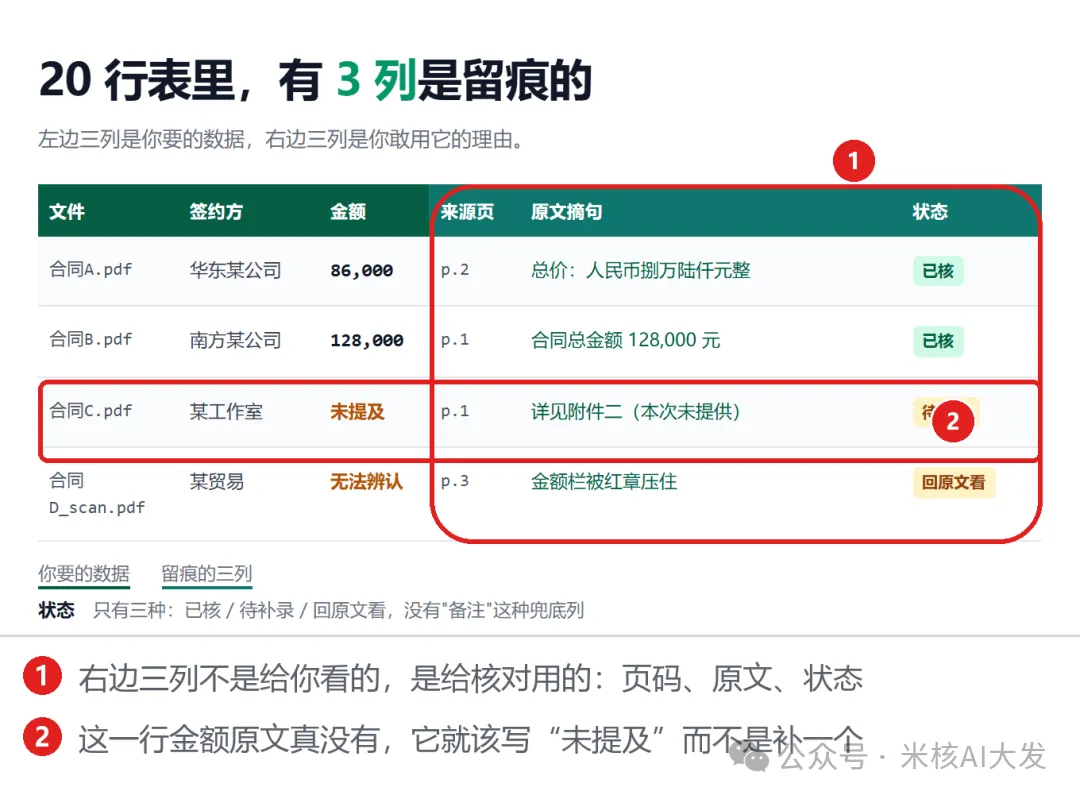
左边三列是数据,右边三列是证据
前三列你一眼就懂。后三列值得单独讲。
来源页:这一行出自第几页。有了它,核对变成「点一下」,而不是「从头翻一遍」。
原文摘句:把那一句原文抄下来。这一列最狠,因为它逼着结果和原文对得上——抄不出来,就说明没找到。
状态:只给三个值,已核、待补录、回原文看。
这里我做了个减法:不加「备注」列。
备注是个万能筐,什么都能往里扔。扔进去的东西等于没写,因为你永远不知道还剩几行要处理。
状态只有三个值,你才数得清自己还欠几行。
06
PART
用三个数验一遍
THREE NUMBERS
表做得再漂亮,也不代表它是对的。我只认三个数。
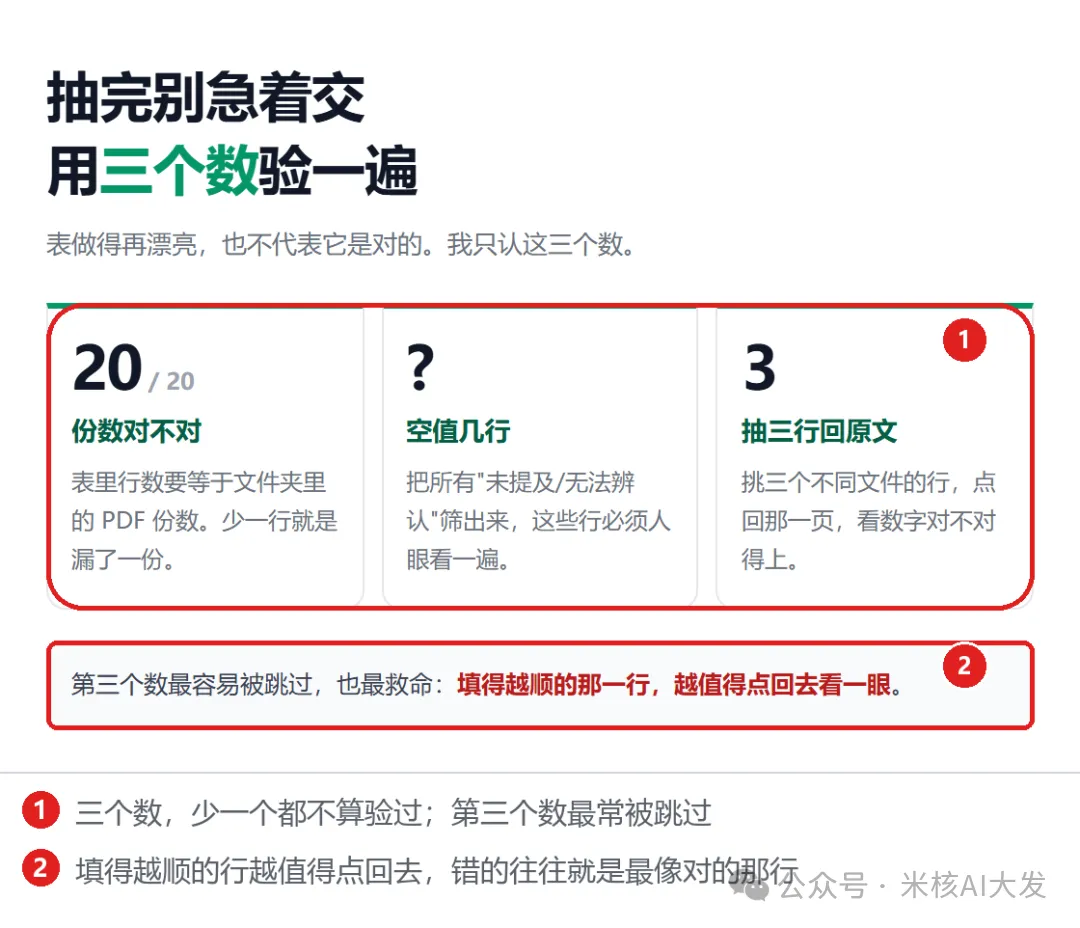
三个数,第三个最常被跳过
第一个,份数守恒。表里 20 行,文件夹里 20 份。少一行就是漏了一份,不是「有一份不重要」。
第二个,空值几行。把「未提及」和「无法辨认」全筛出来,这些行必须人眼看一遍——机器已经承认自己不知道了,剩下的是你的活。
第三个,抽三行回原文。从三个不同文件里各挑一行,点回那一页,看数字对不对得上。
第三个最容易被跳过,也最救命。
我的体感是:填得越顺的那一行,越值得点回去看一眼。 错的往往就是最像对的那一行。
07
PART
五个坑,每一个都不报错
PITFALLS · 5 TRAPS
它不弹红字。它只会安安静静交给你一张错的表。
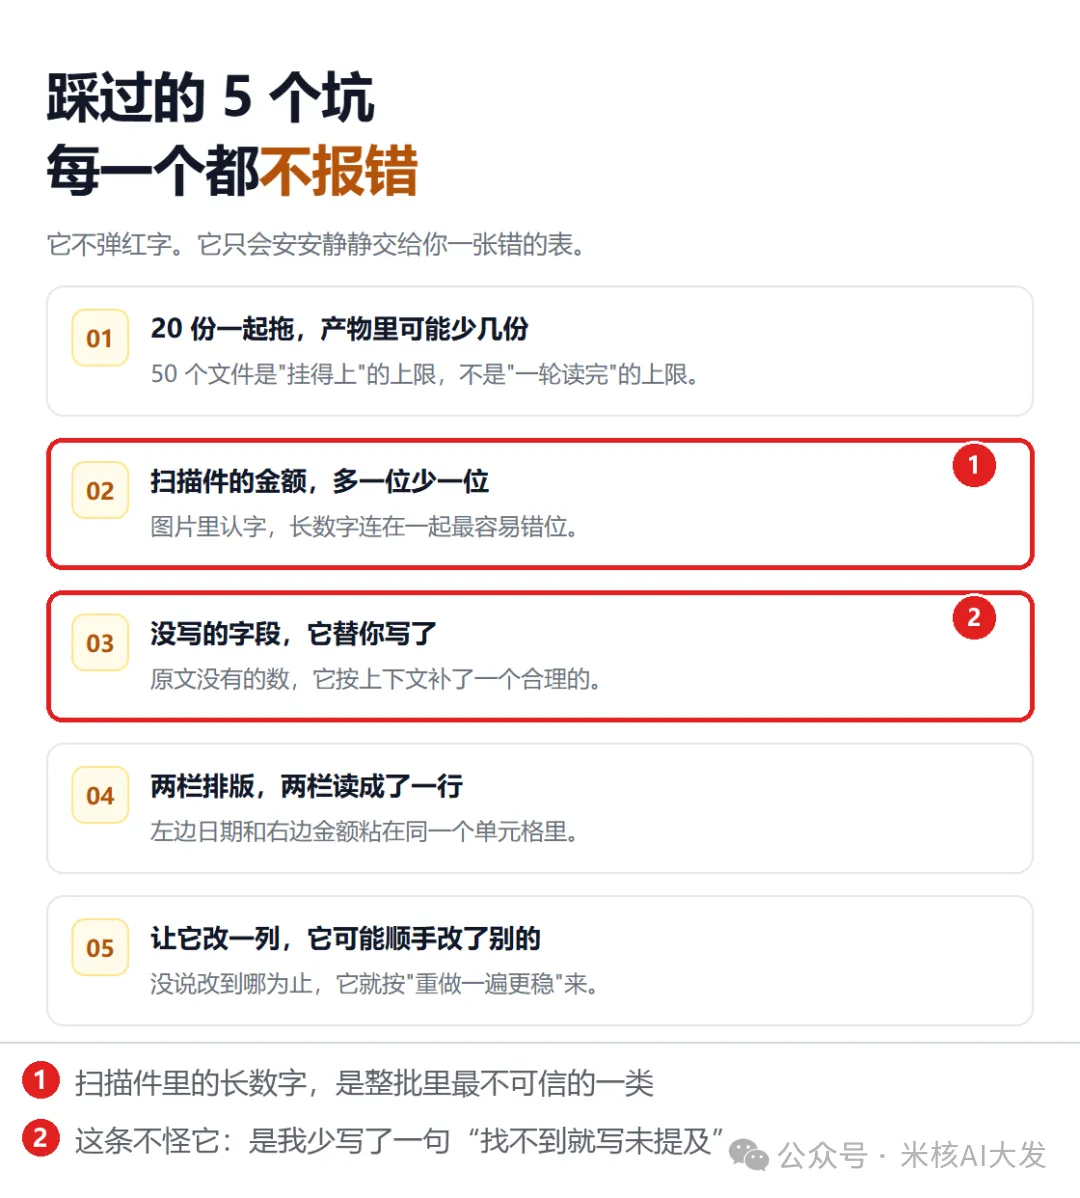
五个坑的共同点:全都不报错
!坑一:20 份一起拖,产物里可能少几份。
现象:拖进去 20 个,产物里数出来不到 20 个文件卡片,它也不说少了谁。
真实原因:50 个是「能挂上」的上限,不是「一轮读完」的上限。文件多、页数多,它会分批走,中途漏了的不会回头补。
怎么绕:一批 10 份,跑完先数份数,够了再下一批。
!坑二:扫描件的金额,多一位少一位。
现象:明明是 8 万,表里写 80 万,或者中间少个 0。
真实原因:扫描件是图片,认字靠猜。长数字连在一起、小数点又小,最容易错位。
怎么绕:扫描件单独一批,金额列必须人眼过;或者让它先只输出这一页的原文,你自己看着抽。
!坑三:没写的字段,它替你写了。
现象:某一格的数字你翻遍原文找不到。
真实原因:默认「补全」是它的习惯,不是故障。表里有空格,它会觉得活没干完。
怎么绕:指令里写死「找不到写未提及,不许推测」,跑完再筛一遍空值。
!坑四:两栏排版,两栏读成了一行。
现象:日期那一列里出现了「2026-03-12 86,000」这种东西。
真实原因:两栏的阅读顺序靠猜坐标,它按横向一行读下来,左右两栏就粘住了。
怎么绕:这类文件单独跑,或者先让它把该页文字按栏位顺序输出,再抽。
!坑五:让它改一列,它可能顺手改了别的。
现象:你说「金额去掉逗号」,回来发现日期格式也变了、顺序也重排了。
真实原因:你没说改到哪为止,它就按「整表重做一遍更稳」来办。
怎么绕:补一句「只改金额这一列,其余行列原样保留,不要重排、不要改格式」。
///
PART
最后
LAST · 写在最后
这篇不写怎么把这些表做成图表,那是另一个旋钮,讲混了谁都记不住。
说句劝告的话。
如果你一年也就处理两三份 PDF,这事你根本不用开 WorkBuddy——打开文件、Ctrl+F、复制粘贴,十分钟的事,比定字段快。
它值得用的位置是:文件多到你已经不想打开第一个的时候。
20 份以上,或者这件事每个月都要来一次,那这套流程才回本。
如果你手上的全是手写单据、模糊照片、盖章压字的扫描件,我也劝你先别上——那类文件它认不准,你核对的时间比手工抄还长。
最后一句判断:AI 抽字段这件事,它的「不知道」比它的「知道」值钱。
一张敢写「未提及」的表,你能直接用;一张每格都填满的表,你得从头核一遍——那还不如自己抄。
下一篇写文件整理:把下载文件夹按类型和日期归档,附一个能反悔的回滚办法。
你手上那批 PDF,最难缠的是扫描件还是两栏排版?回两个字就行:扫描、两栏。
一个人研究 AI 难免孤单,如果你想找到志同道合的伙伴,一起交流研讨 WorkBuddy,关注我回复蓝皮书,我拉你!全套 WorkBuddy 实战资料已经备好,分享给同频的你。
资料 · 顺手整理
这些是我攒下来的,你要就拿去
下面三张是清单原样,没修过图,文件名和大小都看得见。
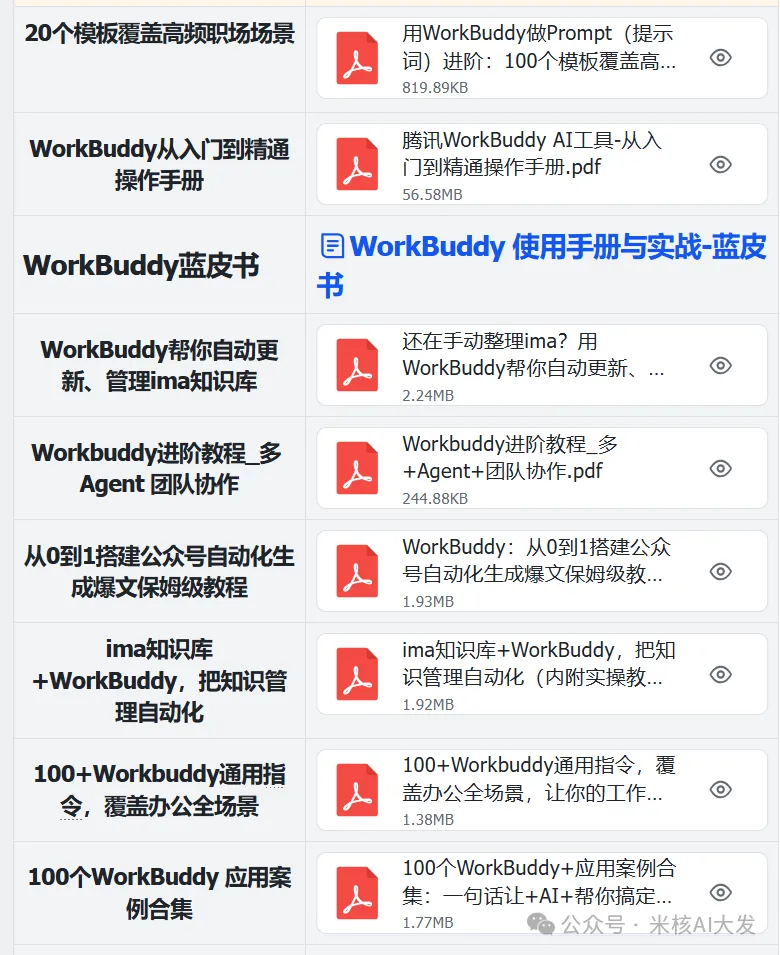
二十来份别挨个看,先开带「手册」的那两份,其余按需翻
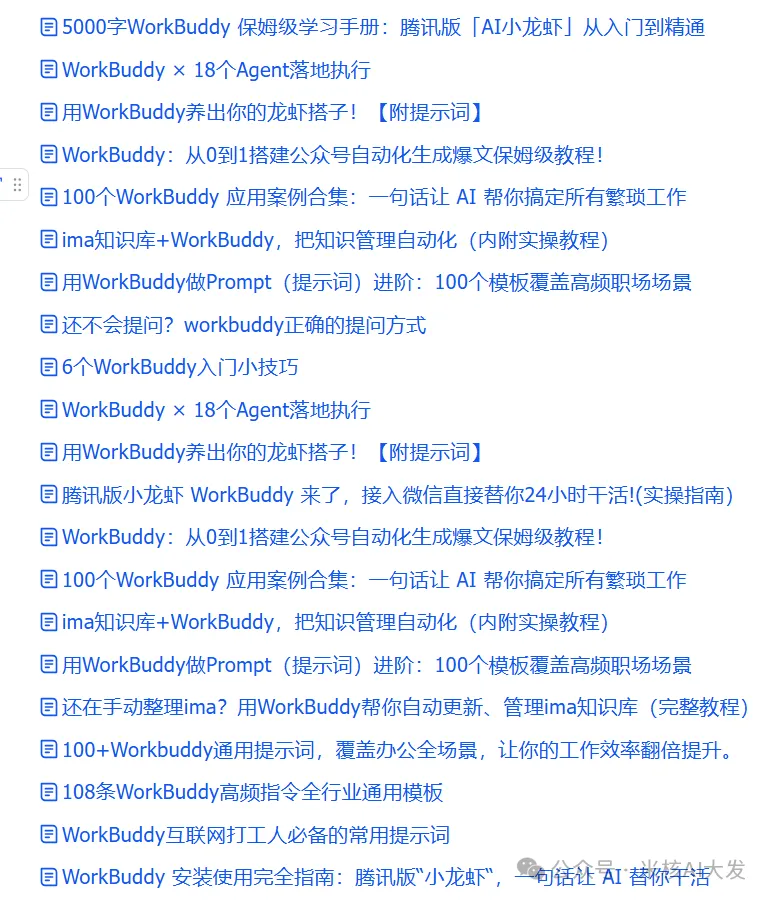
带数字的标题基本是能直接抄的模板,改几个词就能用
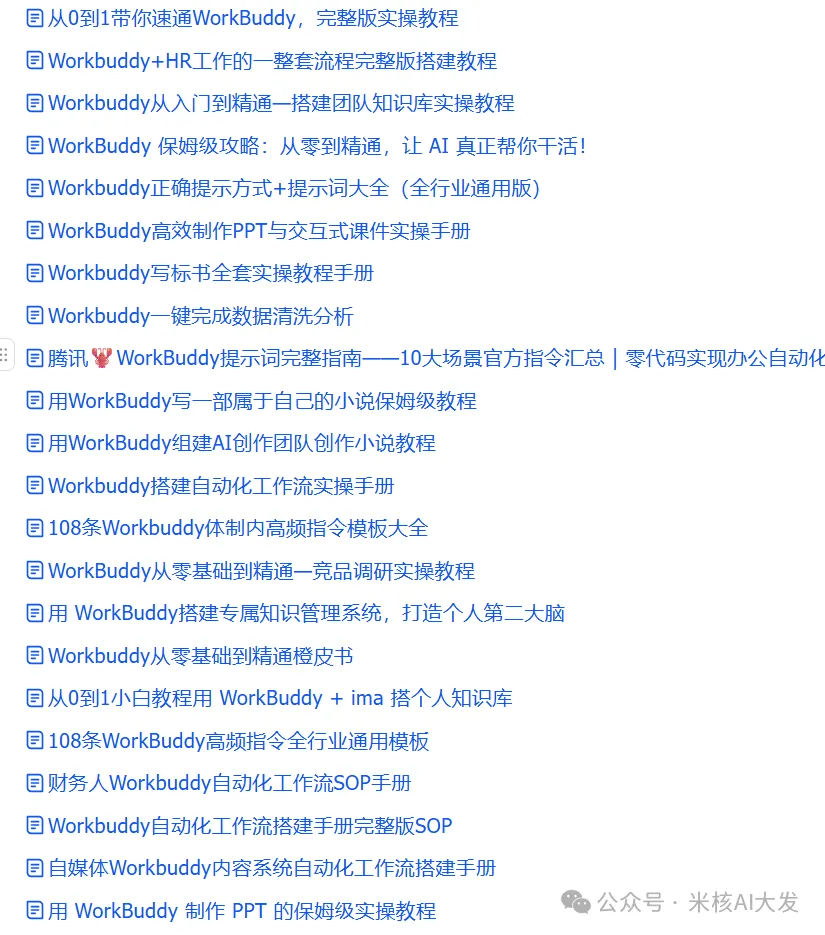
翻到底那几份是按岗位成套的,先找你自己那份
以上都在那份资料包里,按你能用上的挑,不用全下。