ARTICLE · 1360938
Meta 小团队八周做出一个 App:让 AI 自己验过再交活
Meta 小团队八周做出一个 App:让 AI 自己验过再交活
用 Cursor 或 Claude Code 写代码的人,多半有过这种经历:AI 很快交出一大段代码,看着像那么回事,一跑才发现不对,最后花在读和改上的时间,比自己写还多。
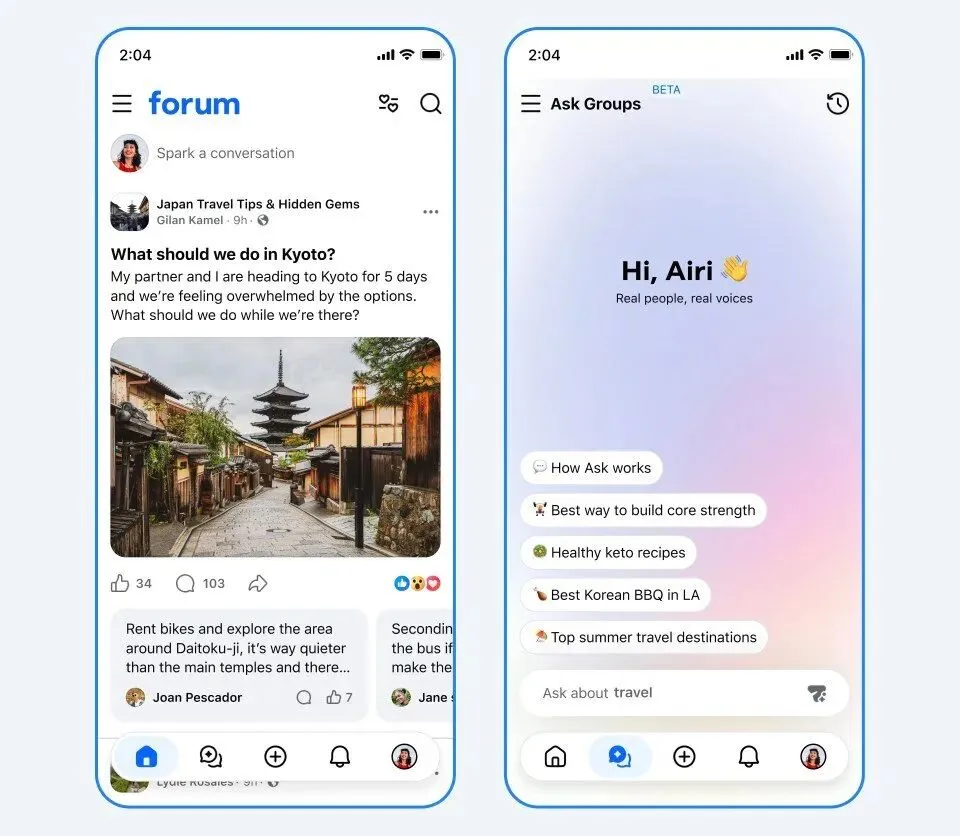
Meta 工程博客 10 月 15 日发了一篇文章,讲他们怎么做新 App「Forum」。一个小团队从零开始,八周做到了和 Facebook 小组核心功能持平。文章里没有什么神奇的提示词,大部分篇幅在讲一件很朴素的事:别让 AI 交没验过的活。
Forum 是什么
Forum 是 Meta 新出的独立 App,给想在 Facebook 小组里深入聊天的人用。原文的定位是一个「独立的小组 App」,由一个小团队从零搭起来。团队同时拿它做了一个实验:把 AI Agent 当成开发流程里的参与者,而不是「打字更快的工具」。
他们一开始就说清楚了怎么算成功:不看 AI 写了多少行代码,只看「经过验证、能上线」的改动,也就是能编译、测试能过、评审能通过的那些。
人从「在环里」挪到「在环上」
原文用了两个词:human-in-the-loop 和 human-on-the-loop,我分别翻成「人在环里」和「人在环上」。
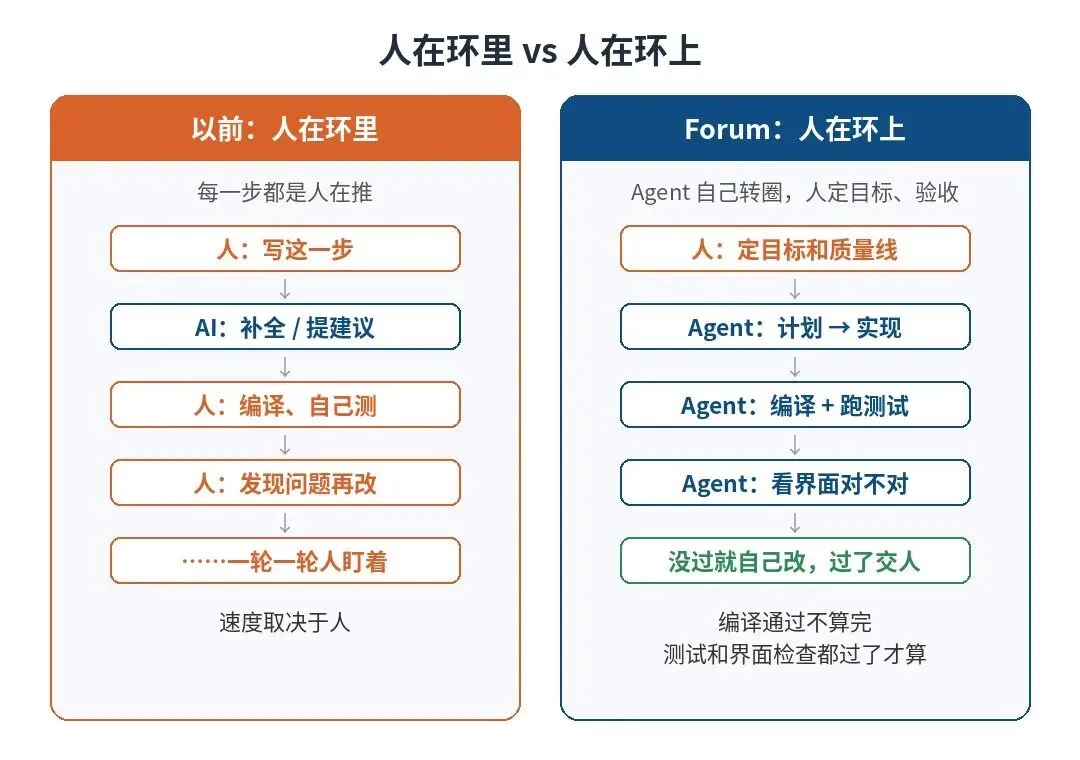
人在环里,就是现在大多数人用 AI 的方式。每一步都由人推着走,AI 在里面帮忙补全一个函数、建议一个修法、回答一个问题。整个过程的速度,取决于人有多快。
人在环上,是让 Agent 自己转圈:计划、实现、编译、测试、改错,再来一遍。人负责定目标、看着它跑、跑偏了拉一把,最后验收。人的工作从「一步步做」变成「对结果负责、守住质量线」。
原文也很坦白,这是他们正在往那儿走的方向,不是已经做到了:有些环节现在能自己跑,有些还是每一轮都要工程师在场。
编译通过不算完
这篇文章最值得记住的一句是:
Compiling isn't the finish line — a task is complete only once automated tests and visual checks have passed.
意思是编译通过不算完,自动化测试和界面检查都过了,任务才算完成。
为什么要这么较真?原文的解释很直白:没有验证,AI 写出来的东西就是「看起来像对的」,没人确认它真能用,最后还得工程师去读、去调,经常整段扔掉。验证不够,瓶颈并没有消失,只是从「写代码」挪到了「审一堆看着写完了、其实没写完的代码」。
所以他们把编译状态、单元测试、界面和设计稿是否一致,这几样「过 / 不过」的信号直接接进 Agent 的循环里。Agent 先自己检查,过了才交给人。交上来的 PR 带着测试计划和录下来的验证过程,工程师签字时有凭有据。原文说,这样生成的少了,扔掉的也少了。
他们还在总结表里说了一句挺扎心的话:没有一个自动的「做完了」的信号,你就不是在让 Agent 自己跑,而是「一个人在给生成器当保姆」。
给 Agent 工具,别给它描述
他们踩过的最大的坑,是 Agent 搞不清自己在 App 的哪个界面。让它改小组首页,它跑去改了首页信息流;要点某个按钮,它就去猜屏幕坐标。
解决办法不是把 App 的结构写成更长的说明文档,而是给它能自己查的工具:从模拟器里读出当前真实的界面层级,列出屏幕上实际有哪些元素,查到目标界面的路径,动手之前先查清楚。原文说,改错地方的情况大幅减少。
后来他们把这个思路用到了所有 Agent 接触系统的地方:能让它直接查状态,就别让它对着一段描述去推理。
让 Agent 当测试员
环境搭好以后,Agent 还能当测试员用。他们设计了几种模拟真人的「折腾」场景:疯狂滑动、随便逛小组、快速来回切页面、反复加载图片视频,每次出新版本都跑一遍,盯着崩溃、内存上涨、界面出错这些信号。
有一次就这么跑出了一个内存问题。Agent 找到了能复现的操作步骤,提出修法,又用同一套场景验证了修复,这些都发生在 App 上线之前。按原文的说法,修完以后内存占用和缺页次数大约减半。
上线后,用户提交的反馈也会先交给 Agent 排查可能的问题,它整理好分析,再交给工程师决定怎么处理。
好用的不是提示词,是上下文
原文有两处讲得很实在。
一处是说,收益最大的是改代码和工具,不是改提示词。Agent 会照着它读到的代码学套路,烂写法修一次,以后每次会话都跟着变好;不修,它就会在以后写的每段代码里抄这个捷径。所以他们尽量让代码结构简单直白,有些地方宁可从头重写,也不硬接复杂的老代码。
另一处是做线上问题排查的时候,有一类问题 Agent 一直查得不好。后来他们把给新同事入职第一天的那些东西,相关代码的位置、查询示例、设计文档,同样给了 Agent,这类问题的排查质量一下子就上去了。原文的说法是,跟带新人不同,这些只需要教一次,以后每次会话都从这里开始。
他们还有一条规矩:Agent 同一个错误犯了两次以上,就把纠正写成一条永久规则,全队共用。
他们自己总结的得与失
文章最后给了两张表,我把要点翻一下:
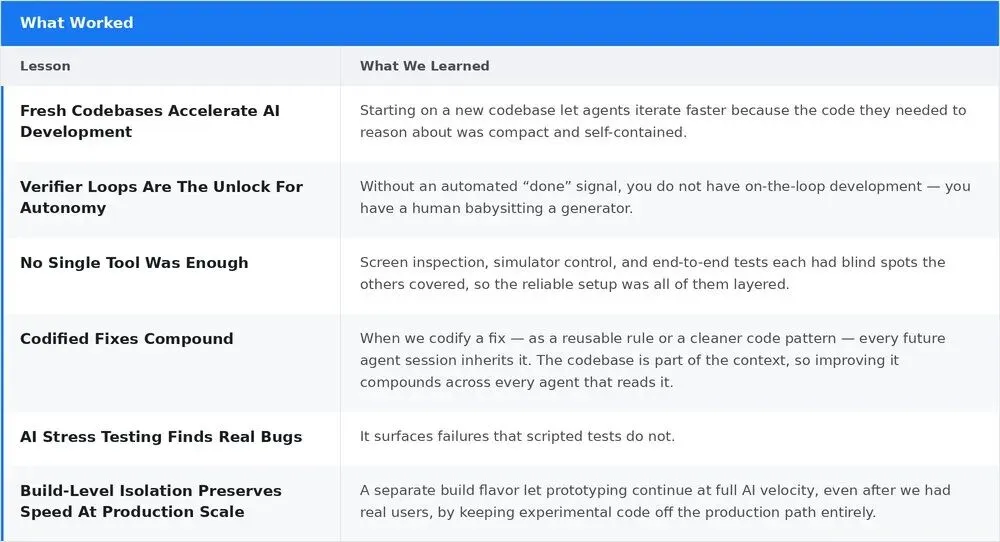
• 新代码库让 Agent 迭代得更快,因为要理解的代码少,而且自成一体。 • 有了验证循环,才谈得上让 Agent 自己跑。 • 没有哪个工具够用。看屏幕、控制模拟器、端到端测试各有盲区,叠在一起才靠得住。 • 修一次、写成规则或者更干净的写法,以后每次会话都受益。 • AI 压力测试能发现脚本测试发现不了的问题。 • 单独搞一个只给原型用的构建版本,让原型代码根本进不了正式版,有了真实用户以后也能放心快速试新东西。
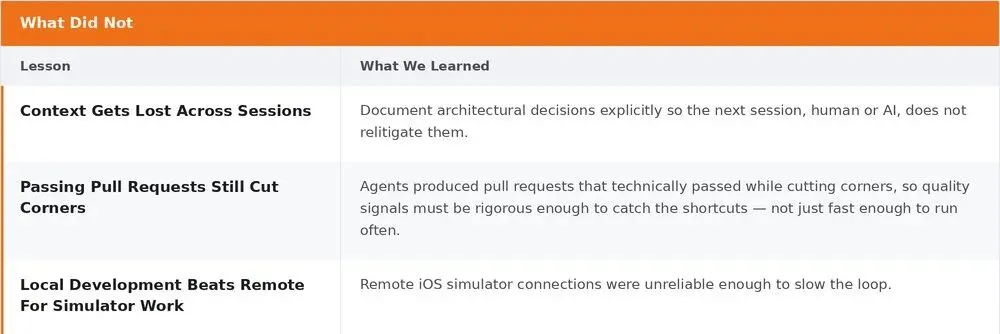
• 换个会话,之前的上下文就丢了。架构上的决定要明确写下来,免得下一个会话(不管是人还是 AI)又从头争一遍。 • 测试都通过的 PR 也会偷工减料。质量检查要严到能抓住这种捷径,光跑得快、跑得勤不够。 • 做模拟器相关的活,本地比远程好用,远程连 iOS 模拟器不稳定,拖慢了整个循环。
普通开发者能拿来怎么用
下面是我自己的看法,不是原文内容。
Meta 有自己的内部工具和整套基础设施,我们照搬不了。但这篇文章里的几条思路,个人用 Cursor 或 Claude Code 也能马上用上:
第一,给 AI 一个「做完了」的标准。别只说「帮我实现这个功能」,要说「实现后跑 npm test,全部通过再告诉我」。项目里有测试、有 lint,就写进 CLAUDE.md、AGENTS.md 或 Cursor 的规则文件,让它每次改完自己跑。没有测试的项目,可以先让 AI 把测试补上。
第二,同一个错它犯第二次,就写进规则文件。这跟 Meta 说的「两次以上就写成永久规则」是一个意思。比如「金额一律用某个工具函数」「别改 migrations/ 目录」。规则文件是越用越好的,不是一次写完就不管了。
第三,能让它自己看,就别光靠描述。做前端的,可以给它接上浏览器自动化之类的 MCP 工具,让它自己打开页面、截图看看改对了没有,比你用文字描述「按钮在右上角」靠谱得多。
第四,测试过了也要看一眼。Meta 自己都承认,测试能过的 PR 也会偷工减料。AI 有时为了让测试变绿,会把测试本身改松。评审时顺手看一下测试文件被改了什么,能省不少事。
链接
• 原文:How Meta Built Forum With AI-Native Engineering https://engineering.fb.com/2026/10/15/ml-applications/how-meta-built-forum-ai-native-engineering/(Meta 工程博客,2026 年 10 月 15 日)