ARTICLE · 1366991
同一个 Markdown,转出来的 PDF 为什么差这么多?
同一个 Markdown,转出来的 PDF 为什么差这么多?用 Markdown 写东西的人,大概都经历过这一刻: 源文件写得清清爽爽,一按转换,出来的 PDF 让你想把文件删了重来。 开头第一行是 title: 某某文档,第二行 author:,第三行 date:,还带着两条 --- 横线。待办清单原样显示成 [x] 完成某某。代码块一坨灰,分不清哪个是关键字。翻到第二页,右下角空白一片——没有页码,打印出来散一桌就再也拼不回去。 问题不在你写得好不好,在转换那一步用的是什么引擎。 旧的链路是这样的:Markdown 先转成一份 HTML,再交给办公软件套件去"另存为 PDF"。 这条路能跑通,但有两处天生吃亏: 第一,它不认识 Markdown 的写法。开头那段 --- 包起来的信息(叫 front matter),在 Markdown 里是元数据,本该被拿走做封面;它不认识,就当成正文原样印了出来。待办清单的 - [x] 在 Markdown 里是"已勾选",它也不认识,就照字面印成 [x]。 第二,它的排版能力受限于办公软件的样式子集。页边距、页码、分页控制这些"正式文档"该有的东西,它基本给不了。 所以你的源文件越规范,转出来的 PDF 反而越难看——因为那些规范写法它全看不懂。 一句话:把出 PDF 的那一步,换成了浏览器打印。 浏览器每天要渲染几亿个网页,它的排版引擎本来就为"把内容排好看"而生。现在链路变成:Markdown 先做一轮整理,再交给浏览器内核按 A4 纸打印成 PDF。 换完之后,三件以前做不到的事自然成立了: 开头那段元数据,现在会被拿走做封面。转换时先把 front matter 摘出来,标题放大居中、作者日期放小一号排在下面、再画一条渐变色分隔线。你打开 PDF 第一眼看到的是文档标题,不是 title: 这个单词。 待办清单变成了真正的勾选框。- [x] 显示成勾上的方框,- [ ] 显示成空方框。该勾的勾着,没做的空着,一眼能看出进度。 代码块有了语法高亮。关键字、字符串、注释各是一种颜色,不再是一片灰。 顺带把正式文档该有的东西都补上了:A4 尺寸、页脚"第 X 页 / 共 Y 页"、表格隔行浅色底、引用块左侧竖线、长链接自动换行不顶出页边。 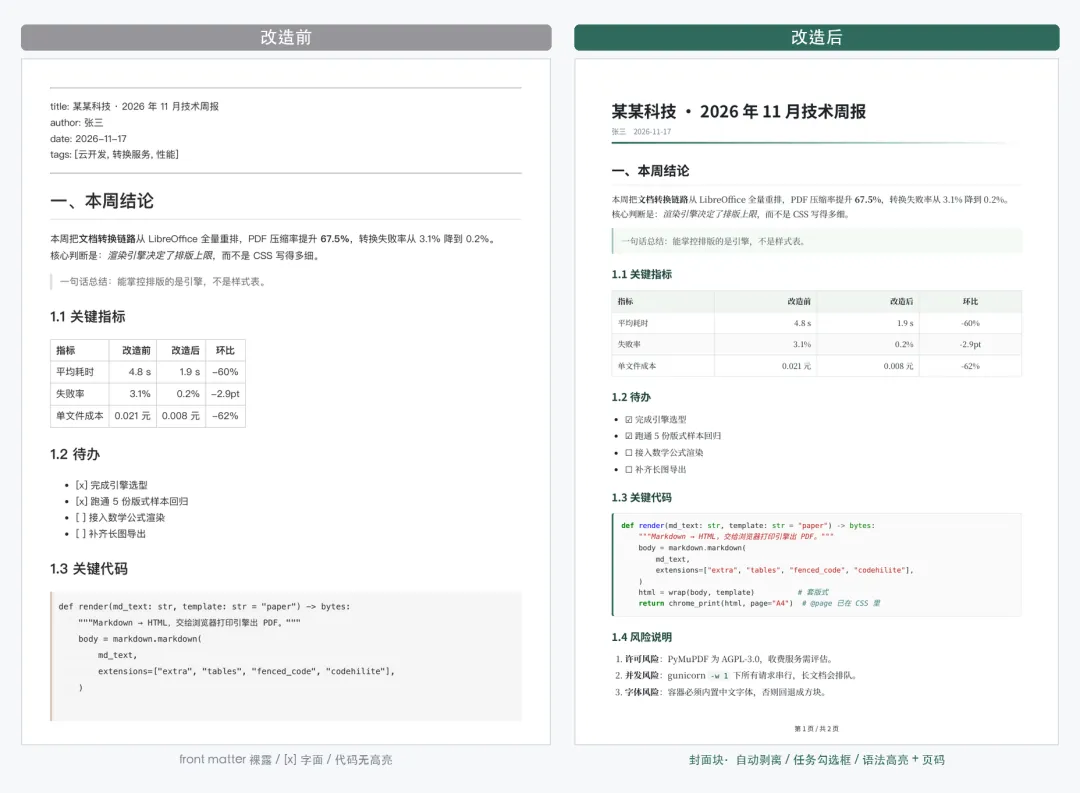
左边那页的顶部,四行 title:author:date:tags: 就那么裸露在正文里;右边同一份 Markdown,开头是干净的封面块。 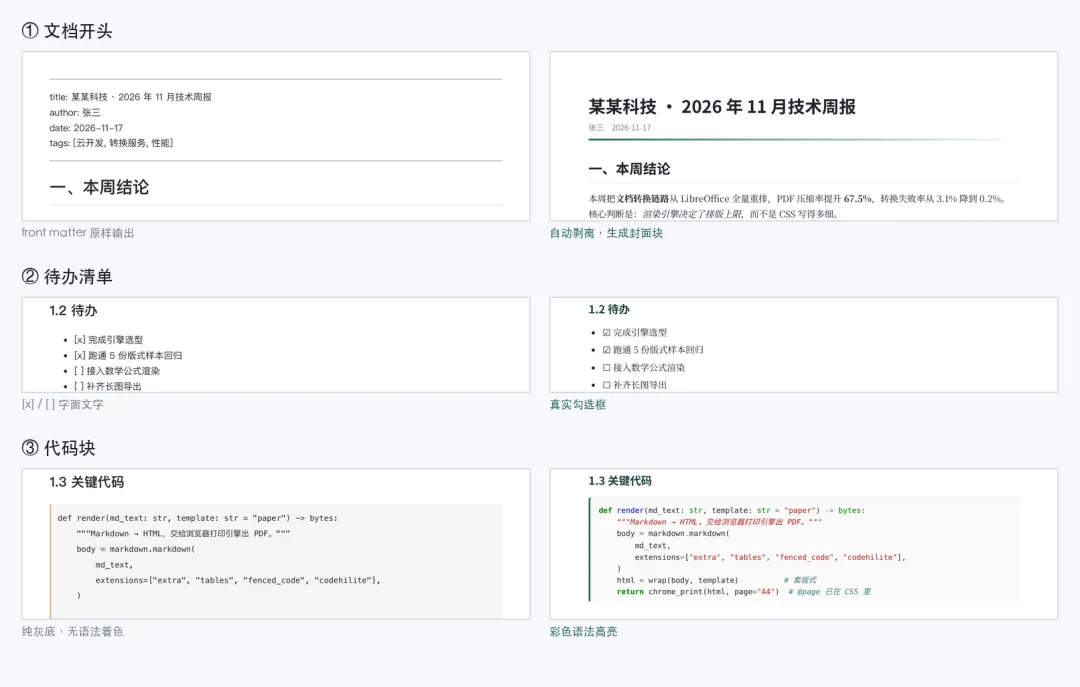
三处细节放到一起看更明显:第一处是开头,第二处是待办清单的 [x] 和勾选框,第三处是代码的纯灰和彩色。 这是一份真实生成的文档,三页,这里展示前两页。用同一套工具从 Markdown 转出来,没做任何后期处理。 (文档里的公司名、人名和数据都是演示用的虚构示例,不是真实业务数据。) 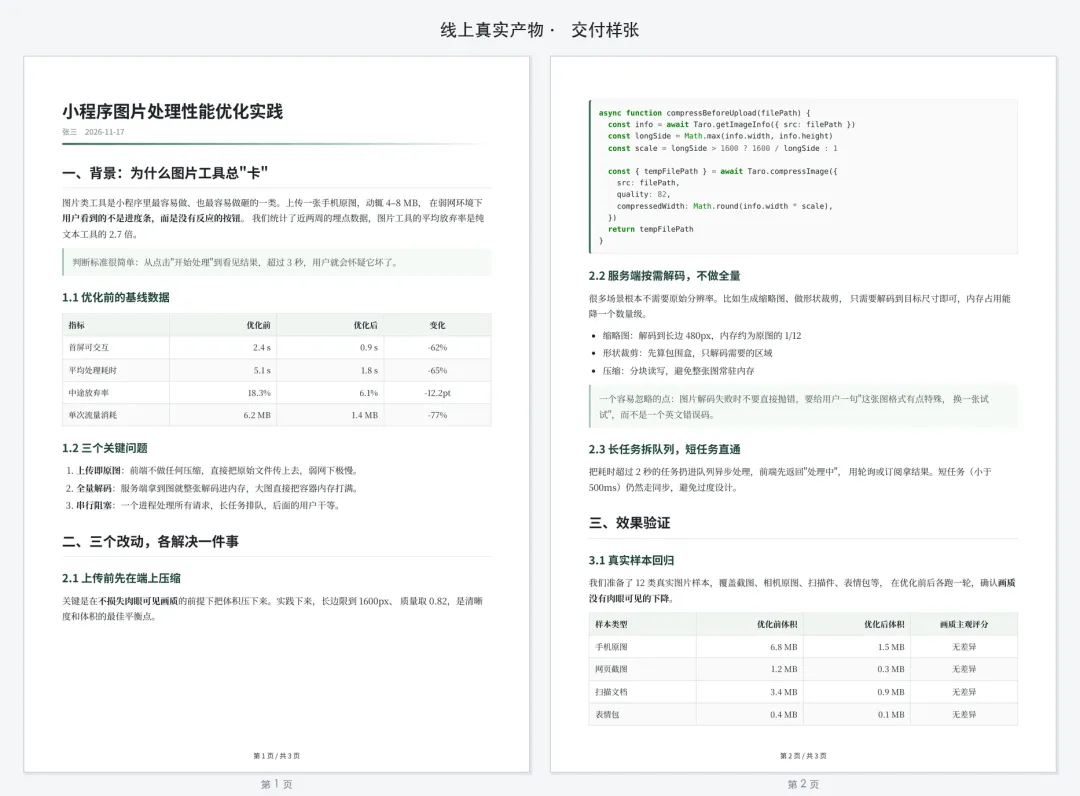
封面、标题层级、斑马纹表格、带高亮的代码块、引用块、页脚页码,都是转换时自动排的。 转换引擎换了之后,最怕的是"新引擎出问题,用户直接转不出来"。 所以加了一道保险:新引擎一旦出错,会自动退回旧链路继续转。也就是说,最坏的情况不是"转换失败",而是"这次样式没升级,但文件照样给你"。 另外还有一条硬上限:正文超过 200 万字会直接提示拆分。听起来很宽松,但这是防止超大文档把服务拖垮——对正常人来说,这个上限一辈子碰不到。 升级不是一次到位,这轮只做了最影响观感的那部分。下面这些还在路上: 转成长图(适合发朋友圈和公众号) 多套排版的模板可选 公式和图表的渲染 一份文档同时打包出 PDF、Word、图片三件套 等这些做完了,会再写一篇。 微信搜「底本工坊」小程序,找到「Markdown 转换」。 把正在写的那份 Markdown 丢进去,选 PDF,看看这次转出来的样子。 如果你手上有以前转出来的旧文件,不妨也放一起对比一下——差别应该在第一眼就能看出来。
以前的 PDF 为什么像记事本
这次换了什么
改造前后,直接看图
转出来的成品长什么样