ARTICLE · 1380003
关掉思考也拿 64.7%,这个编码插件生成量降到约四分之一
一个真实测试里,同一个软件修复任务被交给同一个基座模型跑了两遍。第一遍没挂插件,模型反复搜索、重跑代码片段,用满 100 步依旧没修好。第二遍挂上一个叫 Qwen3.8-27B-pi-adapted 的插件,它定位到出错的函数、改完、跑测试、补上最后一个没过的用例,用了 8 次工具调用。
这个插件 11 月 16 日建仓,模型卡在 11 月 18 日更新。它挂在基座模型 Qwen3.8-27B 上,本身不是完整模型,专门给名为 pi 的编码代理用,让模型去做软件工程和终端任务。官方给出的用法和常见直觉相反:用的时候把思考模式关掉。
关掉之后,官方报告的成绩是:在 SWE-bench Pro(hard 51)上拿到 64.7%,和基座模型开到最高推理强度(xhigh)时的 64.7% 打平。在 Terminal-Bench 2.1 上,它是 56.6%,基座开到最高推理强度时是 54.2%。同一批任务里,它每个任务写出来的内容只有后者的约四分之一。
关掉思考,分数没掉
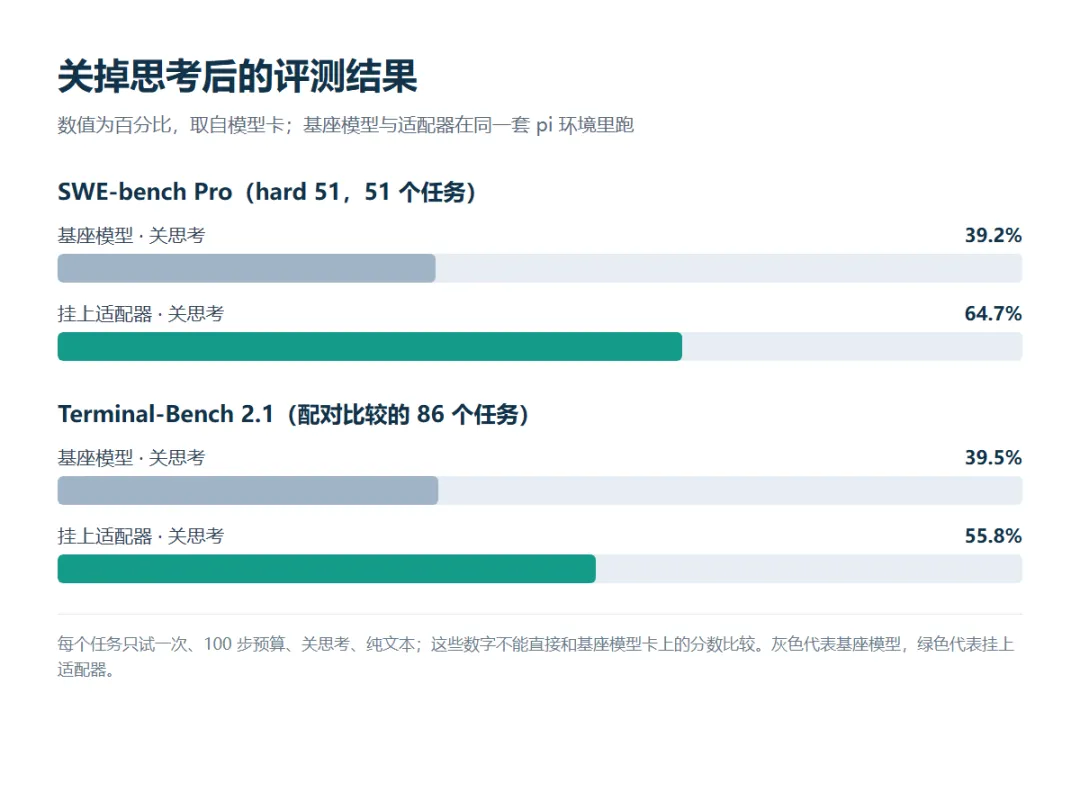
在 SWE-bench Pro(hard 51)上,把插件挂到基座模型上、关掉思考后,得分从 39.2% 升到 64.7%,多了 25.5 个百分点。51 个任务里,15 个从做错变成做对,2 个反过来。
Terminal-Bench 2.1 上做了配对比较:同一批 86 个任务,基座模型 39.5%,挂插件后 55.8%,多 16.3 个百分点,16 个由错变对、2 个由对变错。
插件开思考没有额外收益,官方因此建议全程关着。
省下的是每轮输出
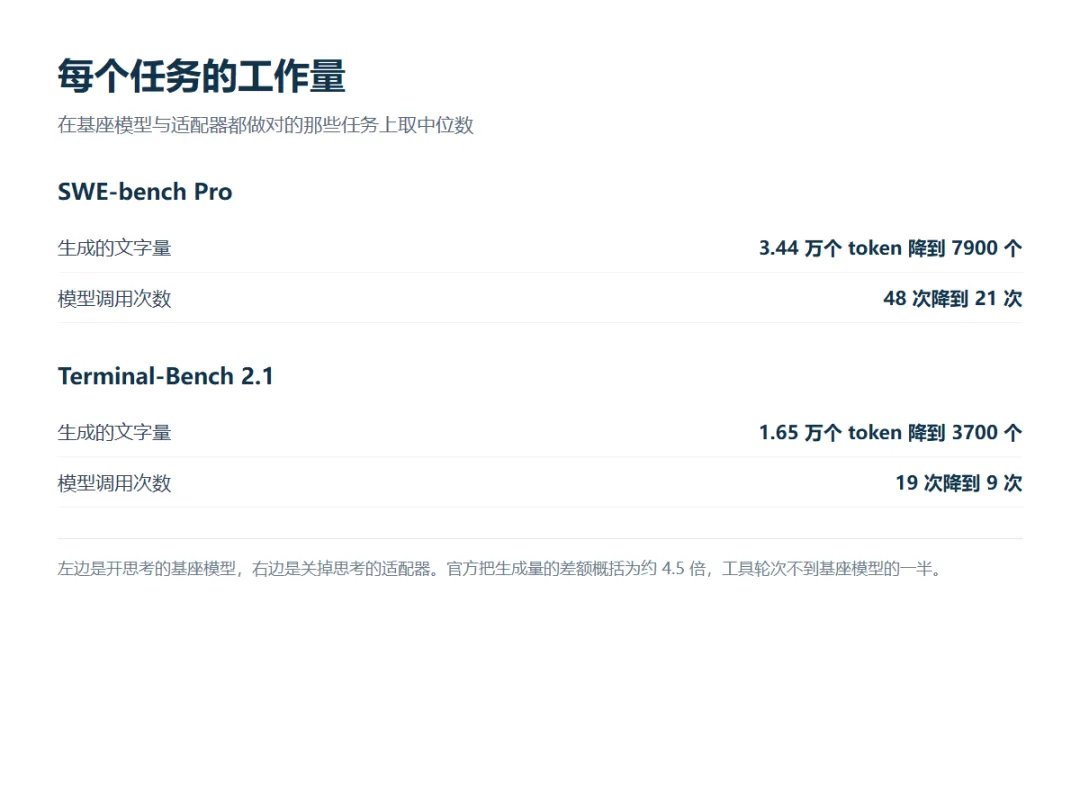
落差的来源是模型每轮写出的文字和工具调用。在两边都做对的那些任务上,开思考的基座模型每个任务平均生成约 3.44 万个 token,这个插件约 7900 个;模型调用 48 次,挂插件后 21 次。
Terminal-Bench 2.1 的差距同样来自思考部分:每个任务从约 1.65 万个 token 降到约 3700 个,调用次数从 19 次降到 9 次。工具轮次不到基座模型的一半。
官方把差额概括为约 4.5 倍。训练时采用的是关思考设置,服务时若打开,插件写出的推理内容和基座模型一样多,这部分省力就消失了。
把它接进编码代理
这段权重不能单独跑,必须配 Qwen3.8-27B 这个基座,换别的基座不起作用。做法是用支持 LoRA 的服务程序把权重挂到基座模型上,再把 pi 指向本机接口;也可以把权重并进基座,得到一个约 54 GB 的独立模型,用普通服务程序跑,不再需要挂权重。
还有一份转成 GGUF 的版本,能在本地用 llama.cpp 一类程序加载,同样要叠在 Qwen3.8-27B 的 GGUF 基座上。官方提示,基座量化得越接近训练用的精度,行为越接近训练结果;更低比特的版本偏离更大,而且这份 GGUF 没有重新评测过。
这些数字有边界
所有成绩都出自 pi 这一套评测环境:每个任务只试一次,预算 100 步,除特别说明外都关思考,只用文本、不加载视觉模块,采样参数为 0.8 和 1.0。基座模型和插件跑在完全相同的设置下。
这些数字不能直接和 Qwen3.8-27B 自己模型卡上的分数比,那张卡用的是别的评测框架、最高推理强度、更大预算和完整的 SWE-bench Pro。
Terminal-Bench 2.1 的四组对比取的是四者都评分的 83 个任务,配对比较用的是 86 个。用来挑检查点之外的 68 个任务上,插件是 55.9%,基座 39.7%。
早先一版模型卡报的是 29.4% 到 62.7%。后来发现其中 9 次基座的尝试因为沙箱和模型服务之间的通道中断而失败,重跑受影响的部分后,才得到现在的 39.2% 到 64.7%。当前检查点选在第 160 步,整轮训练在第 191 步停下,原计划是 1000 步。
要复现这些结果,得按官方这套条件来:用 Qwen3.8-27B 做基座、关掉思考、在 pi 里每个任务只试一次、100 步预算、纯文本。换基座或打开思考,上面的分数和省下的生成量都不成立。