ARTICLE · 1380014
收藏一波!5820星压缩插件,一行命令把月级长会话塞进100K上下文窗口
我最近连着几天在同一个会话里改代码,最烦的不是模型笨,是聊到后面模型开始忘事。宿主自带的自动压缩会把前面几十轮揉成一段不透明的摘要,原文直接丢掉。想追一句「三百轮前那个约束是什么」,只能重开会话从头讲。后来看见 billion-context 这个仓库,思路正好反过来:压缩这件事交给模型自己决定。
01
STEP
为什么用这套压缩
WHY · 痛点
先说清楚它治的是哪个环节。长会话真正撑爆窗口的,很少是你我打的字,多是工具输出:一次 grep 几千行、一轮测试日志、一次整文件读取。这些内容用完就该归档,可宿主默认把整段历史一视同仁地留着,等顶到阈值再一刀切。
· 压缩由模型决定,不是阈值硬切。代理往对话里注入四个工具,模型觉得哪段用完了就自己调用 compress 写成详细摘要;要用回细节再 decompress,还能 search_context 检索、acp_status 看用量。
· 增量、可逆、对前缀缓存友好。只折上次压缩以来的新增内容,摘要块单独存,缓存前缀不被改写。README 给的健康参考是命中率 95–97%,压缩本身代价 ≤2%,这是作者口径,不是我实测。
· 不挑客户端。README 的表格列了二十多个,Claude Code、Codex、OpenCode、pi、dsh、Kimi、Gemini CLI、aider、Zed 都在里面,底层只认 Anthropic 和 OpenAI 两种流。
换句话说,宿主那套「窗口满了揉成一段」的做法,变成了一张可以随时摊开的折叠地图。下面这张是 README 自带的工作原理图,四个工具标得很清楚。
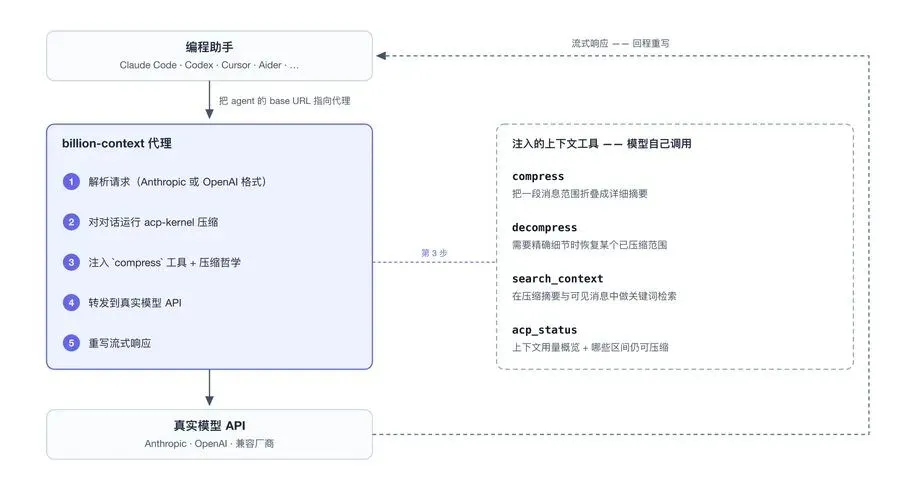
▲ README 里的工作原理图:代理插在编程助手和模型 API 之间,四个工具由模型自己调用
▲ 仓库自带的品牌图,不是产品界面截图
02
STEP
先弄明白它插在哪
PICK · 选型
这一步别急着敲命令。billion-context 不是编辑器插件,也不是模型,它是一个本地代理:编程助手把 base URL 指到它,它解析请求、跑 acp-kernel 压缩、注入工具、转发给真实模型 API,再把流式响应改写回来。
所以选型一句话就能说完:npm 装 bili,加一种接入姿态,模型和现有 API 一个都不用换。仓库里那张请求管道图把五步画得很清楚,入站、prepare、acp-kernel、统一 loop、出站改写,压缩内核只夹在中间一小段。
我选这种代理式方案,主要是因为它不锁宿主。换客户端、换模型、换网关,改的只是 URL;哪天不想用了,把前缀去掉,流量立刻恢复直连,客户端自己存的对话文件从来没被动过。
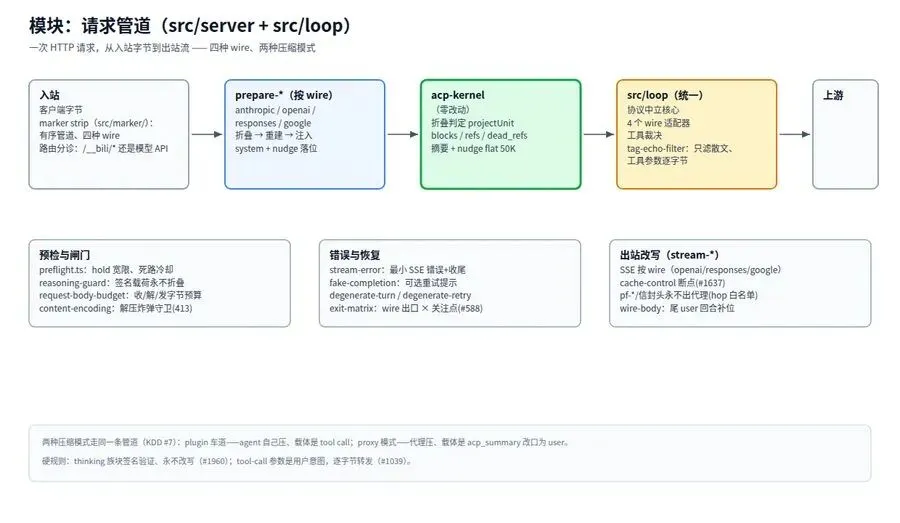
▲ 请求管道示意:入站、prepare、acp-kernel、统一 loop、出站改写(架构示意图,非界面截图)
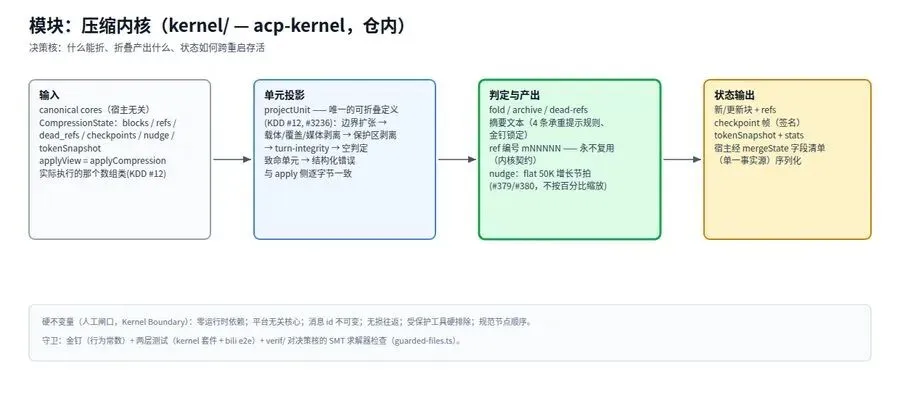
▲ 压缩内核示意:输入、单元投影、判定与产出、状态输出(架构示意图,非界面截图)
03
STEP
装与接:三步走
INSTALL · 实操
第一步,装。Linux 和 macOS 用用户级 prefix,不需要 sudo,也不会改全局 npm 配置。
npm install -g billion-context --prefix=~/.local
export PATH=$HOME/.local/bin:$PATH # PATH 里没有就加这行
bili 会落在 ~/.local/bin。PATH 里没有这个目录,就把那行 export 写进 ~/.zshrc。以前装过 root 属主 prefix、现在报 EACCES 的,重装时同样带上 --prefix 才是根治,别用 sudo 硬来。还有一条得记住:master 是开发分支,README 自己写着随时可能不可用,日常就装 npm 的发布版,别去 clone 源码编译。
第二步,接。三种姿态任选其一,别同时开。
bili plugin install claude # 原生插件,照常启动客户端
bili claude # 启动器,不改任何配置文件
bili # 再把 baseURL 加上 /bili/ 前缀
我最省事的是启动器:一条 bili 加客户端名,把代理和客户端一起拉起来,不碰真实配置文件。改 URL 最通用,把客户端 baseURL 前面加上 http://localhost:8787/bili/,上游的完整地址直接嵌在路径里,代理不用配就知道往哪转发。Claude Code 还能走仓库自带的插件市场,三条斜杠命令依次敲完就好。
/plugin marketplace add ranxianglei/billion-context
/plugin install billion-context@billion-context
/billion-context:bili-setup
对接时有个坑:原生插件和独立的进程内扩展互斥,两个都开着会双重压缩。安装器会替换旧条目并把原配置备份成 .bili-bak,但项目级的手工装,安装器管不到,得自己删。OpenCode 2.x 更麻烦,裸包名走不通,要额外写一行 re-export 的 shim。
第三步,验。装完先确认代理真的在跑,再谈省了多少。
curl -s http://localhost:8787/__bili/health
curl -s http://localhost:8787/__bili/stats
bili --passthrough # 只转发不压缩,冒烟测试
健康检查会告诉我代理在不在、转发到哪。然后从助手发一条消息,去 ~/.local/state/billion-context/bili.log 找 processTurn;等对话长了会冒出 acp-usage 那行缓存命中和 compress 事件。怀疑是代理在捣乱,就用 --passthrough 只转发不压缩,冒烟测一次。
这里顺带把「折」讲明白。论文那张布局图里,左边是分层的摘要块,右边约 50K 的近期区保持原文,首末消息和正在用的内容受保护;被折起来的区间可以按需解压到文件。摘要块还能再折成 tier-2、tier-3,一层比一层小。
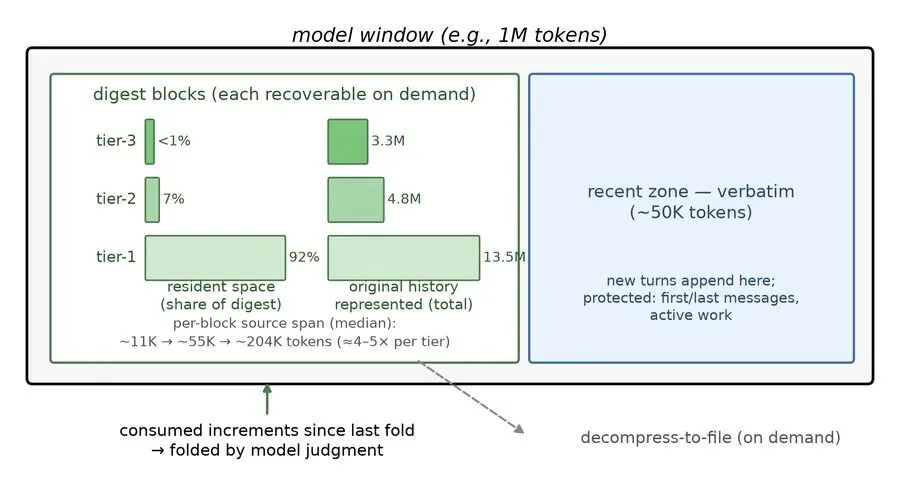
▲ 论文配图:分层摘要块加原文近期区,被折起的内容可按需解压到文件
04
STEP
效果怎么看
CHECK · 面板
别急着信宣传数字,先看自己的面板。浏览器打开 http://localhost:8787,或者在带原生插件的客户端里打 /acp-cache,会出一份带 Web 链接的文字报告。仓库那张中文截图里,用量统计写着 509 次请求、28.8M 输入 token、缓存命中 96.0%、压缩节省 63.3M,下面还有折线图和逐次折叠明细。这种图比一句「省 5 倍 token」实在得多。
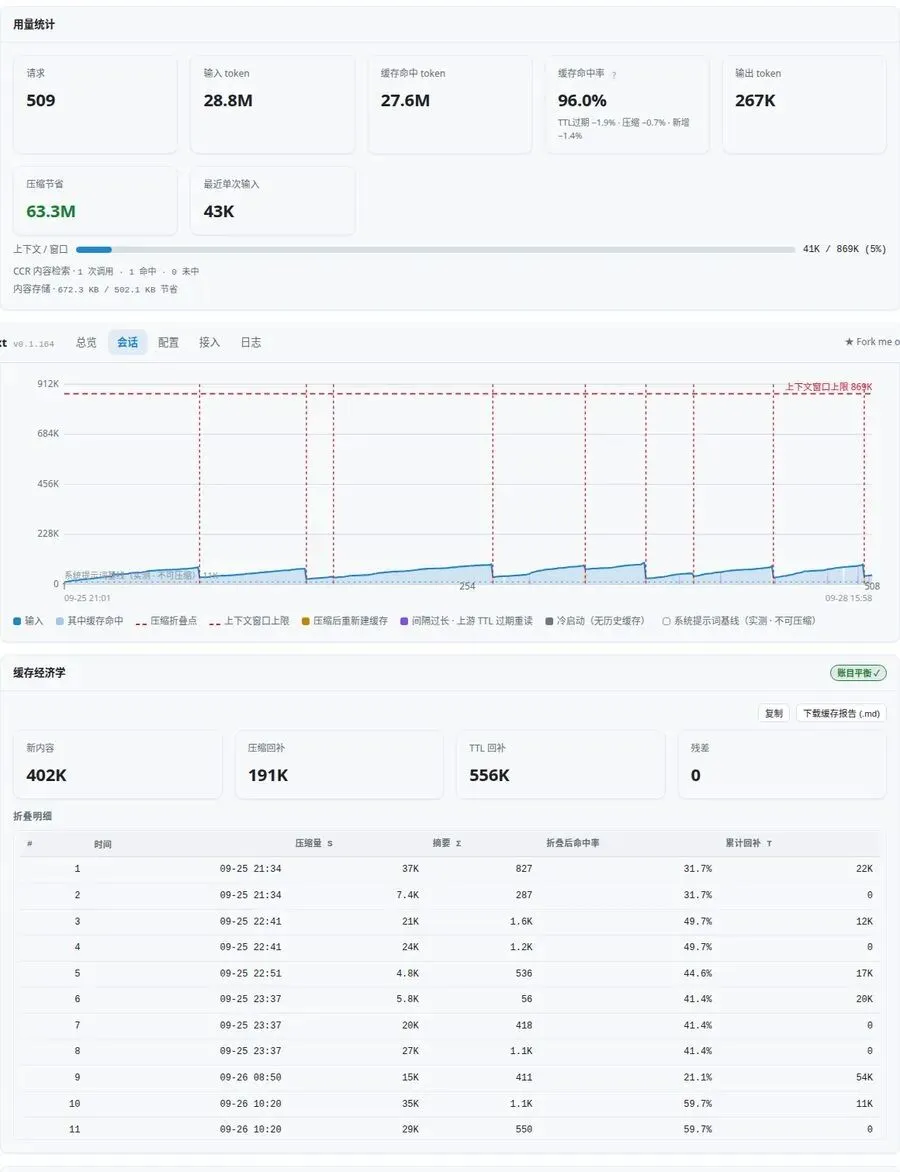
▲ 仓库自带的中文 Web 会话页截图:用量统计、缓存命中率折线图与折叠明细
论文里那张马拉松轨迹图我也看了:两条线分别是 OpenCode 宿主 12,049 次调用和 Pi 宿主 8,584 次调用,红色虚线是 204,800 的窗口天花板,全程没越过去。论文自述的口径是四个半月、三宿主、174,327 次模型调用、187.6 亿累计输入 token。这些数字都来自仓库里的 v0.2 预印本,我没有复现,看的时候当作者自述更稳妥。
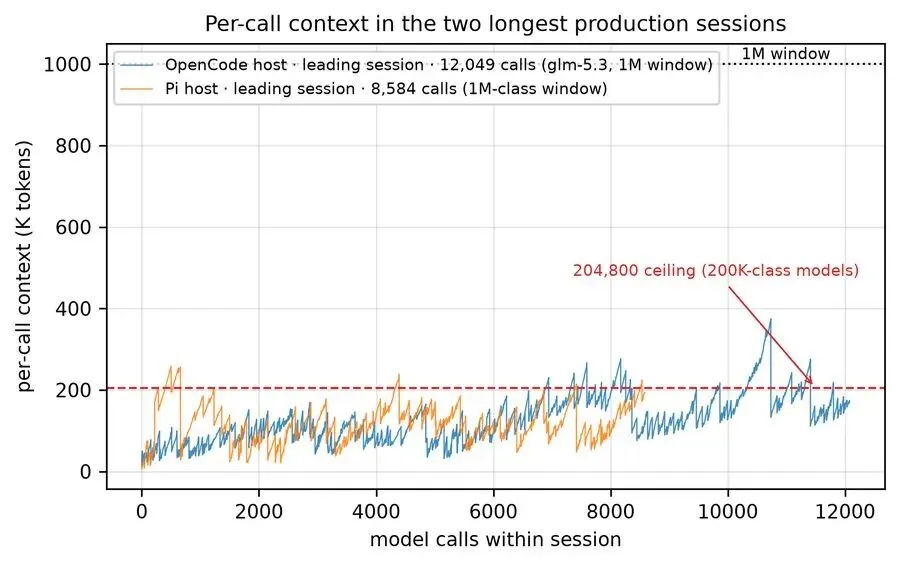
▲ 论文配图:两段生产会话的每调用上下文,红线是 204,800 窗口天花板(作者自述数据)
05
STEP
边界提醒
HONEST · 诚实
说点实在的,这套东西离「装完就省心」还有距离,用之前有几件事得心里有数。
· README 的「状态」一节自己写着「早期」「预期会有粗糙的地方」,真实模型集成测试还列在下一里程碑。仓库现在 929 个 open issue,编号已经过 5600,正文里到处是带编号的修复记录,还专门留了一个「严重缺陷公告(强制更新)」通道。
· 代理每 3 分钟查一次 npm 新版本并原位安装,装完要重启才生效。不想被自动升级打扰可以关 autoUpdate,但关键缺陷公告的轮询是独立通道,关不掉。
· 安全边界要看清:Docker 默认监听 0.0.0.0:8787 且没有任何认证,--host 0.0.0.0 给远程 agent 用时同样没有鉴权,README 明说只应放在可信局域网或防火墙内。部分客户端走的是证书 MITM,等于把模型流量交给本地代理解包再转发,公司机器上先问清楚。
· 别指望装上立刻省钱。默认按增长区间触发,开机内容之上再涨约 50K token 才第一次软压缩;开机内容本来就大的会话,可能要到 20 万上下才动第一次。压缩也只改发给模型的内容,客户端自己存的对话历史一个字节都不动,有人以为是给本地聊天文件瘦身,这是误会。
· 评测数字别只读 README。那份 1,500 题报告里,BC 在 ContextBench 拿第一(0.3097 F1,比全量基线省 58.3% 成本),但 LongMemEval-S 上全量上下文 83.20% 才是第一、BC 79.20% 第二;MemoryAgentBench 上最好的 RAG 臂 55.21%,BC 43.54%。1.48M 超长压力下全量基线 199 题全崩、BC 100% 存活,这是真本事,但「三项全胜」不是报告的原话。
· 论文自己也划了范围:286 亿 token、106 天是仿真外推,比最大观测会话还高约 19 倍;逐字历史类任务(审计、合规、取证)明确不覆盖;作者还做了一个静默对照,光靠压缩哲学文本加消息标签就复现了几乎全部的重获取降幅。
· 协议看着是 MIT,末尾其实加了一条:任何终端用户可见、用到这套内核的产品或服务,要在首页、文档或关于页注明出处并附仓库链接,GitHub 因此把许可证归成 Other。做二次分发前先读一遍 LICENSE。
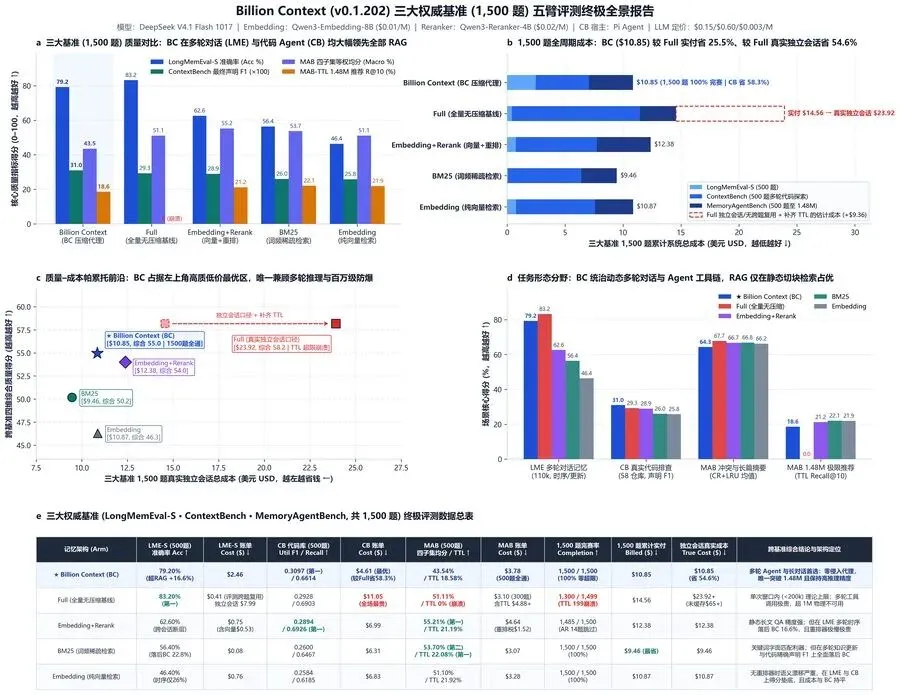
▲ 仓库自带的 1,500 题五臂评测总览,原图信息密集,缩小后细字需点开看
我更愿意把它当「长会话的上下文管理层」,而不是「免费无限上下文的开关」。真要上生产,先在旁路跑一周,盯住缓存命中和压缩事件再说。
///
STEP
最后总结一下
SUMMARY · 总结
最后总结一下。想把长会话不重开,思路不是把窗口越买越大,而是让模型自己决定哪段历史可以折起来、随时还能摊开。一条 npm 命令装好 bili,原生插件、启动器、改 URL 三种姿态挑一种接进现有客户端,再用健康检查和 /acp-cache 面板确认真的在压缩。全文 2703 字,配图 8 张。
开源地址:github.com/ranxianglei/billion-context 协议:MIT 加署名条款 星标:5,820 依赖:Node 与现有编程助手
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING