ARTICLE · 1386847
【NeurIPS 2026】文档解析模型不动架构只动数据,1.2B模型就能解决问题
每日高引论文精读 · NO.052
MinerU2.5-Pro:上海 AI 实验室不动架构只动数据,1.2B 文档解析超过 200 倍大模型
MinerU2.5-Pro: Pushing the Limits of Data-Centric Document Parsing at Scale
arXiv:2604.04771 · cs.CV · 被引 0 次(截至 2026-11-20) · NeurIPS 2026 · Spotlight
文档解析模型这两年卷架构,上海 AI 实验室却先做了个诊断:不同架构、不同参数量的 SOTA 模型,在同一批困难样本上犯高度一致的错误。瓶颈不在架构,在训练数据。于是 MinerU2.5-Pro 完全不改 1.2B 架构,纯靠数据引擎与训练策略:难度感知采样把数据扩到 6550 万页,跨模型一致性验证产出可靠标注,判官修订流水线修正难样本。三阶段训练后,OmniDocBench v1.6 拿 95.69 全场第一,超过 200 倍参数的通用大模型,还修正了基准偏差。
一句话
文档解析不动架构只动数据:跨模型一致性挑难样本,1.2B 模型 OmniDocBench 95.69 超过 235B 大模型。
WHY IT MATTERS
为什么这篇值得读
文档解析是把 PDF 还原成机器可读结构的技术,公式、表格、阅读顺序是三大难点。这个领域的竞赛一直围着架构转:更大的视觉编码器、更强的 VLM。上海 AI 实验室团队先做了一个诊断:把 diverse 架构、跨参数量的 SOTA 模型摆在一起看失败样本,发现它们在同一批难样本上犯高度一致的错误。既然不同的脑子在同地方摔跤,说明路是坏的,不是腿的问题,瓶颈在所有模型共享的训练数据上。
解法是一个围绕覆盖率、信息量、标注准确率三维度协同设计的数据引擎。第一,多样性与难度感知采样(DDAS):页级与元素级两层聚类加跨模型一致性打分,把样本分成易、中、难、无效四档,易的下采样、难的上采样,训练集从不足 1000 万页扩到 6550 万页且控制了分布偏移。第二,跨模型一致性验证(CMCV):多个异构模型对同一样本的输出共识度天然就是难度度量,共识高的自动合格,分歧大的进难样本池。第三,判官与修订流水线:难样本先渲染再对比判错位置,自动修订不过关的高价值样本升级给 Gemini 3 Pro 预标注加人工专家终审。
训练策略按数据质量分层渐进:第一级大规模预训练吃全部 6550 万页,第二级难样本监督微调,第三级 GRPO 强化学习对齐任务级指标。消融把贡献拆清楚:Stage 1 贡献最大单项增益加 1.31,Stage 2 难样本微调加 0.96(表格 TEDS 单项涨 2.50),Stage 3 GRPO 加 0.45(公式 CDM 涨 0.81)。全程架构一个参数没改,OmniDocBench v1.6 从 92.98 涨到 95.69。
评测侧也做了实事:修正了 OmniDocBench v1.5 的元素匹配偏差(语义正确的预测被错误判罚),新增 Hard 子集与三档协议,形成更有区分度的 v1.6。修正后 Gemini 3 Pro 的分数大幅上调(92.85),缩小了与专用模型的差距,但 0.9B 到 1.2B 的专用模型仍然整体领先,小模型打赢 235B 通用大模型这件事本身,就是数据中心路线的最好广告。
不读它会错过什么:在「换架构」叙事主导的领域里,这是一份「数据工程优先」的完整方法论:诊断、采样、验证、标注、分层训练、基准修正,每一环都可复用。做垂直领域解析、做数据工程的团队,这套流水线比单个 SOTA 分数更有移植价值。
THE PAPER
论文基本信息
方法速览:架构沿用 MinerU2.5 的 1.2B 参数模型不做任何修改。数据引擎三件套:DDAS 两层采样(页级 ViT-B 嵌入加 K-Means 聚类,元素级按布局、文本、公式、表格分别聚类),CMCV 用 MinerU2.5、PaddleOCR-VL-1.5、Qwen3-VL-30B 三个异构模型的输出配对一致性划分易中难(约 50%/25%/15%),难样本经 Judge-and-Refine(渲染回比对、Gemini 3 Pro 预标注、专家终审)修正。训练三阶段:6550 万页预训练、约 12 万难样本微调、GRPO 对齐。评测:修正匹配偏差并新增 Hard 子集的 OmniDocBench v1.6(Base、Hard、Full 三档),对比专用小模型与 Gemini 3 Pro、Qwen3-VL-235B、GPT-5.2 等通用大模型。代码、模型、基准开源。
FINDINGS
核心发现与证据
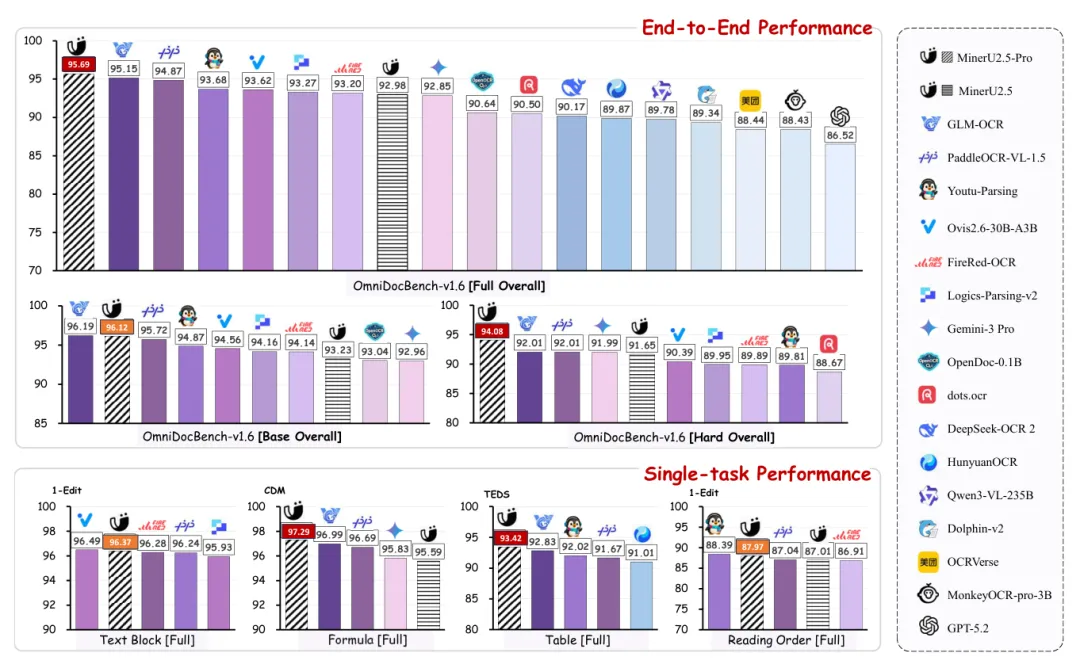
全景战绩:OmniDocBench v1.6 的 Full、Base、Hard 三档与文本、公式、表格、阅读顺序单项,MinerU2.5-Pro(斜纹柱)在 Full 与 Hard 总分居首,公式 CDM 97.29、表格 TEDS 93.42、阅读顺序 0.120 均为最佳。
01不动架构,总分从 92.98 涨到 95.69 全场第一
OmniDocBench v1.6 Full 上 MinerU2.5-Pro 得 95.69,同架构基线 MinerU2.5 是 92.98,2.71 分全部来自数据与训练策略;超过 GLM-OCR(95.15)、PaddleOCR-VL-1.5(94.87)与全部通用大模型。来源:表 2、§6.2。
021.2B 超过 200 倍参数的通用大模型
修正匹配偏差后 Gemini 3 Pro 得 92.85、Flash 92.58,仍低于 1.2B 的 MinerU2.5-Pro(95.69);Qwen3-VL-235B、GPT-5.2 等更大模型同样落后。单项上公式 CDM 97.29、表格 TEDS 93.42、阅读顺序编辑距离 0.120 均为全场最佳。来源:表 2、§6.2。
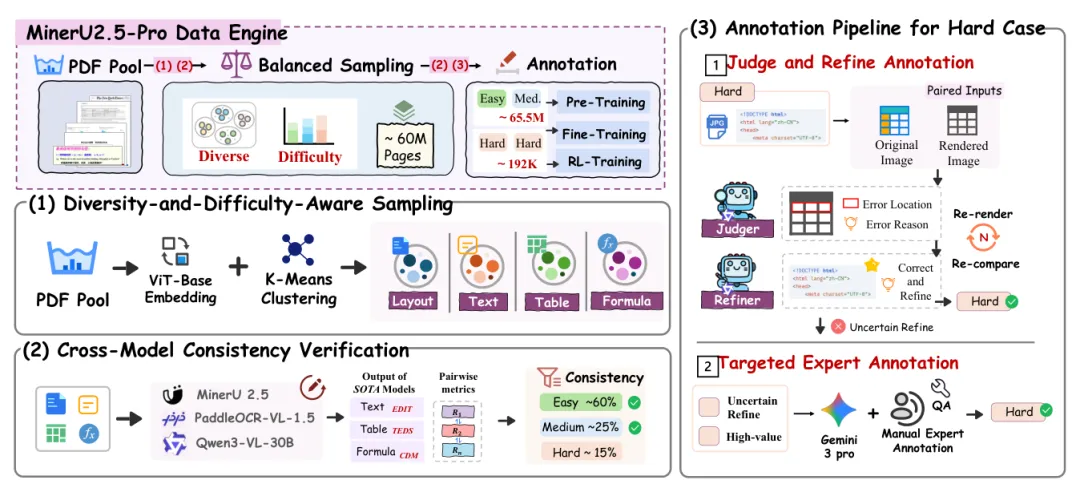
数据引擎三件套:PDF 池经 DDAS 平衡采样产出约 6000 万页训练数据,跨模型一致性验证把样本分成易中难三档,难样本走判官修订加专家终审的标注流水线。
03Base 接近饱和,Hard 子集才是分水岭
标准场景的 Base 子集上前三名(GLM-OCR 96.19、MinerU2.5-Pro 96.12、PaddleOCR-VL-1.5 95.72)差距不足 0.5 分,接近饱和;Hard 子集上 MinerU2.5-Pro 领先 94.08,比并列第二的 GLM-OCR 与 PaddleOCR-VL-1.5(均 92.01)高 2.07 分。数据引擎的优势集中在难样本上。来源:§6.2、表 7、表 8。
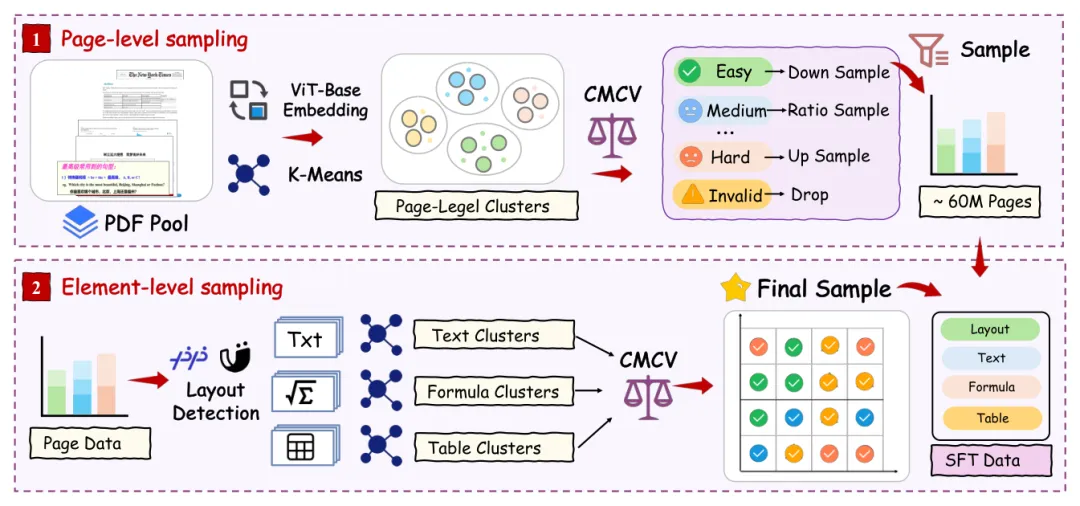
DDAS 两层采样:页级用 ViT-B 嵌入加 K-Means 聚类,元素级按布局、文本、公式、表格分别聚类,再由 CMCV 打分决定下采样、按比例采样、上采样或丢弃。
04三阶段消融拆清贡献:预训练最大、难样本微调次之、GRPO 收尾
Stage 1 大规模预训练贡献最大单项增益(+1.31),Stage 2 难样本微调加 0.96(表格 TEDS 90.37 到 92.87),Stage 3 GRPO 加 0.45(公式 CDM 96.48 到 97.29);Hard 子集累计从 91.65 到 94.08,与 Base 的涨幅相当,说明渐进训练对难样本同样有效。来源:表 3、§6.3。
05不同架构的 SOTA 在同一批难样本上犯同样的错
这是立项的诊断发现:跨架构、跨参数量的 SOTA 模型呈现高度一致的失败模式,说明性能瓶颈来自共享的训练数据缺陷而非架构差异。这个观察直接决定了「不动架构只动数据」的技术路线。来源:摘要、§1。
06修正了基准的匹配偏差, Gemini 3 Pro 被错判罚
OmniDocBench v1.5 的元素匹配策略会把语义正确的预测错误判罚;v1.6 修正后 Gemini 3 Pro/Flash 分数明显上调(Full 92.85/92.58),说明此前通用大模型被系统性低估,也说明旧基准的排名失真。来源:图 4、§5。
SIGNIFICANCE
重要性与突破性
01给「数据工程优先」提供了一份可复制的完整方法论
诊断失败一致性、DDAS 采样、CMCV 难度判定、判官修订标注、分层渐进训练,五个环节都开源可复用。垂直领域(金融、法律、医疗)做专用解析模型时,这套流水线比换架构更对口。
02小模型打赢通用大模型的具体配方
1.2B 专用模型在文档解析全指标领先 235B 通用大模型,证明在领域任务上,「对的训练数据」可以系统性替代参数规模。这对算力受限、需要本地部署解析能力的团队是直接可行的路线。
03把评测基准本身当研究对象来修
发现并修正 v1.5 的匹配偏差、新增 Hard 子集与三档协议,让排名恢复区分度与公平性。当榜单接近饱和时,修基准比刷榜单更有长期价值,这一做法值得其他领域借鉴。
LIMITS
局限性
01评测的元素匹配范式有天然歧义
作者自认:同一内容可有多种等价写法(表格用 HTML 还是 Markdown、公式用哪些 LaTeX 命令),同一版式可合法表达为不同元素类型(双语对照表既可以是逐行文本也可以是两列表格),连人工标注者都可能分歧。语义等价评测仍是开放问题。来源:Limitations。
02垂直领域未覆盖
v1.6 覆盖主流应用场景,金融、法律、医疗等高精度要求的垂直领域需要专门的评测集补充;模型在这些领域的表现没有数据。来源:Limitations。
03只做内容抽取,结构理解缺位
标题层级关系、图表与引用文本的语义绑定、跨页内容连续性这些下游真正需要的结构信息不在本工作范围内;「从内容抽取到结构化语义理解」被列为下一步。来源:Limitations。
04CMCV 的难度判定依赖三个特定模型的一致性
易中难划分由 MinerU2.5、PaddleOCR-VL-1.5、Qwen3-VL-30B 的输出共识决定,模型组合变化时划分可能不同;一致性高不代表标注正确(三个模型可能一致地错),对高价值样本仍需人工与 Gemini 兜底。来源:§3。
05数据引擎依赖 Gemini 3 Pro 与人工专家
难样本的预标注用 Gemini 3 Pro,终审靠人工专家,这一环既不便宜也不完全自动;对无法访问 Gemini 的团队,该环节的成本与质量需要重新评估。来源:§3.3。
06Base 子集接近饱和,增长空间转向 Hard
标准场景前三名差距不足 0.5 分,接近饱和;继续提升主要靠 Hard 场景,而 Hard 子集的构成由作者定义,其「难」的代表性需要时间检验。来源:§6.2、§5.3。
IN ONE LINE
一句话总结
跨架构模型在同一批难样本上犯同样的错,说明瓶颈在数据不在架构。MinerU2.5-Pro 不动 1.2B 架构,靠 6550 万页数据引擎与三阶段渐进训练,OmniDocBench v1.6 拿 95.69 全场第一,超过 200 倍参数的通用大模型。
原文:arxiv.org/abs/2604.04771
配图:论文原图与表中数据重绘;数据以论文为准。
每日高引论文精读 · 每天一篇高引用 AI 论文,去粗取精。