ARTICLE · 1039838
GLM 用 AI 优化推理系统:约 3 倍吞吐是怎么做出来的?
“一次推理系统优化,最值得追问的,是性能收益如何被验证。
让 AI 写出一段代码,已经不稀奇。
让它进入一个运行中的推理系统,判断哪里该改、改完是否正确、收益能否落到整条链路上,难度就完全不同了。
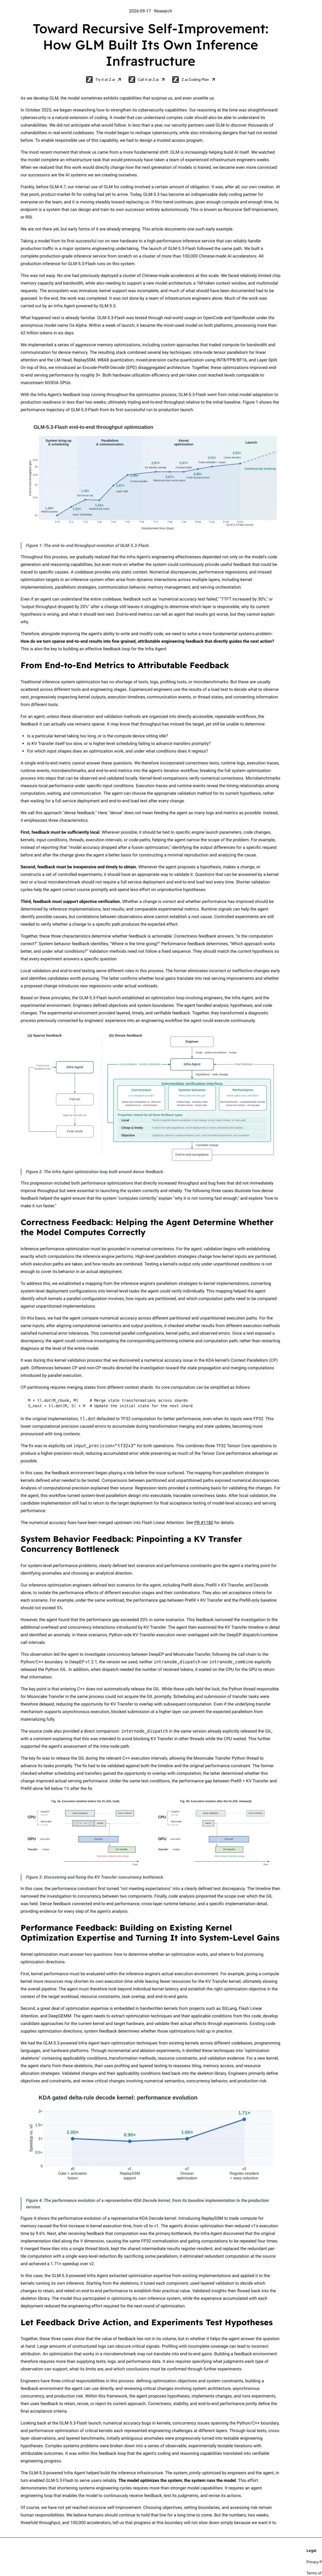
9 月 17 日,智谱披露:GLM-5.3 驱动的 Infra Agent 参与优化 GLM-5.3-Flash 推理系统,官方报告端到端吞吐达到初始基线约 3 倍。
对开发者来说,值得追问的是:这些改动如何让系统更快,AI 又具体参与了哪一步?
顺着这个问题看下去,量化、算子、并发和测试,就连成了一条完整的工程链路。
01 / 先把“约 3 倍”放回正确的位置
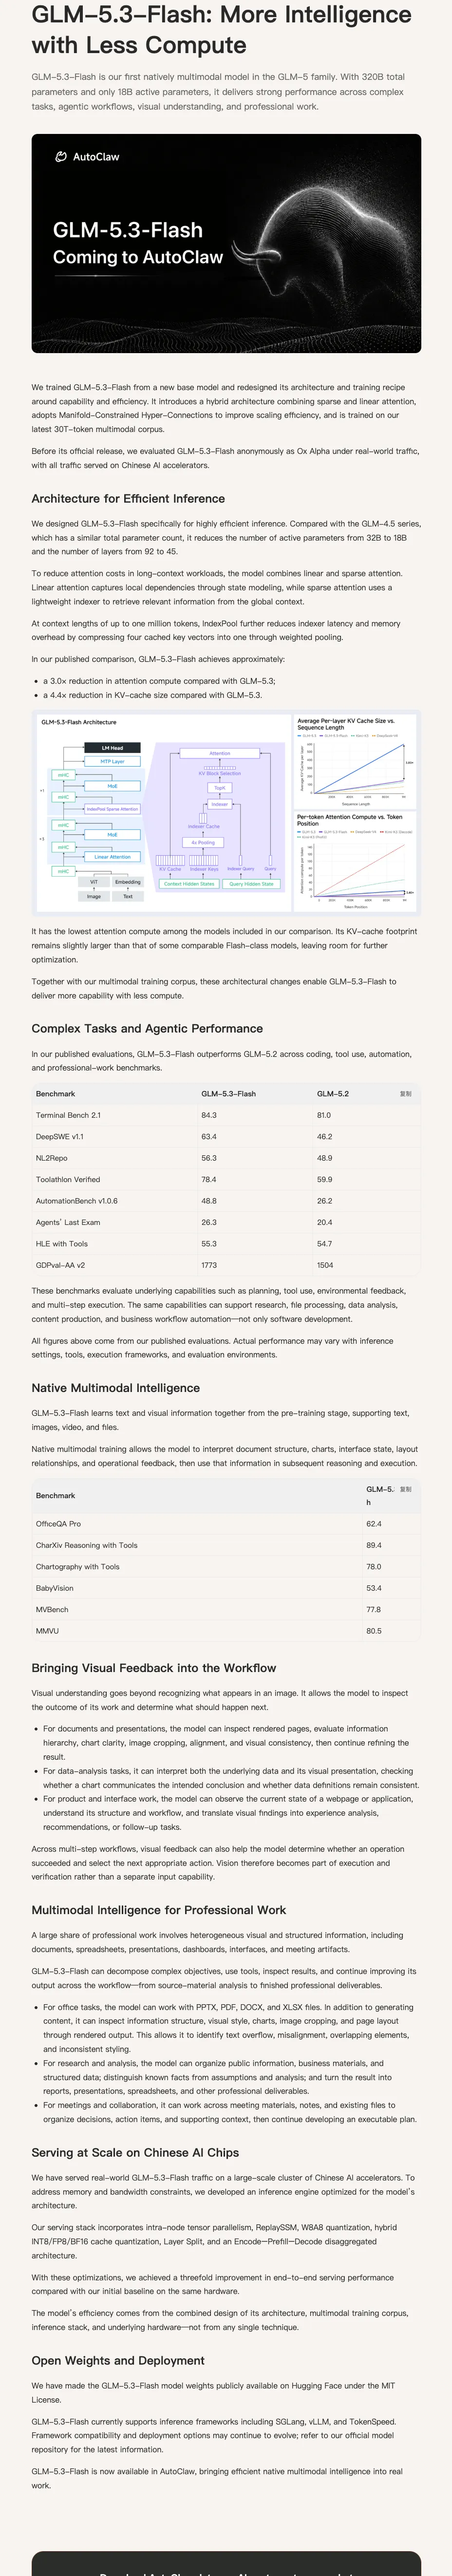
官方后续模型说明明确,比较对象是同一硬件上的初始基线;系统同时采用了 W8A8 量化、混合精度缓存、机内张量并行、ReplaySSM、Layer Split,以及 Encode–Prefill–Decode 阶段拆分。
因此,“约 3 倍”描述的是一组优化后的整体结果。
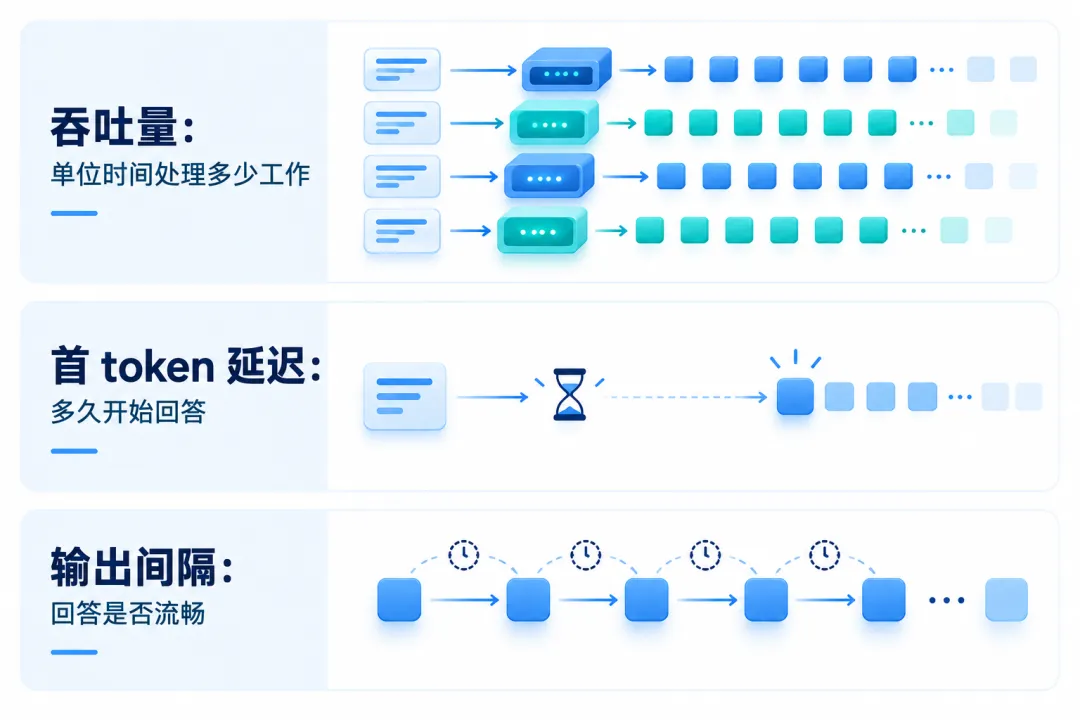
读这类数字时,最好在脑中保留三个不同的仪表:
吞吐量:整套服务单位时间处理多少工作。 首 token 延迟:用户等多久,才能看到回答开始。 后续输出间隔:回答开始后,内容是否流畅地生成。
它们回答的是不同的问题。把更多请求攒成批次,可能有利于整体处理效率,也可能增加某个用户的等待。一个更漂亮的吞吐数字,需要放回具体负载和延迟约束中判断。
本文采用官方披露的收益口径,未独立复现该集群。公开材料也不足以给每项优化分配一张“贡献百分比”清单。
02 / 推理优化,要同时盯住计算、数据和调度
理解这些技术,可以先沿着一个请求向前走:输入进入系统,数据被读取、计算、传递,最后生成输出。
任意一段拖慢,都会影响最终体验。下面是理解这些优化方向所需的通用原理。
第一处:让数据少占空间,也少搬一点。
量化会用更低位宽表示权重或激活。数据变小,有机会缓解内存容量和带宽压力,但新增的数据转换、算子实现和硬件支持,都会影响最终收益。
PyTorch 的 torchao 文档特别提醒:某些层量化后,可能因为额外开销变得更慢。
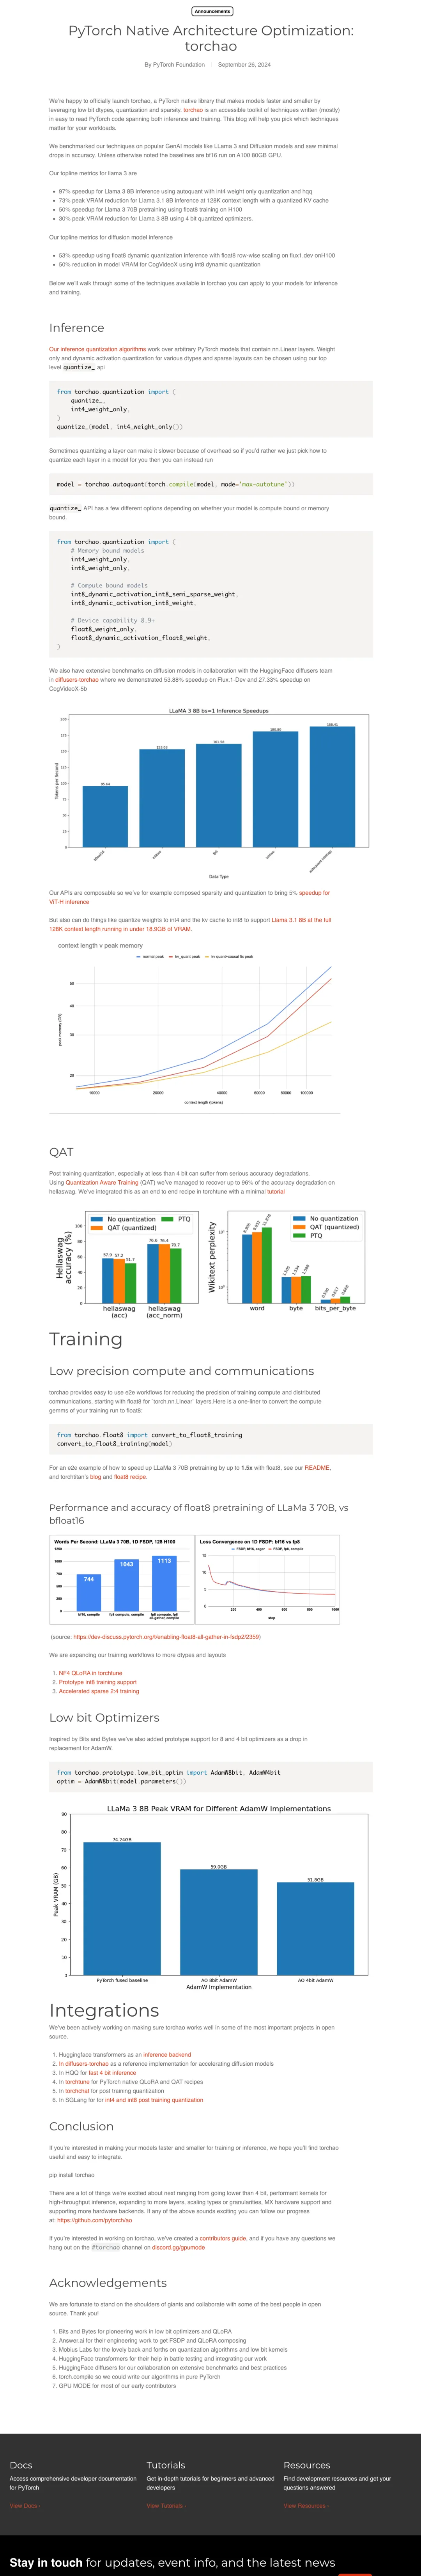
这给评估带来一个直接要求:不要只比较模型文件大小。应该在目标硬件、目标输入和真实并发下,同时检查精度、占用与速度。
ReplaySSM 则提供了另一种减少搬运的思路。按其作者公开的机制说明,它保留状态检查点和近期输入,在需要时重建状态,减少每一步都把完整状态写回显存的操作。这里介绍的是通用机制,GLM 内部如何适配仍以其披露为准。
第二处:让计算过程减少浪费。
矩阵乘法等算子,需要由底层内核执行。同一个数学操作,可以有不同的实现方式:数据怎样分块,中间结果放在哪里,哪些操作合并执行。
PyTorch 的推理优化案例就把算子融合、更快的算子实现和张量并行列为不同的加速手段。
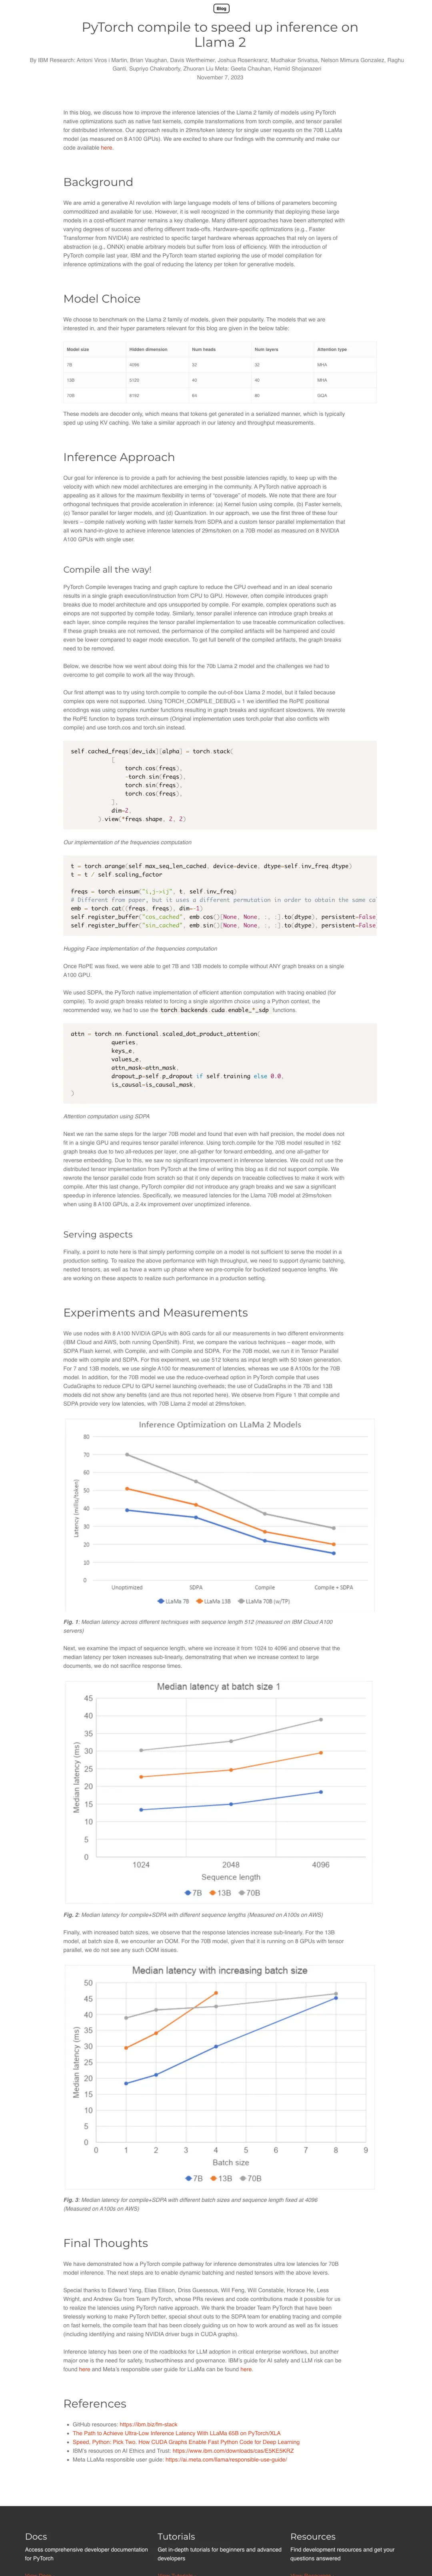
一个通用的设计例子是:多个任务都需要同一份中间结果。如果它们各自重新计算,就要比较“重复计算的成本”和“共享结果的成本”,再决定如何组织执行。并行数量本身无法替代这个判断。
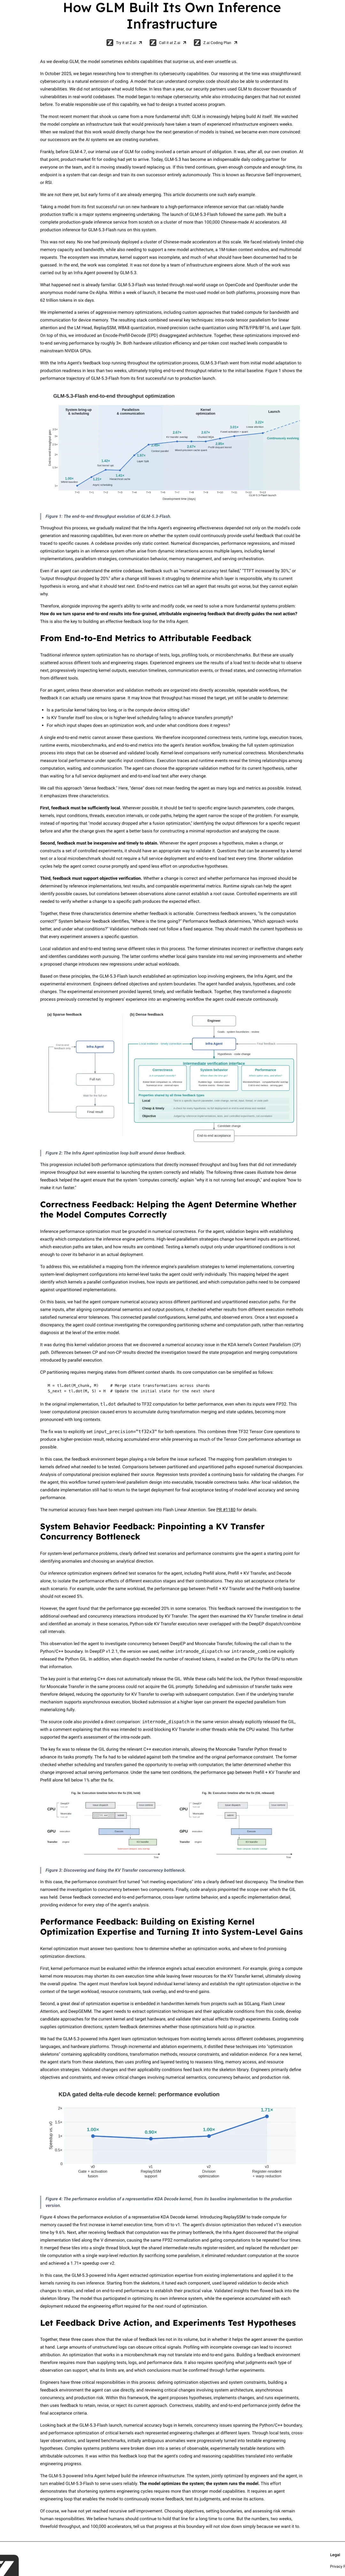
官方案例里,Agent 通过合并分块,消除了某个 KDA Decode 内核中重复四次的归一化与门控计算;该版本相对 v2 加速 1.71 倍。这是局部结果,不能与其他收益直接拼成系统的 3 倍。
第三处:让不同阶段各自有合适的资源。
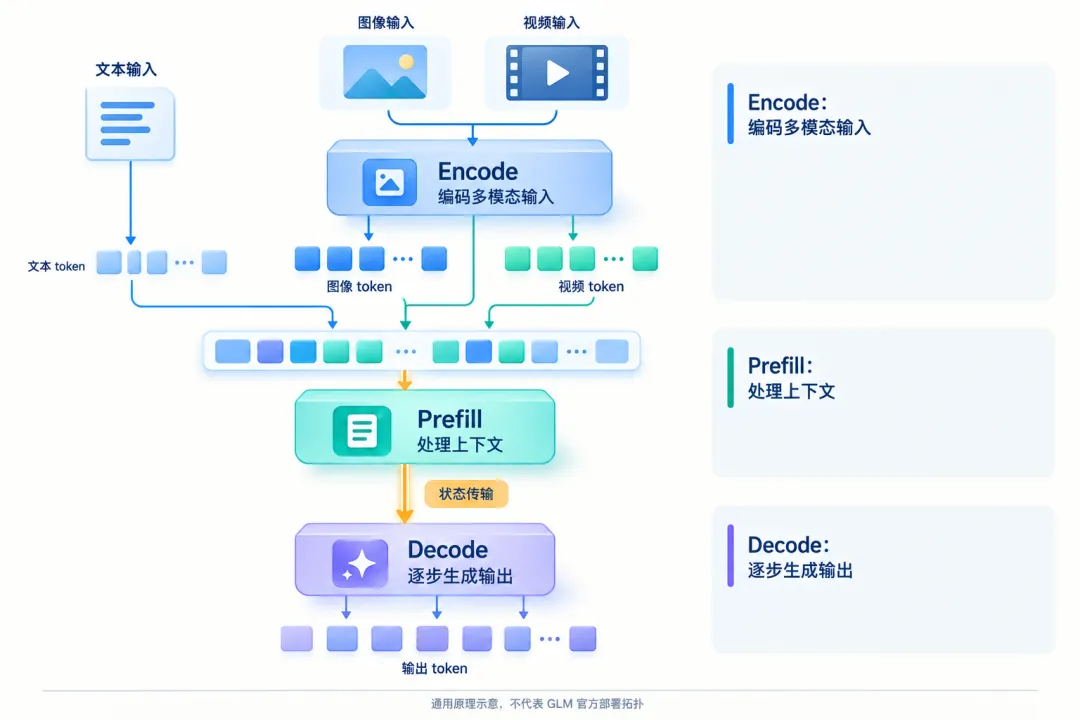
在多模态请求中,Encode 负责把图像等非文本输入转成模型可用的表示;Prefill 处理输入上下文;Decode 逐步生成输出。纯文本输入不需要先经过图像编码这一步。
将 Prefill 与 Decode 拆开,就有机会分别配置资源、调整首 token 延迟和后续输出延迟。
但拆开也引入了状态传输和协调工作。vLLM 的文档明确指出,其 disaggregated prefill 功能本身不提高吞吐;它主要用于独立调节不同阶段的延迟,以及控制尾部输出延迟。
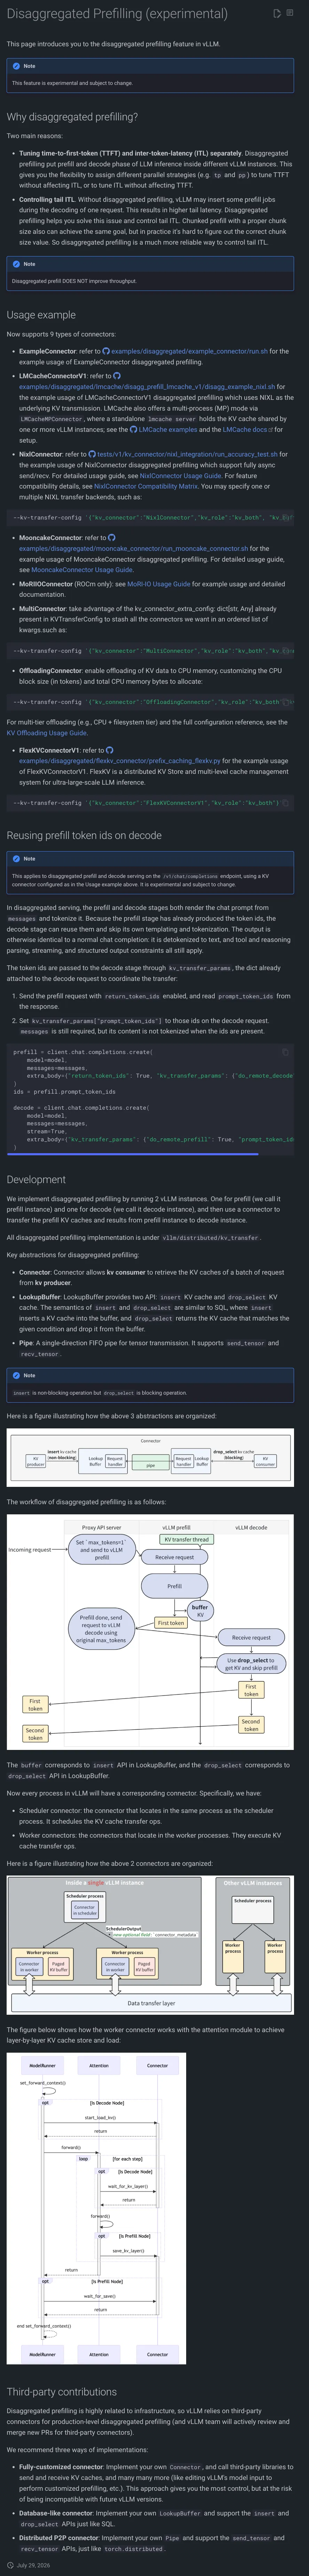
这也解释了为什么不能看到“阶段拆分”,就把整套系统的收益记在它一个技术名词下面。
03 / 一个具体瓶颈:传输线程被“锁”住了
另一个官方案例中,Agent 从时间线追到节点内调用持有 GIL 的问题。释放对应区间的锁后,Prefill + KV Transfer 相对 Prefill-only 的性能差距,在部分场景由超过 20% 降至 1% 以下。
这组数字描述的是一个特定对照实验,不能直接换算成整套服务又获得多少倍加速。
为什么一个 Python 层面的锁,会出现在推理性能问题里?
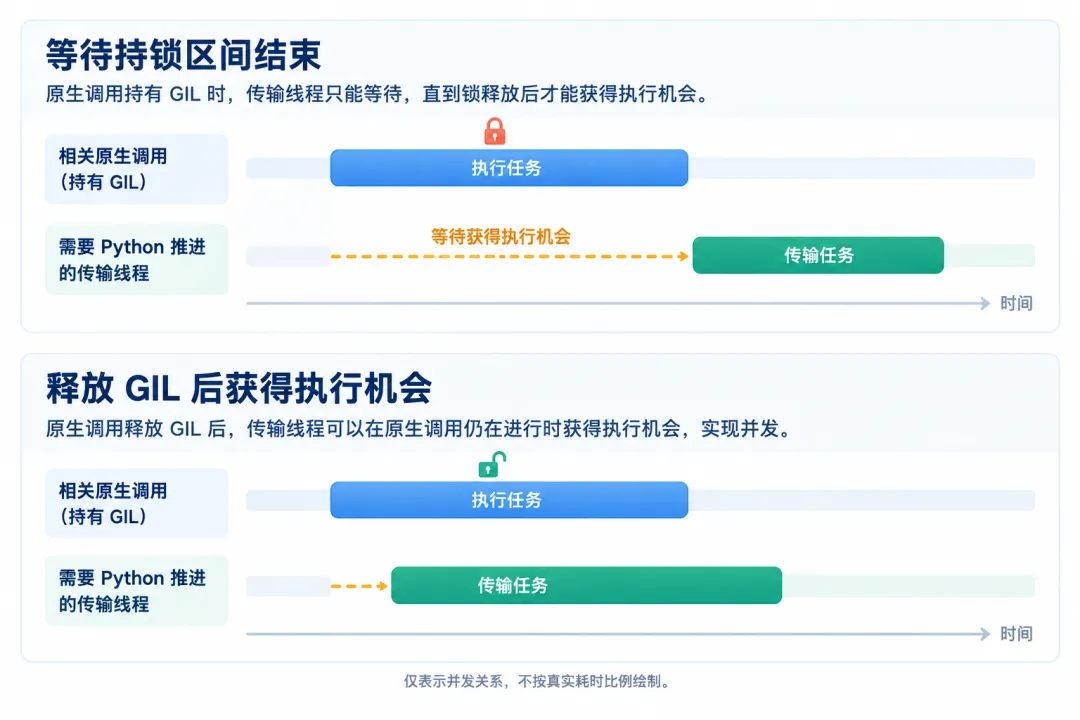
在启用 GIL 的 CPython 中,线程访问 Python 对象需要持有全局解释器锁。原生扩展进入某些无需访问 Python 对象的耗时区间时,可以按规则释放它,使其他线程获得执行机会。

用一个简化的场景来理解:一条线程进入原生代码,另一条线程需要通过 Python 推进数据传输。如果前者持续占锁,后者就可能一直等。纸面上已经安排了并行任务,运行时却没能重叠起来。
这个机制有独立的开源记录。DeepEP 的 PR #142 早在 2025 年就讨论并修复过长时间持有 GIL、导致 Mooncake 传输线程受阻的问题。
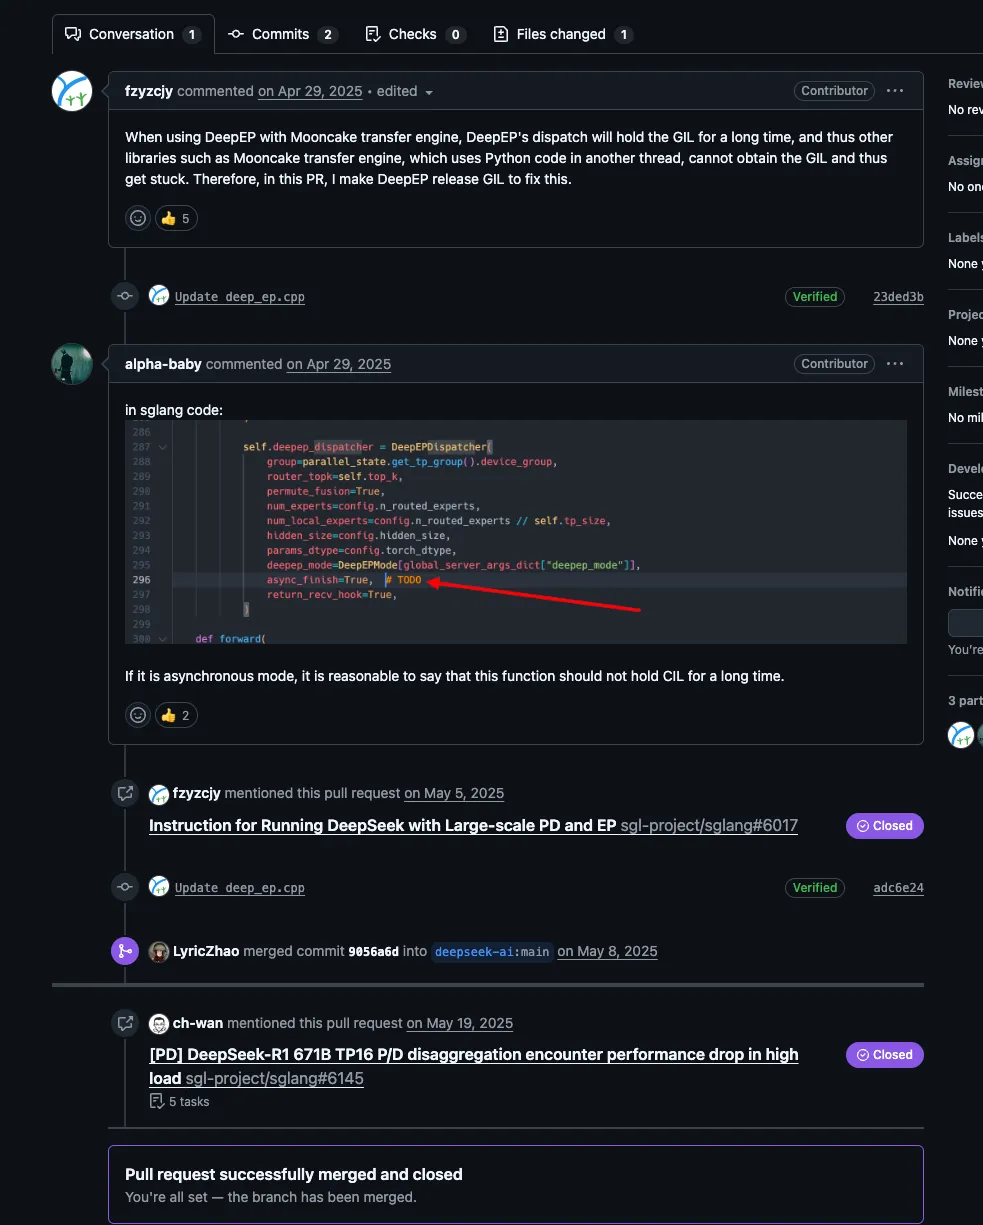
这份记录修复的是跨节点路径,可以帮助理解该类瓶颈。它与本次案例中的节点内路径不同,也不能当作本次 GLM Agent 提交的成果。
从工程判断上说,一个“传输慢”的症状,至少可能对应两类问题:数据已经开始搬,但搬得慢;或者传输任务迟迟没得到推进。
前一种方向需要检查传输路径,后一种方向则需要检查线程、锁和调度。只有吞吐数字,很难把两者区分开;执行时间线能让下一次实验更有针对性。
04 / 有些补丁的价值,是让计算重新可信
性能优化还会遇到更隐蔽的情况:程序跑完了,输出也有了,但数值误差改变了结果。
官方介绍的分工是:人设定目标和约束、审查关键改动;Agent 分析、改代码和跑实验。
Flash Linear Attention 的 PR #1180 提供了一个可以直接查看的实例。它针对上下文并行中的仿射链计算,引入可选的 tf32x3 精度路径,以缓解长上下文中的误差累积,并补充了多 GPU 测试。
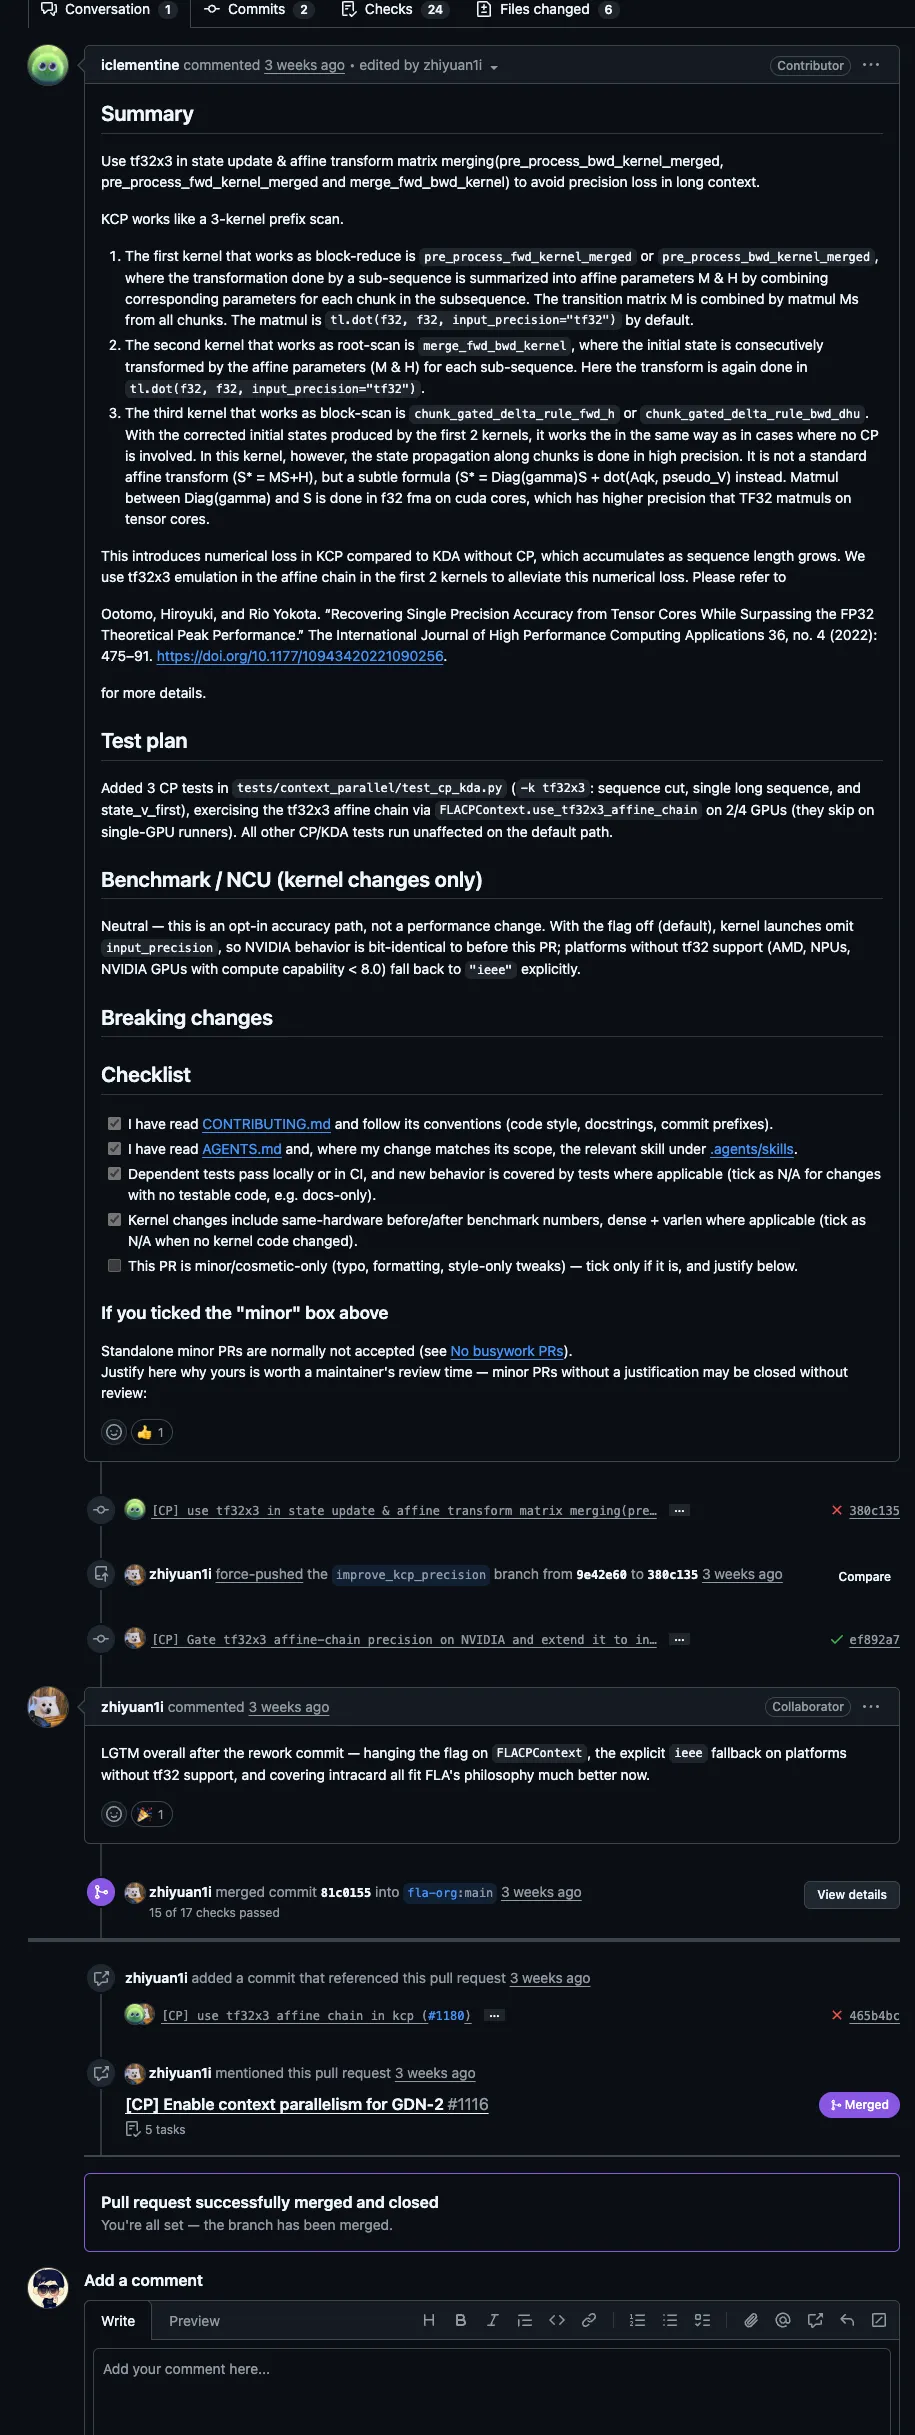
这个 PR 的说明很克制:它是可选的精度修复路径,并未宣称性能提升;默认路径保持不变,不支持 TF32 的平台有对应回退。
这类改动提醒我们,评价一个 Agent 的工作,不能只统计“它让多少函数变快”。
如果一个优化把错误结果更快地交给用户,漂亮的耗时曲线没有业务意义。精度验证决定了后面的性能比较是否成立。
同样,微基准回答的是某个局部在指定条件下如何表现。把补丁放回服务后,还要面对资源竞争、请求排队、通信,以及其他模块的变化。
因此,一份值得接受的性能补丁,至少应该附带三类证据:正确性结果、局部测量、真实负载下的整体表现。这是本文建议采用的评审标准,而非对官方内部流程的完整复述。
05 / 普通团队可以先做一张“实验记录卡”
读完这个案例,最容易产生的冲动,是给 Agent 一个更大的目标:“把我们的服务也优化一下。”
更容易落地的起点,是选一个可以重复测量的问题,然后约定每次实验怎样留下证据。
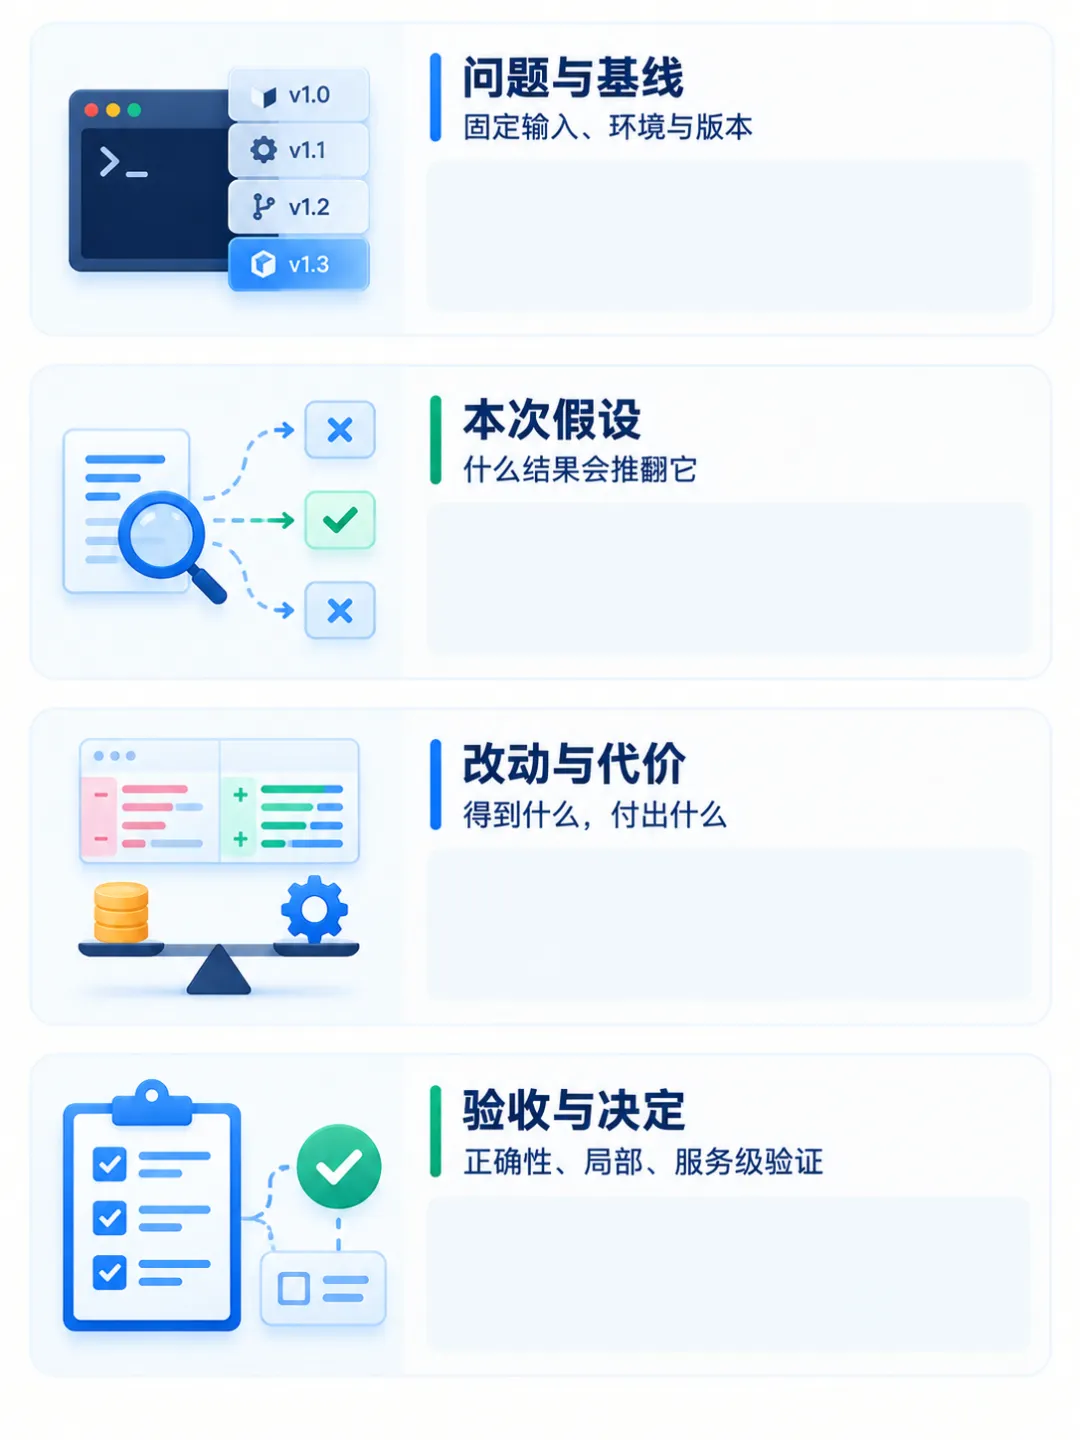
下面这张记录卡是本文建议的实践模板,可用于推理服务,也可用于接口、数据库查询和批处理任务。
问题与基线
写明哪种输入、哪个版本、什么硬件和并发条件下出现问题。保留运行命令与原始结果,让另一位工程师能够重跑。
本次假设
只写这次准备验证的因果关系。例如:“某段等待可能来自锁竞争。”随后说明准备观察什么,以及什么结果会推翻这个判断。
改动与代价
记录改了哪里,也记录增加了什么成本:更多内存、更高通信量、更复杂的同步,或者更长的构建时间。
验收与决定
先确认结果正确,再比较性能。局部有效的补丁继续接受服务级验证;记录适用条件、失败场景,以及最终保留还是撤回。
这会改变人与 Agent 之间的协作方式。
人可以把注意力放在目标是否值得做、测试是否覆盖真实业务,以及系统能承受哪些代价上。Agent 每提交一次修改,也同时提交一次可以检查的实验。
逐渐积累下来的,不只是代码,还有一份团队能够接手的优化档案:试过什么、为什么保留、在哪里失效。
下一次让 AI 优化服务时,可以在需求里加上一句:请同时交付能够复现这次收益的实验记录。
这句话,会让“优化好了”变成一个可以认真评审的工程结论。