ARTICLE · 1040945
动手把Ai装进手机,来不来?
动手把Ai装进手机,来不来?
无论你在用豆包,Deepseek还是GPT,Claude,我们每天都在聊天框里向 AI 提问。但按下“发送”以后,这句话去了哪里? 平时我们提出的问题通常会通过网络发往AI服务商的数据中心,由服务器上的模型处理,再把结果传回手机。 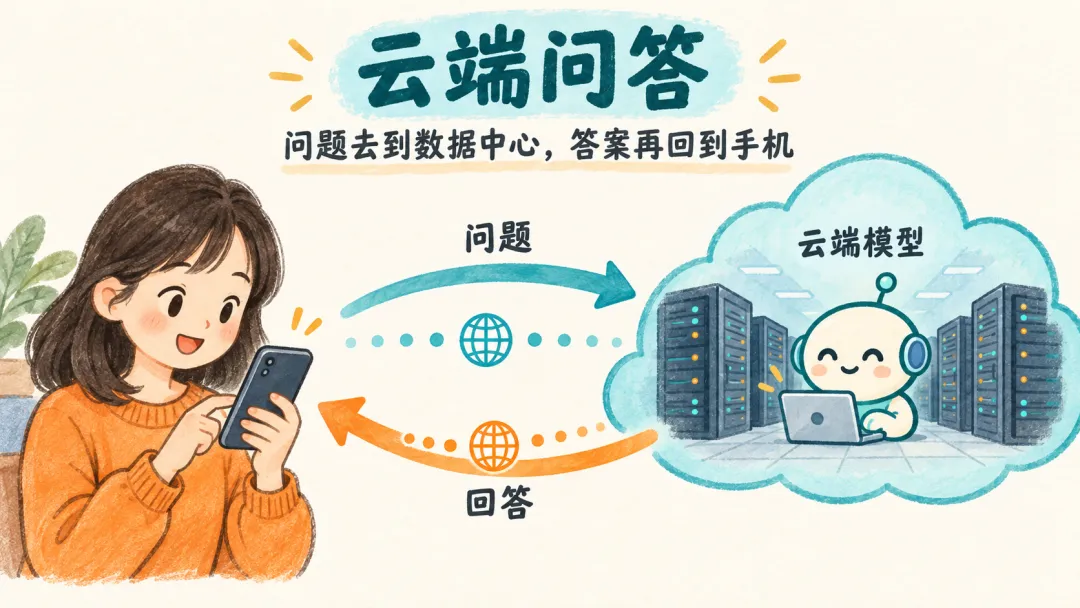
今天我们要动手尝试把一个大模型装进手机,调用本地的算力,亲手完成一次问答。 相信你会切身了解到,聊天框只是入口,真正处理问题的,是背后的大模型。在动手之前我们先来了解一些Ai工作的流程知识。 平时使用 ChatGPT、Gemini 等服务,问题通常会通过网络发往数据中心,由服务器上的模型处理,再把结果传回手机。 但模型不一定只能放在远方的服务器里。经过压缩和适配后,一些较小的模型也可以直接保存在手机中,由手机自己的 CPU、GPU 和内存完成计算。 这叫作“设备端 AI”或“本地推理”。“推理”在这里不是专指逻辑题,而是指模型使用已经学到的参数,根据输入生成结果。 云端问答是“手机把问题送出去,再收回答”;端侧问答则是“问题、模型和计算都留在手机里”。这两种方式背后的生成原理一致,运行地点和可用资源却很不一样。 为什么需要端侧Ai?所有数据可以在本地处理,保证隐私数据安全,同时可以在断网的环境下运行,打消的在飞机或者荒岛上的无聊时光。 要在手机上动手部署大模型,大概分为三个流程: 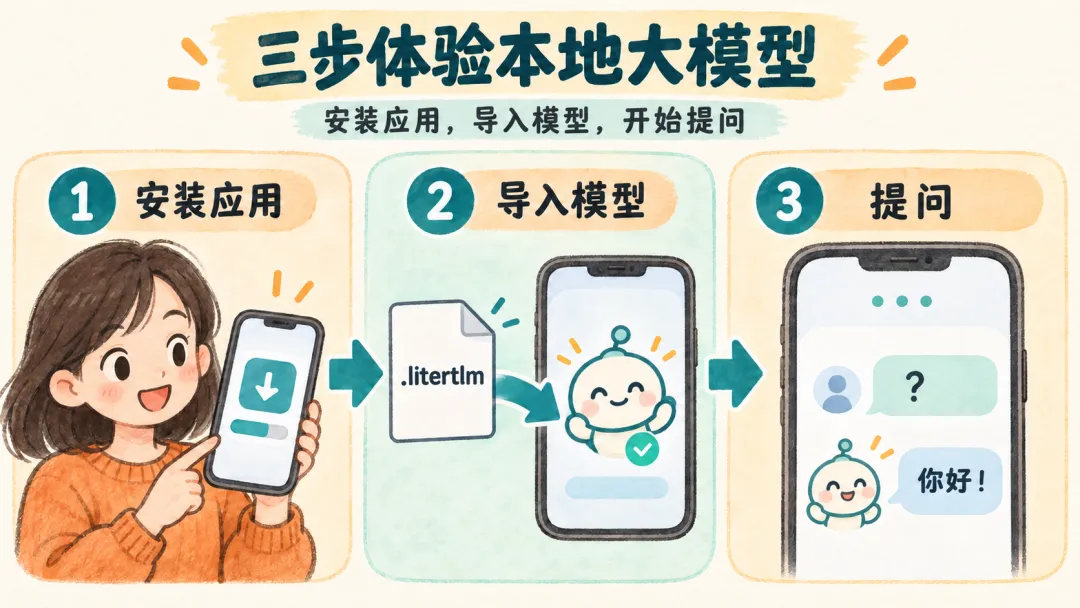
Ai客户端像工作台,负责接收文字、管理模型和显示答案;底层有运行模型的引擎,负责把模型交给手机的 CPU、GPU 等硬件执行; 模型文件像保存下来的“大脑”,里面装着模型结构、参数和运行所需资源; 手机芯片和内存提供真正完成计算的“体力”。 把大模型称为“大脑”,说的是它在这套系统中承担理解输入、计算和生成回答的核心角色。 假设我们输入:今天天气怎么样? 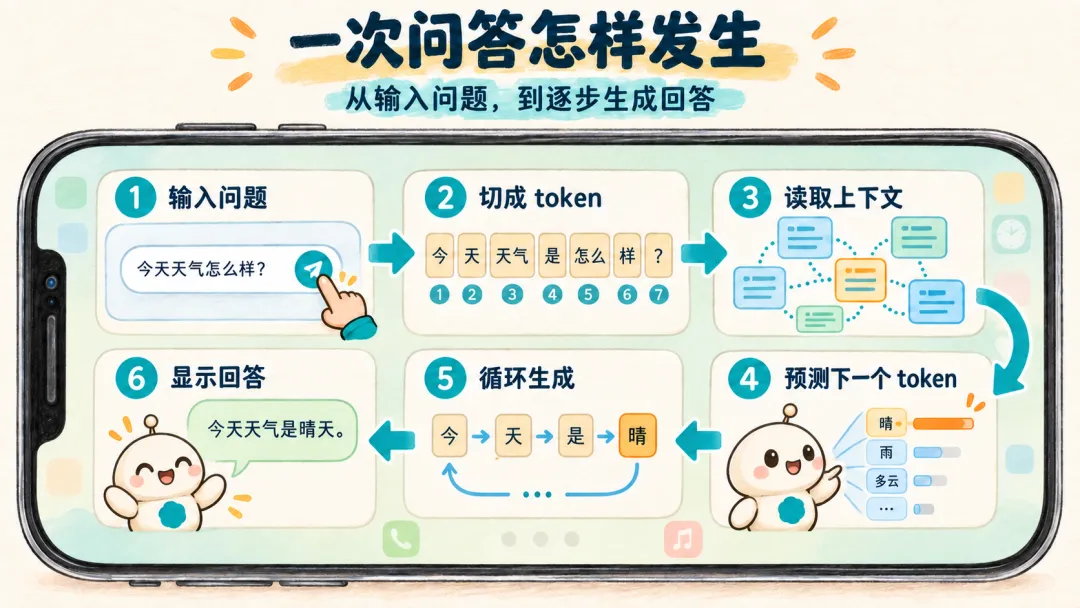
手机里运行的流程可以简化成六步: 第一步:接收问题。客户端App 读取我们输入的文字,并按模型需要的对话格式整理它。 第二步:切成 token(中文名:词元)。模型不会直接看到完整句子。文字会被转换成一串 token,也就是模型能够处理的编号。一个 token 可能是一个字、词的一部分、标点或其他片段。 第三步:理解上下文。模型读取这些 token,结合前面的对话,计算它们之间的关系。[2] 第四步:预测下一个 token。模型不会先在内部写好整段答案。它会计算:在当前上下文之后,哪些 token 更可能出现,再按照设定选择其中一个。 第五步:不断重复。新 token 被接到已有内容后面,模型再预测下一个。这个 decode 过程循环进行,于是回答像打字一样逐步出现在屏幕上。 第六步:还原成文字。token 被转换回我们能读懂的文字,由 App 显示出来。 因此,大语言模型最基础的生成方式,可以概括成一句话: 读懂已有上下文,反复预测接下来最合适的 token。 “预测下一个”听起来很简单,但模型在训练中调整了海量参数,学到语言、知识和任务模式之间复杂的关联。流畅的回答来自这些关联的共同作用,不是从资料库里原样找出一段固定答案。 本地模型的好处很直观:没有网络也能使用,响应不必往返服务器,输入可以留在设备上。对于私人草稿、离线环境和设备端功能,这很有吸引力。 代价也同样明显:手机的内存、算力和电量都有限,小模型的知识与复杂任务能力通常不及大型云端模型;长对话会占用更多内存,持续运行还可能让设备发热、耗电。 而且,“在本地运行”不等于“回答一定正确”。模型仍然可能误解问题、编造事实,或者给出已经过时的信息。重要内容依然需要核查。 1、准备文件: iPhone:从 App Store 安装Google AI Edge Gallery; Android(安卓):安装文末提供的 APK,或从项目官方发布页获取最新版:https://github.com/google-ai-edge/gallery 华为:尝试使用卓易通安装AI Edge Gallery(未测试) 模型文件:可以使用文末提供的模型文件。如果安装AI Edge Gallery后网络可行直接在App里下载官方推荐的模型(可能需要代理访问)。如果网络下载不了,有网络条件也可以访问抱抱脸探索最新适合手机的模型https://huggingface.co/litert-community 2、导入本地模型: 打开 AI Edge Gallery,进入右上角菜单,点击模型; 点击右下角或者右上角的“+” 选择从本地模型文件导入 在系统文件选择器中找到 .litertlm 文件 先保留推荐参数,建议硬件选择勾选GPU;如果只做文字聊天,不要额外勾选未经确认的图片或音频能力 点击 Import,等待模型出现在列表中 3、测试 回到主页面点击AI Chat,滑到最下方选择刚刚导入的模型开始对话。 部署演示 关掉网络再试一次。现在,假如你是鲁滨逊,你来到了一个荒岛,你可以开始用它给你一些求生建议了。 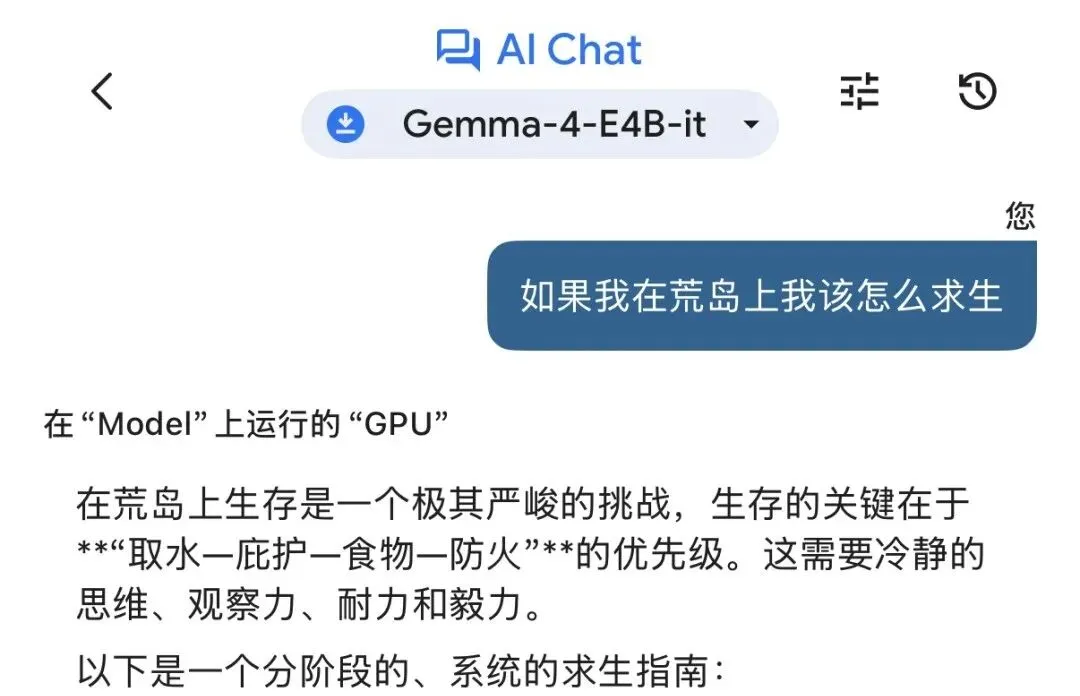
本期体验资源: iPhone:App Store 搜索 Google AI Edge Gallery Android(安卓) APK 与两个模型:百度网盘 LLM 共享文件夹|提取码:1234 推荐模型:gemma-4-E2B-it.litertlm|约 2.59 GB 小体积可选模型:Qwen3-0.6B.litertlm|约 586 MB 网盘文件夹内包含 Android APK 和上述两个模型文件:
信息和软件来源
i AI · 学习 / 分享 / 交流
01 / 端侧AI 是什么?
02 / 端侧部署的流程
在手机里安装Ai客户端引用 把适合手机运行的模型文件导入应用 测试和运行
03 / 一次问答,在手机里走过了什么?
04 / 本地模型的局限
06 / 最后动手:把大模型装进手机
关注
重播 分享 赞
链接: https://yun.139.com/shareweb/#/w/i/2xTrFp0vToGba 提取码:b94z 复制内容打开中国移动云盘手机APP,操作更方便哦
[1] Google AI Edge Gallery:项目主页。功能、平台要求、离线运行说明与官方安装入口。
[2] Google AI Edge LiteRT-LM:Engine 接口说明;运行与性能说明。tokenizer、prefill、decode 与 CPU/GPU 后端。
[3] Google DeepMind:Gemma 4 模型卡片。模型定位、参数、模态与设备端说明。
[4] Google AI Edge Gallery:Android 1.0.14 模型清单。Gemma 4 E2B 文件大小、最低设备内存、默认配置及 Android 定位。
[5] LiteRT Community:Qwen3-0.6B。各 LiteRT-LM 文件的体积、量化方式、上下文长度与适用平台。
[6] Google AI Edge Gallery:导入本地模型。本地 .litertlm 文件导入步骤。
[7] Google AI Edge Gallery:iOS 模型清单。当前公开列出的 iOS 模型与最低内存要求。