ARTICLE · 1043778
AI 编程工具全景指南:从工具选型到全流程实战
🎯 学习目标
今天的目标是让你从"被各种 AI 编程工具的名字绕晕",变成"能根据自己的场景做正确选型"的人。具体来说,你要掌握以下七件事:
理解当前 AI 编程工具的全局格局,分清开源与商业两条路线的本质区别,认识国内外主流工具的定位。
掌握 AI 编程工具底层模型调用机制,知道如何接入 OpenAI、Claude、DeepSeek、通义千问等模型,以及如何配置本地 Ollama。
了解免费 AI API 的获取途径与调用方法,学会安装和配置 LiteLLM、FreeLLMAPI、Ollama、vLLM 等开源工具。
掌握把一个功能从需求、规划、设计、开发、测试到代码审计的完整 AI 协作流程。
理解多轮对话的上下文管理策略,避免"说着说着就忘了"。
掌握选型四条件(数据驻留、成本、审计、模型自由)和省钱实战技巧。
解决 PowerShell 中文乱码等常见环境问题。
到今天结束,你不应该只是"听说过这些工具",而应该真正装好并跑通其中至少一个,并且能说清楚"我为什么选它"。
📖 第一部分:AI 编程工具的格局
2.1 两条路线:开源 vs 商业
过去两年,AI 编程工具从"Cursor 一家独大"演变为"群雄并起"。截至 2026 年,市场上活跃着超过 30 款工具,理解这个格局的关键不是背名字,而是抓住两条路线。
开源路线强调"代码可审查、可自托管、模型自由、数据不出本地"。代表工具包括 Cline、Aider、OpenHands、OpenCode 等。
商业路线强调"开箱即用、体验打磨好、代码库索引强、有官方支持"。代表工具包括 Cursor、GitHub Copilot、Windsurf、Claude Code 等。
理解这个分水岭,是一切判断的地基。
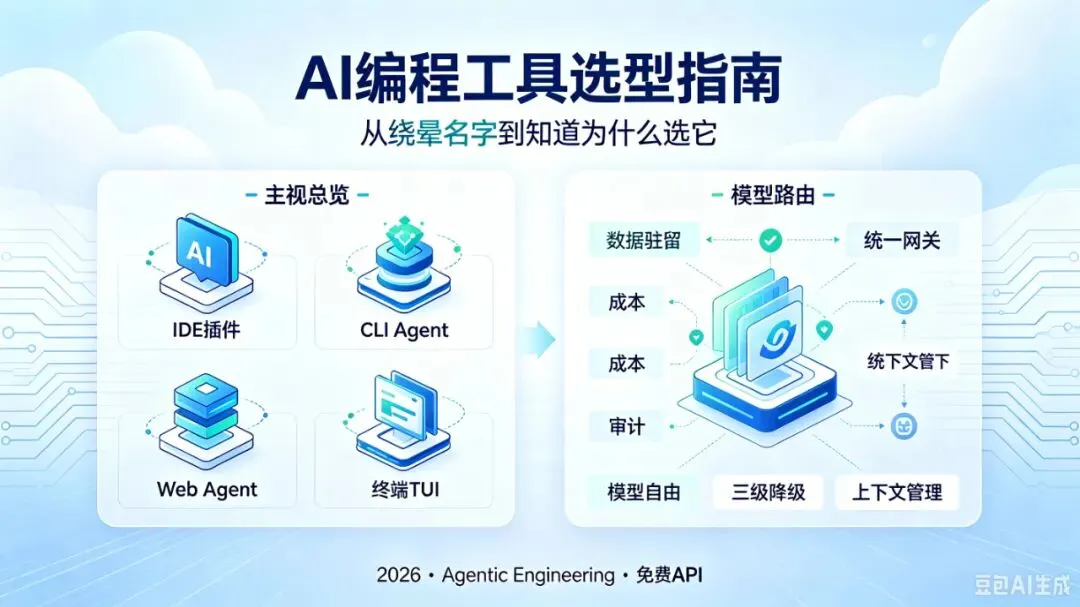
2.2 四类形态:你和 AI 怎么协作
工具形态决定了"你和 AI 怎么协作":
| 形态 | 代表工具 | 协作方式 | 适合场景 |
|---|---|---|---|
| IDE 插件 | Cursor、Windsurf、Copilot、Cline、Roo Code | 我在写、AI 帮我补全 | 日常编码、交互式开发 |
| 独立 CLI | Claude Code、Gemini CLI、Aider、OpenCode | 我下指令、AI 自己干 | 自动化、远程服务器 |
| Web Agent | OpenHands | AI 像"远程实习生"自主工作 | 复杂多步骤任务 |
| 终端 TUI | OpenCode | 终端里提供类 IDE 交互 | 轻量开发、服务器环境 |
💡 关键理解
IDE 插件适合"我在写、AI 帮我补全";CLI Agent 适合"我下指令、AI 自己干完一整件事"。这直接对应你后面要养成的两种工作流。
🔍 第二部分:主流工具横向对比
3.1 国外主流工具
| 工具 | 定位 | 核心特点 | 适合人群 |
|---|---|---|---|
| Cursor | AI-First IDE | 内置 AI 聊天和内联编辑,最好的上下文感知能力,支持远程模型和本地 Ollama。Pro $20/月 | 想要最好的开箱即用体验、愿意付费追求效率的开发者 |
| GitHub Copilot | 代码补全工具 | 依托 GitHub 海量代码训练,补全质量高,与 VS Code / JetBrains 深度集成。$10/月 | 已在用 VS Code、主要写 Web 前后端代码的开发者 |
| Claude Code | CLI 工具 | Anthropic 官方,主打深度推理和高质量代码,支持 MCP 协议 | 喜欢终端工作、追求代码质量的开发者 |
| Windsurf | AI IDE | Codeium 出品,Cascade 超级代理,免费使用(截至 2026 年) | 预算有限、想要免费工具又不想要简陋体验的开发者 |
| Gemini CLI | CLI 工具 | Google 官方,深度集成 Gemini 模型,免费额度高 | 在 Google 生态内的开发者 |
3.2 国内主流工具
| 工具 | 出品方 | 核心特点 | 适合人群 |
|---|---|---|---|
| TRAE | 字节跳动 | 国内首款 AI 原生 IDE,基于 VS Code 同源架构。基础版免费,内置 Doubao、DeepSeek、Kimi、Qwen、GLM 等多款主流大模型,模型切换无需额外配置。中文需求理解准确率高,企业版支持私有化部署 | 国内开发者、对数据安全有要求的企业团队 |
| 通义灵码 | 阿里 | 默认使用通义千问 Qwen-Coder 模型,支持切换到 Qwen 系列其他模型。提供智能问答、文件编辑和智能体三种模式 | 国内开发者、阿里云生态用户 |
| CodeBuddy | 腾讯 | 默认使用混元模型,支持切换。与腾讯云生态集成较好 | 腾讯云生态用户 |
| 文心快码 Comate | 百度 | 默认使用文心一言 ERNIE 模型,支持切换 | 百度生态用户 |
3.3 开源工具
| 工具 | 形态 | 核心特点 | 适合场景 |
|---|---|---|---|
| Cline | VS Code 插件 | 完全开源(Apache 2.0),支持任意 LLM,内置文件操作、终端执行、浏览器自动化,支持 MCP | 数据敏感场景的首选,可完全本地运行 |
| Aider | CLI | 通过 git diff 工作,每次修改有版本记录,擅长"小步快跑"式代码改进 | 已有代码库、需要精准修改的开发者 |
| OpenHands | Web Agent | AI Agent 框架,内置浏览器操作、代码执行、API 调用,支持循环反思 | 自动化测试、批量重构等复杂任务 |
| OpenCode | 终端 TUI | 支持 Plan 和 Build 两种模式,provider 无关,可使用任意模型 API | 服务器端轻量开发 |
⚙️ 第三部分:模型调用与配置
4.1 底层模型的三大阵营
现在绝大多数编程助手都支持手动切换底层模型,不再"绑死"一家。底层模型可以分成三大阵营:
| 阵营 | 代表模型 | 特点 |
|---|---|---|
| 海外闭源 | GPT(OpenAI)、Claude(Anthropic)、Gemini(Google) | 编程能力最强梯队,价格偏高 |
| 国产开源/闭源 | DeepSeek、通义千问 Qwen、豆包、文心、GLM | 性价比高,中文场景好,编程能力快速追赶 |
| 专用代码模型 | DeepSeek-Coder、Qwen-Coder、CodeGeeX | 专为代码训练,补全/生成更精准、更便宜 |
4.2 如何配置模型调用
方式一:使用 OpenRouter 聚合服务(推荐新手)
OpenRouter 聚合了多家模型提供商,一个 API Key 就能切换 DeepSeek、Qwen、Claude 等模型。在 Cline 设置中选择 API Provider 为 OpenRouter,填入 API Key,然后选择模型:
{
  "cline.apiProvider": "openrouter",
  "cline.openRouterModelId": "deepseek/deepseek-chat"
}
方式二:使用本地 Ollama
在 Cline 设置中选择 API Provider 为 Ollama,配置本地端点,数据完全不出本机,零 API 费用:
{
  "cline.apiProvider": "ollama",
  "cline.ollamaBaseUrl": "http://localhost:11434",
  "cline.ollamaModelId": "deepseek-r1:7b"
}
方式三:使用 GitHub Models(免信用卡)
拥有 GitHub 账号即可使用,模型由 Azure OpenAI Service 提供,无需额外门槛。免费版限制为每分钟 15 次、每日 150 次请求。通过 OpenAI SDK 直接调用:
import OpenAI from "openai";

const openai = new OpenAI({
  baseURL: "https://models.github.ai/inference",
  apiKey: process.env.GITHUB_TOKEN // 使用 GitHub PAT
});

const res = await openai.chat.completions.create({
  model: "openai/gpt-4o",
  messages: [{ role: "user", content: "Hi!" }]
});
GitHub Models 兼容 OpenAI 的 chat/completions API,任何接受 baseURL 的客户端都能直接使用,包括 OpenAI SDK、LangChain、llama.cpp 等。
Cursor 的模型路由功能
Cursor 支持 Auto 模式自动选择模型,有三种优化模式——Cost(省钱优先)、Balance(平衡)、Intelligence(质量优先)。日常小任务用 Cost 模式,复杂任务切 Intelligence 模式。
🆓 第四部分:免费 AI API 全攻略
5.1 主要厂商免费额度一览
| 厂商 | 免费额度 | 速率限制 | 是否需要信用卡 |
|---|---|---|---|
| Google Gemini | 免费层永久可用,额度每日重置 | 60 RPM | 否 |
| Groq Cloud | 永久免费层,极速推理 | 30 RPM / 1,000 TPM | 否 |
| 智谱 AI (GLM) | GLM-4-Flash 模型长期免费 | 有独立并发限制 | 否 |
| 硅基流动 | 0 元模型矩阵(bge 向量/重排、OCR 等) | 视模型而定 | 否 |
| 通义千问 | 每月 100 万 Token,长期有效 | 因模型而异 | 否 |
| DeepSeek | 注册送 500 万 Token(30 天有效) | 60 RPM | 否 |
| GitHub Models | 免费层,模型由 Azure OpenAI 提供 | 15 次/分钟,150 次/日 | 否(只需 GitHub 账号) |
| Cloudflare Workers AI | 每天 1 万次免费推理 | 300 RPM | 否 |
| OpenRouter | 50 次/天(充值 $10 后 1,000 次/天) | 视模型而定 | 否 |
5.2 如何安装和调用免费 API
以 Groq 为例:注册即用
访问
console.groq.com,注册账号(只需邮箱,无需信用卡)。在控制台创建 API Key。
在 Cline 或任何支持 OpenAI 兼容 API 的工具中配置:
{
  "cline.apiProvider": "openai",
  "cline.openAiBaseUrl": "https://api.groq.com/openai/v1",
  "cline.openAiApiKey": "gsk_你的密钥",
  "cline.openAiModelId": "llama-3.3-70b-versatile"
}
以 GitHub Models 为例:GitHub 账号直接调用
生成 GitHub Personal Access Token(PAT),授予
models:read权限。使用 OpenAI SDK 调用:
from openai import OpenAI

client = OpenAI(
    base_url="https://models.github.ai/inference",
    api_key="你的_GITHUB_PAT"
)

response = client.chat.completions.create(
    model="openai/gpt-4o",
    messages=[{"role": "user", "content": "Hello"}]
)
print(response.choices[0].message.content)
以 Ollama 本地 API 为例:零成本、数据不出本机
安装 Ollama(访问
ollama.com下载对应平台安装包)。拉取模型并启动:
ollama pull deepseek-r1:7b
ollama serve
调用本地 API(OpenAI 兼容):
from openai import OpenAI

client = OpenAI(
    base_url='http://localhost:11434/v1/',
    api_key='ollama',  # 必填但会被忽略
)

chat_completion = client.chat.completions.create(
    messages=[{'role': 'user', 'content': 'Say this is a test'}],
    model='deepseek-r1:7b',
)
print(chat_completion.choices[0].message.content)
Ollama 支持 OpenAI API 的子集,包括 /v1/chat/completions 和 /v1/responses 端点,任何兼容 OpenAI 的客户端库都可以直接连接[reference:1]。
5.3 社区聚合平台:一个接口调用多家免费额度
FreeLLMAPI 是一个开源项目,把 34 家提供方的免费额度聚合到单个 OpenAI 兼容端点,每月约 74 亿 Token。路由器为每个请求挑选当前可用的最佳模型,某家提供方触发限流时自动转移到下一家。
安装与配置:
# 克隆项目
git clone https://github.com/tashfeenahmed/freellmapi.git
cd freellmapi

# 安装依赖并启动
npm install
npm run start

# 访问 http://localhost:3000 配置各平台 API Key
启动后,将任意 OpenAI 客户端指向 http://localhost:3000/v1 即可,FreeLLMAPI 会自动在你添加过密钥的提供方之间透明路由。
awesome-freellm-apis 是一个 GitHub 情报库,维护了 482+ 个免费 LLM API(来自 31 家提供商),提供一键配置脚本,支持 Claude Code、Cursor、Codex、Aider 等 10+ 工具。数据每日自动更新,确保你不会用到已经失效的免费额度。
🔧 第五部分:开源 API 工具链
开源 AI API 工具生态可以按位置分成模型服务层和网关聚合层两类。模型服务层负责把模型跑起来并提供 API,网关聚合层则把多个模型服务统一成一个入口。
6.1 模型服务层:把模型跑成 API
Ollama:个人电脑上的快速原型
安装简单,提供 OpenAI 兼容 API,适合个人电脑或小规模场景。安装后一条命令即可拉取并运行模型:
# 安装(macOS / Linux)
curl -fsSL https://ollama.com/install.sh | sh

# 拉取并运行模型
ollama run deepseek-r1:7b

# 验证 API
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-r1:7b", "messages": [{"role": "user", "content": "Hello"}]}'
vLLM:GPU 服务器上的生产级部署
适合 GPU 服务器部署,提供高性能的 OpenAI 兼容 API,支持 Chat Completions、Embeddings 等端点。安装与启动:
# 使用 uv 安装(推荐)
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto

# 启动 OpenAI 兼容服务器
vllm serve NousResearch/Meta-Llama-3-8B-Instruct \
  --host 0.0.0.0 --port 8000
启动后,任何 OpenAI 客户端都可以连接到 http://localhost:8000/v1 调用模型[reference:5]。
6.2 网关聚合层:统一管理多个模型入口
LiteLLM:最广泛采用的统一网关
MIT 协议,支持 140+ 提供商和 1800+ 模型,通过统一的 OpenAI 兼容 API 暴露出去。提供虚拟 Key、预算控制和管理界面。
安装与配置:
# 安装(基础库)
pip install litellm

# 安装代理服务(带 UI 管理界面)
pip install 'litellm[proxy]'

# 创建配置文件 litellm_config.yaml
cat > litellm_config.yaml << 'EOF'
model_list:
  - model_name: deepseek-chat
    litellm_params:
      model: deepseek/deepseek-chat
      api_key: sk-你的DeepSeek密钥
  - model_name: groq-llama
    litellm_params:
      model: groq/llama-3.3-70b-versatile
      api_key: gsk_你的Groq密钥
  - model_name: local-ollama
    litellm_params:
      model: ollama/deepseek-r1:7b
      api_base: http://localhost:11434
EOF

# 启动代理
litellm --config litellm_config.yaml --port 4000
启动后,将任意 OpenAI 客户端指向 http://localhost:4000/v1,即可通过统一的 API 调用所有配置的模型[reference:6]。
Bifrost:高性能 Go 网关
Go 写的高性能网关,声称吞吐量约为 LiteLLM 的 50 倍,支持自适应负载均衡、集群模式和 MCP,零配置即可通过 Docker 启动,文档中明确支持 Ollama 本地模型。
One API / New API:中转与计费
支持多模型统一入口、额度管理和令牌分发,MIT 协议,部署轻量(默认 SQLite),适合需要对外提供 API 服务或做内部计费的场景。
💡 工具链选择建议
个人开发者,想在本地跑模型练手:从 Ollama 开始,需要更高性能或生产部署时再切到 vLLM。
需要在一个应用里调用多个云端模型:LiteLLM 是最稳妥的默认选择,生态最广、文档最全。
团队已有 API 网关基础设施:直接评估 Apache APISIX 或 Kong AI Gateway 的 AI 插件能力。
需要自建 API 服务平台,带计费和额度管理:One API / New API 是针对性最强的选择。
🔄 第六部分:AI 编程全流程实战
7.1 从"Vibe Coding"到"Agentic Engineering"
传统 Vibe Coding 的方式是:打开 AI 对话框,用自然语言描述需求,让模型直接生成代码,跑通就算完。原型验证很爽,但一旦要上生产,问题就来了——生成的代码质量不可控、没有审查流程。本质上,Vibe Coding 是"提示即祈祷"。
更成熟的做法是Agentic Engineering(智能体工程):人负责定义目标、约束条件和质量标准,AI 作为自主智能体在结构化流程中执行规划、编码、测试和迭代,每个关键节点都有人工审核。
7.2 全流程拆解
| 阶段 | 你做什么 | AI 做什么 | 推荐工具 |
|---|---|---|---|
| ① 需求创建 | 口述需求 | — | — |
| ② 需求澄清 | 回答 2-3 个关键问题 | 反向提问,确认边界条件 | Skill: /grill-with-docs |
| ③ 制定计划 | 审核计划 | 拆解为小的、可验证的任务 | Plan 模式 |
| ④ 并行开发 | 几乎无需干预 | 按计划逐块实现 | Cline / Claude Code |
| ⑤ 代码自审 | 审核报告 | 运行代码评审,检查冗余和劣质代码 | Skill: /review |
| ⑥ 编译部署 | 确认部署参数 | 执行编译和部署 | CLI 工具 |
| ⑦ 测试验证 | 手动触发测试 | 自动跑测试,输出结果 | OpenHands |
| ⑧ 创建 MR | 确认 MR 信息 | 生成 MR 描述 | /create-mr |
| ⑨ AI 辅助评审 | 审核 AI 评审意见 | 对代码差异做精细化校验 | Skill: /review-mr |
| ⑩ 合入发布 | 点 Merge | — | CI/CD |
以需求澄清阶段为例,平常我们用 AI 的方式是"我提需求 → AI 开始写"。引入 Skill 后会变成"我提需求 → AI 反过来问我 → 把边界确认清楚 → 再开始写"。
比如你说"做一个用户批量导入功能",它可能追问:支持 CSV 还是 Excel?重复用户覆盖还是跳过?100 条失败 1 条,是整体回滚还是部分成功?最大支持多少数据?同步还是异步?这些东西,恰恰才是一个需求最容易返工的地方。
🧠 第七部分:多轮对话与上下文管理
8.1 为什么 AI 会"说着说着就忘了"
多轮对话里最常遇到的问题:AI 忘记了早期决策,重复犯错,自相矛盾。社区把这种现象叫做 Context Window Decay(上下文窗口衰减)。
根本原因有两个:一是会话过长时早期内容会被有损压缩,对话里交代过的表关系、开发规则容易在压缩中丢失;二是超长上下文下模型注意力稀释,输出质量会下降。
有开发者实测:上下文用到 250k 时,模型明显失忆,让其记住的表关联关系和要遵循的开发规则全忘了,生成的代码质量极差。AI 编程代理每次调用工具,原始数据是全量输入上下文的。一个包含 20 次工具调用的简单任务,50 轮对话后,光工具输出就向模型灌入了 30 MB 的 token。等你跑到 30 分钟的时候,上下文窗口已经有 40% 被这些原始数据占满了[reference:7]。
8.2 五条实用策略
① 一个任务一个会话
上下文到 100k~150k 就开新会话,先把结论沉淀到规则/记忆再切。编辑器卡顿也是长会话导致的,开新会话即可缓解。
② 善用规则文件
把表关联关系、开发规范写进项目规则文件(如 .cursorrules、.claudeignore),这些内容不会被压缩丢失,比在对话里说更可靠。
③ 分层上下文预算
一个好的上下文管理策略应该分层——系统指令(项目规范)、工作记忆(当前文件)、RAG 检索(相关代码段)、工具反馈(编译输出)、对话历史(滑动窗口)。
④ 重要决策及时沉淀
使用 wayfinder 这类工具维护一张跨会话共享的地图,用 handoff 在会话之间交接上下文。AgentScaffold 等框架也支持"plans that span multiple sessions",让持久化的发现、决策和状态在上下文重置后依然存活。
⑤ 用工具压缩上下文
context-mode 是一个 MCP 服务器,在代理与工具之间加了一层中间件。代码在隔离子进程中运行,只把 stdout 的结论送进上下文,原始数据全部拦在门外。实测可砍掉 98% 的上下文浪费[reference:8]。
💰 第八部分:如何省钱
9.1 Token 到底浪费在哪
很多人以为省钱就是"选便宜的模型",这想法本身最费钱。真正烧钱的从来不是单价,而是无效消耗:
上下文冗余:把整个文件几百行贴进对话框,AI 反复读你根本没改过的代码
方向跑偏返工:需求没想清楚就开干,写了一半发现不对,推倒重来
重复交代:每个新会话都从头介绍"我是做前端的、技术栈是 React"
一个真实的翻车案例:前端 bug 修复时直接把整个组件文件贴进去,来回试错改了七八轮,花了一万五 token 才搞定。同一个问题,精准描述报错信息和相关函数后一次命中,不到四千 token 解决,差距接近四倍。
9.2 三级降级机制
开源工具 9Router 专门为 AI 编程工具打造智能调度中心,自带 RTK Token 节省器,自动压缩终端输出、代码差异等冗余内容,每次请求帮你节省 20-40% Token。
它的三级降级机制确保编程过程永远不会被打断:第一层(订阅层)先用已有的订阅服务,如 Claude Code、Copilot;第二层(低价层)额度用完自动切换到便宜的模型,如 GLM、MiniMax;第三层(免费层)预算用完自动切换到完全免费的模型。
9.3 Claude Code 接 DeepSeek:成本降到 1/180
Claude Code 很强,但账单也不低。以 Opus 4.7 为例,输入价格 $5/M tokens。而 DeepSeek V4-Flash 缓存命中时输入仅 $0.028/M,差了 178 倍。
配置方法:通过 ccl 或 MCC Proxy 等代理工具,把 Claude Code 的后端模型指向 DeepSeek 或 SiliconFlow 等 OpenAI 兼容格式的网关,实现超低成本运行。
9.4 日常省钱习惯
模式选择:明确的小任务用 Craft 模式(直接干),新功能/重构用 Plan 模式(先计划再干)。实测 Plan 模式至少省掉 30% 的 token
按需选择模型:简单补全用便宜的代码专用模型,复杂重构用 Claude/GPT
善用免费额度:GitHub Copilot 学生免费、Gemini CLI 免费额度、TRAE 基础版免费
及时终止跑偏任务:发现 AI 方向不对立即停止,不要让它继续消耗 token
🧩 第九部分:开源 Agent 与 Skill 生态
AI 编程助手往往会选择最短路径——跳过需求文档、测试、安全评审等关键环节。Skill 的本质是给 AI 的专项工作说明书,把资深工程师的工作流和质量门禁封装成结构化技能。
10.1 Matt Pocock 的 skills 项目
将 TDD、需求澄清、Bug 复现等经典工程实践转化为 53 个可插拔 AI 工作模块。最推荐的几个 Skill:
/grill-with-docs:写代码之前,先把需求问透。把项目里的领域术语整理到 CONTEXT.md,重要技术决策沉淀成 ADR/tdd:不是"让 AI 补测试",而是限制它怎么写。真正的 TDD 是"Red → Green → Refactor",先写一个失败测试,确认它真的失败,然后只写刚好够测试通过的代码
10.2 Addy Osmani 的 Agent Skills
覆盖软件开发生命周期六个核心阶段的 20 个技能:定义(Define)、规划(Plan)、构建(Build)、验证(Verify)、评审(Review)、发布(Ship)。
| 你要做什么 | 命令 | 核心理念 |
|---|---|---|
| 定义要构建什么 | /spec | 先写需求再写代码 |
| 规划如何构建 | /plan | 小的原子化任务 |
| 增量式构建 | /build | 一次只做一块 |
| 证明它能工作 | /test | 测试就是证明 |
| 合并前评审 | /review | 提高代码健康度 |
| 简化代码 | /code-simplify | 清晰胜过聪明 |
| 发布到生产 | /ship | 越快越安全 |
⚠️ 第十部分:常见问题与避坑指南
11.1 PowerShell 中文乱码(Windows 最高频问题)
现象:AI 生成的代码里中文变成 ?? 或方块;Python 脚本报 UnicodeDecodeError: 'gbk' codec can't decode byte;终端输出一片乱码。
根因:PowerShell 的编码冲突来自两个独立控制的变量——$OutputEncoding(管道传输编码,默认 ASCII)和 [Console]::OutputEncoding(控制台输出编码,中文 Windows 默认 GBK/CP936)。任何外部工具(git、python、node、Codex CLI 等)输出 UTF-8 文本,经过这两层转换后都会产生乱码。
临时修复(当前会话立即生效):
chcp 65001
[Console]::OutputEncoding = [System.Text.Encoding]::UTF8
$OutputEncoding = [System.Text.Encoding]::UTF8永久修复:把上面三行写入 PowerShell Profile:
notepad $PROFILE在文件末尾添加:
if ($PSEdition -eq 'Desktop') {
    chcp 65001 | Out-Null
    [Console]::OutputEncoding = [System.Text.Encoding]::UTF8
    $OutputEncoding = [System.Text.Encoding]::UTF8
}
⚠️ 注意
Codex CLI 用户需特别注意,PowerShell 7 不能解决所有场景,因为 Codex 调用的是系统内置 PowerShell 5.1 而非用户安装的 PS7。正确姿势是修改 5.1 的 Profile,而非换默认终端。
11.2 其他常见问题
| 问题 | 原因 | 解决方案 |
|---|---|---|
| 上下文过长导致模型"失忆" | 会话过长,早期内容被压缩丢失 | 到 100k~150k 时开新会话,把重要决策沉淀到规则文件 |
| AI 生成代码"看起来对,实际不对" | AI 选择最短路径,跳过验证 | 引入 TDD Skill,强制 AI 先写失败测试 |
| 需求理解偏差导致大量返工 | 需求没想清楚就开干 | 使用需求澄清 Skill,让 AI 在写代码之前先反问 |
| 免费 API 突然不可用 | 提供方调整额度或下线模型 | 使用 FreeLLMAPI 等聚合工具,自动切换到可用提供方 |
| LiteLLM 代理启动报错 | 缺少依赖或配置文件格式错误 | 确认已安装 litellm[proxy],检查 YAML 缩进 |
| Ollama 连接超时 | 服务未启动或端口被占用 | 运行 ollama serve 确认服务状态,检查 11434 端口 |
🎯 第十一部分:选型决策框架
12.1 用四条件评估
| 条件 | 核心问题 | 高敏感场景建议 | 一般场景建议 |
|---|---|---|---|
| 数据驻留 | 代码会不会发给第三方? | 选本地模型方案(Cline + Ollama) | 主流工具均可 |
| 成本 | 固定订阅还是按量? | 开源工具 + 便宜模型 | 按预算选订阅 |
| 审计 | 能否看到 AI 做了什么? | 选开源工具(日志全透明) | 商业工具也有日志 |
| 模型自由 | 能否自由切换模型? | Cline / Aider(支持任意 API) | 按需选择 |
12.2 推荐组合
✅ 组合 A:免费优先(预算 $0)
TRAE 基础版(免费、中文好、多模型)+ Cline + Ollama(本地模型处理敏感代码)+ Gemini CLI(免费额度)。适合个人开发者、学生、预算紧张的小团队。
✅ 组合 B:效率优先(预算 $20/月)
Cursor Pro 或 Claude Code + 9Router 做 Token 调度。适合全职开发者、追求效率的团队。
✅ 组合 C:企业级(预算 $50+/月)
TRAE 企业版(私有化部署)+ OpenHands(敏感代码自动化)+ 自托管 vLLM + LiteLLM 统一网关。适合有安全合规要求的组织。
✅ 组合 D:国内网络、重隐私、预算有限
VS Code + Cline,模型指向 DeepSeek 或通义千问 API。数据不出内网可选 Ollama 本地端点 + FreeLLMAPI 聚合免费额度。
📋 今日产出与关键学习
今日产出
认识了国内外 15+ 主流 AI 编程工具的定位与适用场景
理解了 AI 编程助手底层模型的三大阵营与切换方法
掌握了至少 3 种免费 AI API 的获取与调用方法(Groq、GitHub Models、Ollama)
学会了安装和配置 LiteLLM 统一网关、FreeLLMAPI 聚合平台、vLLM 模型服务
掌握了从需求到代码审计的 AI 全流程协作方法
学会了用 Skill 给 AI 注入工程纪律(需求澄清、TDD、Code Review)
掌握了多轮对话的上下文管理策略
落地了至少一套省钱方案(9Router / DeepSeek 替代 / 模式选择)
解决了 PowerShell 中文乱码问题
关键学习
Agentic Engineering:人定义目标,AI 在结构化流程中执行,关键节点人工审核
Skill:给 AI 的专项工作说明书,把工程纪律封装成可插拔模块
模型路由:按任务复杂度自动选择模型,简单任务用便宜模型,复杂任务用强模型
三级降级:订阅层 → 低价层 → 免费层,确保编程永不中断
上下文衰减:会话过长时早期内容被压缩丢失,需及时开新会话并沉淀决策
开源 API 工具链:Ollama/vLLM 提供模型服务,LiteLLM 统一网关聚合多模型,FreeLLMAPI 聚合免费额度
选型四条件:数据驻留、成本、审计、模型自由
感谢阅读!对您有帮助的话,点亮👍🏻❤️,关注公众号,转发给需要的朋友~ 原创转载请联系授权。