ARTICLE · 1047714
AI 大模型算力栈全景:从 CUDA、PyTorch、MLX 到 ggml/llama.cpp 与 Vulkan
AI 大模型算力栈全景:从 CUDA、PyTorch、MLX 到 ggml/llama.cpp 与 Vulkan
🧭
这是一篇给非专业读者也能读下去的硬核长文。规则有三条:凡是专业名词,第一次出现时一定给一句大白话解释;凡是有数字的地方,尽量给出处;凡是容易搞混的概念,都放进对照表里。
全文约 2.5 万字,建议先读第 0 章的“五层地图”,再按兴趣跳读。
序章:为什么 2026 年还要重新理解这条栈
关于大模型,过去几年绝大多数讨论都发生在最上面那一层:谁的聊天机器人更聪明、谁的上下文更长、谁的推理能力更强。但真正决定“这件事能不能跑起来、跑一次多少钱、能不能跑在你自己的电脑上”的,是下面那一整套被称为“算力栈”的东西。
这套栈在过去五年里被反复重写过。NVIDIA 在 2025 年 12 月发布 CUDA 13.1,官方称其为“自 2006 年 CUDA 诞生以来最大、最全面的升级”,核心是把 GPU 编程从“手写一个个线程”提升到“描述一块块数据”(NVIDIA 官方博客)。苹果在 2023 年 12 月开源了 MLX,一个专门为自家芯片设计的机器学习框架,把“统一内存”直接写进了数组的语义里。而一个叫 Georgi Gerganov 的保加利亚开发者,用纯 C 写了一个叫 ggml 的张量库,它的衍生项目 llama.cpp 在 2026 年 9 月已经积累了 12.9 万个 GitHub 星标,成了“在自己电脑上跑大模型”的事实标准。
这三件事看起来毫不相干,其实指向同一个问题:当硬件越来越专用、越来越碎片化时,软件到底该在哪一层做抽象?
本文试图回答这个问题,方法是把整条栈拆成五层,逐层讲清楚:每一层解决什么问题、有哪些玩家、核心原理是什么、以及它们之间到底是什么关系(很多时候是“看起来像竞争、其实是邻居”)。
0.1 一个贯穿全文的比喻:算力栈 = 一套物流系统
为了让非专业读者能跟上,全文会反复使用这个类比。
想象你要把一批货物(数据)从仓库(内存)运到工厂(计算单元),加工后再运回来。
GPU 硬件是工厂里的机器和流水线。 CUDA / Metal / Vulkan 是操作这些机器的“工作手册”和“叉车驾驶证”——它们规定了你能对机器下达哪些指令。 cuBLAS / MPS 这类数学库,是厂家已经帮你调好的标准化作业流程,比如“搬 1000 箱货最快的走法”。 PyTorch / MLX 是调度中心:你只要说“我要把这批货加工成这样”,它负责拆解成具体的搬运和加工步骤。 ggml / llama.cpp / vLLM 是末端配送:它们不再关心你怎么训练,只关心“把这件已经做好的商品,用最低成本送到用户手上”。
这个类比能解释很多事。比如为什么 PyTorch 装起来有几百 MB 而 llama.cpp 编译出来不到 1 MB——前者是全套调度中心加仓库管理系统,后者只是一条配送路线。再比如为什么苹果能在本地推理上做得很好:它的工厂和仓库在同一栋楼里(统一内存),根本不用卡车。
0.2 五层地图:先建立坐标系
下面这张表是全文的骨架。建议先扫一遍,后面每一章都是在填其中一格。
需要立刻澄清一个常见误解:**这五层不是严格上下叠的,同一项技术常常横跨好几层。**CUDA 既是 L1 的编程模型,又自带 L2 的 cuBLAS/cuDNN;MLX 同时覆盖了 L3 的 API、L4 的惰性求值与 L1 的 Metal 内核;llama.cpp 身上的 ggml 既是 L2 的算子库,也是 L4 的计算图,还是 L5 的运行时。
理解“横跨”这件事,是理解整个生态的关键。因为过去五年真正发生的事情是:每一层都在试图向上或向下伸手,去抢相邻层的活。
0.3 阅读约定
专业名词第一次出现时会用「」标出,并紧跟一句大白话解释。 涉及数字的部分尽量标注口径与出处,出处链接统一放在文末“参考来源”,正文里也会就近给出。 文中所有 GitHub 星标数据,均为 2026 年 9 月 20 日通过 GitHub API 实测获取,会随时间变化。 文中出现的性能数字都附带测试条件,请勿脱离条件直接横向比较。
第一章 硬件与设备抽象层:三种截然不同的世界观
这一章讲 L1 层,也就是“你用什么语言指挥 GPU”。这是整条栈里最底层的软件,也是最难被替代的一层——因为它直接绑定硬件厂商。
这一层上有三个主要玩家:NVIDIA 的 CUDA、苹果的 Metal、Khronos 的 Vulkan。它们不是同一个东西的三种实现,而是三种世界观——对“GPU 到底是什么、程序员该怎么用它”给出了完全不同的答案。
1.1 NVIDIA CUDA:把显卡变成通用计算机的第一次成功
1.1.1 为什么 2006 年是关键分水岭
在 2006 年之前,GPU 只能画三角形。一块 GPU 内部是两条互不相通的流水线:一条处理顶点(图形的位置),一条处理像素(图形的颜色)。如果你想用 GPU 做科学计算,你得把自己的问题伪装成“画图”——用 OpenGL 这类图形 API 把矩阵运算包装成渲染任务。这就像为了寄一封信,非得把它塞进电视信号里播出去。
2006 年 11 月,NVIDIA 在 GeForce 8800 GTX 上推出了 G80 架构,做了两件事。第一,把顶点着色器和像素着色器统一成一个可编程的通用处理器池(128 个流处理器),从此 GPU 不再“只会画图”,而是“什么都能算”。第二,同步发布 CUDA(Compute Unified Device Architecture,统一计算设备架构),让开发者可以用类 C 语言直接写跑在 GPU 上的程序,不用再借道图形 API。
用我们的物流比喻:在此之前,GPU 是一条只能加工画作的专用流水线;在此之后,它变成了一座通用工厂,而且 NVIDIA 还给所有工人发了一本能直接读懂的操作手册。
顺便说一句,CUDA 在商业上并不是一开始就成功的。黄仁勋后来多次提到,当年强行在 GeForce 游戏卡里塞进 CUDA 架构是个巨大赌注,最初近十年并不赚钱。真正的转折点出现在 2012 年:AlexNet 用两块 GTX 580 训练深度卷积网络,在 ImageNet 上把第二名甩开超过 10 个百分点,整个机器学习领域才意识到 GPU 意味着什么。
1.1.2 CUDA 的编程模型:线程、块、网格与 Warp
CUDA 的核心抽象只有几个,但每个都非常关键。
线程(Thread):最小执行单位。一个线程执行一次你的函数体。 线程块(Block):一组线程,块内线程可以互相协作、共享一块高速的「共享内存」(Shared Memory,可以理解为这一小组工人共用的工作台)。 网格(Grid):一堆线程块,构成一次完整的计算任务。 Warp:硬件层面真正一起执行的一组 32 个线程。
理解 Warp 是理解 GPU 性能的关键。GPU 的执行方式叫 SIMT(Single Instruction, Multiple Threads,单指令多线程):同一条指令,32 个线程同时执行,但每个线程操作的是自己那份数据。这就像 32 个工人排成一排,听同一个口令,但各自手里的零件不同。
由此产生一个极为重要的性能陷阱:分支发散(Warp Divergence)。如果你的代码里写了 if-else,而这 32 个线程里有的人走 if、有的人走 else,硬件只能先让走 if 的干、其他人等着,再反过来。原本并行的一拍,被拆成了两拍。这就是 GPU 程序员谈之色变的“分支发散”。
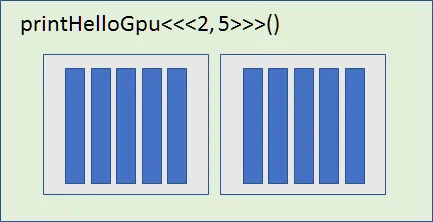
CUDA 的线程层次结构:网格、线程块、线程与共享内存的关系(图片来自 Wikimedia Commons,公有领域)
1.1.3 存储层次:GPU 性能的真正瓶颈往往在这里
GPU 的内存是分级的,速度和容量成反比:
寄存器:最快,每个线程私有,容量最小。 共享内存:块内共享,速度接近寄存器,需要你手动管理。 L2 缓存:全芯片共享。 全局显存(HBM):最大最慢,也就是我们常说的“显存”。
在大模型时代,第 4 层几乎决定一切。因为 Transformer 的解码过程是逐 token 生成的,每生成一个字,都要把几十 GB 的权重从显存里读一遍。这意味着瓶颈不是“算得快不快”,而是“搬得快不快”。这也是为什么行业里衡量一块 AI 显卡,看的往往不是 FLOPS(每秒浮点运算次数)而是显存带宽和显存容量。
由此也能理解近几年最重要的两个技术方向:
低精度:把 FP16 换成 FP8、FP4,本质上是把要搬的货物压扁一半,同样的带宽能搬两倍的量。 KV Cache 优化与批处理:想办法一次多搬点、少搬几次。
1.1.4 架构演进:从通用流处理器到专用矩阵单元
**Tensor Core(张量核心)**值得单独解释。普通 CUDA Core 一次只能算一个乘法;Tensor Core 一次能算完一整个小矩阵(比如 4×4)的乘法累加。深度学习 99% 的计算量都是矩阵乘法,所以这一步专用化带来的收益极其夸张。但它也带来一个新问题:程序员现在要面对两种硬件单元,代码复杂度陡增——这正是后文 CUDA Tile 要解决的问题。
1.1.5 CUDA 的真正护城河:不是编译器,是整套库
很多人以为 CUDA 的壁垒是“别人写不出同样的编译器”。其实不是。CUDA 真正的护城河是它上面的那一整套库:
cuBLAS:矩阵乘法,深度学习的绝对主力。 cuDNN:卷积、归一化、注意力等深度学习常用算子,手工调优到极致。 NCCL:多卡之间的集合通信(比如把所有卡的梯度求和),分布式训练的地基。 cuSPARSE / cuFFT:稀疏与频域运算。 TensorRT:面向推理的图优化与运行时。
这些库是 NVIDIA 十几年持续投入、针对每一代架构手工调优的结果。一个竞争对手即使做出了语法兼容的编译器,也要重新花十年把这些库补上。这才是“CUDA 生态”四个字的真实重量。
1.1.6 2025 年的重大转向:CUDA Tile
2025 年 12 月,NVIDIA 发布 CUDA 13.1,官方定性为“自 2006 年 CUDA 诞生以来最大、最全面的升级”。核心变化是推出CUDA Tile(NVIDIA 官方博客)。
要理解它解决了什么,先看它要取代什么。传统 CUDA 是 SIMT 编程:你要自己切分数据、自己规定每个线程干什么、自己管理 Tensor Core 的数据布局。这非常难,而且写出来的代码绑死在特定架构上。
CUDA Tile 的思路是往上抬一层:你不再描述“每个线程做什么”,而是描述“这一块数据(Tile)上要做什么数学运算”,由编译器和运行时决定怎么把这块数据映射到具体线程和 Tensor Core 上。官方的表述是:这一编程模型“把 Tensor Core 等专用硬件的细节抽象掉了,你的 tile 代码将兼容未来的 GPU 架构”。
首批发布包含两个组件:
CUDA Tile IR:面向 NVIDIA GPU 的全新虚拟指令集架构(可以理解为 GPU 世界的“中间字节码”)。 cuTile Python:一门用 Python 编写 tile 内核的领域专用语言(DSL)。
同期的其他更新也能看出 NVIDIA 的重心:cuBLAS 新增 FP8 / BF16 分组 GEMM(分组矩阵乘法)并支持 CUDA Graph,官方称在 MoE(混合专家模型)负载上可带来最高 4 倍加速;Green Contexts 从驱动 API 开放到运行时 API,允许把 GPU 的 SM(流式多处理器)划分成独立分区,给延迟敏感任务预留专用资源。
这些变化的共同指向很明确:**GPU 硬件越来越专用、越来越复杂,编程模型必须继续往上抽象,否则没人写得了。**这一点会在后文反复出现——Triton、MLX 的编译、CUDA Tile,其实是同一件事在不同层的投影。
1.2 苹果的 Metal 与 MPS:为统一内存而生的答案
1.2.1 三层结构:Metal、MPS、MPSGraph
苹果的方案是三层叠起来的,很多人会把它们混为一谈,其实职责完全不同。
Metal:最底层的图形与计算 API,地位大致相当于 Vulkan 加苹果私有的一些扩展。它让你直接管理 GPU 资源与命令队列,并可以用 Metal Shading Language(MSL,苹果的 GPU 着色语言)写自己的内核。 Metal Performance Shaders(MPS):苹果预先写好、并针对每一代 Metal GPU 家族手工调优的一组高性能内核库。卷积、矩阵乘法、归一化这些常见算子,苹果已经帮你调好了。它的生态位对应 NVIDIA 的 cuDNN 与 cuBLAS。 MPSGraph:图(Graph)层面的 API。你不再一个个调用算子,而是把整个计算图交给它,由它统一优化、融合、调度。它的生态位对应后文会讲的 XLA 或 TorchInductor。
除此之外,苹果芯片里还有一块叫Neural Engine(ANE,神经引擎)的专用 NPU,用来跑语音识别、图像处理这类固定任务。它能效极高,但编程接口受限,主要通过 Core ML 暴露给开发者,并不直接面向通用张量计算。
1.2.2 统一内存:苹果最大的差异化,也是 MLX 存在的前提
要理解苹果在这一层做的一切,必须先理解统一内存架构(UMA,Unified Memory Architecture)。
传统 PC 里,CPU 用的内存(DDR)和 GPU 用的显存(GDDR/HBM)是两块物理上独立的存储,中间隔着一条 PCIe 总线。数据要上 GPU 算,必须先从内存拷到显存,算完再拷回来。这条总线的带宽通常只有显存带宽的十分之一量级,是个巨大的漏斗。
苹果的 M 系列芯片把 CPU、GPU、NPU 和内存封装在同一个基板上,它们共享同一块物理内存。结果是:数据根本不需要拷贝,CPU 和 GPU 看到的其实就是同一份数据。
这件事的意义被严重低估了,它带来三个直接后果:
模型大小的上限从“显存”变成了“内存”。一台 192GB 统一内存的 Mac Studio,理论上能装下 192GB 的模型,这在消费级设备里几乎是独一档的能力。 不存在拷贝开销。加载一个 70B 模型到 GPU,在传统机器上要花几十秒做主机到设备的传输,在 Mac 上几乎是瞬时的。 CPU 与 GPU 可以灵活分工。模型可以一部分层跑 GPU、一部分跑 CPU,而不必为数据搬运付额外代价。
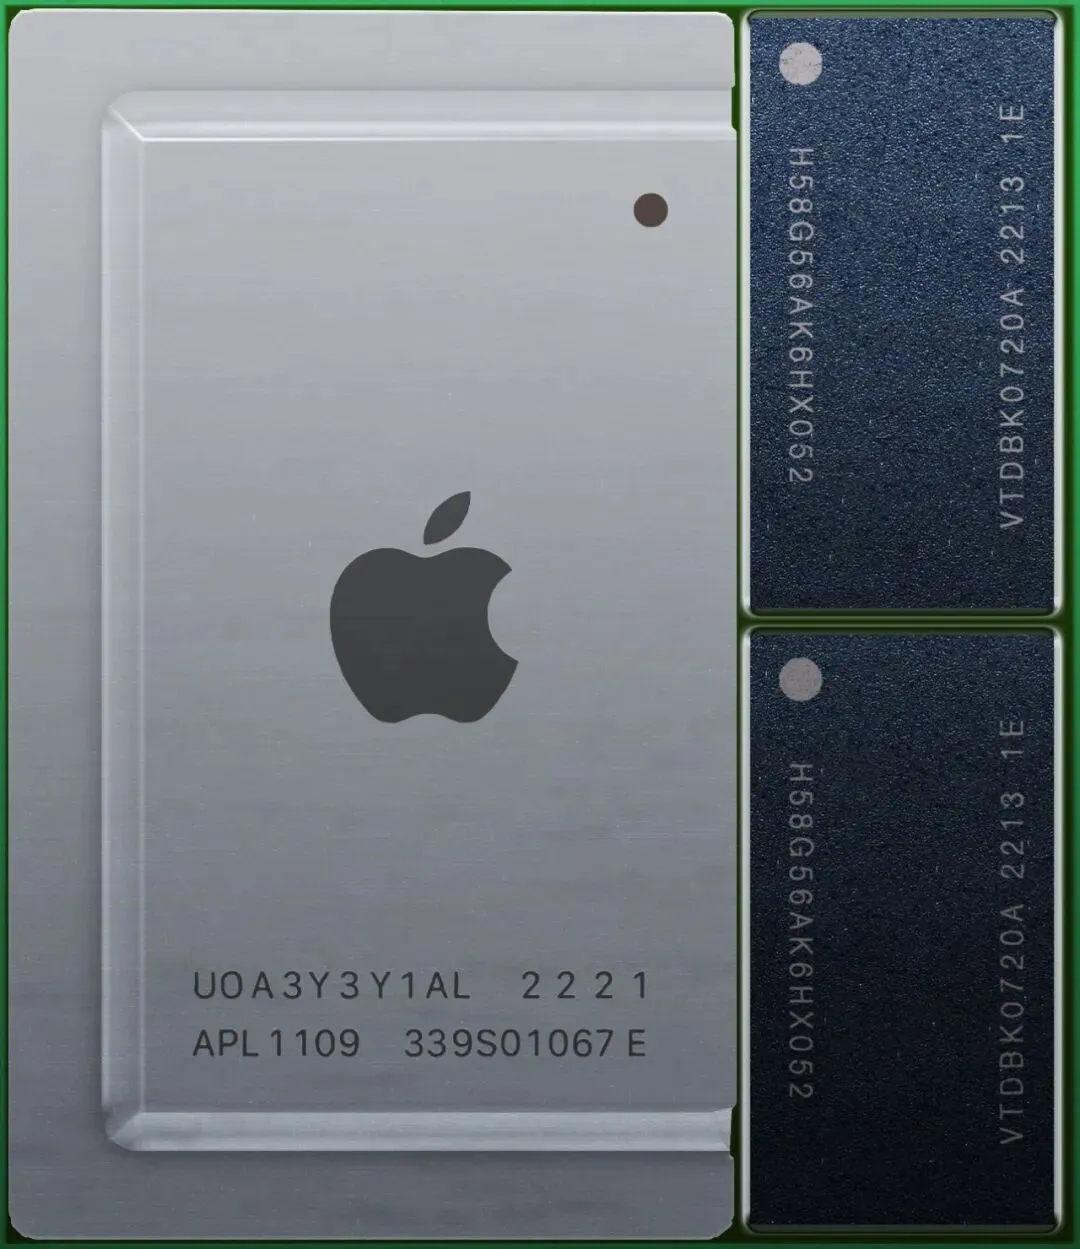
Apple M2 芯片:CPU、GPU、神经引擎与内存封装在同一基板上(图片来自 Wikimedia Commons,CC0 公有领域)
苹果官方在配合 PyTorch 发布 MPS 后端时,对统一内存的描述是:每台 Apple silicon Mac 都有统一内存架构,为 GPU 提供对完整内存的直接访问,“使 Mac 成为机器学习的绝佳平台,让用户能在本地训练更大的网络或更大的 batch size”(PyTorch 官方博客)。
1.2.3 代价:封闭
苹果这套方案的问题显而易见——它只存在于苹果的硬件上。Metal 不是开放标准,MPS 的源码不公开,第三方无法通过它支持别家 GPU。
这造成一个尴尬局面:在 Mac 上用 Metal 写好的高性能内核,无法迁移到任何非苹果设备。这个痛点最终促成了 2025 年 MLX 那个颇受关注的决定,后文详述。
1.3 Vulkan:Khronos 的跨厂商通用 GPU 语言
1.3.1 出身:OpenGL 的彻底重做
Vulkan 由 Khronos Group(制定 OpenGL、OpenCL 等标准的开放联盟)发布,1.0 规范于 2016 年 2 月 16 日正式推出。官方新闻稿对它的定位是:“为现代 GPU 提供高效、跨平台的图形与计算访问,覆盖从 PC、主机到手机与嵌入式平台的各类设备”(Khronos 官方新闻稿)。
它的诞生背景是:诞生于 1990 年代的 OpenGL 到了多核 CPU 时代已经严重过时——单线程、状态机式的设计,驱动在背后做大量隐式优化,导致性能不可预测。AMD 把自己的私有 API Mantle 捐给 Khronos 作为起点,最终做出了 Vulkan。
Vulkan 的设计原则可以概括为三条:
显式控制:内存怎么分配、资源怎么同步,全部由程序员说了算,驱动不再猜。代价是代码量暴增。 低 CPU 开销与多线程友好:可以在多个 CPU 核上并行生成命令缓冲区,也就是并行写好一份份“作业清单”交给 GPU。 可预测:没有驱动魔法,同样的代码在不同厂商 GPU 上行为一致。
1.3.2 SPIR-V:Vulkan 最被低估的设计
Vulkan 不接收任何高级语言作为输入,而是使用SPIR-V:一种由 Khronos 定义的中间二进制表示。
类比一下:Java 源码被编译成字节码,JVM 执行字节码;SPIR-V 就是 GPU 世界的“字节码”。前端语言(GLSL、HLSL,未来也可以是 C++、Rust 或 MLIR)只要能生成 SPIR-V,就能跑在 Vulkan 上。
好处正如 Khronos 所说:驱动不再需要内嵌高级语言编译器,复杂度大幅下降;着色器加载更快;语言前端可以自由发展。对 GPU 计算而言,这意味着你可以用任何语言写 GPU 内核,只要工具链能吐出 SPIR-V。
1.3.3 图形与计算在同一套 API 里
Vulkan 一个常被忽略的特点是:从 1.0 开始就把图形队列和计算队列放在同一个 API 里。计算着色器(Compute Shader)不是图形渲染的附庸,而是一等公民。
这跟 CUDA 的哲学很不一样。CUDA 从一开始就只做计算;Vulkan 要同时服务游戏引擎与科学计算。好处是它能跑在任何有 Vulkan 驱动的 GPU 上——NVIDIA、AMD、Intel、高通 Adreno、ARM Mali、Imagination PowerVR 全都支持;坏处是它为了通用性牺牲了一些针对 AI 的深度优化能力。
Vulkan 官方标志(图片来自 Wikimedia Commons,公有领域)
1.3.4 在苹果设备上:MoltenVK
苹果从未为 macOS 提供原生 Vulkan 驱动。于是社区做了MoltenVK——一个 Vulkan 的“可移植性实现”,把 Vulkan 的图形与计算 API 叠在苹果 Metal 框架之上,让 Vulkan 应用能跑在 macOS、iOS 和 tvOS 上。该项目自 2017 年起开发,目前约 5.8 千个 GitHub 星标(MoltenVK 仓库)。
要注意的是,MoltenVK 只实现 Vulkan 的一个子集(Vulkan Portability 子集),且多了一层翻译开销。所以在 Mac 上,追求极致性能的代码直接用 Metal,追求跨平台的代码才走 MoltenVK。
1.3.5 Vulkan 在大模型时代的真实角色:兜底与长尾
客观地说,Vulkan 从来不是最快的那个。在 NVIDIA 卡上 CUDA 永远更快,在苹果芯片上 Metal 永远更快。Vulkan 的价值在别处:
它是唯一能同时覆盖 NVIDIA、AMD、Intel 与移动 GPU 的通用计算 API。对 llama.cpp 这种“要让所有人的显卡都能跑”的项目来说,这是最经济的选择——写一份 Vulkan 内核,等于同时支持半个显卡市场。 它是国产与新兴 GPU 的入场券。很多新厂商来不及做完整的 CUDA 兼容层,但都能提供 Vulkan 驱动。 它是浏览器与移动端的桥梁。WebGPU 在设计思想上与 Vulkan、Metal、D3D12 同构,llama.cpp 也已有 WebGPU 后端,可在浏览器里直接推理。
1.4 顺带一提:其他玩家的 L1 层
为了地图完整,快速点名其余几家:
ROCm / HIP(AMD):AMD 对标 CUDA 的方案。HIP 是一门类 CUDA 的语言,可编译到 AMD 与 NVIDIA 两种平台,便于迁移。 SYCL / oneAPI(Intel):基于标准 C++ 的异构编程模型,可同时跑 Intel GPU、CPU 与 FPGA。 CANN(华为昇腾):华为为昇腾 NPU 提供的异构计算架构。 MUSA(摩尔线程):国产 GPU 厂商的对标方案。 OpenCL:Vulkan 之前 Khronos 的通用计算标准,如今在移动端(高通 Adreno)仍有生命力,但整体处于退场状态。
它们的共同处境是:硬件不差,生态很薄。这不是技术问题,而是投入时间与人力所产生的复利问题。
1.5 三种世界观正面比较
需要强调一句:这三者之间不是替代关系,而是并存关系。一个成熟的 AI 系统常常同时用到其中两三种——在 NVIDIA 集群上用 CUDA 训练,导出成通用格式,然后在 Mac 上用 Metal 跑、在 AMD 卡上用 Vulkan 跑、在浏览器里用 WebGPU 跑。理解这一点,后面看 llama.cpp 的多后端设计就水到渠成了。
第二章 深度学习框架层:PyTorch 与它的两条岔路
框架层(L3)是研究者真正打交道的地方。它的任务是:让你用尽量接近数学的方式描述一个模型,然后帮你把模型拆成 GPU 能执行的一堆操作。
这一层过去十年只发生过一次大的权力更迭——从 TensorFlow 到 PyTorch。而现在正在发生第二次,并且分成了两条岔路:一条是 PyTorch 自己不断“后端化”,另一条是苹果干脆另起炉灶做了 MLX。
2.1 PyTorch:靠动态图赢下研究,再用编译器补上性能
2.1.1 出身与治理:从 Meta 内部项目到行业公共设施
PyTorch 由 Meta(当时的 Facebook)团队孵化,GitHub 仓库创建于 2016 年 8 月,2017 年正式对外发布。它的直接前身是 Torch7——一个用 Lua 写的框架;PyTorch 的本质是“把 Torch 的 C 后端搬到 Python 上”。
关键转折发生在治理结构。2022 年 9 月,Meta 宣布把 PyTorch 移交 Linux Foundation 管理,成立独立的 PyTorch Foundation。首届治理董事会成员包括 Meta、AMD、AWS、Google Cloud、Microsoft Azure 和 NVIDIA,2023 年又陆续扩至 IBM、Hugging Face、Intel、Graphcore、Lightning AI、华为、Snowflake 等(相关报道)。
董事会负责业务治理,日常技术治理仍由社区维护者集体决定。这件事的意义在于:PyTorch 从此不再是一家公司的产品,而成了行业公共基础设施。截至 2026 年 9 月,PyTorch 仓库约有 10.3 万个星标、3.0 万个 fork。
PyTorch 官方标志(图片来自 Wikimedia Commons,BSD 许可)
2.1.2 两个奠基性设计:即时执行与自动微分
PyTorch 能赢下研究领域,靠的是两个设计。
第一是 eager 模式(即时执行)。写下一行代码,这一行立刻就执行了,你马上能打印结果、能在中间打断点。对比之下,早期的 TensorFlow 是静态图:你先写一张图的蓝图,再启动一个会话去执行它,中间过程看不见摸不着。
对研究者来说这是天壤之别。做研究意味着大量试错,能随时打印中间结果、能用 Python 的 if 和 for 控制流程,比那一点点性能重要得多。
第二是 autograd(自动微分)。训练神经网络的核心是把误差反向传播回去,算出每个参数该往哪个方向调整多少,这需要求导。PyTorch 的做法是:你正常写前向计算,它在背后悄悄记一本账,把每一步操作都记进一张图里;最后你调用一次反向传播,它就顺着账本倒着走一遍,把每一步的导数算出来。
打个比方:autograd 就是那个站在旁边记录“放了多少盐、火多大、炒了几分钟”的助手;最后菜咸了,它能倒推出是哪一步出了问题。
2.1.3 支撑一切的骨架:ATen 与 Dispatcher
PyTorch 内部有两个关键部分值得知道名字。
ATen是张量库,所有具体运算的实现都在这里,用 C++ 写成,Python 只是外面一层薄薄的接口——这也是为什么 PyTorch 的 Python 调用其实相当快。
Dispatcher(分发器)则是理解“后端”这件事的钥匙。它是一个多路复用开关:当你调用一次矩阵乘法时,Dispatcher 会根据输入张量所在的设备以及当前启用的各种模式,把这次调用路由到正确的实现——CUDA 张量走 cuBLAS,MPS 张量走 MPSGraph,CPU 走 MKL 或 oneDNN;如果开了自动求导,还要先包一层求导逻辑。
这套机制叫DispatchKey。它的存在正是 PyTorch 能长出 CUDA、CPU、MPS 乃至各种第三方后端的根本原因:新硬件厂商只需注册自己的 DispatchKey,实现几百个算子,就能让 PyTorch 跑在自己的芯片上。
2.1.4 PyTorch 2.0:用编译器把丢掉的性能抢回来
eager 模式的代价是性能。因为每执行一个算子,Python 和 C++ 之间都要来回一趟,而且框架看不到全局,无法做跨算子的优化。
PyTorch 2.0 就是为了解决这个问题。它在 2022 年 12 月 2 日的 PyTorch 大会上预告,2023 年 3 月 15 日正式发布,核心是 torch.compile(PyTorch 官方博客)。用法极简:把模型包一层,剩下的交给编译器。
model = torch.compile(model)它背后是四项新技术,值得逐个认识:
TorchDynamo:负责“抓图”。它利用 Python 解释器的帧求值钩子,在运行时安全地捕获 PyTorch 程序的计算图,而且不会破坏 Python 的动态语义。官方称这是五年研发的成果。 AOTAutograd:把 PyTorch 的自动求导引擎当作一次“提前求导”,生成前向与反向的完整图(AOT 即 Ahead-Of-Time,提前编译)。 PrimTorch:把 2000 多个 PyTorch 算子收敛成约 250 个“原语算子”。这一条对硬件厂商意义巨大——以前适配 PyTorch 要实现几千个算子,现在只需实现几百个。 TorchInductor:真正的代码生成器。对 NVIDIA 和 AMD GPU,它用 OpenAI 的 Triton 编译器生成核函数;对 Intel CPU,它生成多线程、向量化的 C++ 代码。
官方给出的效果是:在 165 个开源模型上,torch.compile 有 93% 的情况能正常工作,fp32 精度平均加速 20%,自动混合精度(AMP)平均加速 36%。
这里要解释一下Triton。它是 OpenAI 开发的一门用 Python 写 GPU 内核的语言和编译器,你可以把它理解成“CUDA 的 Python 版,但抽象更高一层”。你不用自己管理线程块和共享内存,只需描述一个数据块上的运算,编译器帮你生成高效的 GPU 代码。官方的说法是:Triton 生成的核函数性能可与手写内核以及 cuBLAS 这类专用库媲美。Triton 目前约有 2 万个 GitHub 星标。
这一小节最该记住的一句话:PyTorch 2.0 之后,PyTorch 不再只是“一个框架”,而是“一个前端 + 一套编译器 + 一组可插拔后端”。这个结构变化,才让后面 MPS、MLX 乃至各种国产芯片后端有了生存空间。
2.2 PyTorch 的 MPS 后端:让同一份代码在 Mac 上落到 Metal
2.2.1 它是什么,什么时候来的
2022 年 5 月 18 日,PyTorch 官方与苹果 Metal 工程团队合作宣布:Mac 上的 PyTorch 训练可以用 GPU 加速了,这一能力随 PyTorch v1.12 发布(PyTorch 官方博客)。在此之前,Mac 上的 PyTorch 只能跑 CPU。
实现方式是新增一个名为 mps 的设备:它把机器学习计算图和原语映射到苹果的 MPSGraph 框架,把单个算子映射到 MPS 提供的调优内核上。官方的原话是:MPS 后端“用针对每个 Metal GPU 家族独特特性精调的内核来优化计算性能”。
用法上,它和其他设备完全一致:
mps_device = torch.device(”mps”)x = torch.ones(5, device=mps_device)model = YourFavoriteNet()model.to(mps_device)pred = model(x)
官方 MPS 文档还提示了两个可用性前提:PyTorch 安装必须编译时启用了 MPS,且 macOS 版本需在 14.0 以上并配备支持 MPS 的设备(PyTorch MPS 文档)。
2.2.2 覆盖率:从“能跑”到“能训练”
MPS 后端刚推出时算子覆盖有限。到 PyTorch 2.0(2023 年 3 月),它升级为 Beta 特性:官方称已支持最常用的 60 个算子,加上社区高频请求的算子后,覆盖超过 300 个算子,并把重点放在补齐基于 OpInfo 的前向与梯度测试,以消除“静默的正确性问题”(即不报错但结果算错)。
这一时期 MPS 后端已经被第三方网络采用,官方点名包括 Stable Diffusion、YOLOv5、Whisper。
2.2.3 性能口径:看清苹果的测试条件
苹果公布的加速数据有明确的测试条件,值得原样引用以免误读:测试由苹果在 2022 年 4 月进行,使用生产版本的 Mac Studio,配置为 Apple M1 Ultra(20 核 CPU、64 核 GPU)、128GB 内存、2TB SSD,系统为 macOS Monterey 12.3,PyTorch 为 1.12 预发布版,模型与 batch size 分别为 ResNet50(128)、HuggingFace BERT(64)、VGG16(64)。
这个口径提醒我们两件事:一是数据来自顶配机型,二是它是相对 CPU 基线的加速比,不是与 NVIDIA GPU 的对比。脱离这两点谈“MPS 有多快”都是耍流氓。
2.2.4 MPS 的真实生态位与局限
MPS 的价值非常明确:**它让全世界已有的 PyTorch 代码,几乎不用改就能在 Mac 上跑起来。**对一个想在飞机上改模型的研究者来说,这是无价的。
但它的局限也同样明确:
算子覆盖始终落后于 CUDA。遇到没实现的算子,会回退到 CPU 执行,此时性能会断崖式下跌。 它沿用了 PyTorch 的设备语义。也就是说,你仍然要写 .to(device),仍然要在脑内区分“CPU 上的张量”和“GPU 上的张量”——哪怕在苹果芯片上它们物理上是同一块内存。这一点正是 MLX 认为最该改的地方。分布式、稀疏、某些动态形状算子的支持较弱。
一句话总结:MPS 是一次“借道”——把 PyTorch 已有的庞大生态,接到苹果 GPU 上。
2.3 MLX:苹果自己的答案——不做 PyTorch 的后端,重做一个框架
2.3.1 基本盘
2023 年 12 月初,苹果机器学习研究团队开源了 MLX。仓库创建于 2023 年 11 月 28 日,主语言是 C++,截至 2026 年 9 月约有 2.85 万个 GitHub 星标。
官方对它的定义是:一个面向 Apple silicon 的、高效而灵活的机器学习数组框架,由苹果机器学习研究团队出品;设计受 PyTorch、JAX 和 ArrayFire 启发(MLX 官方文档)。苹果研究员 Awni Hannun 在社交平台上的介绍是:“一个专为 Apple silicon(也就是你的笔记本电脑)设计的高效机器学习框架。”
MLX 官方仓库 ml-explore/mlx(GitHub 社交卡片)
MLX 官方仓库 ml-explore/mlx(GitHub 社交卡片)
2.3.2 四个设计支柱
MLX 与 PyTorch 的差异集中在四点,每一点都值得单独讲。
**第一,统一内存模型。**官方文档的原话是:“MLX 数组存在于共享内存中,对 MLX 数组的操作可以在任何受支持的设备上执行,而无需执行数据拷贝。”
这句话的分量在于:它把“统一内存”从一个硬件特性,变成了编程模型的语义。在 PyTorch 里你写 x.to("mps") 是在请求一次数据搬运(哪怕在 Mac 上这次搬运可能是零成本优化掉的);在 MLX 里你指定的是“这个操作在哪个设备上执行”,而不是“把数据搬到哪去”。
**第二,惰性求值(Lazy Evaluation)。**MLX 的计算是惰性的:你写下的一串运算不会立刻执行,而是先攒成一张图,直到你真正需要结果(比如打印、保存、或显式调用 mx.eval)时才物化。
为什么这很重要?因为攒成了图,编译器就能看到全局,从而做算子融合——比如把“乘、加、归一化”三步合成一个内核,中间结果根本不写回内存。对大模型这种内存带宽受限的负载,融合带来的收益往往比算力提升还大。
**第三,可组合的函数变换。**这是 MLX 受 JAX 影响最深的地方。所谓函数变换,就是“对一个函数做变换,得到另一个函数”:
自动微分: mx.grad、mx.value_and_grad、mx.jvp、mx.vjp自动向量化: mx.vmap(把一个只处理单样本的函数,自动变成能处理一批样本的函数)图优化与编译: mx.compile
关键在于“可组合”:这几个变换可以任意嵌套。vmap(grad(f)) 这种写法是合法的,意思是“先对 f 求导,再把求导后的函数批量化”。这在需要计算逐样本梯度(比如某些元学习算法、隐私计算)时非常有用,而在 PyTorch 里要手写循环。
**第四,设备与流(Stream)抽象。**MLX 提供 mx.Device 和 mx.Stream,可以显式指定操作跑在 CPU 还是 GPU、跑在哪条执行流上;再配合 mx.distributed(all_sum、all_gather、send、recv 等),官方示例里已经包含数据并行与张量并行两种模式。
2.3.3 底下那层:Metal 内核与 Fast 算子
MLX 的 GPU 后端直接用 Metal 实现,并且开放了自定义内核的能力:
mx.fast.metal_kernel:直接用 Metal Shading Language 写自己的内核并接入 MLX。 mx.fast模块内置了一批融合过的热点算子: rms_norm、layer_norm、cross_entropy、rope(旋转位置编码)、scaled_dot_product_attention(缩放点积注意力)。
这几个算子名字暴露了 MLX 的真实目标——它们全是 Transformer 的关键路径。换句话说,MLX 从一开始就是为大模型准备的。
此外 MLX 还有完整的量化支持(quantize、quantized_matmul、FP8 转换等),甚至能直接 save_gguf 保存成 llama.cpp 生态通用的 GGUF 格式。
API 层面,Python API 紧密遵循 NumPy,同时提供完整的 C++ API 与 Swift 绑定,这意味着它既可以做研究,也可以直接塞进 iOS 应用。
2.3.4 2025 年的转折:MLX 开始支持 CUDA
2025 年 7 月,一个颇受关注的动向出现了:MLX 正在加入对 NVIDIA CUDA 的支持,相关代码由社区开发者主导,并已拆分模块逐步并入 MLX 主分支。这在技术社区引发了大量讨论(相关报道)。
需要准确理解它的含义,很多报道都讲错了:
它不是让 Mac 能插 NVIDIA 显卡本地跑 MLX。 它是让开发者可以在 Apple silicon Mac 上用 MLX 开发和调试,然后把代码导出到 Linux 或 Windows 的 NVIDIA GPU 上运行。
这一变化在 MLX 官方文档里可以看到痕迹:MLX 0.32.2 的 API 中已经存在 mlx.core.cuda.is_available、mx.fast.cuda_kernel、mx.fast.precompiled_cuda_kernel 这些 CUDA 相关接口。
苹果给出的两条理由很值得玩味:一是 CUDA 提供统一内存机制,二是 NVIDIA 硬件在学术研究与大规模计算中应用广泛,支持 CUDA 能让开发者在 Mac 上本地开发测试、随后无缝部署到 NVIDIA 服务器或超算。
**这件事的意义远超技术本身。**它等于承认:训练这件事已经被 CUDA 生态锁定,苹果没有必要、也没有能力在数据中心层面硬碰;苹果要守住的是“开发入口”和“部署终端”这两端。
2.3.5 MLX 的生态位
到 2026 年,MLX 周边已经长出一批官方与社区项目:mlx-lm(用 MLX 跑大语言模型,约 7 千星标)、mlx-whisper(语音转写)、各类图像与音乐生成示例,以及 Swift 侧的 LLM 与 VLM 示例。社区侧也有越来越多模型发布 MLX 版本。
它的生态位可以概括为:Apple silicon 上的一等公民,本地微调与端侧推理的首选。
2.4 PyTorch MPS 与 MLX:不是二选一,而是“借道”与“重铺路”
这是读者最容易混淆的一组关系,这里对照清楚。
一句话判据:如果你手上已有一份 PyTorch 代码,用 MPS;如果你在从零开始、且目标平台明确是苹果设备,用 MLX。
第三章 被低估的一层:图编译与内核生成
这一层(L4)很少被单独讨论,但它是过去五年变化最剧烈的地方。原因在于:硬件越来越专用,而人手写内核的能力是有上限的,所以“让编译器生成内核”成了唯一出路。
这条演进线可以画成三级台阶:
手写内核(CUDA C++):性能上限最高,但人力成本极高,且绑死架构。 DSL 生成内核(Triton):用 Python 描述一个数据块上的运算,编译器生成 GPU 代码。性能接近手写,成本大幅下降。PyTorch 的 TorchInductor 就建立在它之上。 Tile 级抽象(CUDA Tile、MLX compile、XLA):连“数据块”这个概念都由框架来组织,程序员只描述数学。
NVIDIA 自己在 2025 年的 CUDA 13.1 里推 CUDA Tile,理由说得非常直白:传统 SIMT 编程要求你指定每个线程的执行路径,而 tile 模型让你“提升一个层级,指定要在这块数据上执行的数学运算,由编译器和运行时决定把工作映射到各个线程的最佳方式”,并且“抽象掉 Tensor Core 等专用硬件的细节,使你的 tile 代码兼容未来的 GPU 架构”。
三条路线其实指向同一个结论:AI 负载的形状(大规模矩阵运算)已经足够稳定,稳定到可以让编译器来替人类做决策。
这也是为什么评价一个框架,不能只看它的算子数量,还要看它的编译栈:PyTorch 有 TorchDynamo 加 Inductor,JAX 有 XLA,MLX 有自己的惰性图加编译,而 llama.cpp 走的是另一条路——它干脆把这一层简化到极致。
第四章 推理引擎层:ggml 与 llama.cpp
前三章讲的是“怎么把模型训出来”,这一章讲的是“怎么把训好的模型送到用户手上”。这是过去三年爆发最猛的一层,也是离普通人最近的一层——你现在能在自己笔记本上跑大模型,几乎全靠它。
4.1 ggml:把框架这一层整个扔掉
ggml 是一个用 C 和 C++ 写的张量库,由 Georgi Gerganov 在 2022 年 9 月启动(ggml 仓库,创建于 2022 年 9 月 18 日,截至 2026 年 9 月约 1.54 万星标)。
它对自己的定位很克制:“主要目标是成为一个简单、可移植、高效的机器学习张量库,且配置成本极低。”
4.1.1 核心设计原则
官方 README 列出的特性,每一条都是理解 llama.cpp 为什么这么“轻”的钥匙:
纯 C/C++ 实现,无任何第三方依赖。 跨平台:x86、ARM、RISC-V、LoongArch(龙芯)、PowerPC、s390x,以及 WebAssembly。 针对 x86、ARM、RISC-V 的 SIMD 优化内核。 广泛的后端支持:CPU、GPU、NPU,乃至浏览器。 2 到 8 比特整数量化,外加 MXFP4 与 NVFP4 微缩放格式。 运行时零内存分配。
4.1.2 “零运行时内存分配”是什么意思
常规框架的做法是:需要一块临时内存就申请一块,用完释放。这在服务器上没问题,但在推理场景有两个麻烦:一是分配与释放本身有开销;二是长时间运行会产生内存碎片——总量够,却找不到一块连续的大空间。
ggml 的做法是:推理开始前先用 ggml_context 一次性把需要的内存全部分配好,之后整个推理过程不再申请任何内存。
好处是可预测、无碎片、无分配抖动;代价是你必须提前算清楚要多少内存。对“跑一个结构固定的模型”来说,这是完全可接受的限制。
4.1.3 计算图与 mmap:两次关键的效率提升
ggml 用 ggml_cgraph 表示计算图:定义一次,执行多次。大模型推理本质上是把同一张图跑很多遍(每生成一个 token 跑一遍),所以“建图一次、反复执行”能省掉大量重复开销。
另一个关键设计是mmap(内存映射)。加载模型时不把整个文件读进内存,而是让操作系统把文件“映射”到进程的地址空间,用到哪一块才真正把哪一块读进来。好处有两点:启动几乎是瞬时的;多个进程加载同一个模型文件时,物理内存可以共享。
4.1.4 ggml 的取舍:它不做训练
必须明确指出:ggml 从定位上就不追求成为通用训练框架。复杂优化器、分布式训练、自动混合精度这些训练必需的能力,它要么不支持,要么支持得很弱。
这不是缺陷,而是取舍。**它把“训练”这整块包袱扔掉了,换来了极致的轻量与可移植。**用物流比喻:ggml 不做调度中心,它只做配送。
ggml 官方仓库 ggml-org/ggml(GitHub 社交卡片)
ggml 官方仓库 ggml-org/ggml(GitHub 社交卡片)
4.2 llama.cpp:一个周末写出来的东西,然后引爆了生态
4.2.1 起点与现状
2023 年 3 月 10 日,Georgi Gerganov 提交了 llama.cpp 的第一个 commit,距离 Meta 的 LLaMA 权重泄露只过了几天。最初的目标写在 README 里,朴素得可爱:“用 4 比特量化在 MacBook 上跑这个模型。”
三年多之后,截至 2026 年 9 月 20 日,通过 GitHub API 实测:llama.cpp 有128,908 个星标、23,477 个 fork,采用 MIT 许可(llama.cpp 仓库)。它已经支持数十种模型架构,从 LLaMA、Mistral、Qwen、Gemma、DeepSeek 到非 Transformer 架构的 Mamba 与 RWKV。
llama.cpp 官方仓库 ggml-org/llama.cpp(GitHub 社交卡片)
llama.cpp 官方仓库 ggml-org/llama.cpp(GitHub 社交卡片)
它为什么能长这么快?三个原因:
零依赖。不需要装 Python,不需要装 PyTorch,不需要 CUDA toolkit。有个 C 编译器就能编译。 量化。4 比特量化把一个 7B 模型压到约 4GB,这意味着绝大多数人手上的笔记本都能装下。 它解决了一个真实的、被压抑的需求。在那之前,“在自己电脑上跑大模型”几乎是不可能的任务。
4.2.2 后端的爆炸式扩张
llama.cpp 最有意思的地方是它的后端列表。最初的 llama.cpp 只有 CPU 后端;随后社区把它移植到了几乎所有能找到的加速器上。大致的时间顺序是:
Metal(苹果芯片,2023 年 5 至 6 月) CUDA(NVIDIA,2023 年 5 月起,后来成长为文件数量最大的后端) CLBlast / cuBLAS(2023 年 6 月) HIP / ROCm(AMD) Vulkan(跨厂商,2024 年) SYCL / oneAPI(Intel) CANN(华为昇腾)、MUSA(摩尔线程) Hexagon(高通 DSP)、OpenCL(移动端) WebGPU(浏览器)、OpenVINO、zDNN(IBM Z)、RPC(跨机器分布式)
这份列表本身就是一篇行业报告:**它记录了过去三年全球 AI 芯片的竞争格局。**每一个后端背后,都站着一家想让自己硬件被支持的厂商。
4.2.3 GGUF:一个格式如何成为事实标准
早期的 llama.cpp 用的是一种叫 GGML 的简单二进制格式,后来迭代出 GGMF、GGJT 两个版本。它们都有同一个问题:每加一个新特性就破坏向后兼容。
2023 年 8 月 21 日,GGUF正式取代它们。它的全称是 GPT-Generated Unified Format,核心设计是四点:
自描述:模型架构、上下文长度、词表、分词器、RoPE 参数、特殊 token,全部以键值对的形式存在文件头里,不需要额外的配置文件。 可内存映射:张量数据区做了对齐,操作系统可以直接 mmap,不必先把整个文件读进内存。 可扩展:新增元数据字段不会破坏旧版本的读取器。 单文件分发:一个文件包含运行模型所需的全部东西。
结果是:GGUF 成了本地大模型的通用货币。Hugging Face 上社区发布的量化模型,绝大多数都是 GGUF 格式;Ollama、LM Studio、GPT4All、Jan、koboldcpp 等工具都原生支持它。
顺带一提,MLX 也提供了 save_gguf 接口——两个生态在文件格式这一层握手了。
4.2.4 量化:llama.cpp 最锋利的那把刀
量化(Quantization)是把模型权重从 16 或 32 位浮点压到更低位宽的过程。它同时减小体积、降低内存占用,并且往往还能提速——因为要搬运的数据变少了。
llama.cpp 的量化类型大致分三代,命名规则值得记住:以 Q4_K_M 为例,4 表示每个权重 4 比特,K 表示使用了 k-means 聚类的高级量化,M 表示大小档位(S 小、M 中、L 大)。
传统量化:Q4_0、Q4_1、Q5_0、Q5_1、Q8_0。按块做对称或非对称量化,每块一个缩放因子。 K 系列量化:Q2_K 到 Q6_K,更精细的分块与混合精度。社区常用的甜点档是 Q4_K_M。 I 系列量化:IQ1 到 IQ4,基于码本,需要先用一份校准数据生成 imatrix(重要性矩阵)来指导量化。
这里要解释一下“为什么量化能几乎不掉点”:神经网络的权重分布是高度集中的,大部分权重挤在一个很小的数值区间里。既然如此,用 16 位去表示它们就是巨大的浪费——用 4 位加上一个缩放因子,就能以极小的误差还原出来。而 imatrix 的思路更进一步:不同位置的权重对最终结果的重要性不同,重要的地方多给几位,不重要的地方少给几位。
4.2.5 2026 年 2 月:ggml.ai加入 Hugging Face
2026 年 2 月 20 日,Gerganov 宣布ggml.ai团队加入 Hugging Face。Hugging Face 官方博客的表述是:团队仍然 100% 投入维护 llama.cpp,并在技术方向和社区上保留完全的自主权与领导力,项目继续 100% 开源、由社区驱动(Hugging Face 官方博客)。
官方给出的技术目标是:让新模型从 transformers 库到 llama.cpp 的发布路径尽可能接近“一键完成”,并改进基于 ggml 的软件在打包与用户体验上的表现。
这件事的意义在于:它给整个本地推理生态提供了一层机构性的可持续保障。llama.cpp 已经成了公共基础设施,而公共基础设施最怕的就是维护者 burnout。
4.3 llama.cpp 为什么能同时用 CUDA、Metal 和 Vulkan
这是本章的技术核心,也是全文最重要的交汇点。
4.3.1 后端抽象:一个“可替换的执行器”
ggml 的做法是定义一套后端接口:一个后端就是“给定一张计算图,我负责把上面的节点执行完”的一种实现。CPU 后端用 SIMD 指令执行,CUDA 后端生成并调用 CUDA 内核,Metal 后端调用 Metal 内核,Vulkan 后端调用 SPIR-V 计算着色器。
在编译期,你用 CMake 开关决定编译哪些后端(比如 GGML_CUDA、GGML_METAL、GGML_VULKAN);在运行时,llama.cpp 维护一张后端注册表,可以动态加载并挑选合适的后端。
**这意味着同一份 GGUF 模型文件,可以在 N 种完全不同的硬件上跑,而模型本身完全不用变。**用物流比喻:货物是标准化的集装箱(GGUF),公路是可替换的(后端),目的地是同一个。
4.3.2 分层卸载:混合推理
llama.cpp 还支持把模型的不同层分配到不同设备上。典型场景是:显存放不下整个模型时,把前若干层放 GPU、剩下的放 CPU,或者干脆一部分放 GPU 一部分放另一块 GPU。
在苹果的统一内存机器上,这个能力的意义相对小一些(因为没有独立的显存);但在 NVIDIA 或 AMD 的独立显卡上,它直接决定了“你能不能跑一个比你显存更大的模型”。
4.3.3 三种后端在 llama.cpp 里的真实分工
注意这张表透露的关键事实:**CUDA 和 Metal 是“最快”的,Vulkan 是“最通”的。**llama.cpp 同时保留它们,不是因为选择困难,而是因为它们解决的是不同维度的问题。
第五章 把它们拼起来:全景对照与选型决策
前面四章把每一层拆开讲了,这一章把它们放回同一张图里,看清楚各自的生态位。
5.1 全景对照表
补充一句关于 vLLM:它创建于 2023 年 2 月,截至 2026 年 9 月约有 9.2 万星标,是线上高并发服务的主流选择。它和 llama.cpp 的关系经常被误读为竞争——其实不是。llama.cpp 优化的是单用户、低延迟、能跑在你的笔记本上;vLLM 优化的是多用户、高吞吐、跑在一堆服务器显卡上。同样是“推理”,目标函数完全不同。
5.2 选型决策树:照着这个走就行
下面按真实需求给出路径,每一条都写明“为什么”。
一、我要从头训练或微调一个大模型,有 NVIDIA 显卡。
路径:CUDA + PyTorch(配合 torch.compile、FSDP 或 Megatron 之类的并行方案)。
理由:这是唯一生态完整的选项。CUDA 的库、NCCL 的多卡通信、PyTorch 的分布式能力,三者缺一不可。
二、我要在线上给大量用户提供服务。
路径:vLLM 或 TensorRT-LLM,底层 CUDA。
理由:此时瓶颈是并发吞吐与显存利用率,不是单次推理延迟。llama.cpp 在这一场景下并不对口。
三、我只有一台 Mac,想在本地跑或微调模型。
路径分两种:
已有 PyTorch 代码 —— 用 PyTorch 加 MPS 后端,改动最小。 从零开始的新项目 —— 用 MLX,能吃到统一内存与算子融合的全部红利。
理由:这是本文 2.4 节的结论,核心分野在于“是否已有 PyTorch 资产”。
四、我要在一台普通电脑上跑一个开源大模型。
路径:llama.cpp(或基于它的 Ollama、LM Studio),模型用 GGUF。后端选择:苹果芯片走 Metal,NVIDIA 走 CUDA,AMD 与 Intel 走 Vulkan 或 ROCm 与 SYCL,实在不行还有纯 CPU。
理由:这是 llama.cpp 的主场,多后端设计就是为这个场景准备的。
五、我要把模型塞进手机、浏览器或嵌入式设备。
路径:ggml 的 WebGPU 与 Hexagon 后端,或 ExecuTorch、Core ML。
理由:此时约束是体积与依赖,ggml 零依赖、可编译到 WebAssembly 的特性就成了决定性优势。
六、我的硬件不是 NVIDIA 也不是苹果。
路径:先看厂商是否提供 ROCm、SYCL、CANN、MUSA 之类的原生栈;如果没有或不好用,退回到 Vulkan。
理由:Vulkan 是长尾硬件的“最低公约数”,虽然不是最快,但至少能用。
5.3 一个反直觉的提醒:别急着做二选一
本文最想传达的一点其实是:这条栈上的大多数“竞争关系”是被误读的。
MLX 与 PyTorch MPS 不是敌人,它们服务于不同的代码资产状态。 llama.cpp 与 vLLM 不是敌人,它们优化的是不同的目标函数。 Vulkan 与 CUDA 不是敌人,一个卖可移植性,一个卖极致性能。 甚至 MLX 支持 CUDA、MLX 能导出 GGUF,都说明各层正在握手而不是开战。
真正值得关注的竞争,只发生在同一层之内:L1 层是谁的编程模型能成为默认选项;L5 层是谁的推理引擎能成为默认运行时。跨层的“谁取代谁”叙事,大多是媒体简化。
第六章 正在发生的结构性变化
最后总结四条趋势。它们不是预测,而是已经发生、且能从前面的事实里直接推出来的。
6.1 抽象层级正在整体上移
从 CUDA C++ 到 Triton,从 Triton 到 CUDA Tile,从手写算子到 MLX 的惰性图编译——方向极其一致:让人少管一点硬件细节,让编译器多管一点。
驱动力是硬件复杂度的失控。当一块 GPU 里同时有 CUDA Core、Tensor Core、异步拷贝单元、Transformer Engine,还要考虑 NVLink 域与多卡拓扑时,人类已经写不动最优代码了。NVIDIA 在 CUDA 13.1 里给出的理由说得很明白:tile 模型“抽象掉 Tensor Core 等专用硬件的细节”,并让代码“兼容未来的 GPU 架构”。
6.2 统一内存正在从苹果特色变成行业共识
统一内存原本是苹果的小众设计,如今正在变成主流叙事。
证据有三:其一,苹果把它写进了 MLX 的数组语义;其二,NVIDIA 在机架级系统上大幅强化 CPU 与 GPU 之间的大统一内存与高带宽互联;其三,MLX 官方解释为何支持 CUDA 时的第一条理由就是“CUDA 提供统一内存机制,便于不同设备间的数据共享与迁移”。
背后的物理原因很简单:模型越来越大,而数据搬运的代价越来越高。当搬运成本超过计算成本时,消灭搬运就成了第一优先级。
6.3 生态在收敛,而不是分裂
这是最反直觉、也最值得记住的一条。看三个动作:
2022 至 2023 年,PyTorch 从 Meta 转移到 Linux Foundation,成为行业公共设施。 2025 年,MLX 开始支持 CUDA 导出,苹果主动向 NVIDIA 生态伸手。 2026 年 2 月,ggml.ai 团队加入 Hugging Face,本地推理有了机构性保障。
再加上 GGUF 成为跨工具通用格式、MLX 能直接保存 GGUF、PrimTorch 把算子收敛到约 250 个——各层之间正在形成标准接口,而不是各自为战。
竞争的重点,正在从“我做一套完整的栈取代你”,转向“我在这几层做到最好,并与上下相邻层握手”。
6.4 训练与推理彻底分家
过去训练和推理用同一套框架,PyTorch 一把梭。现在它们正在分道扬镳:
训练侧高度收敛:基本就是 CUDA 加 PyTorch,其他方案都在追赶。原因是训练对算力、通信、算子覆盖的要求极端苛刻,生态壁垒极高。 推理侧高度碎片:llama.cpp、vLLM、TensorRT-LLM、ExecuTorch、Core ML、MLX、WebGPU,各占一个场景。原因是推理的约束条件千差万别——有的要吞吐,有的要延迟,有的要离线,有的要在浏览器里。
这个分化对从业者的直接含义是:**“学一套技术走天下”的时代结束了。**你需要知道自己处在栈的哪一层,以及这一层的胜负手是什么。
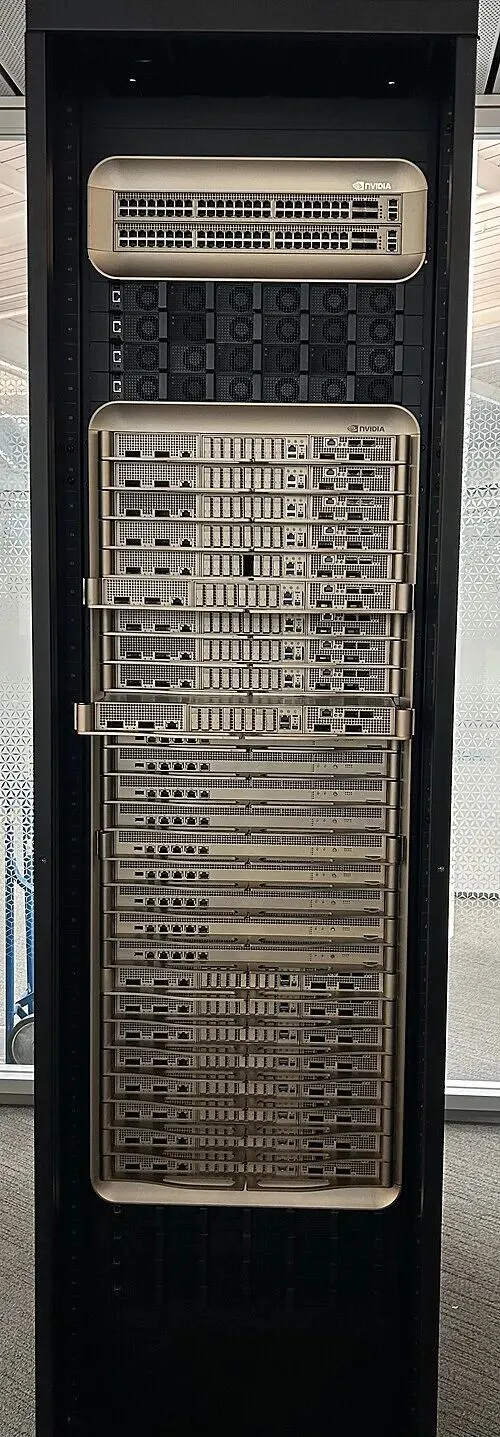
NVIDIA DGX GB200 机架级系统。近几年竞争焦点已从单卡转向整机:互联、功耗与内存带宽(图片来自 Wikimedia Commons,CC BY-SA 4.0)
结语:每一层的胜负手
如果用一句话概括每一层真正在竞争什么,我会这么说:
L1 编程模型层:争的是“谁的硬件能被默认支持”。CUDA 赢在库,Vulkan 赢在广度,Metal 赢在垂直整合。 L2 算子层:争的是“同样的矩阵乘法,谁能更快更省电”。这一层拼工程积累,没有捷径。 L3 框架层:争的是“研究者用谁写模型”。PyTorch 已经赢了,MLX 在苹果设备上开辟了第二战场。 L4 编译层:争的是“谁能自动生成最优代码”。这是当前变化最快的一层,Triton、Inductor、CUDA Tile 混战正酣。 L5 运行时层:争的是“谁能最低成本把模型送到用户手上”。llama.cpp 拿下了单机与边缘,vLLM 拿下了服务端。
回到开头那个问题:当硬件越来越专用、越来越碎片化时,软件该在哪一层做抽象?
看完这几年的演进,答案大概是:**每一层都要做,但只做自己那一层的事。**苹果没有试图让 MLX 取代 PyTorch,而是把统一内存的红利吃透;Gerganov 没有试图让 ggml 支持训练,而是把推理做到极致;NVIDIA 没有放弃 CUDA,而是给它加了一层 Tile 抽象。
真正失败的案例,几乎都是试图一口气吃掉整条栈的。
参考来源
本文关键事实与数据的出处如下,均为官方渠道或权威来源。
官方来源
NVIDIA 官方技术博客:CUDA 13.1 与 CUDA Tile 编程模型(2025 年 12 月)—— nvidia-cuda-13-1-powers-next-gen-gpu-programming Khronos Group 官方新闻稿:Vulkan 1.0 规范发布(2016 年 2 月 16 日)—— khronos-releases-vulkan-1-0-specification PyTorch 官方博客:PyTorch 2.0 发布说明(2023 年 3 月 15 日)—— pytorch-2-0-release PyTorch 官方博客:Mac 上的 GPU 加速训练与 MPS 后端(2022 年 5 月 18 日)—— introducing-accelerated-pytorch-training-on-mac PyTorch 官方文档:MPS 后端说明 —— docs.pytorch.org MPS backend MLX 官方文档(Apple 机器学习研究团队)—— ml-explore.github.io/mlx MLX 官方仓库 —— github.com/ml-explore/mlx ggml 官方仓库 —— github.com/ggml-org/ggml llama.cpp 官方仓库 —— github.com/ggml-org/llama.cpp Hugging Face 官方博客:GGML 与 llama.cpp 加入 Hugging Face(2026 年 2 月)—— ggml-joins-hf Khronos MoltenVK 仓库 —— github.com/KhronosGroup/MoltenVK
媒体与第三方来源
Hackster:Meta 将 PyTorch 移交 Linux Foundation —— 报道链接 Jon Peddie Research:GPU 向 AI 处理器演进的三阶段梳理(GPGPU、Tensor Core、NPU)—— Part III: The evolution to AI GPUs C114 转载 AppleInsider:苹果 MLX 框架新增 CUDA 支持 —— 报道链接 WinBuzzer:ggml.ai 加入 Hugging Face 的背景梳理 —— 报道链接
数据来源说明
llama.cpp、ggml、MLX、PyTorch、MoltenVK、vLLM、Triton 的星标数与 fork 数,均由作者于 2026 年 9 月 20 日通过 GitHub REST API 实测获取。 GGUF 格式发布时间(2023 年 8 月 21 日)、llama.cpp 首个 commit 时间(2023 年 3 月 10 日)等,来自仓库提交历史与社区整理资料。 苹果 MPS 性能测试数据(M1 Ultra、macOS 12.3、PyTorch 1.12 预发布版、ResNet50 与 BERT 与 VGG16)引自 PyTorch 官方博客注明的测试口径,由苹果于 2022 年 4 月测得。 文中所有图片均来自 Wikimedia Commons(遵循各图标注的授权协议)或 GitHub 官方社交卡片,链接可直接访问。
写作说明
本文所有性能数字均附测试条件,请勿脱离条件做横向比较。文中对各项技术的生态位判断为作者基于公开资料的分析,不代表相关厂商立场。数据截至 2026 年 9 月,技术发展较快,请以各项目官方最新文档为准。