ARTICLE · 1052201
Aquria 多模态 AI 访谈,正在打破定性与定量研究的边界
Aquria 多模态 AI 访谈,正在打破
定性与定量研究的边界
从结构化题型、开放追问,到视频语音与标签化分析
一场 AI 深访,开始同时回答「选了什么」「为什么这么选」,以及「真实反应是什么」。
过去,结构化结果和用户自己的解释,经常分散在不同的研究阶段里。Aquria 正在把这些信息,放进同一场多模态 AI 访谈中。
在很多研究项目里,定性和定量一直有着清晰的分工。
问卷更擅长回答「有多少人这样想」。单选、多选、量表、排序,可以把消费者的态度转化为结构化数据,让研究团队看到选择比例、评分分布、人群差异,以及一个产品或概念的整体表现。
深度访谈承担的则是另一类任务:为什么这么选?为什么喜欢,却没有购买?明明认可产品,购买意愿为什么只有 6 分?一个看起来简单的选择,背后经历了怎样的判断和权衡?
因此,一项研究经常会经历多个阶段:先通过访谈找到关键因素,再把这些因素写进问卷;或者先通过问卷发现值得继续了解的问题,再邀请部分用户进行深访。
这样的研究方式已经非常成熟,但一个现实问题也一直存在:
结构化结果和用户自己的解释,经常分散在不同的研究阶段里。
随着 AI 开始直接主持一对一访谈,这种关系开始发生变化。Aquria 正在把过去分散在不同研究环节中的信息,放进同一场多模态 AI 访谈中。
用户选了什么?
结构化答案
为什么这么选?
AI 继续追问
真实反应是什么?
视频语音保留
下面七个部分,是一场多模态 AI 访谈从一道题走向一整项研究的过程。
当结构化答案进入深访,数字之后还能继续问
以一项手机新品研究为例。研究中设置了一道购买意愿量表题,一位受访者给出了 7 分。这个数字已经可以进入统计,但研究人员真正关心的往往还包括:为什么是 7 分?
在 Aquria 的 AI 访谈中,量表题之后可以直接继续追问。
▎访谈实录
AI 问:「是什么让你没有给到更高的分数?」
受访者回答:「主要还是价格,我觉得这一代升级没有大到让我马上换。」
AI 可以顺着这个回答继续了解:他对价格的判断,究竟来自预算限制,还是觉得当前升级不足以支撑这个价格。于是,一个原本只有「7 分」的结果,开始有了更具体的解释。
同样的方式也适用于单选、多选和排序题。受访者把 AI 功能排在最后,AI 可以继续了解原因;在多选题里选择「价格」作为主要购买阻碍,也可以继续追问他所说的「贵」究竟指什么。
同样一个 7 分,背后也可能是完全不同的人:有人介意价格,有人暂时没有换机需求,也有人担心生态兼容。
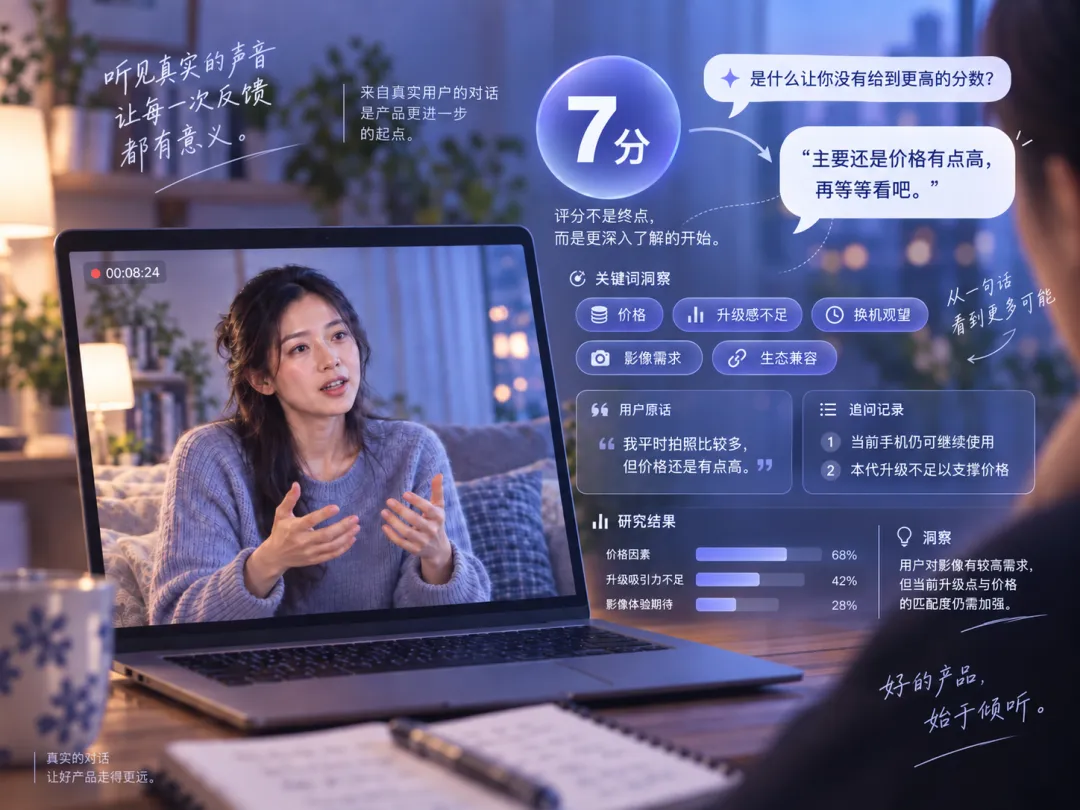
数字让我们看到共同结果,继续追问才能看到这些结果背后的差异。
▎场景价值
结构化题目不再只负责留下一个结果——每一次选择、评分和排序,也都可以成为下一轮深访的起点。
多模态交互,让研究材料直接进入访谈
开放追问解决了「为什么」的问题,但真实研究中,很多问题还需要受访者先看到、听到,甚至亲自拍摄某些内容。这也是多模态访谈很重要的一部分。
在 Aquria 中,研究人员可以针对提纲中的每一道题,直接向受访者展示图片或视频材料。
▎材料可以这样进入访谈
AI 获得的上下文因此不再只有一道问题,还包括用户刚刚看到了什么,以及他看完以后产生了什么反应。
多模态交互也可以从受访者一侧发生——用户可以在访谈过程中直接回传照片。比如一项桌面设备研究,研究人员可以让受访者拍摄自己的真实桌面。用户上传照片以后,AI 可以结合他前面的回答继续问:
▎结合照片的追问
「你刚刚提到桌面整洁对你很重要。照片里这几个设备为什么会这样摆放?」
在居家使用研究里,可以让受访者上传真实的产品摆放和使用场景;在产品体验研究里,可以让用户拍下正在使用的设备、包装、界面或者出现问题的位置;在日志型研究里,还可以通过照片连续记录几天里的变化,再结合前几次回答继续追问。
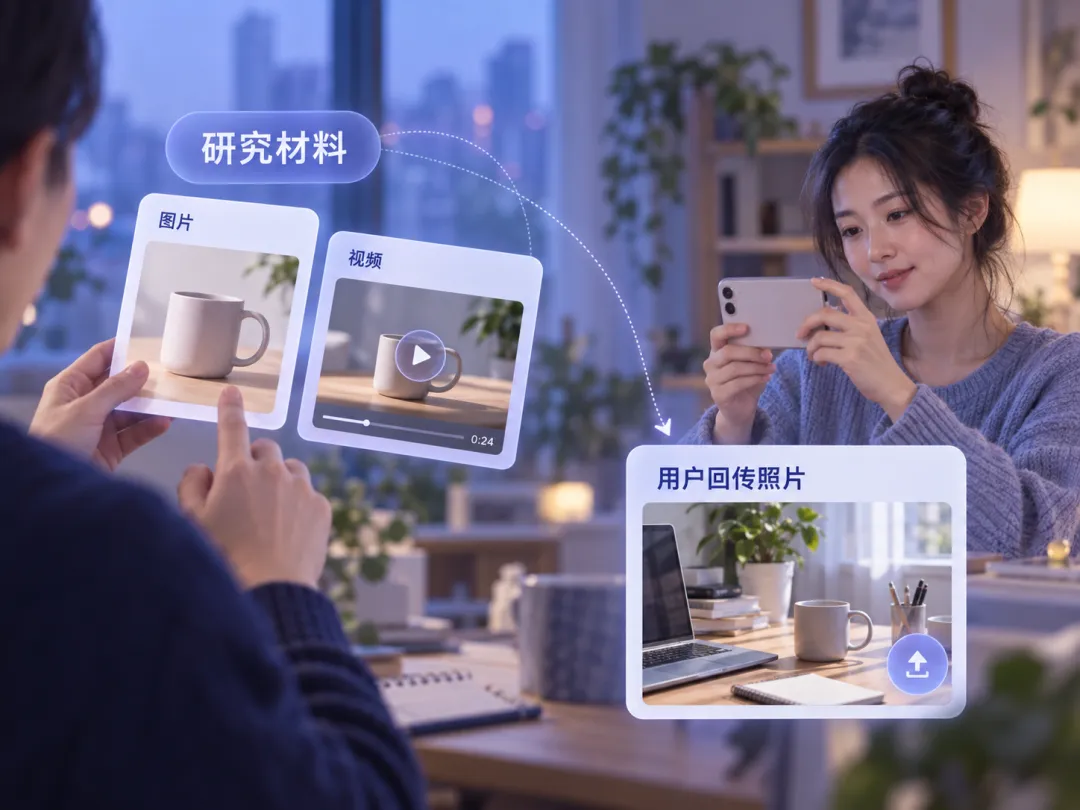
▎场景价值
研究人员听到的不再只是用户对一个场景的描述——真实的环境、产品和现场内容本身,也开始进入访谈。
视频和语音,保留下文字之外的真实反应
还有一部分信息,很难完整存在于文字转写中。
单看文字转写
「嗯……我觉得还可以。」「挺有意思的。」
两句偏中性的评价
回看完整视频
回答前停顿了几秒,第一反应有些犹豫;真正的情绪反应,出现在广告的某个具体片段
评价背后的真实状态
表情、语气、停顿,以及看到研究材料后的第一反应,本身就是深访中的重要信息。
Aquria 支持由 AI 主持的视频或语音一对一访谈。研究团队除了获得完整文字笔录,也可以回看完整访谈视频,重新观察受访者当时的表达过程。
因此,多模态在一场访谈里其实同时发生在两个地方:一方面,研究材料可以进入访谈,用户也可以回传自己的现场内容;另一方面,视频和语音本身又记录下了受访者完整的表达状态。
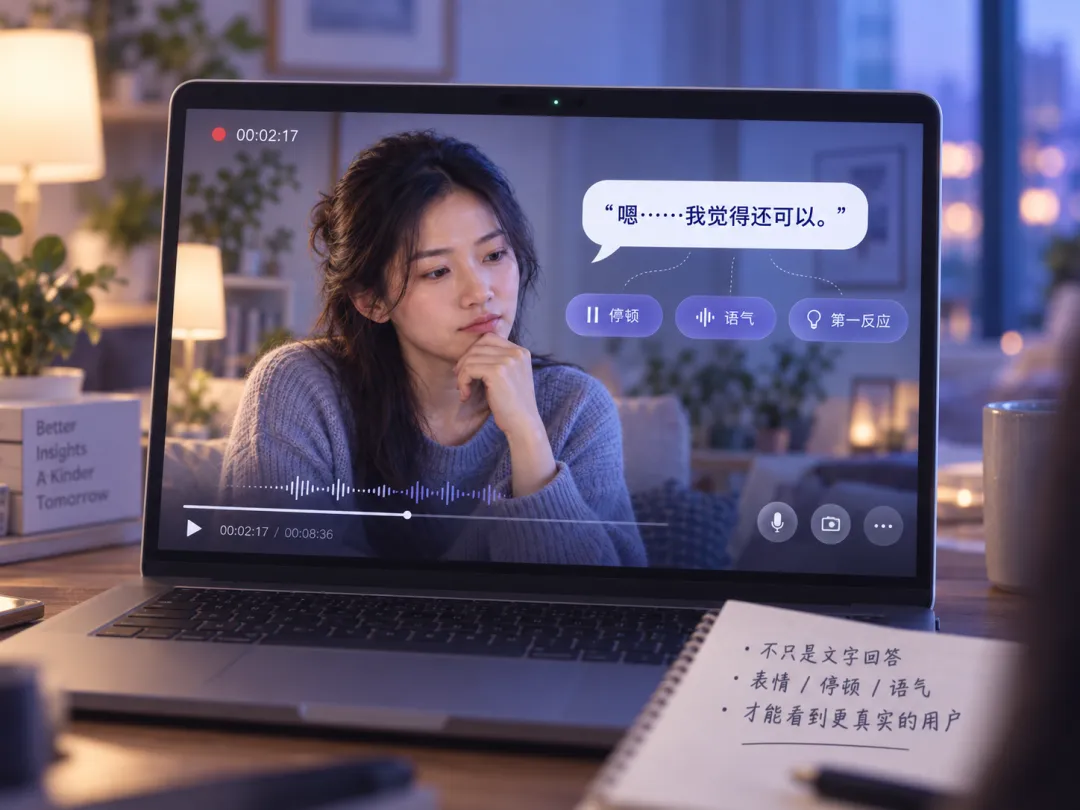
▎场价值
文字方便检索和分析,视频和语音则把当时真实发生的交流保留下来——两者在同一场访谈里各归其位。
当几十场、上百场访谈结束,研究面对的问题又变了
理解一个人为什么给出 7 分之后,研究还没有结束。当一个项目完成几十场甚至上百场访谈时,研究团队开始需要从大量个体回答里找到共同规律。
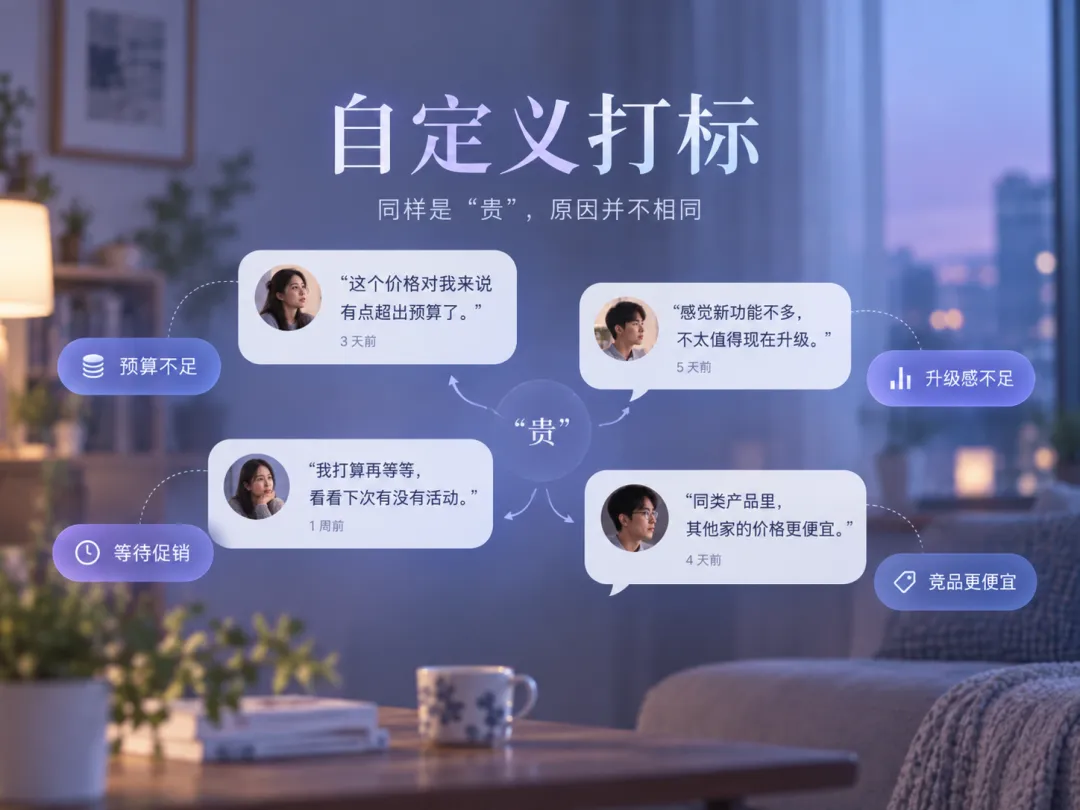
比如,同样提到「价格贵」的消费者,背后的原因可能完全不同:有人确实预算不足,有人觉得当前产品不值这个价格,也有人只是在等待促销。依靠逐场回看视频、逐份阅读笔录,很难快速完成这件事。
访谈完成后,研究团队可以获得研究报告和标签化 Table,原本散落在不同访谈里的内容,会重新被整理到一起。例如一项新品研究结束以后,可以看到:
▎标签化 Table · 新品研究(节选)
🎯 驱动:相机升级
🚧 阻碍:价格
📍 状态:有换机计划
🎯 驱动:性能提升
🚧 阻碍:当前设备仍够用
📍 状态:暂无计划
🎯 驱动:外观设计
🚧 阻碍:生态兼容
📍 状态:观望
🎯 驱动:续航、相机
🚧 阻碍:无明显阻碍
📍 状态:近期准备购买
同一个分数并排看,差异一眼可见——A、B 同为 7 分,驱动、阻碍和状态却完全不同。
前面大量开放的访谈内容,由此变成了可以横向查看、筛选和比较的信息。研究人员可以先从 Table 里看整体情况,再回到某一位受访者的具体回答和原始访谈内容。
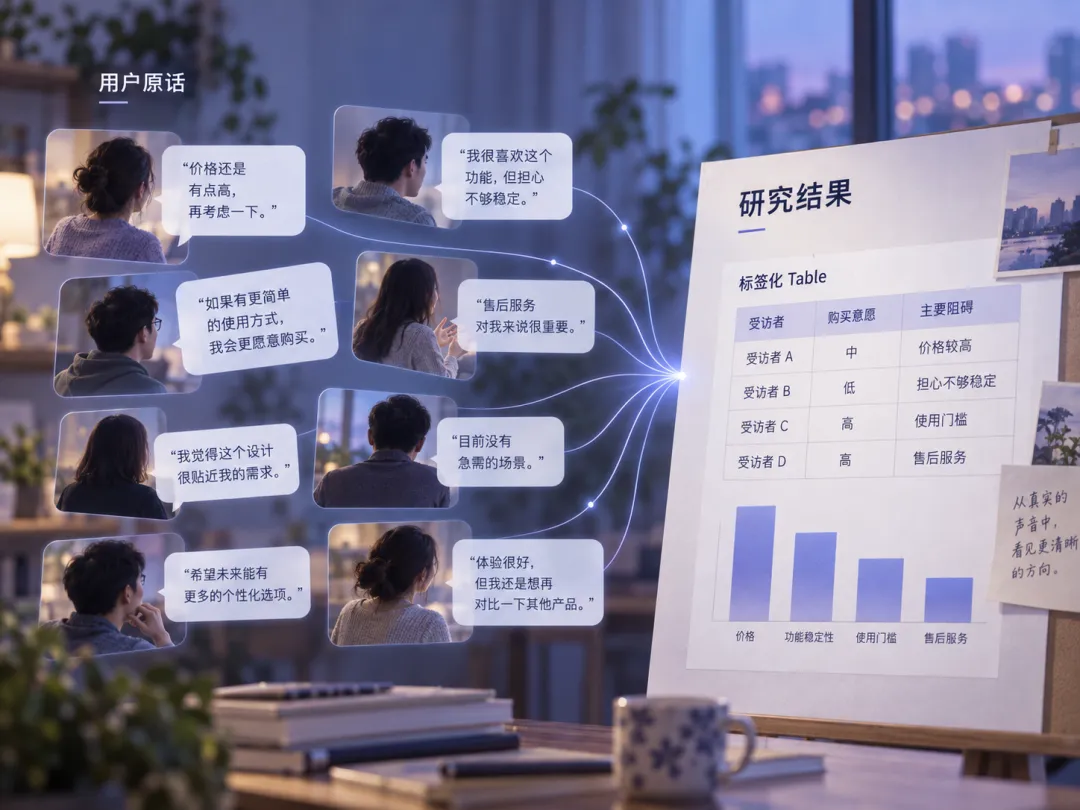
最开始那个「7 分」,到了这里也有了新的意义。单场访谈关注的是「为什么这个人给了 7 分」;到了整项研究里,还可以继续看到——
所有给出 7 分的人,背后分别是什么原因?
▎场景价值
从整体分布到个体原话只需一步:先看 Table 里的全貌,再回到任何一位受访者的完整访谈。
自定义打标,让开放回答按照研究问题重新整理
不同项目真正关心的内容并不一样。手机新品研究可能关心价格敏感、换机周期、影像需求和生态依赖;食品研究可能更关注口味、健康、成分、包装和食用场景;广告测试关注的又可能是记忆点、理解度、品牌关联和情绪反应。
所以标签本身也需要跟着研究目标变化。Aquria 支持研究团队根据项目需要进行自定义打标,按照自己真正关心的问题整理访谈结果。
▎同一句「贵」,三种不同的研究含义
他们都可能在访谈里说「贵」,研究含义却完全不同。通过自定义标签,这些差异可以重新整理出来。
标签还可以再和量表、单选、多选、排序等结构化答案放在一起查看。研究团队可以先看到哪些人给出了低分,再继续查看低分背后的主要原因,也能回到对应的消费者原话和完整访谈。
数字让我们看到结果分布,标签和原话则让我们继续理解结果是怎么形成的。
▎怎么用
按本项目真正关心的问题定义标签,再把标签、结构化答案和消费者原话放在同一个视图里交叉查看。
从一次回答,到一整项研究
把整个过程连起来看,一项多模态 AI 访谈已经开始形成一条更加连续的研究过程。
▎一场多模态访谈里,同时被记录下来的信息
还是最开始那个简单的 7 分。在单场访谈里,可以继续知道这个人为什么给了 7 分;完成大量访谈以后,又可以继续看到有多少人给出了 7 分,以及这些 7 分背后分别对应着哪些原因。
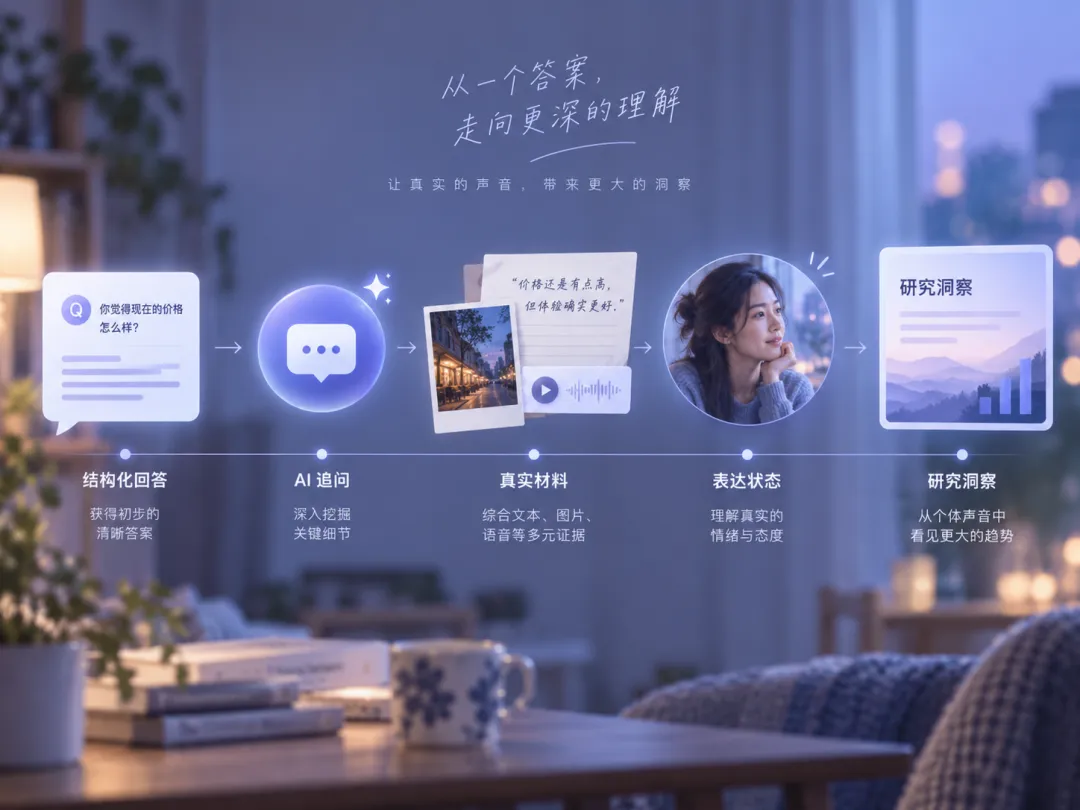
一个单独的数字,可以一路回到一个真实的人;很多个真实的人,又可以重新汇集成一项研究的整体结果。
定性与定量研究的边界,正在发生变化
在访谈里加入量表、单选、多选和排序,并不意味着传统的研究原则可以被忽略。真正进行统计推断时,样本数量、抽样方式、样本代表性、配额设计和统计方法依然重要——这些基础不会因为 AI 的出现而消失。
真正发生变化的,是一项研究里不同类型的信息开始连接得更紧。
过去,一道量表题可能在「7 分」这里结束。现在,这个 7 分可以继续往下走:研究团队可以知道数字背后的原因,理解用户做出这个选择时的判断,也可以回看他说出这个答案时的表情、语气和停顿。
一张产品图、一段广告视频,甚至一张用户现场拍摄的照片,都可以直接进入访谈,成为后续交流的一部分。当几十个、上百个用户完成访谈以后,这些开放表达又可以通过标签、Table 和研究报告重新整理,回到整项研究中。
过去,一项研究得到的
「42% 的用户给出了 8 分以上。」
现在,还可以继续知道
高分用户真正认可什么;6 分、7 分的用户主要卡在哪里;消费者说「贵」时,背后是哪一种判断
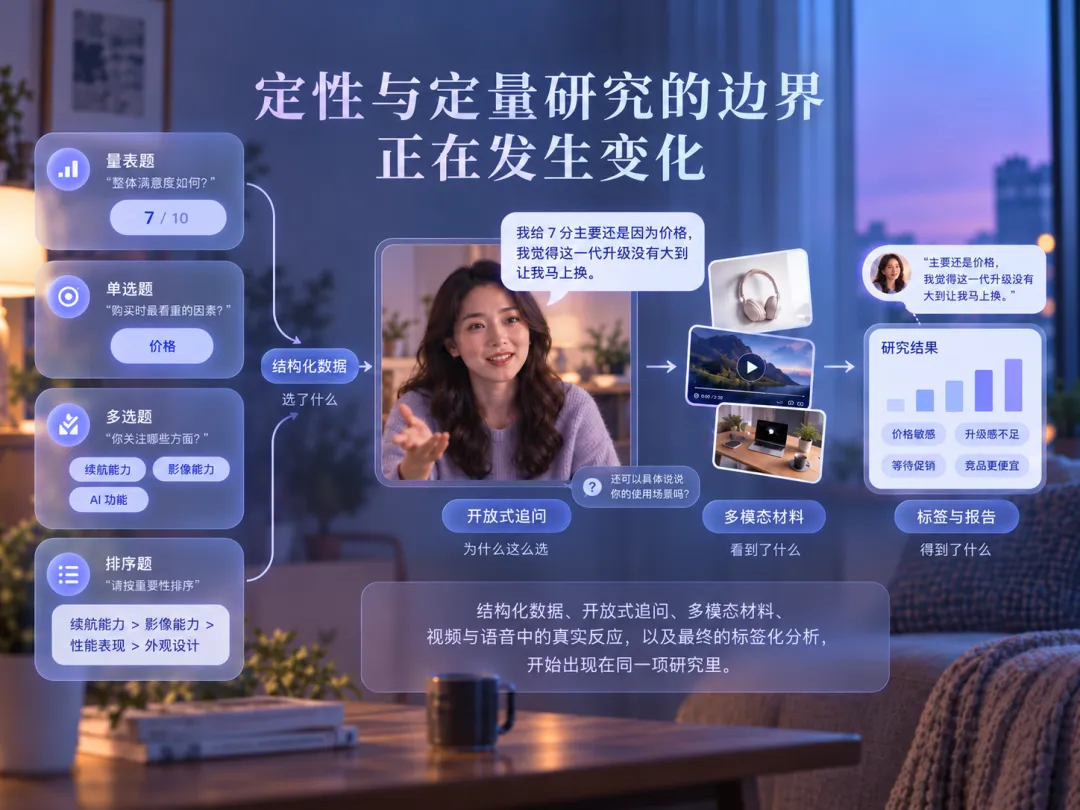
这也是 Aquria 多模态 AI 访谈正在带来的变化:
结构化数据、开放式追问、多模态材料、视频与语音中的真实反应,以及最终的标签化分析,开始出现在同一项研究里。
一个 7 分之后,研究还可以继续往下走
一个用户给出了 7 分。这个数字当然值得记录,而研究还可以继续追问:为什么是 7 分?他说出这个答案时经历了怎样的判断?他刚刚看到的产品、广告或现场环境,又怎样影响了这次回答?和他一样给出 7 分的人,背后还有多少种不同原因?
▎在 Aquria 的一场多模态 AI 访谈里
数字 — 告诉我们发生了什么
追问 — 帮助我们理解原因
多模态交互 — 让真实材料进入访谈
视频和语音 — 保留下当时的真实反应
报告、标签和 Table — 把分散在每个受访者身上的信息,重新整理成可以继续阅读、筛选和分析的研究结果
一个用户给出了 7 分,这个数字当然值得记录。而研究,还可以继续往下走。