ARTICLE · 1053188
AI 服务器的三类职责:算力、数据和管理
看一台 AI 服务器,最容易把注意力放在 GPU 数量、显存和机箱规格上。但一项任务能否稳定完成,可以先用一个简单的观察视角来判断:算力负责协同,数据负责持续供给,管理负责持续可见和可接手。
这里说的不是三条物理上完全独立的链路,也不是某种官方统一分类。它只是把服务器能力拆成三类职责,帮助我们看清同一项任务的关键条件。网卡、PCIe、存储等部件,会随任务和部署方式参与不同职责。
这更不是完整的服务器能力模型。功耗、散热、安全、合规、软件栈等同样重要,但不必都塞进这篇文章。本文只提供一套简化框架:让读者先判断算力、数据和管理三类职责是否成立,再回到目标任务验证结果。
算力协同不足,多张 GPU 难以形成有效工作;数据流动跟不上,GPU 会等待;管理能力缺失,正常运行时难以持续掌握状态,异常发生后也可能失去判断和接手入口。
前面讨论过带外管理与机柜供电,分别回答了异常时能否接手、整柜能否承载。今天把视角拉回整机:一台服务器要从配置单变成可用算力,必须让三类职责共同服务目标任务。
算力职责:让 GPU 围绕任务协同
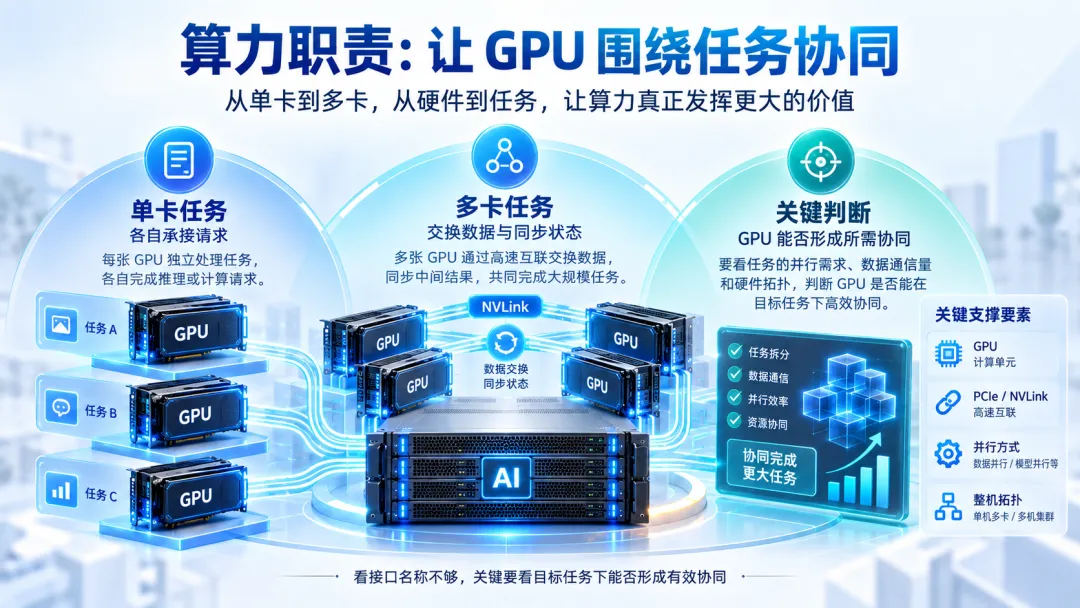
算力职责解决的是计算资源如何协同完成任务。
对于单卡或彼此独立的推理请求,重点是每张 GPU 能否各自承接任务;对于模型切分、多卡推理或训练,GPU 之间还需要交换数据、同步状态。GPU、PCIe、NVLink 等连接关系,以及面向集群的网络接口,都可能参与这类职责。
这里要判断的不是某个接口名称是否出现,而是:在目标模型、并行方式和任务规模下,参与任务的 GPU 能否形成所需的协同。 对应证据应来自目标任务的实际运行,而不只是配置表。
NVIDIA 的 DGX H100/H200 系统资料会分别列出 GPU、集群网络和存储/带内管理网络组件。这也说明,服务器内部不同连接承担的任务并不相同。具体平台怎样组织,仍要回到整机拓扑和软件支持边界确认。
数据职责:让任务所需数据持续流动
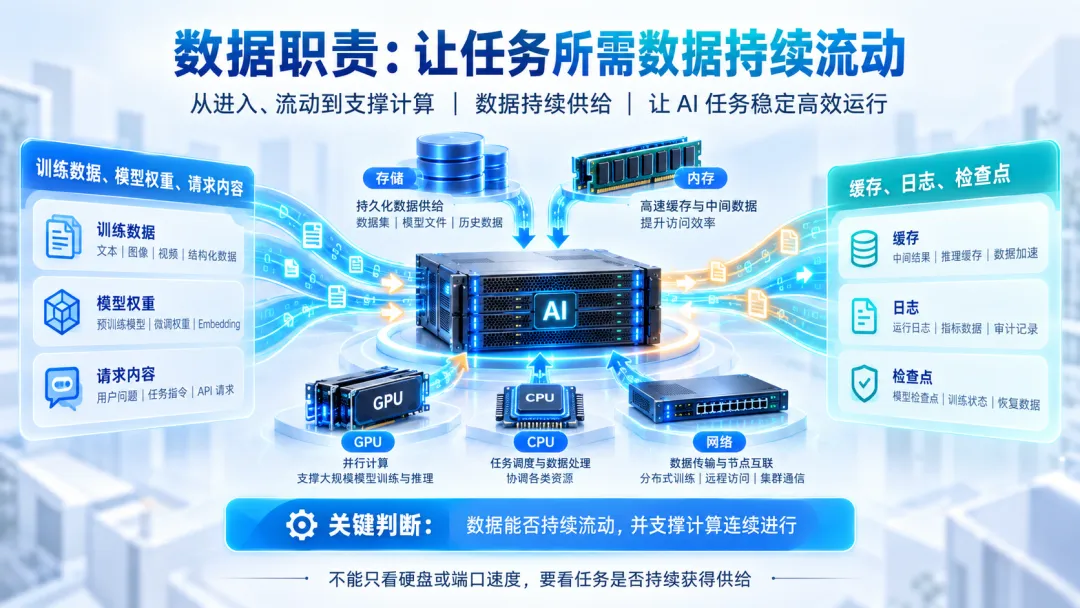
数据职责解决的是任务所需数据能否持续流动,并支撑计算。
训练数据、模型权重、请求内容、缓存、日志和检查点,并不都以同一种方式流动。硬盘、CPU、内存、网卡与 GPU 之间的路径,会共同影响这些数据能否在需要的时点进入、离开或留在计算过程。
因此,GPU 没有持续工作时,不能立刻把问题归为算力不足。先要分清:目标任务需要哪些数据,它们从哪里来,经过哪些处理和传输环节,又以什么节奏支撑计算。
数据职责的终点也不是某块硬盘或某个端口的标称速度,而是目标任务所需的数据能否持续流动,并支撑计算连续进行。 对应证据也应回到实际任务是否获得连续供给,而不只看部件规格。
管理职责:让状态持续可见、需要时可接手
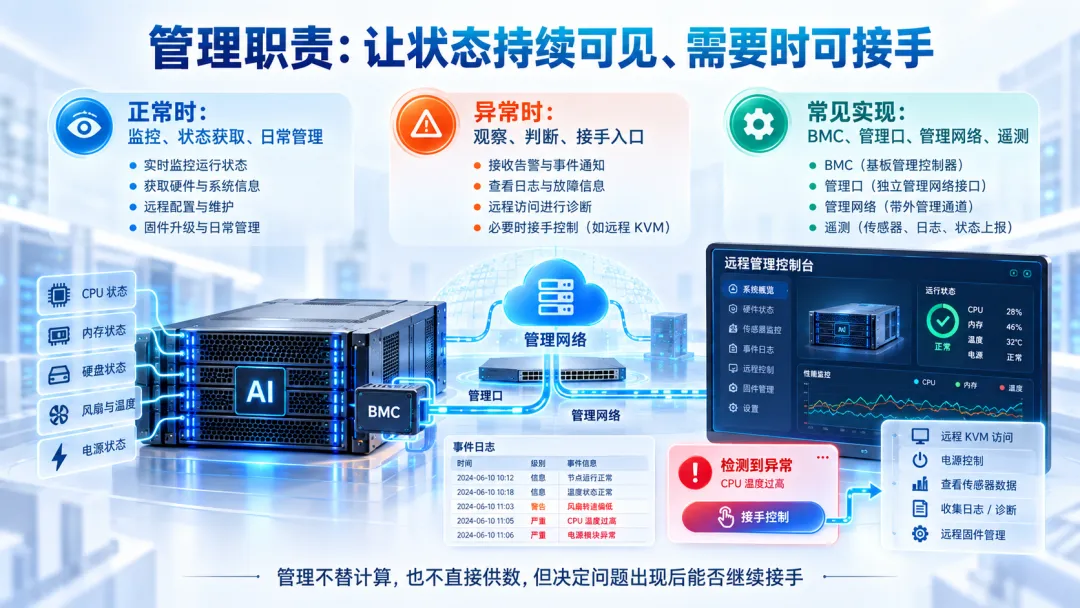
管理职责解决的是团队能否持续看到状态、判断系统,并在需要时于授权范围内接手。
正常运行时,它承接监控、状态获取和日常管理;异常发生时,它的关键交付价值是让团队仍有观察、判断和接手入口。BMC、管理口、管理网络、遥测和事件记录,都是常见的实现方式。OCP 的 GPU 与加速器 RAS 要求将 BMC 描述为面向节点管理、遥测和错误报告的带外管理实体,强调的正是管理能力不应完全依附于当前业务运行通道。
这类职责不负责替任务计算,也不直接给 GPU 供数。它的价值是让系统在正常时持续可见,在问题出现时不必从“失去联系”开始处理。是否具备这一能力,也应有可查看、可追溯的管理证据;具体动作仍以设备支持矩阵、现场网络和权限边界为准。
三类职责,最终只服务一个结果
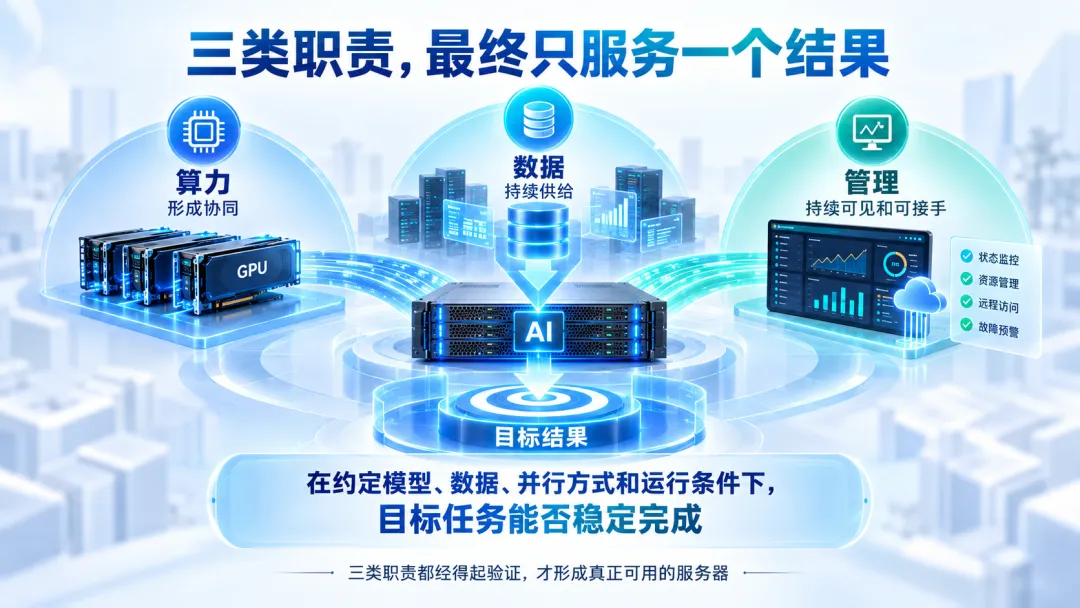
这三类职责不能被当成三个独立知识点,更不能替代完整的服务器评估。它们是一套简化的判断框架:
算力负责协同:参与任务的 GPU 能否形成所需协同,并有目标任务运行作为证据。 数据负责持续供给:任务所需数据能否持续流动并支撑计算,并有连续供给的结果作为证据。 管理负责持续可见和可接手:正常时能否掌握状态,异常时能否继续观察、判断和接手,并有相应管理记录或演练作为证据。
最终验证不在三张孤立的清单上,而在同一个结果上:在约定模型、数据、并行方式和运行条件下,目标任务能否稳定完成。
所以,评估方案时不必先把接口和部件全部背下来。先用这套框架看一张整机图:GPU 如何协同、任务数据怎样持续流动、系统状态如何持续可见并在需要时被接手;再让每类职责拿出对应证据,最后用目标任务验证它们是否共同成立。
只需记住一句话:算力负责协同,数据负责持续供给,管理负责持续可见和可接手;三类职责都经得起验证,才形成真正可用的服务器。